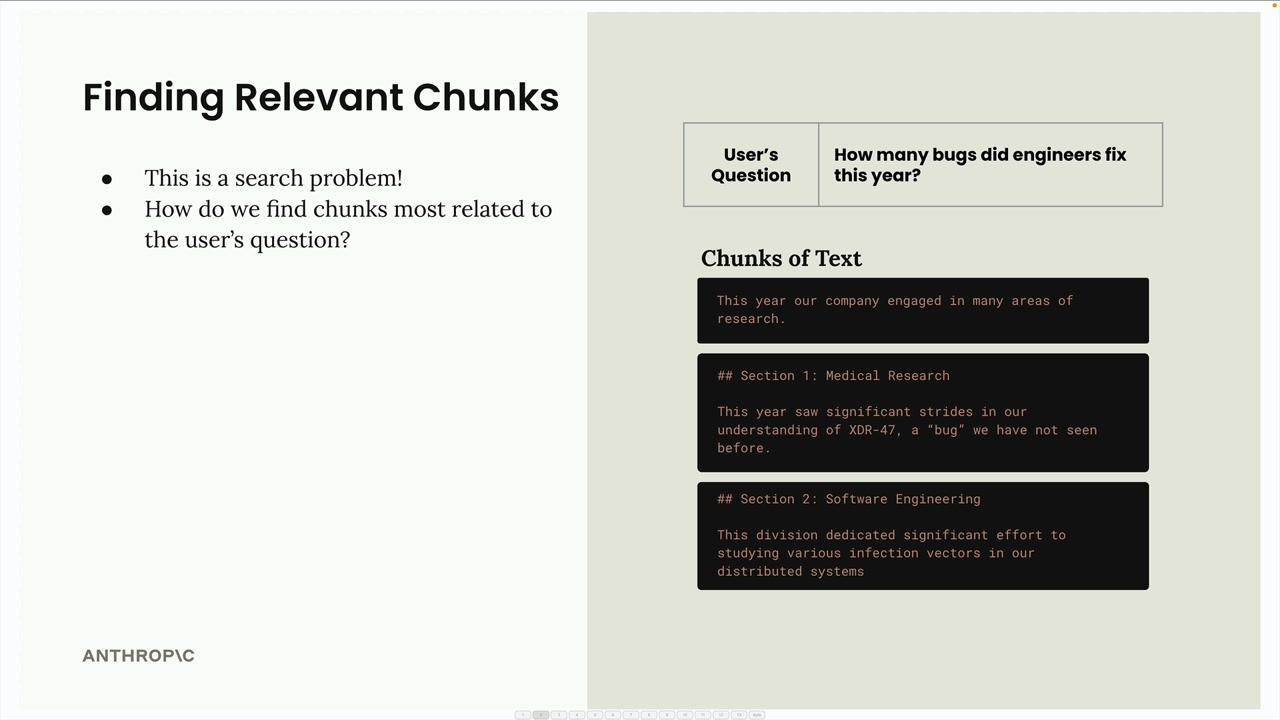
Après avoir découpé un document en fragments, l'étape suivante dans un pipeline RAG consiste à trouver quels fragments sont les plus pertinents par rapport à la question d'un utilisateur. Il s'agit essentiellement d'un problème de recherche : vous devez parcourir tous vos fragments de texte et identifier ceux qui se rapportent à ce que l'utilisateur demande.
Recherche sémantique
L'approche la plus courante pour trouver les fragments pertinents est la recherche sémantique. Contrairement à la recherche par mots-clés qui cherche des correspondances exactes de mots, la recherche sémantique utilise des plongements de texte pour comprendre le sens et le contexte à la fois de la question de l'utilisateur et de chaque fragment de texte.
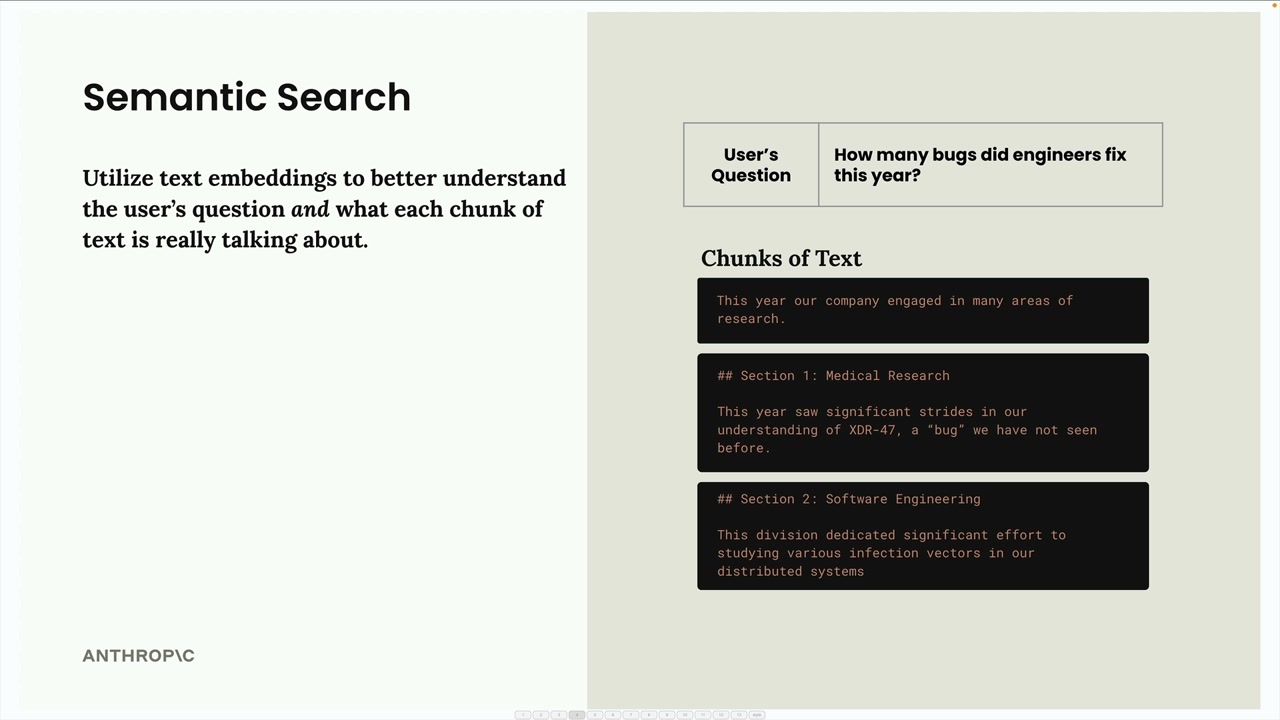
Plongements de texte
Un plongement de texte est une représentation numérique du sens contenu dans un texte. Imaginez cela comme la conversion de mots et de phrases dans un format que les ordinateurs peuvent manipuler mathématiquement.
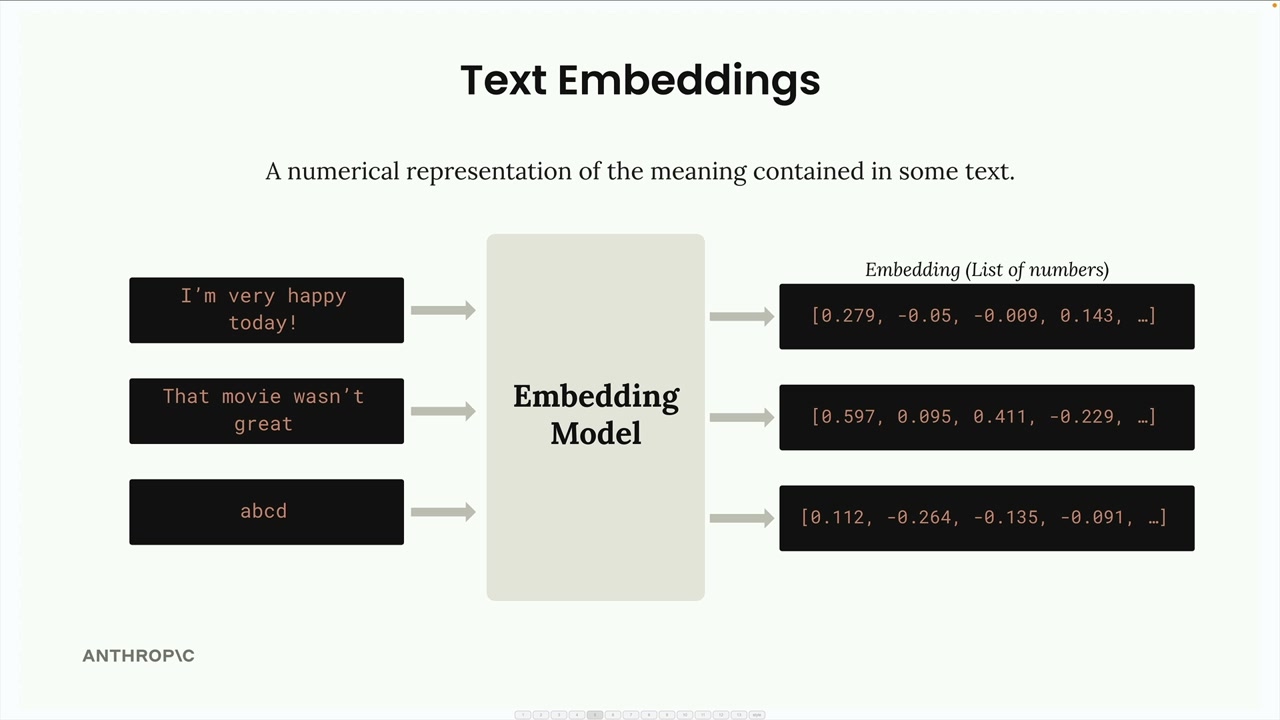
Voici comment le processus fonctionne :
- Vous transmettez du texte à un modèle de plongement
- Le modèle produit une longue liste de nombres (le plongement)
- Chaque nombre se situe entre -1 et +1
- Ces nombres représentent différentes qualités ou caractéristiques du texte d'entrée
Comprendre les nombres
Chaque nombre dans un plongement est essentiellement un « score » pour une qualité du texte d'entrée. Cependant, voici la mise en garde importante : nous ne savons pas précisément ce que représente chaque nombre.
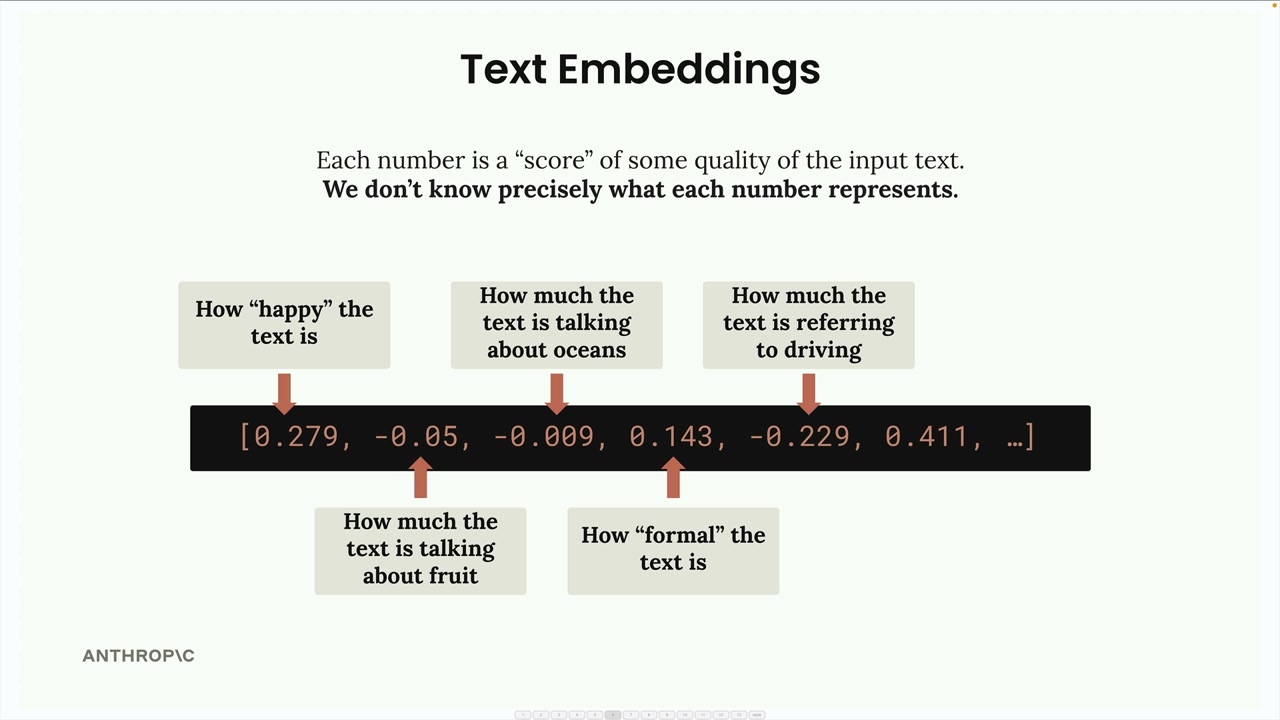
Bien qu'il soit utile d'imaginer qu'un nombre pourrait représenter « à quel point le texte est heureux » ou « à quel point le texte parle des océans », ce ne sont que des exemples conceptuels. La signification réelle de chaque dimension est apprise par le modèle pendant l'entraînement et n'est pas directement interprétable par les humains.
VoyageAI pour les plongements
Puisqu'Anthropic ne fournit pas actuellement de génération de plongements, le fournisseur recommandé est VoyageAI. Vous devrez :
- Vous inscrire pour un compte VoyageAI distinct
- Obtenir une clé API (gratuite pour commencer)
- Ajouter la clé à vos variables d'environnement
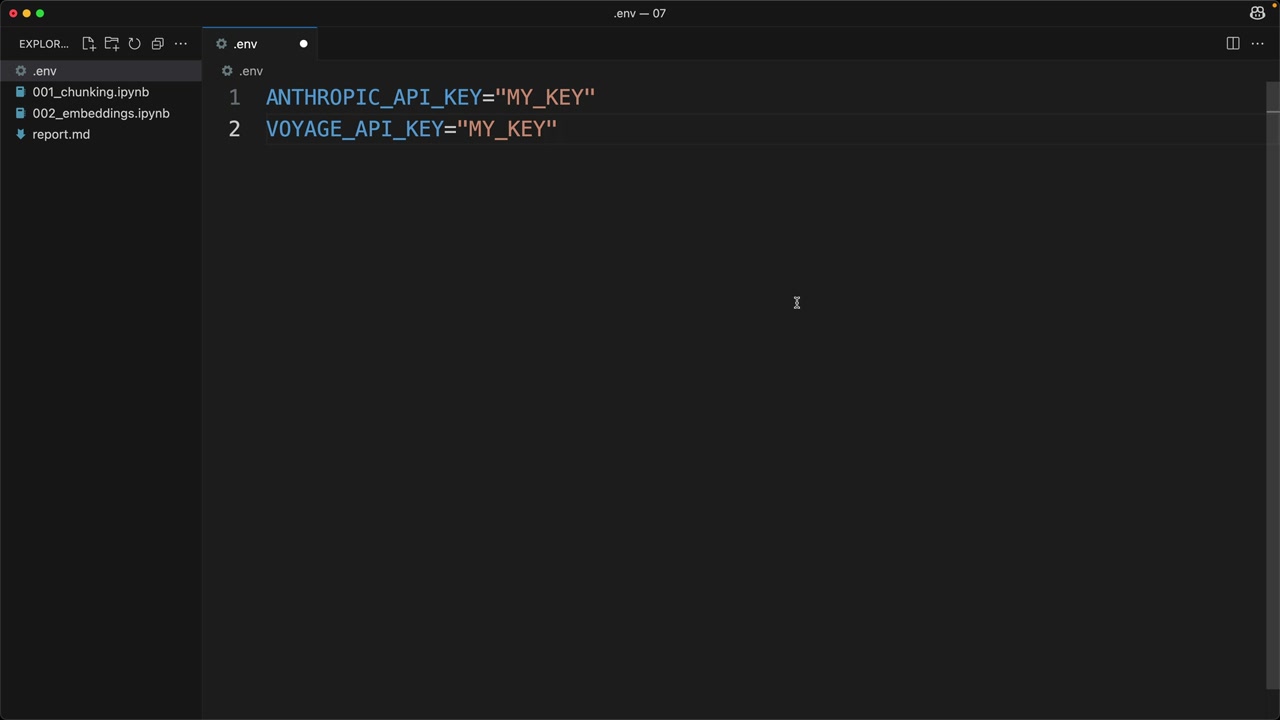
Dans votre fichier .env, ajoutez :
VOYAGE_API_KEY="your_key_here"Implémentation
Tout d'abord, installez la bibliothèque VoyageAI :
%pip install voyageaiEnsuite, configurez le client et créez une fonction pour générer des plongements :
from dotenv import load_dotenv
import voyageai

load_dotenv()
client = voyageai.Client()

def generate_embedding(text, model="voyage-3-large", input_type="query"):
    result = client.embed([text], model=model, input_type=input_type)
    return result.embeddings[0]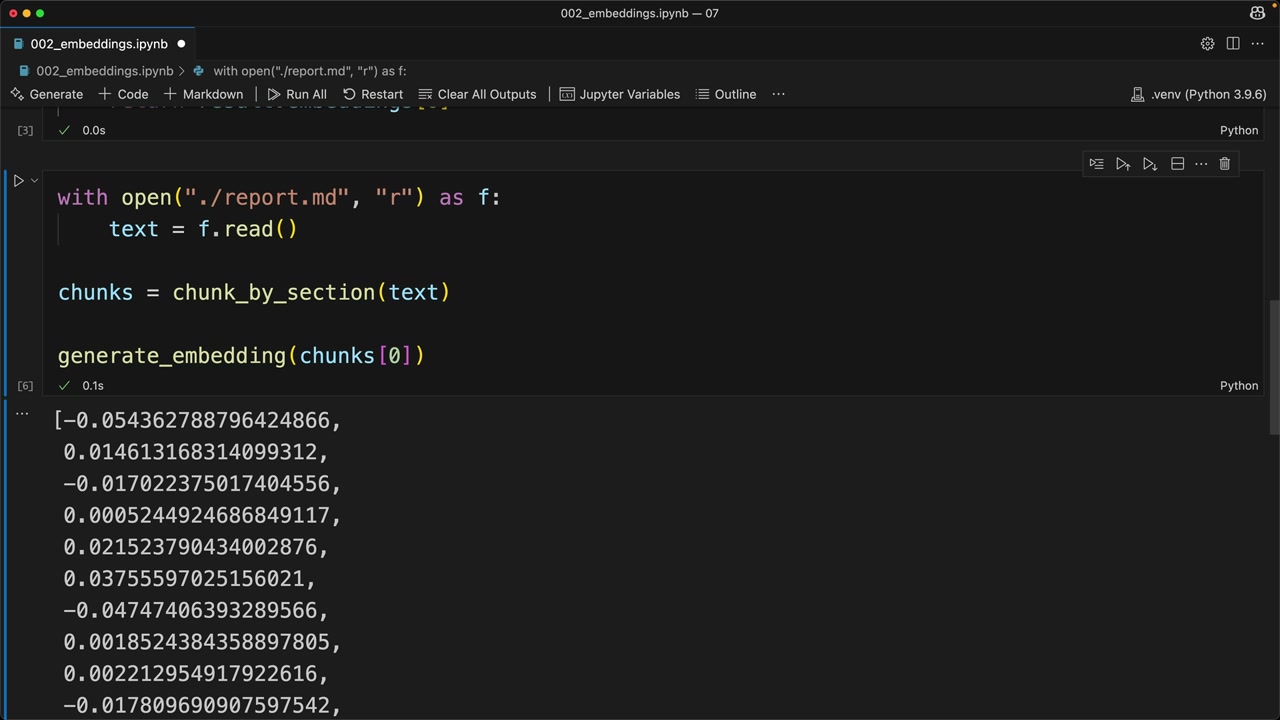
Lorsque vous exécutez cette fonction sur un fragment de texte, vous obtenez en retour une liste de nombres à virgule flottante représentant le plongement. Le processus est rapide et direct - le véritable défi consiste à comprendre comment utiliser ces plongements efficacement dans votre pipeline RAG pour trouver le contenu le plus pertinent.
L'étape suivante consiste à apprendre comment comparer les plongements pour déterminer quels fragments sont les plus similaires à la question d'un utilisateur, ce qui constitue le cœur du processus de recherche sémantique.