Lors de la création de flux de travail d'évaluation de requêtes, les systèmes de notation fournissent des signaux objectifs sur la qualité des résultats. Un évaluateur prend le résultat du modèle et renvoie une forme de retour mesurable - généralement un nombre entre 1 et 10, où 10 représente une qualité élevée et 1 une qualité médiocre.
Types d'évaluateurs
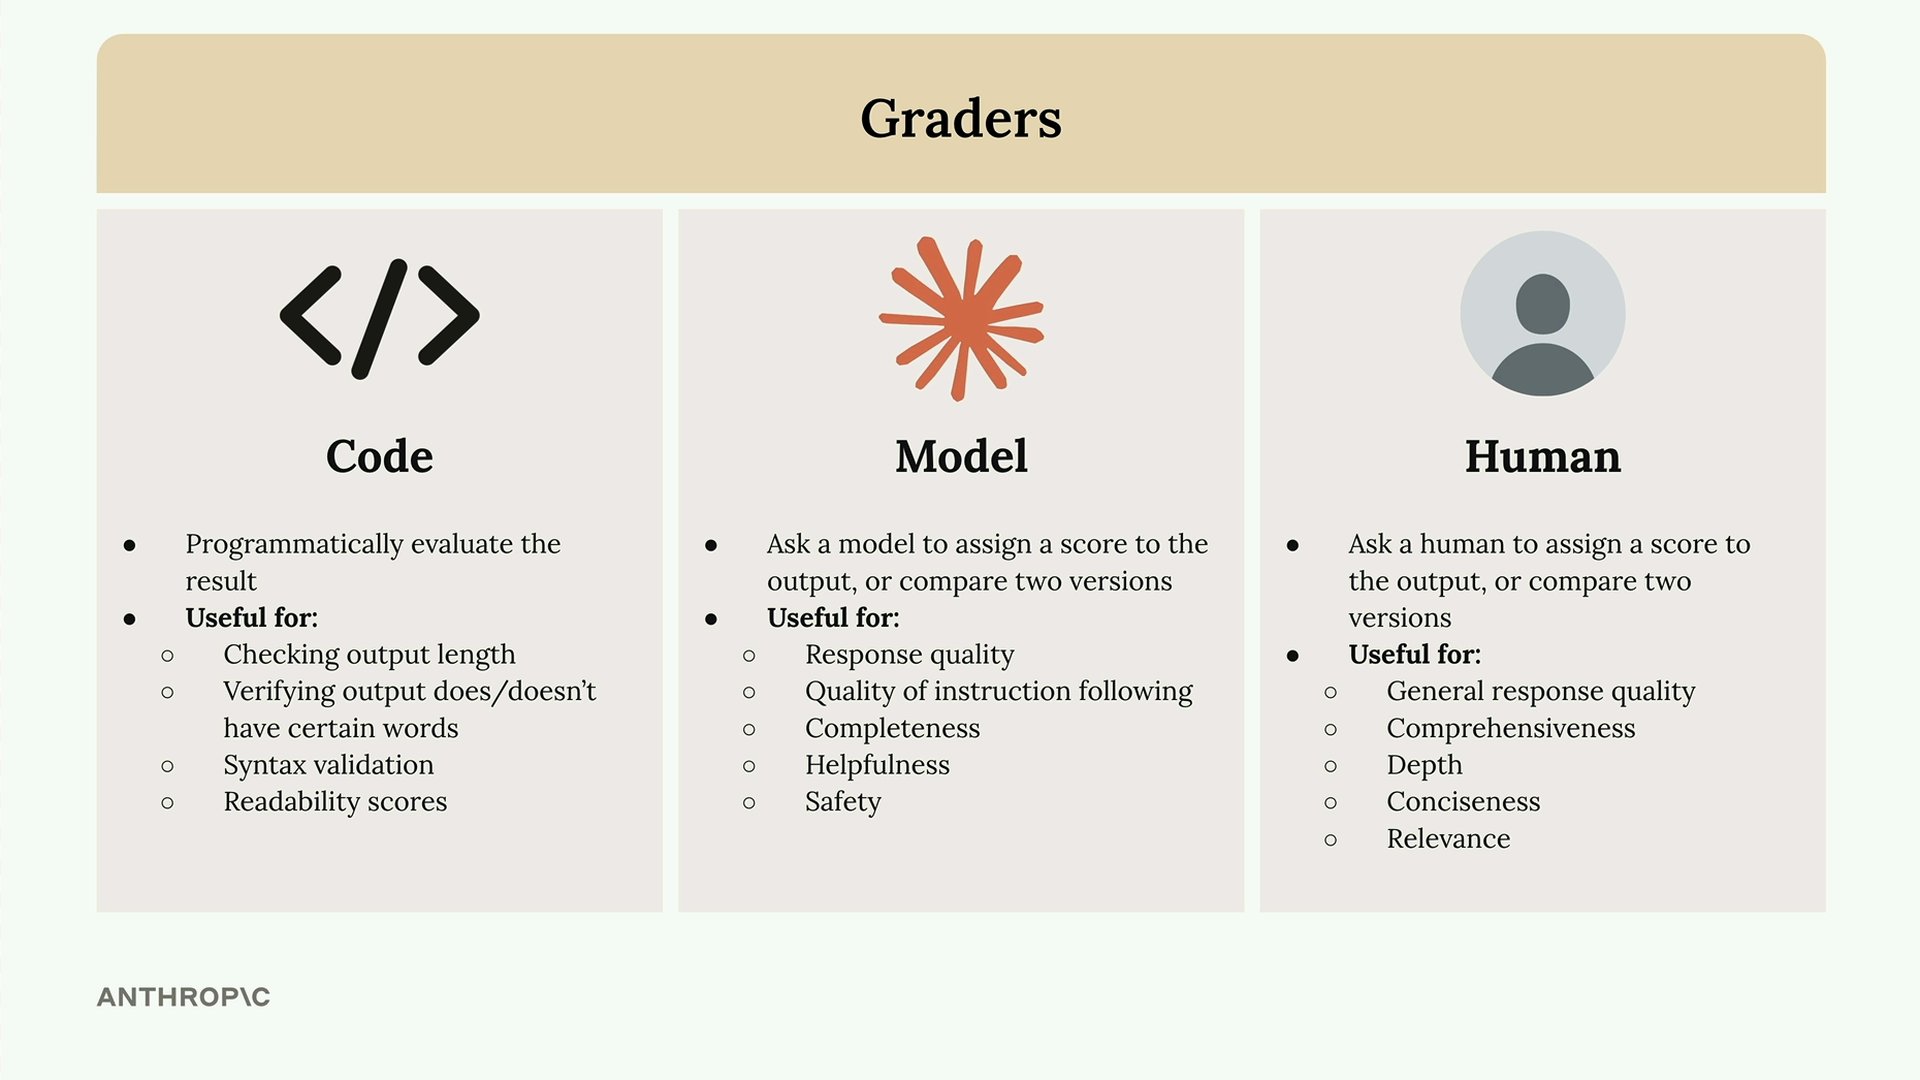
Il existe trois approches principales pour évaluer les résultats d'un modèle :
- Évaluateurs par code - Évaluent les résultats de manière programmatique à l'aide d'une logique personnalisée
- Évaluateurs par modèle - Utilisent un autre modèle d'IA pour évaluer la qualité
- Évaluateurs humains - Font appel à des personnes pour examiner et noter manuellement les résultats
Évaluateurs par code
Les évaluateurs par code vous permettent de mettre en œuvre n'importe quelle vérification programmatique imaginable. Les usages courants incluent :
- Vérification de la longueur du résultat
- Vérification de la présence ou de l'absence de certains mots dans le résultat
- Validation de la syntaxe pour JSON, Python ou les expressions régulières
- Scores de lisibilité
La seule exigence est que votre code renvoie un signal exploitable - généralement un nombre entre 1 et 10.
Évaluateurs par modèle
Les évaluateurs par modèle transmettent votre résultat initial dans un autre appel API à des fins d'évaluation. Cette approche offre une flexibilité considérable pour évaluer :
- La qualité de la réponse
- La qualité du respect des instructions
- L'exhaustivité
- L'utilité
- La sécurité
Évaluateurs humains
Les évaluateurs humains offrent la plus grande flexibilité, mais demandent du temps et sont fastidieux. Ils sont utiles pour évaluer :
- La qualité générale de la réponse
- L'exhaustivité
- La profondeur
- La concision
- La pertinence
Définir les critères d'évaluation
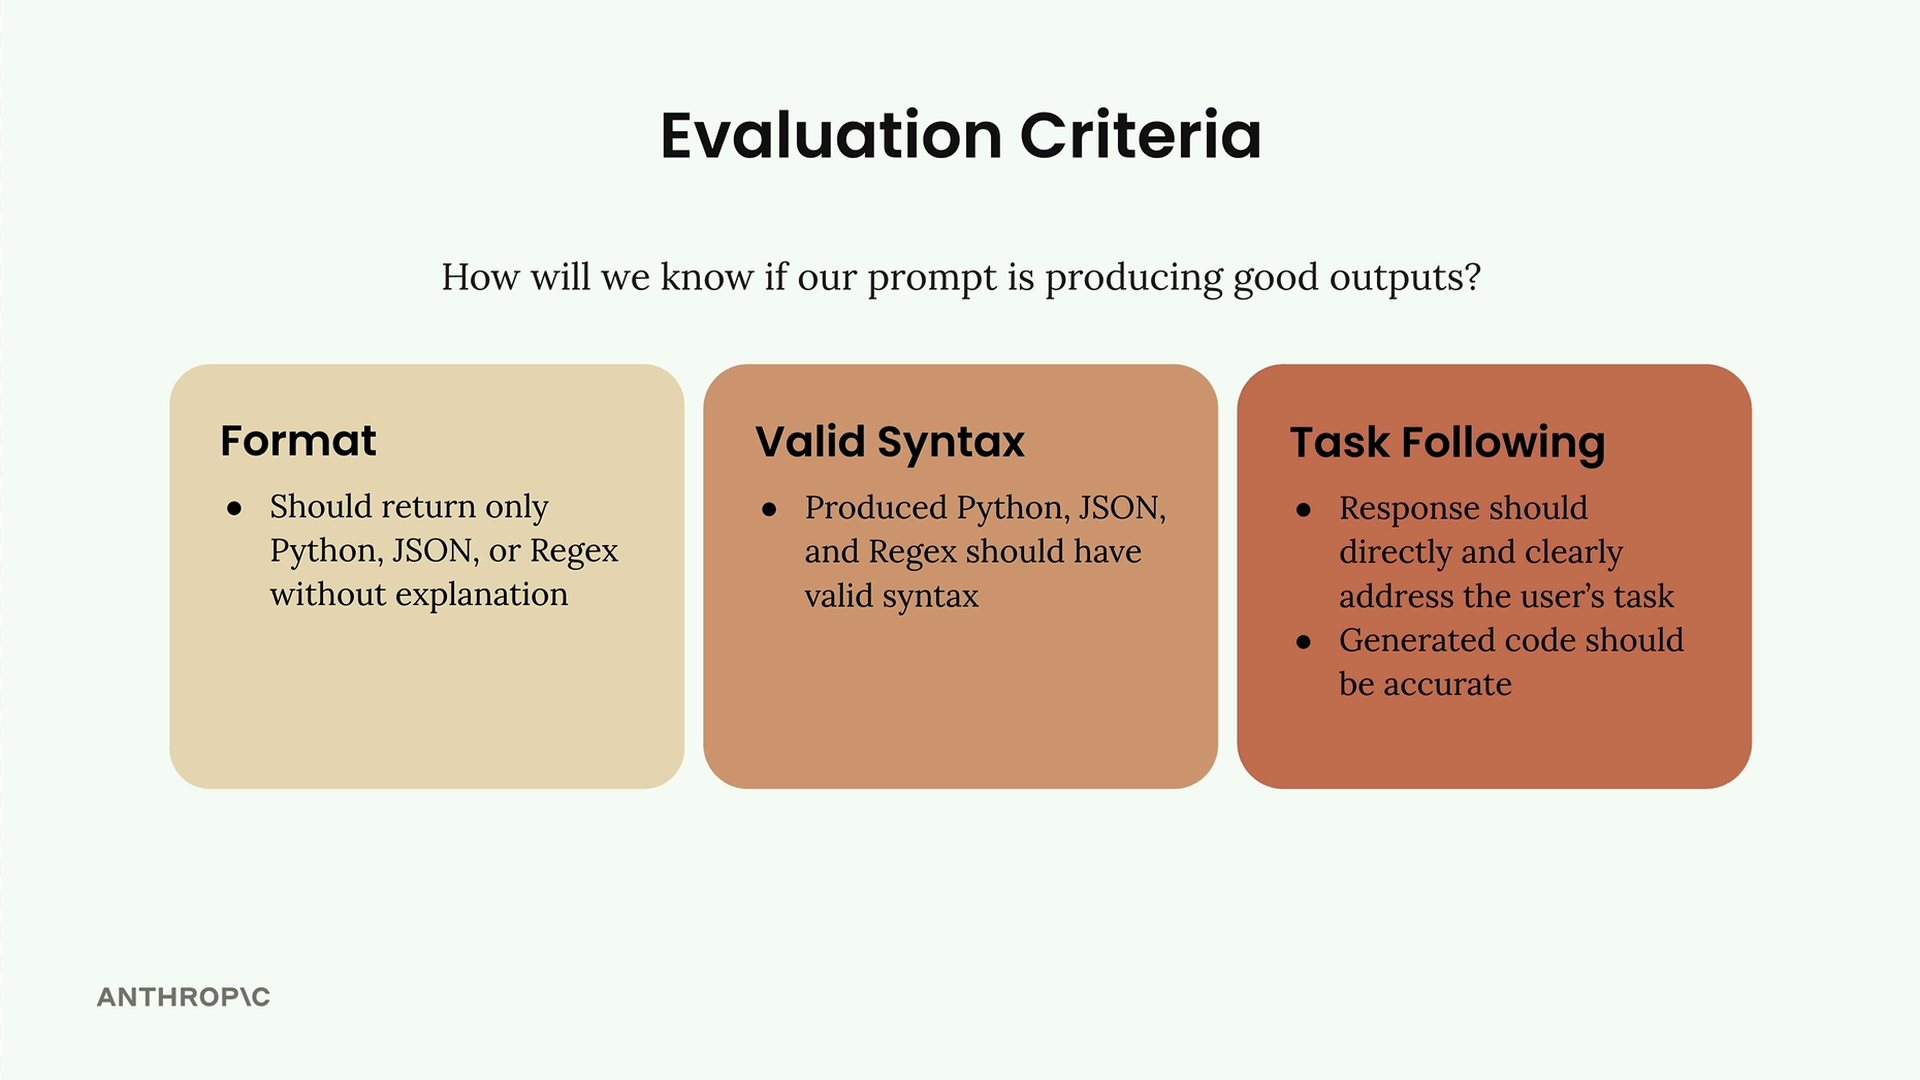
Avant de mettre en œuvre un évaluateur, vous devez définir des critères d'évaluation clairs. Pour une requête de génération de code, vous pourriez vous concentrer sur :
- Format - Ne devrait renvoyer que du Python, du JSON ou des expressions régulières, sans explication
- Syntaxe valide - Le code produit doit avoir une syntaxe valide
- Respect de la tâche - La réponse doit répondre directement à la tâche de l'utilisateur avec un code précis
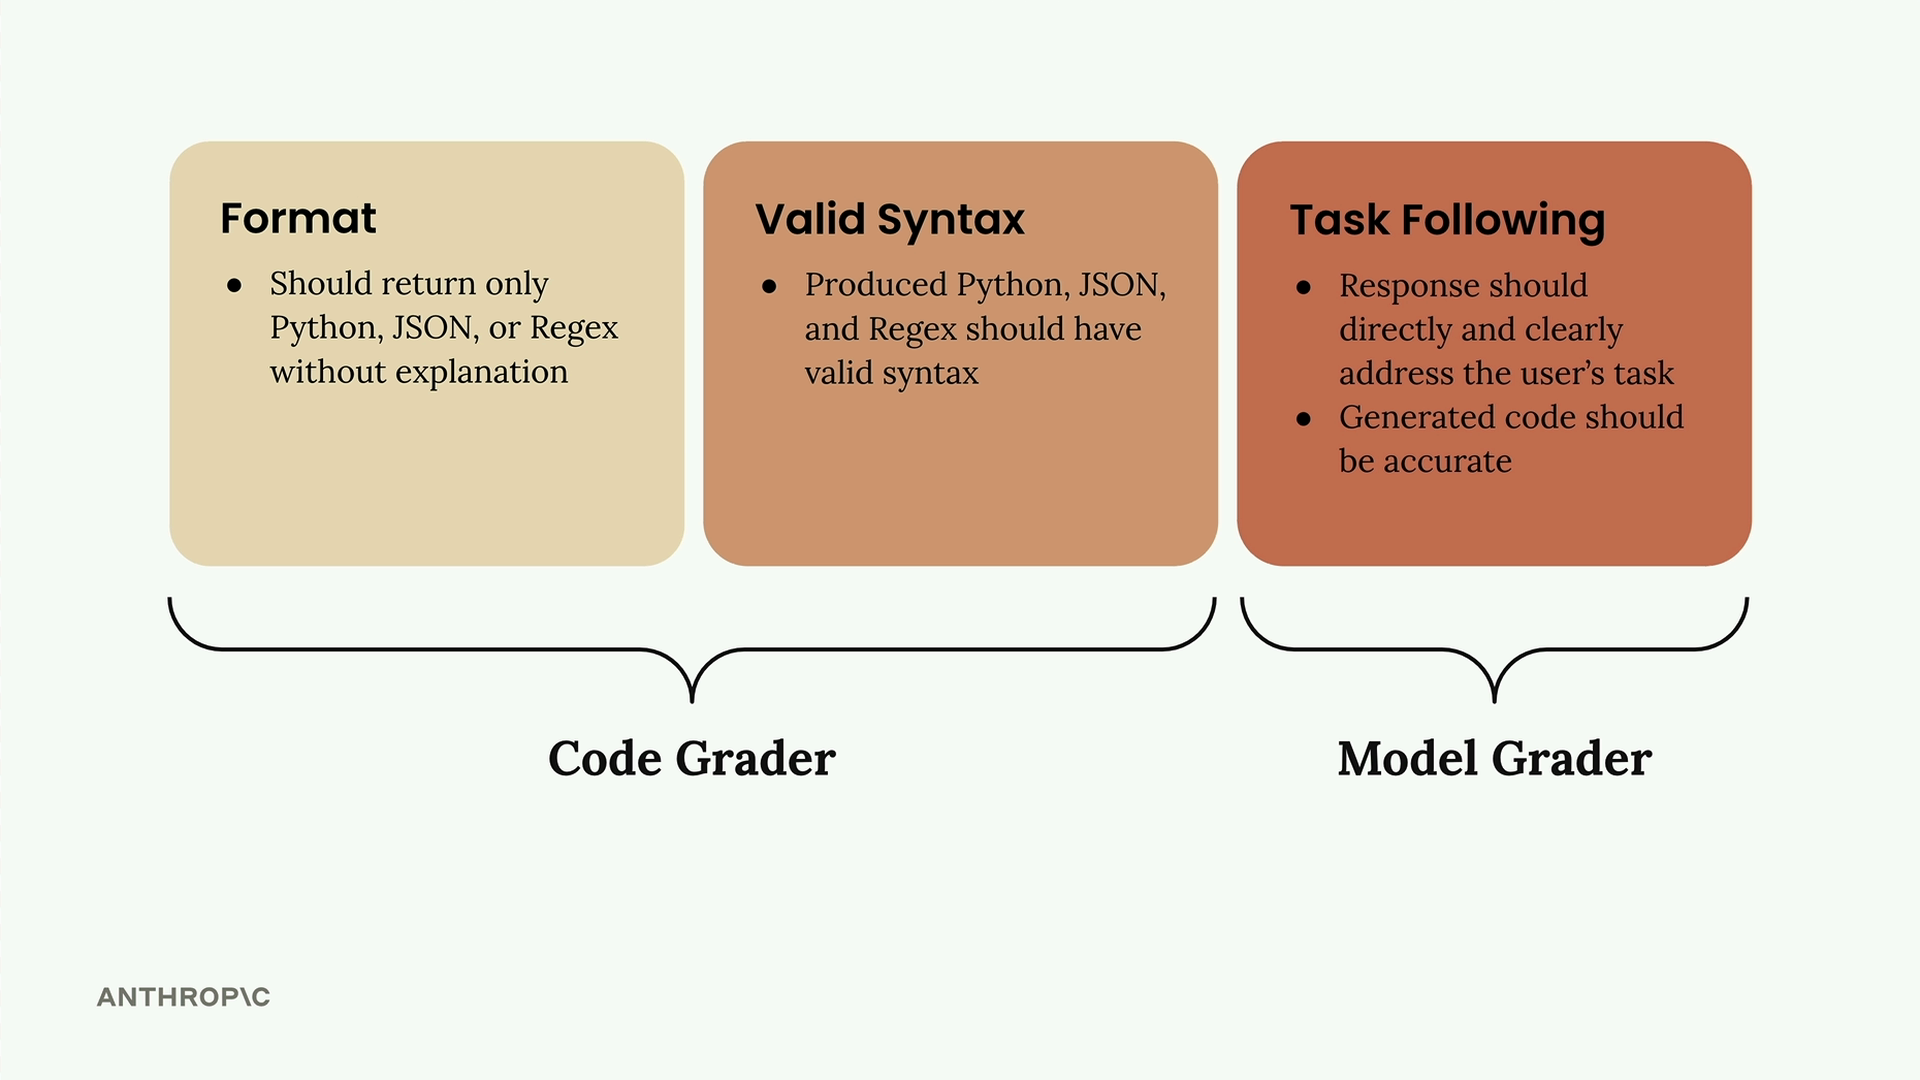
Les deux premiers critères fonctionnent bien avec les évaluateurs par code, tandis que le respect de la tâche convient mieux aux évaluateurs par modèle en raison de leur flexibilité.
Mettre en œuvre un évaluateur par modèle
Voici comment créer une fonction d'évaluateur par modèle :
def grade_by_model(test_case, output):
    # Créer une requête d'évaluation
    eval_prompt = f"""
    You are an expert code reviewer. Evaluate this AI-generated solution.

    Task: {test_case["task"]}
    Solution: {output}

    Provide your evaluation as a structured JSON object with:
    - "strengths": An array of 1-3 key strengths
    - "weaknesses": An array of 1-3 key areas for improvement
    - "reasoning": A concise explanation of your assessment
    - "score": A number between 1-10
    """

    messages = []
    add_user_message(messages, eval_prompt)
    add_assistant_message(messages, "```json")

    eval_text = chat(messages, stop_sequences=["```"])
    return json.loads(eval_text)
L'idée clé est de demander les points forts, les points faibles et le raisonnement en plus du score. Sans ce contexte, les modèles ont tendance à revenir par défaut à des scores médiocres autour de 6.
Intégrer l'évaluation dans votre flux de travail
Mettez à jour votre exécuteur de cas de test pour appeler l'évaluateur :
def run_test_case(test_case):
    output = run_prompt(test_case)

    # Noter le résultat
    model_grade = grade_by_model(test_case, output)
    score = model_grade["score"]
    reasoning = model_grade["reasoning"]

    return {
        "output": output,
        "test_case": test_case,
        "score": score,
        "reasoning": reasoning
    }
Enfin, calculez un score moyen pour l'ensemble des cas de test :
from statistics import mean

def run_eval(dataset):
    results = []

    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    average_score = mean([result["score"] for result in results])
    print(f"Average score: {average_score}")

    return results
Cela vous fournit une métrique objective à suivre au fur et à mesure que vous itérez sur votre requête. Bien que les évaluateurs par modèle puissent parfois se révéler capricieux, ils offrent une référence cohérente pour mesurer les améliorations.