Lorsque vous combinez l'utilisation d'outils avec le streaming dans Claude, vous obtenez des mises à jour en temps réel à mesure que l'IA génère les arguments d'outils. Cela crée une expérience utilisateur plus réactive, mais il y a quelques détails importants à comprendre sur la façon dont cela fonctionne en coulisses.
Streaming d'outils de base
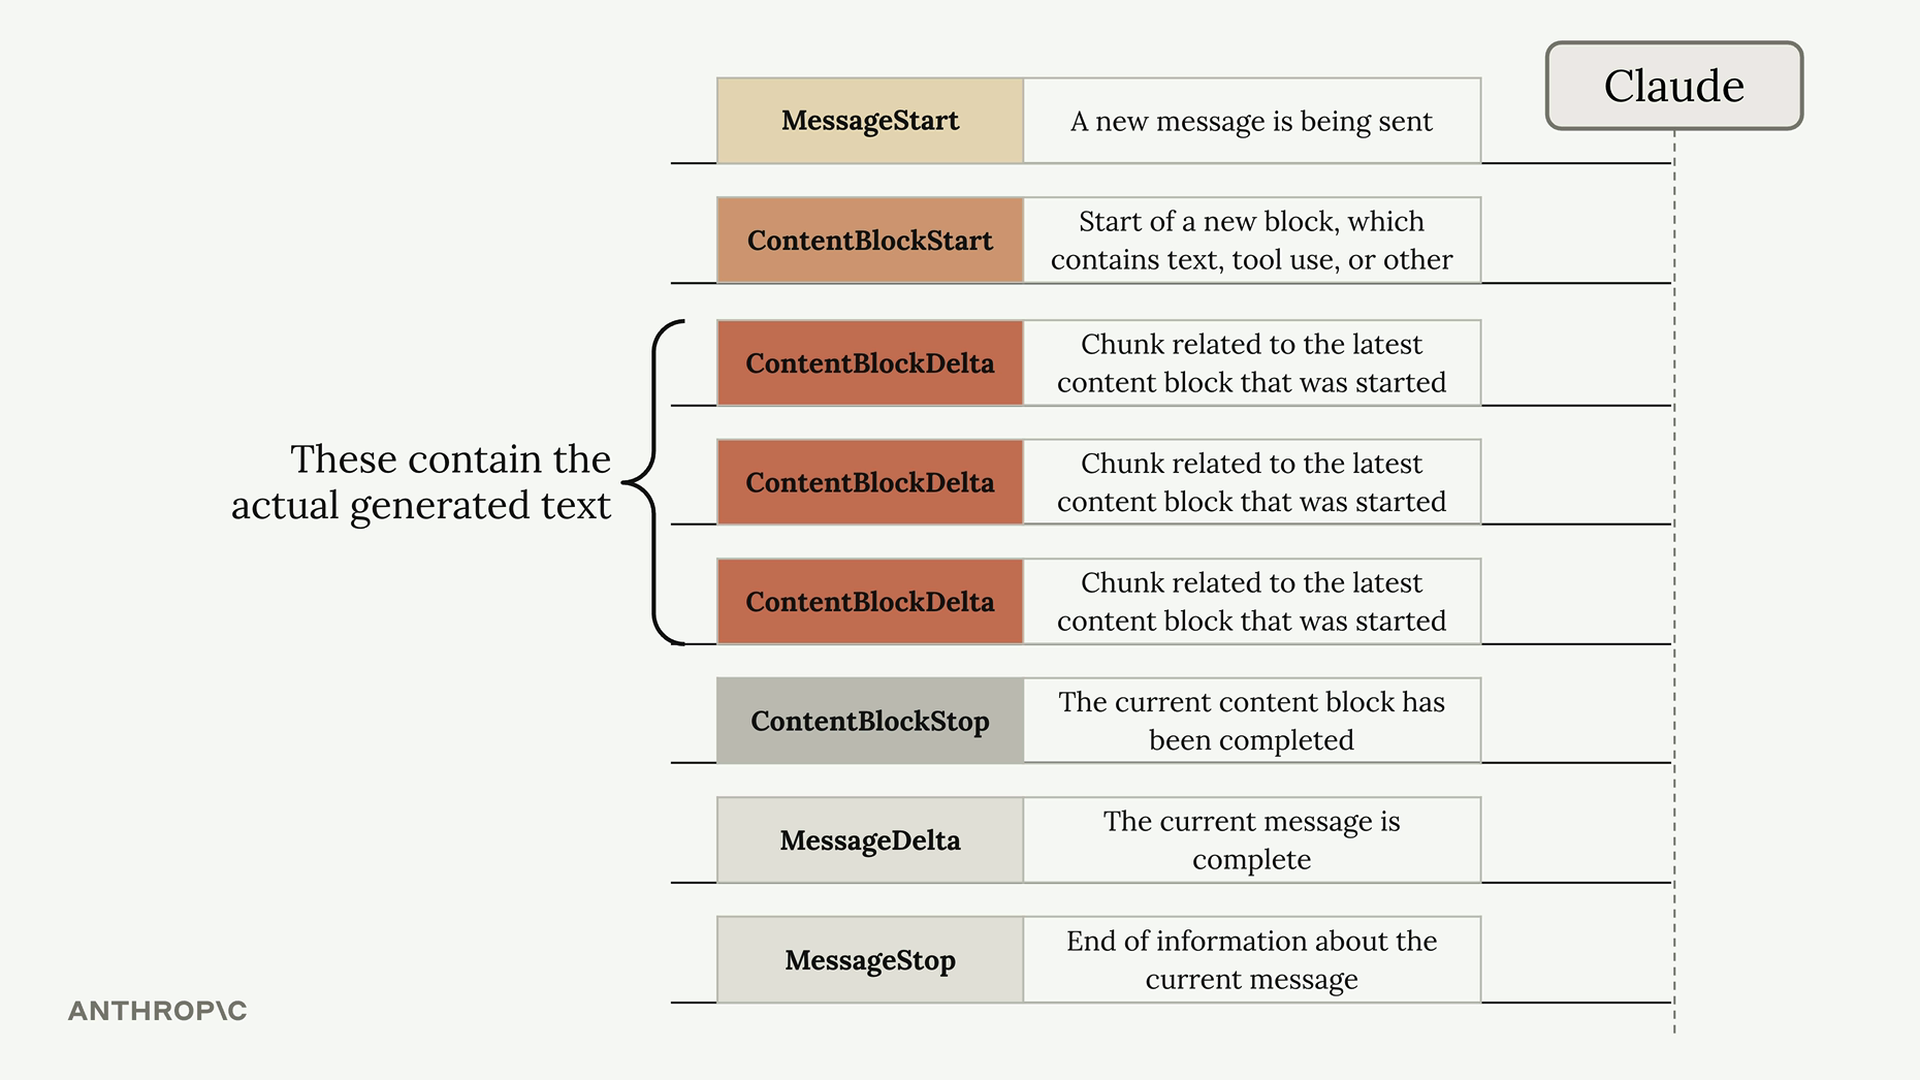
Avec le streaming activé, Claude renvoie différents types d'événements à mesure qu'il traite votre requête. Vous connaissez déjà des événements comme ContentBlockDelta pour la génération de texte classique. Pour l'utilisation d'outils, vous devrez également gérer un nouveau type d'événement appelé InputJsonEvent.
Chaque InputJsonEvent contient deux propriétés clés :
- partial_json - Un fragment de JSON représentant une partie des arguments d'outil
- snapshot - Le JSON cumulatif construit à partir de tous les fragments reçus jusqu'à présent
Voici comment gérer ces événements dans votre pipeline de streaming :
for chunk in stream:
    if chunk.type == "input_json":
        # Traiter le fragment JSON partiel
        print(chunk.partial_json)
        # Ou utiliser l'instantané complet jusqu'à présent
        current_args = chunk.snapshot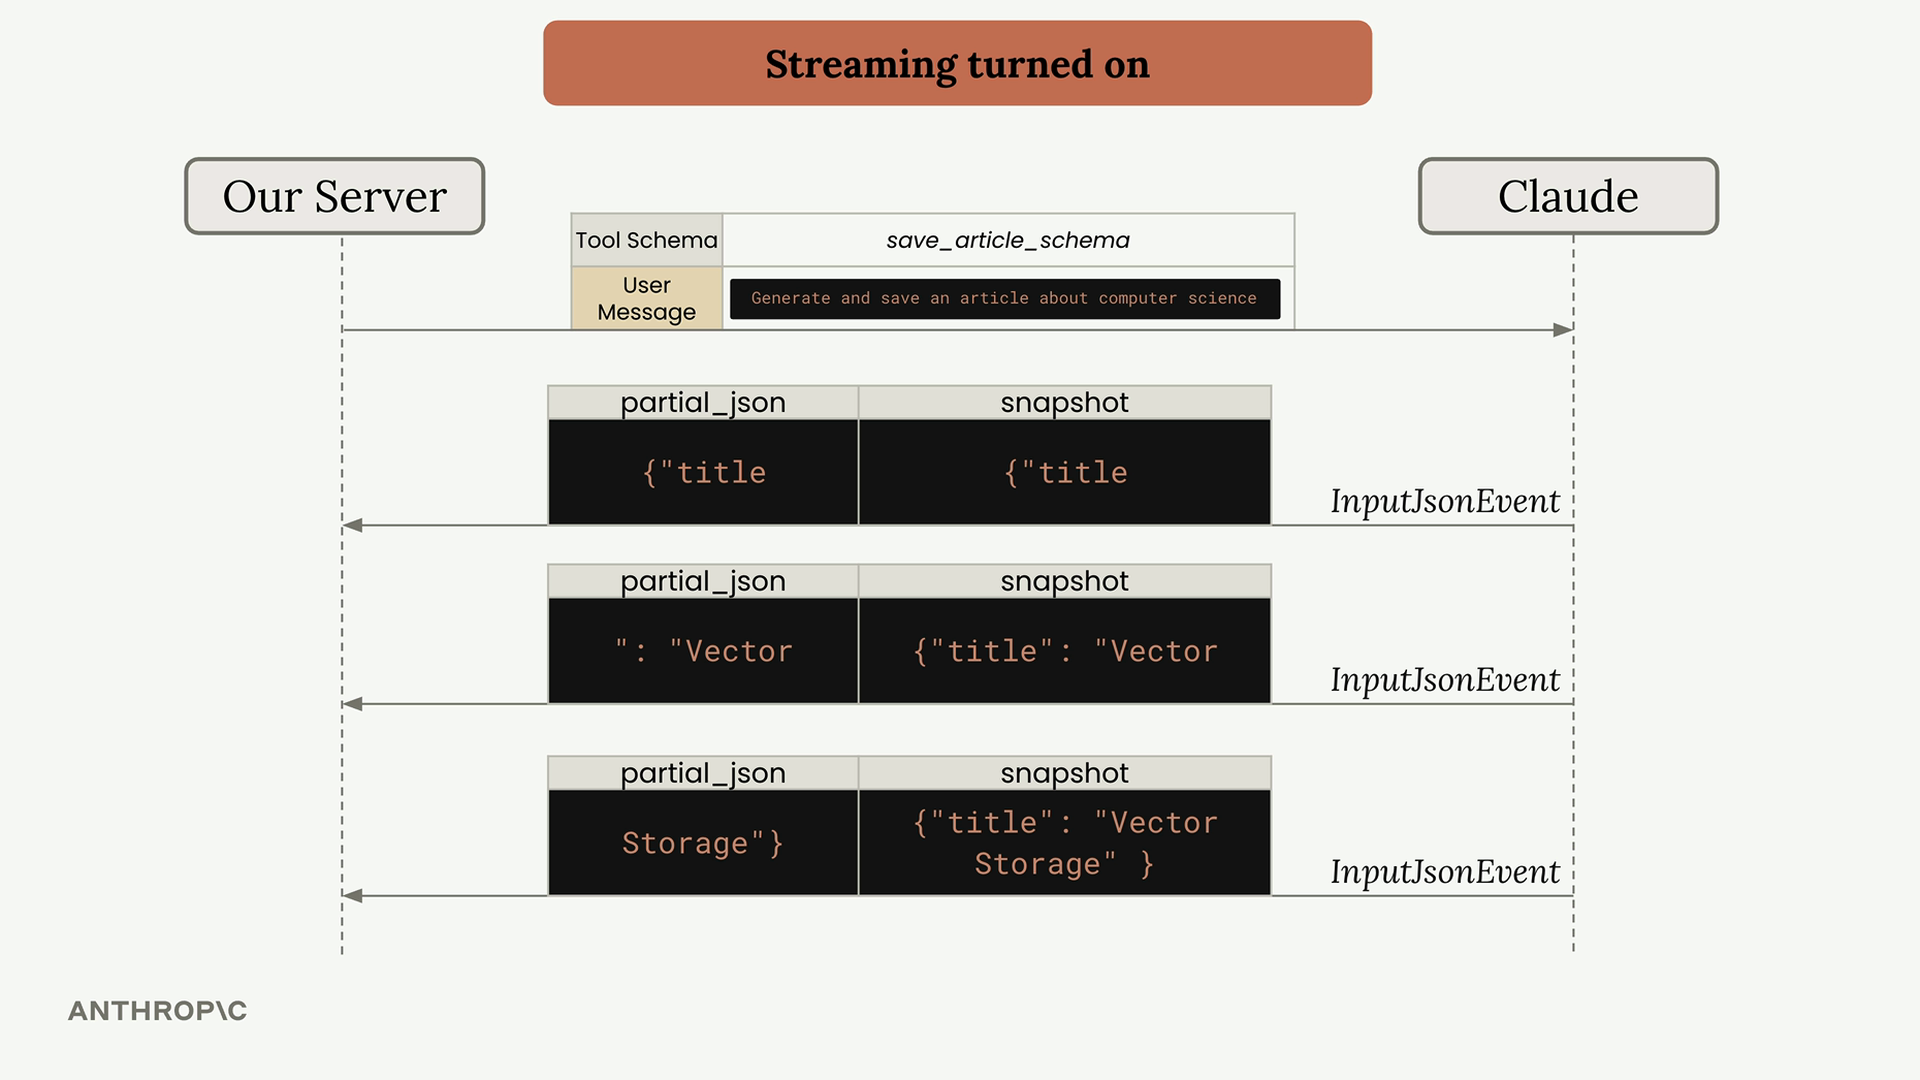
Comment fonctionne la validation JSON
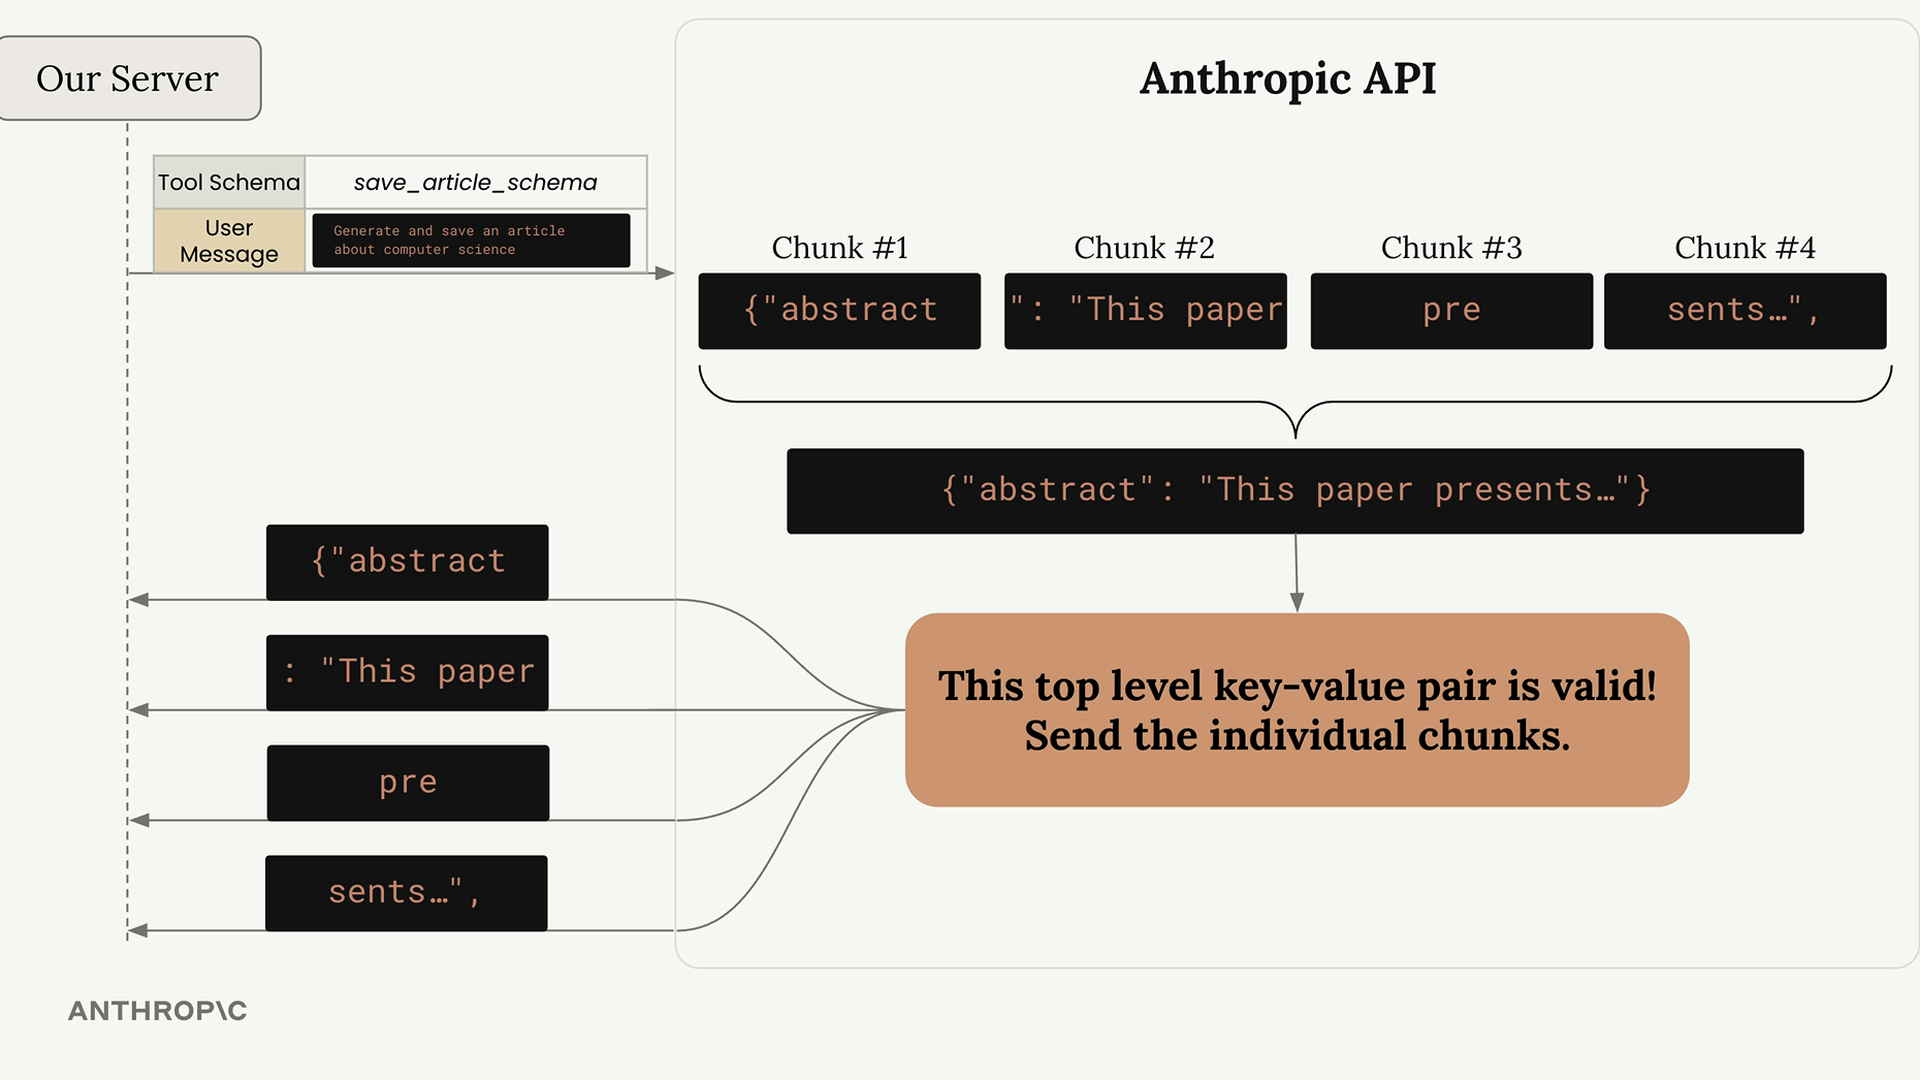
C'est ici que les choses deviennent intéressantes. L'API Anthropic ne vous envoie pas immédiatement chaque fragment au fur et à mesure que Claude le génère. Elle met plutôt les fragments en mémoire tampon et les valide d'abord.
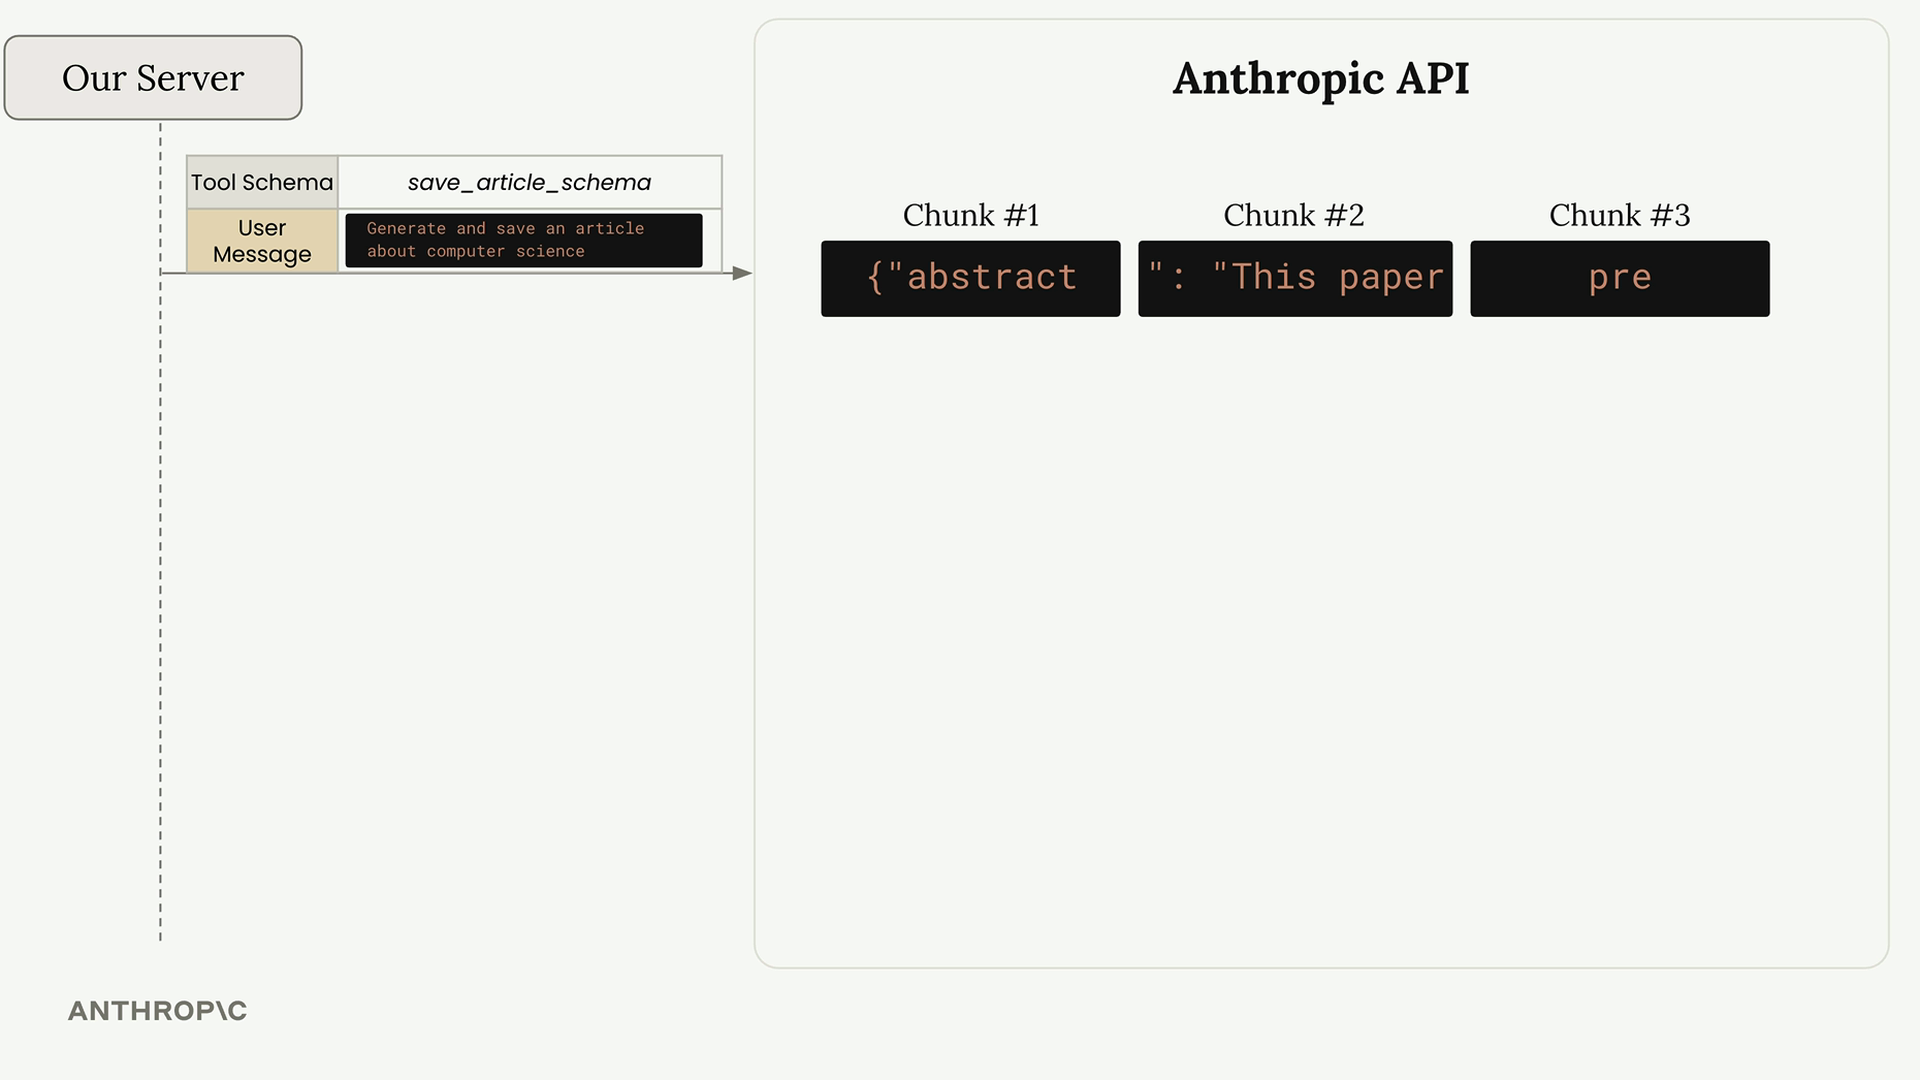
L'API attend que les paires clé-valeur de premier niveau soient complètes avant d'envoyer quoi que ce soit. Par exemple, si votre outil attend cette structure :
{
  "abstract": "This paper presents a novel...",
  "meta": {
    "word_count": 847,
    "review": "This paper introduces QuanNet..."
  }
}
L'API va :
- Attendre que la valeur complète d'
abstractsoit terminée - Valider cette paire clé-valeur par rapport à votre schéma
- Envoyer d'un seul coup tous les fragments mis en mémoire tampon pour
abstract - Répéter le processus pour l'objet
meta
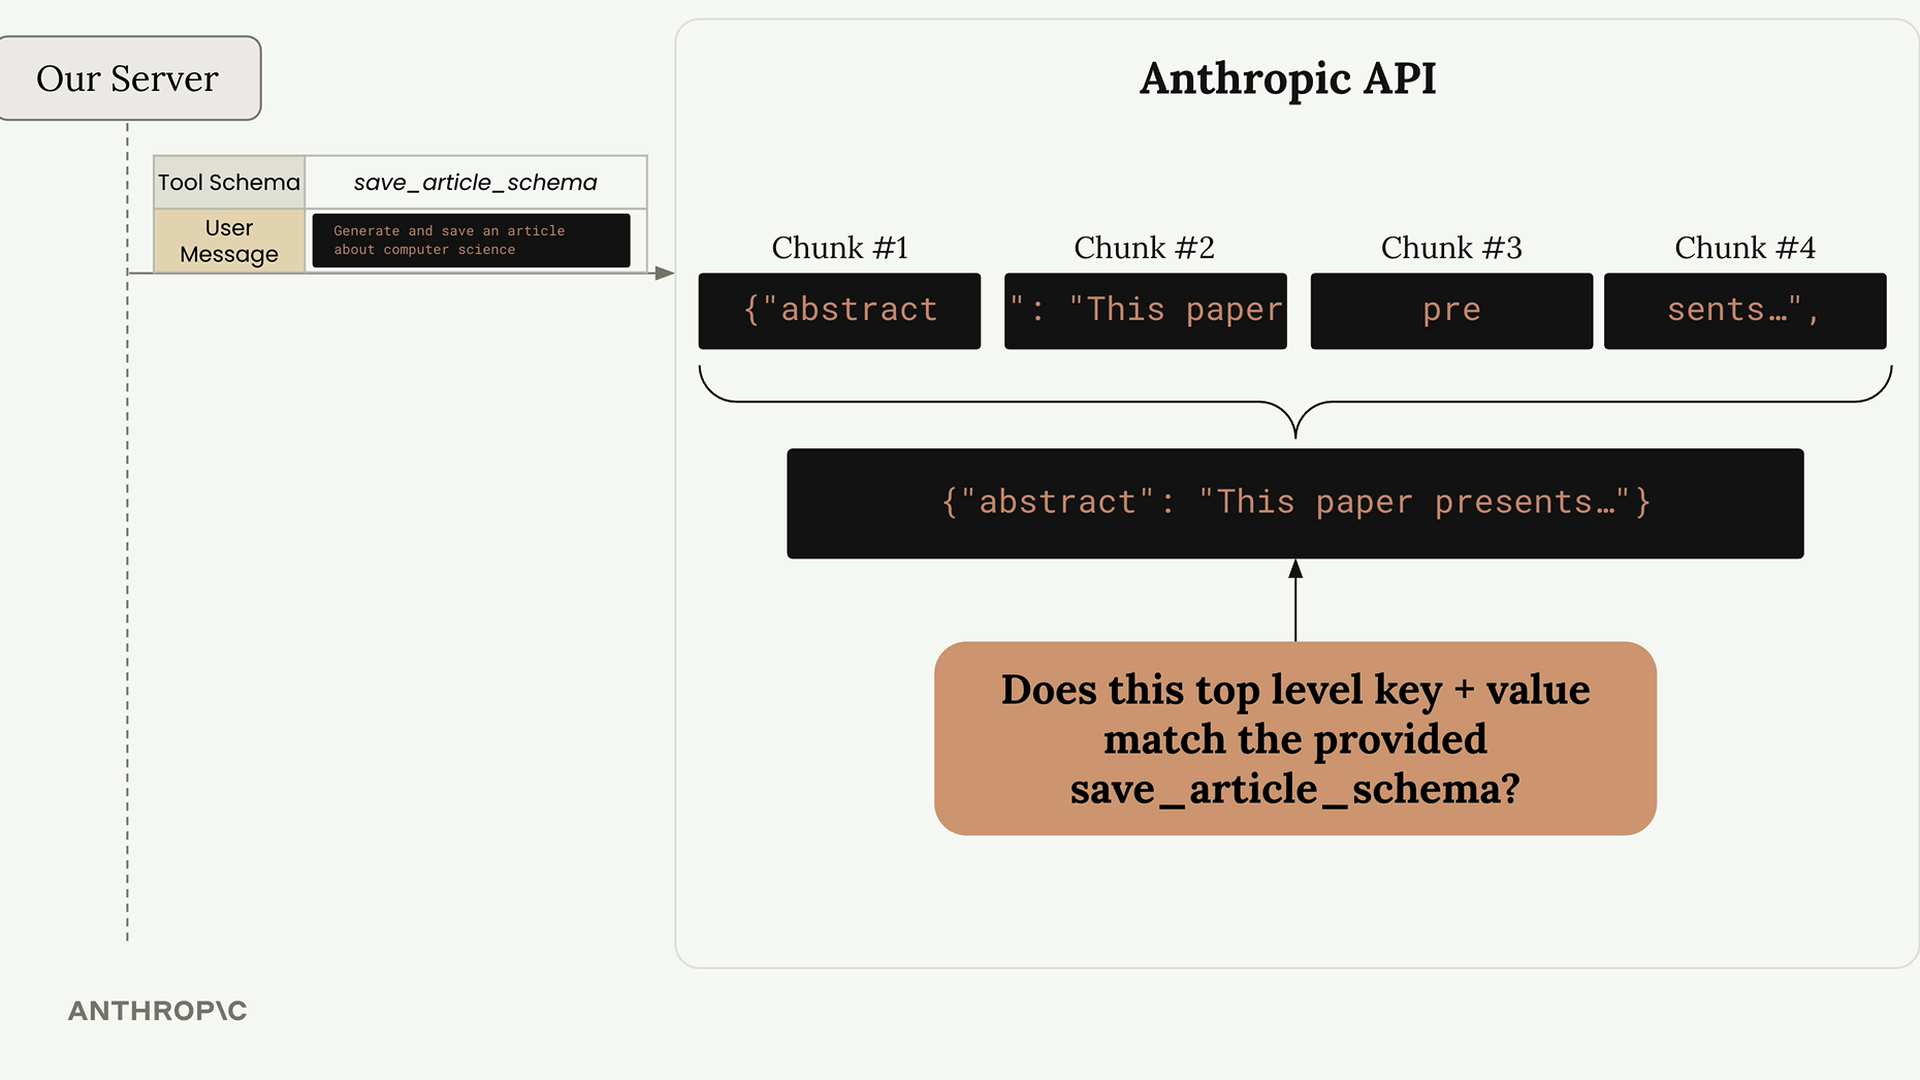
Ce processus de validation explique pourquoi vous observez des délais suivis de rafales de texte, même avec le streaming activé. Les fragments sont retenus jusqu'à ce qu'une paire clé-valeur de premier niveau complète et valide soit prête.
Appel d'outils à granularité fine
Si vous avez besoin d'un streaming plus rapide et plus granulaire - peut-être pour montrer aux utilisateurs des mises à jour immédiates ou commencer à traiter des résultats partiels rapidement - vous pouvez activer l'appel d'outils à granularité fine.
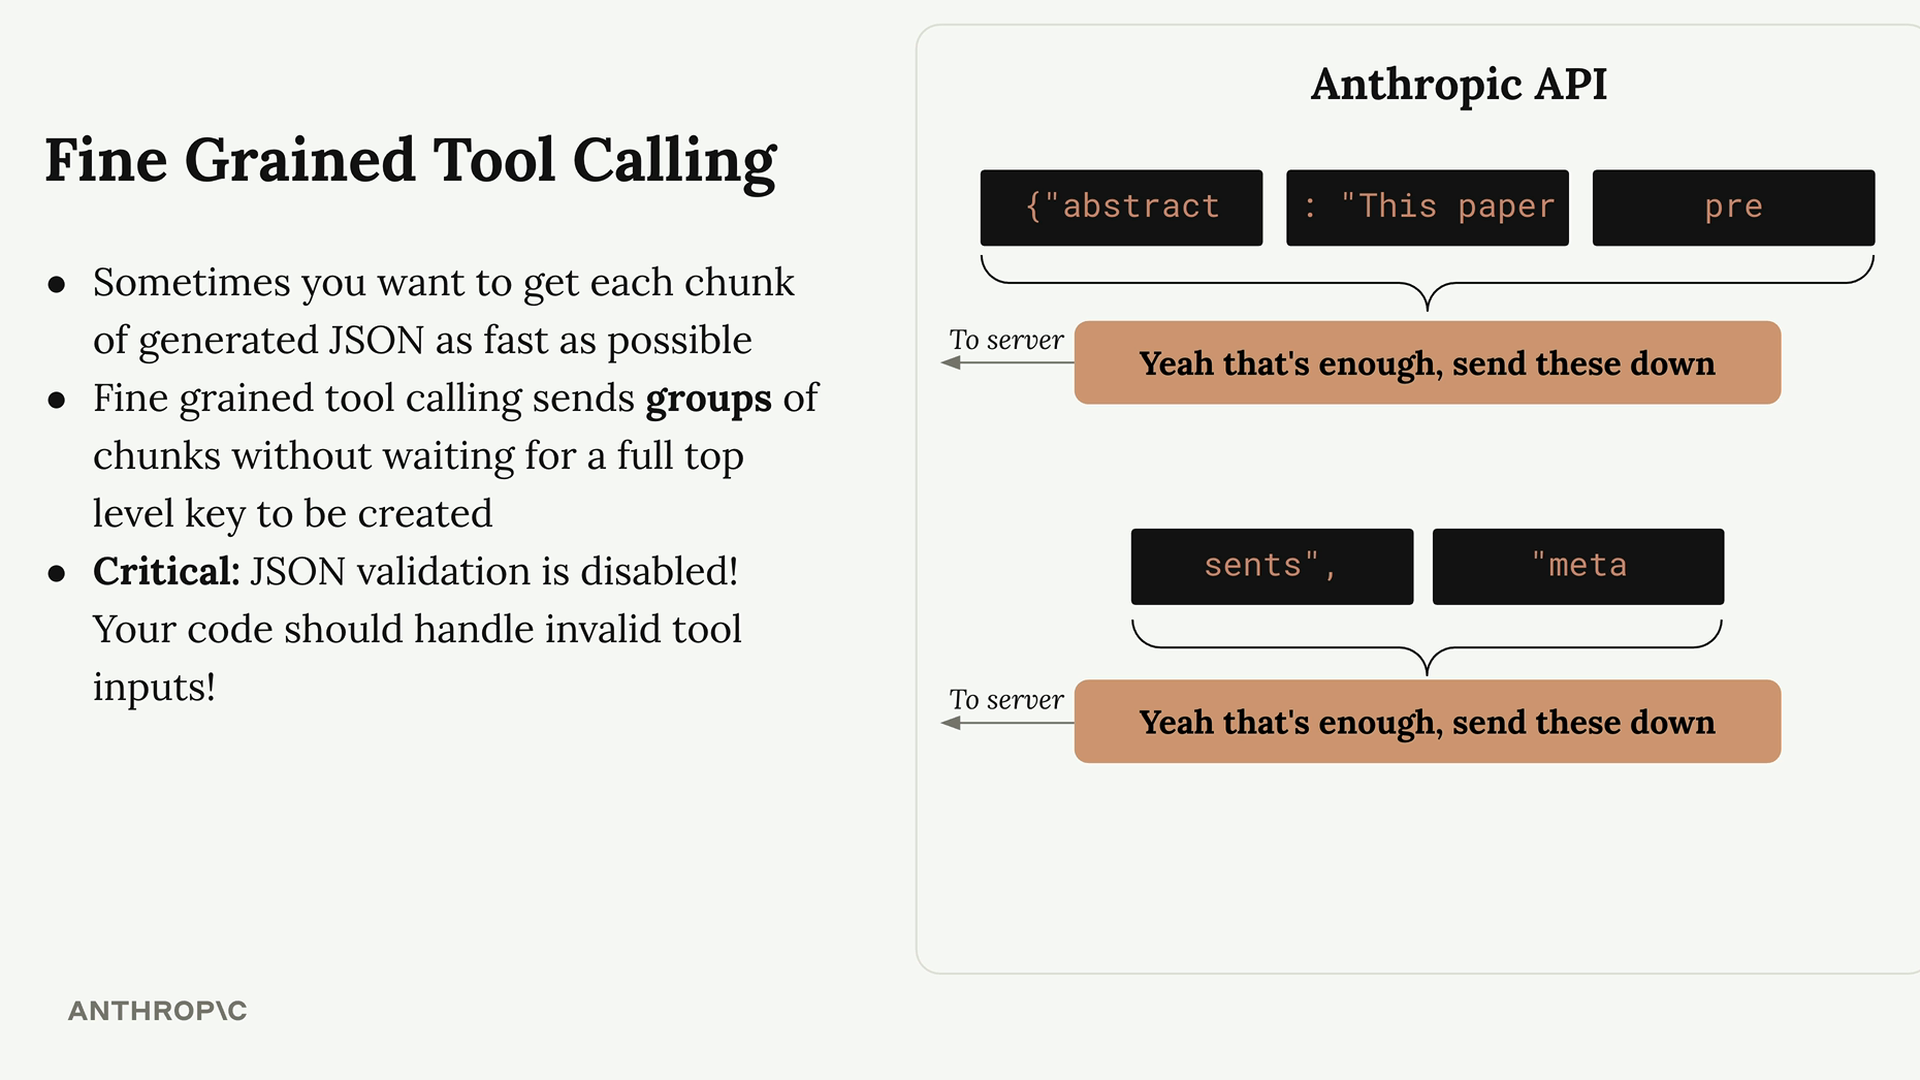
L'appel d'outils à granularité fine fait essentiellement une chose : il désactive la validation JSON côté API. Cela signifie que :
- Vous recevez les fragments dès que Claude les génère
- Il n'y a pas de délais de mise en mémoire tampon entre les clés de premier niveau
- Un comportement de streaming plus traditionnel
- Important : la validation JSON est désactivée - votre code doit gérer le JSON invalide
Activez-le en définissant eager_input_streaming sur True pour l'outil :
run_conversation(
    messages,
    tools=[{**save_article_schema, "eager_input_streaming": True}]
)
Avec l'appel d'outils à granularité fine, vous pourriez recevoir une valeur word_count bien plus tôt dans le flux, sans attendre que l'objet meta entier soit terminé.
Gérer le JSON invalide
Lors de l'utilisation de l'appel d'outils à granularité fine, Claude peut générer du JSON invalide comme "word_count": undefined au lieu d'un nombre correct. Votre application doit gérer ces cas avec élégance :
try:
    parsed_args = json.loads(chunk.snapshot)
except json.JSONDecodeError:
    # Gérer correctement le JSON invalide
    print("Received invalid JSON, continuing...")
Sans l'appel d'outils à granularité fine, la validation de l'API détecterait cette erreur et pourrait encapsuler les valeurs problématiques dans des chaînes de caractères, ce qui pourrait ne pas correspondre à votre schéma attendu.
Quand utiliser l'appel d'outils à granularité fine
Envisagez d'activer l'appel d'outils à granularité fine lorsque :
- Vous devez montrer aux utilisateurs une progression en temps réel de la génération des arguments d'outil
- Vous voulez commencer à traiter les résultats partiels d'outils aussi rapidement que possible
- Les délais de mise en mémoire tampon nuisent à l'expérience utilisateur
- Vous êtes à l'aise avec la mise en œuvre d'une gestion robuste des erreurs JSON
Pour la plupart des applications, le comportement par défaut avec validation est tout à fait adapté. Mais lorsque vous avez besoin de cette réactivité supplémentaire, l'appel d'outils à granularité fine vous donne le contrôle pour obtenir les fragments aussi vite que Claude peut les générer.