Maintenant que nous comprenons le flux RAG sur le plan conceptuel, mettons-le en œuvre étape par étape. Nous allons parcourir un exemple complet qui montre comment découper du texte en segments, générer des embeddings, les stocker dans une base de données vectorielle et effectuer des recherches de similarité.
La mise en œuvre du RAG en cinq étapes
Notre mise en œuvre suit les cinq mêmes étapes que nous avons abordées précédemment :
- Découper le texte par section
- Générer des embeddings pour chaque segment
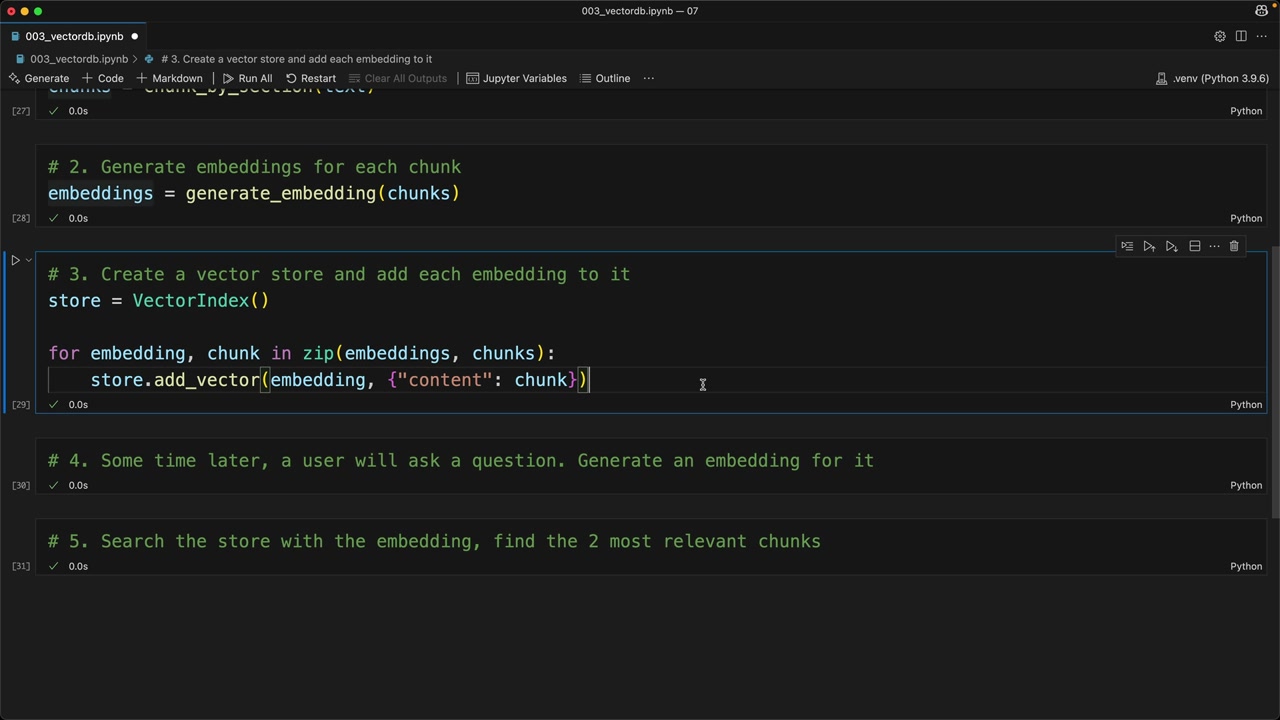
- Créer un magasin vectoriel et y ajouter chaque embedding
- Générer un embedding pour la question de l'utilisateur
- Rechercher dans le magasin pour trouver les segments les plus pertinents
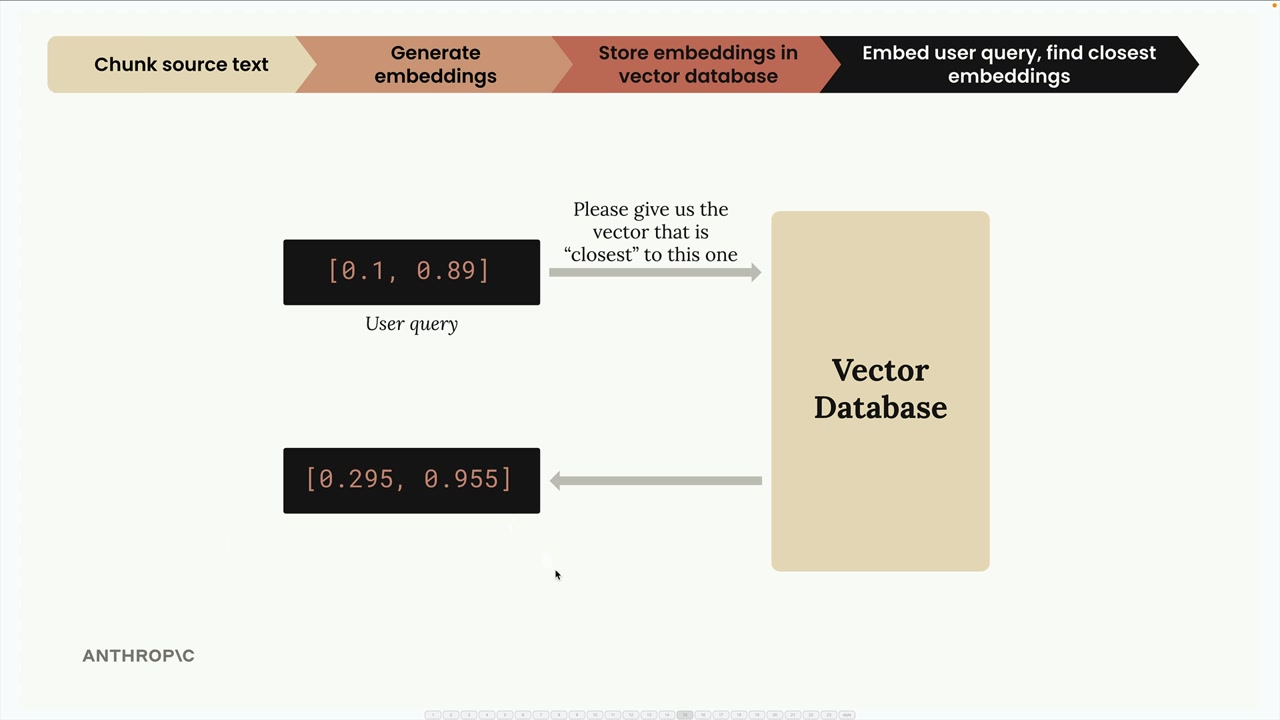
Ce schéma montre comment nous transformons les requêtes utilisateur en embeddings et comment nous effectuons une recherche dans notre base de données vectorielle pour trouver le contenu le plus pertinent.
Étape 1 : Découper le texte en segments
Tout d'abord, nous chargeons notre document et le découpons en sections gérables :
with open("./report.md", "r") as f:
    text = f.read()

chunks = chunk_by_section(text)
chunks[2]  # Test to see the table of contents
Nous utilisons la même fonction chunk_by_section que précédemment pour découper notre document en sections logiques.
Étape 2 : Générer des embeddings
Ensuite, nous créons des embeddings pour tous nos segments en une seule fois :
embeddings = generate_embedding(chunks)La fonction d'embedding a été mise à jour pour gérer à la fois des chaînes de caractères uniques et des listes de chaînes de caractères, ce qui la rend plus efficace pour le traitement par lots.
Étape 3 : Stocker dans la base de données vectorielle
Nous créons maintenant notre magasin vectoriel et le remplissons avec les embeddings et leur texte associé :
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
Remarquez que nous stockons à la fois l'embedding et le contenu textuel original. Cela est essentiel, car lorsque nous effectuons une recherche par la suite, nous devons renvoyer le texte réel, et non simplement les valeurs numériques de l'embedding.
Pourquoi stocker le texte original ?
Lorsque nous interrogeons notre base de données vectorielle, le fait de récupérer uniquement les nombres de l'embedding n'est pas utile. Nous avons besoin du texte réel qui a été utilisé pour générer ces embeddings. C'est pourquoi nous incluons le texte du segment original (ou du moins une référence à celui-ci) à côté de chaque embedding dans notre base de données.
Étape 4 : Traiter les requêtes des utilisateurs
Lorsqu'un utilisateur pose une question, nous générons un embedding pour sa requête :
user_embedding = generate_embedding("What did the software engineering dept do last year?")Étape 5 : Trouver le contenu pertinent
Enfin, nous effectuons une recherche dans notre magasin vectoriel pour trouver les segments les plus similaires :
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
Cette recherche renvoie les deux segments les plus pertinents, accompagnés de leurs scores de similarité (distances cosinus).
Les résultats de la recherche nous montrent quelles sections de notre document sont les plus pertinentes par rapport à la question de l'utilisateur, accompagnées des scores de similarité.
Comprendre les résultats
Lorsque nous exécutons notre exemple de requête concernant le département d'ingénierie logicielle, nous obtenons :
- Section 2 : Ingénierie logicielle avec une distance de 0,71 (correspondance la plus proche)
- Section Méthodologie avec une distance de 0,72 (deuxième correspondance la plus proche)
Des valeurs de distance plus faibles indiquent une similarité plus élevée, donc la Section 2 est la plus pertinente pour notre requête.
Et ensuite ?
Cette mise en œuvre fonctionne bien pour les cas de base, mais il existe des scénarios où elle ne fonctionne pas comme prévu. Dans les sections suivantes, nous explorerons des améliorations pour rendre notre système RAG plus robuste et plus précis.
Le point clé à retenir est que le RAG consiste fondamentalement à convertir du texte en nombres (embeddings), à stocker ces nombres de manière efficace, puis à utiliser la similarité mathématique pour trouver du contenu pertinent lorsque les utilisateurs posent des questions.