Lorsque vous créez des pipelines RAG, vous découvrirez rapidement que la recherche sémantique seule ne renvoie pas toujours les meilleurs résultats. Parfois, vous avez besoin de correspondances exactes de termes que la recherche sémantique pourrait manquer. La solution consiste à combiner la recherche sémantique avec la recherche lexicale en utilisant une technique appelée BM25.
Le problème de la recherche sémantique seule
Imaginons que vous recherchiez un identifiant d'incident spécifique comme « INC-2023-Q4-011 » dans un document. Bien que la recherche sémantique excelle à comprendre le contexte et le sens, elle pourrait renvoyer des sections sémantiquement liées mais qui ne contiennent pas réellement le terme exact que vous recherchez.
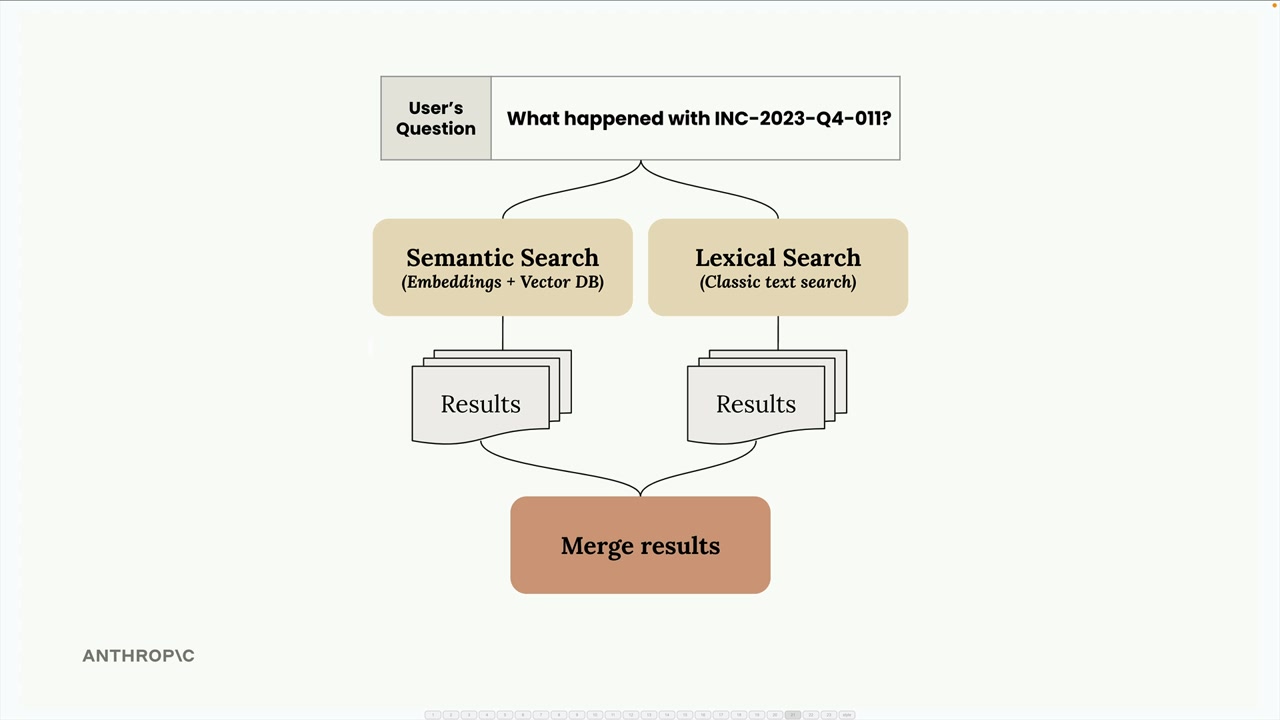
Dans l'exemple ci-dessus, la recherche sémantique a renvoyé la section cybersécurité (qui contient effectivement l'identifiant d'incident) mais a également renvoyé une section d'analyse financière qui ne mentionne pas du tout l'incident. Cela se produit parce que la recherche sémantique se concentre sur la similarité conceptuelle plutôt que sur la correspondance exacte des termes.
Stratégie de recherche hybride
La solution consiste à exécuter en parallèle les recherches sémantique et lexicale, puis à fusionner les résultats. Cela vous donne le meilleur des deux mondes :
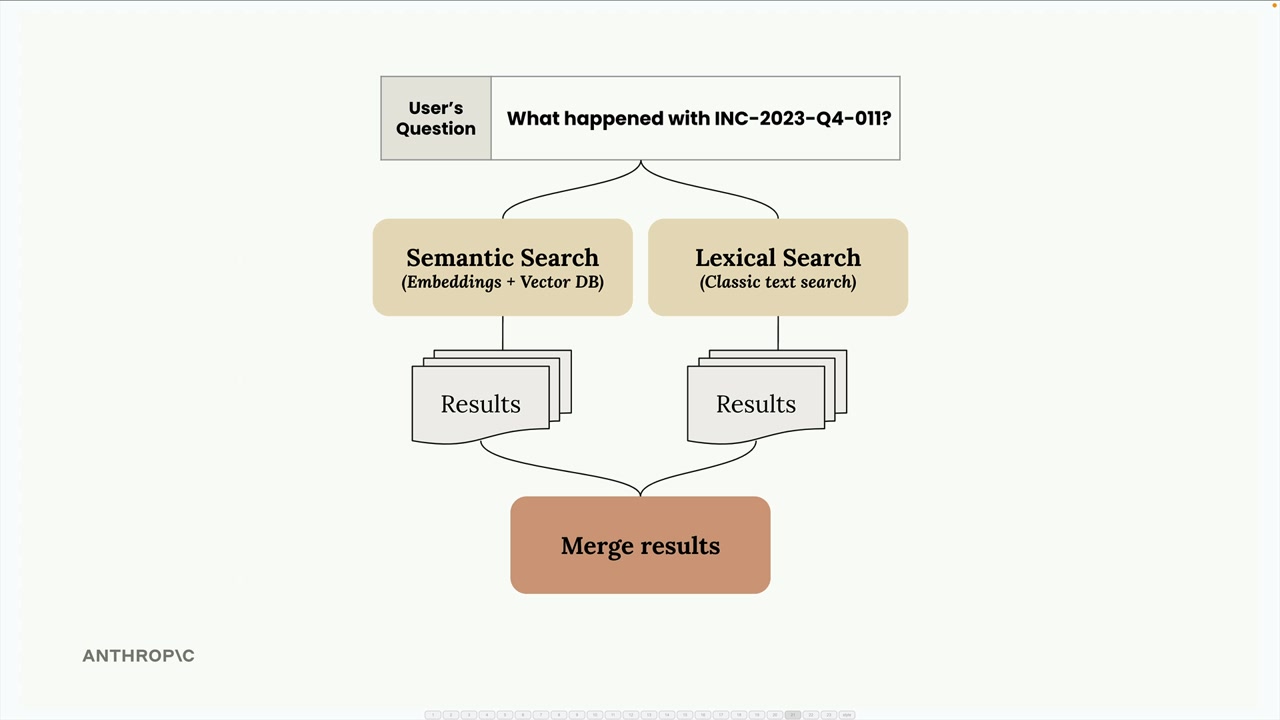
- La recherche sémantique trouve du contenu conceptuellement lié en utilisant des embeddings
- La recherche lexicale trouve des correspondances exactes de termes en utilisant la recherche de texte classique
- Les résultats fusionnés combinent les deux approches pour une meilleure précision
Comment fonctionne BM25
BM25 (Best Match 25) est un algorithme populaire pour la recherche lexicale dans les systèmes RAG. Voici comment il traite une requête de recherche :
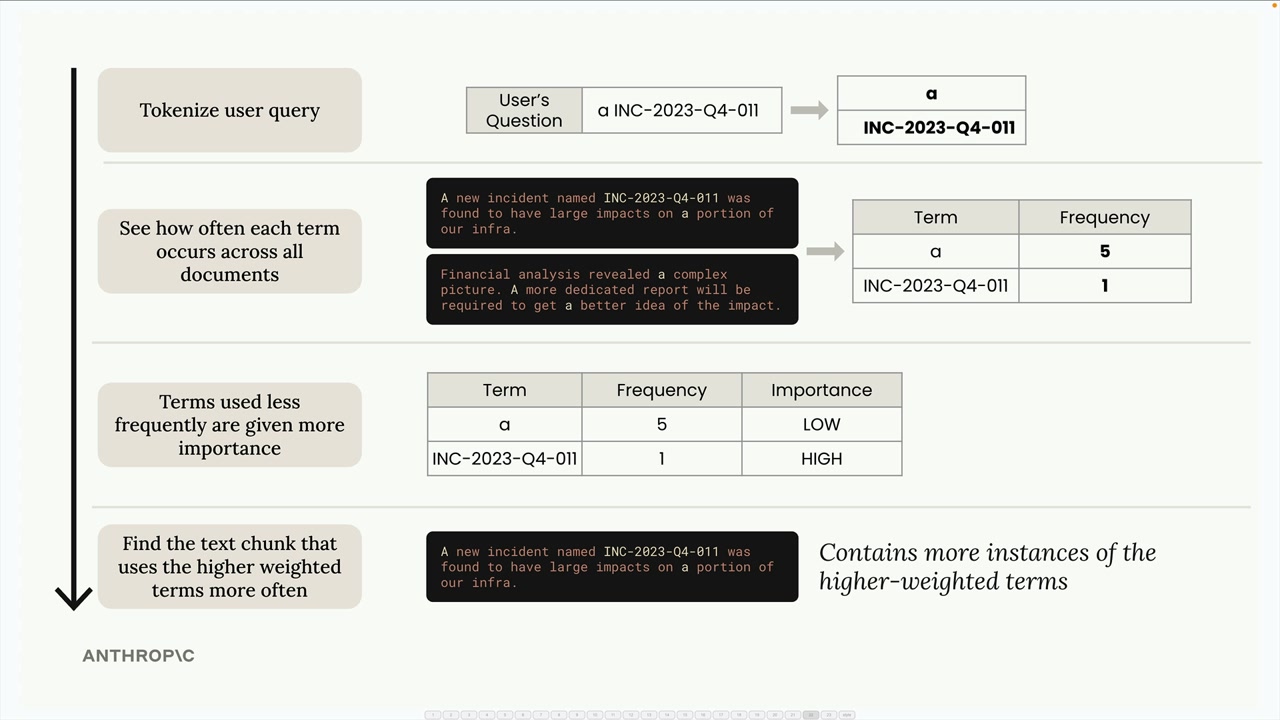
Étape 1 : Tokeniser la requête Découpez la question de l'utilisateur en termes individuels. Par exemple, « a INC-2023-Q4-011 » devient ["a", "INC-2023-Q4-011"].
Étape 2 : Compter la fréquence des termes Observez la fréquence d'apparition de chaque terme dans l'ensemble de vos documents. Les mots courants comme « a » peuvent apparaître 5 fois, tandis que des termes spécifiques comme « INC-2023-Q4-011 » peuvent n'apparaître qu'une seule fois.
Étape 3 : Pondérer les termes selon leur importance Les termes qui apparaissent moins fréquemment obtiennent des scores d'importance plus élevés. Le mot « a » obtient une faible importance parce qu'il est courant, tandis que « INC-2023-Q4-011 » obtient une importance élevée parce qu'il est rare.
Étape 4 : Trouver les meilleures correspondances Renvoyez les documents qui contiennent le plus d'instances des termes les plus fortement pondérés.
Mettre en œuvre la recherche BM25
Voici comment configurer un système de recherche BM25 basique :
# 1. Découpez votre texte par sections
chunks = chunk_by_section(text)

# 2. Créez un magasin BM25 et ajoutez des documents
store = BM25Index()
for chunk in chunks:
    store.add_document({"content": chunk})

# 3. Effectuez une recherche dans le magasin
results = store.search("What happened with INC-2023-Q4-011?", 3)

# Afficher les résultats
for doc, distance in results:
    print(distance, "\n", doc["content"][:200], "\n----\n")
Lorsque vous exécutez cette recherche, vous obtiendrez de bien meilleurs résultats que la recherche sémantique seule. L'algorithme BM25 donne la priorité aux sections qui contiennent réellement vos termes de recherche spécifiques, en particulier les termes rares comme les identifiants d'incident.
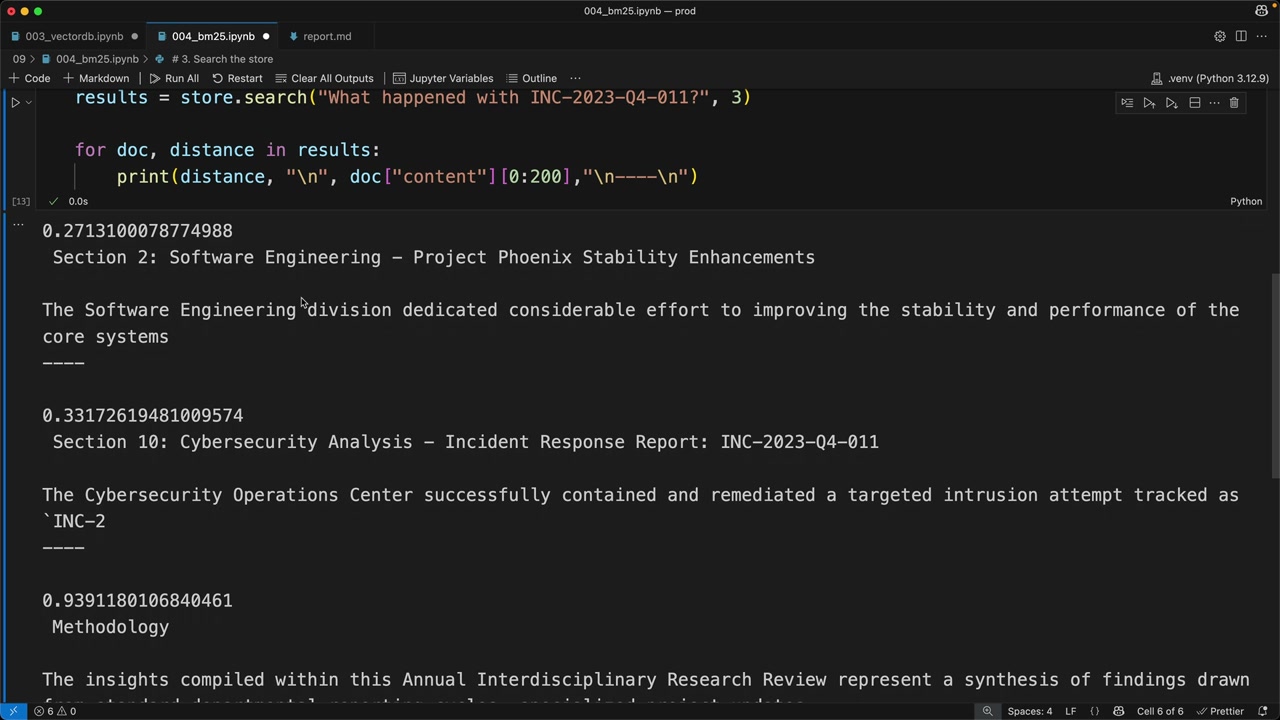
Remarquez comment les résultats donnent désormais correctement la priorité à la section Software Engineering et à la section Cybersecurity - qui contiennent toutes deux réellement l'identifiant d'incident que vous recherchez.
Pourquoi cela fonctionne mieux
BM25 excelle à trouver des correspondances exactes parce qu'il :
- Donne un poids plus élevé aux termes rares et spécifiques
- Ignore les mots courants qui n'ajoutent pas de valeur de recherche
- Se concentre sur la fréquence des termes plutôt que sur le sens sémantique
- Fonctionne particulièrement bien pour les termes techniques, les identifiants et les phrases spécifiques
L'idée clé est que les deux méthodes de recherche ont des forces complémentaires. La recherche sémantique comprend le contexte et le sens, tandis que la recherche lexicale garantit que vous ne manquez pas les correspondances exactes de termes. En les combinant, vous créez un système de recherche plus robuste qui gère efficacement à la fois les requêtes conceptuelles et les recherches spécifiques.
Dans l'étape suivante, vous apprendrez comment fusionner les résultats des deux systèmes de recherche pour créer une expérience de recherche hybride unifiée.