Claude peut lire et analyser directement des fichiers PDF, ce qui en fait un outil puissant pour le traitement de documents. Cette capacité fonctionne de manière similaire au traitement d'images, mais avec quelques différences clés dans la structuration de votre code.
Configuration du traitement des PDF
Pour traiter un fichier PDF avec Claude, vous utiliserez un code presque identique à celui que vous utiliseriez pour les images. Les principales différences concernent les spécifications de type de fichier et les noms de variables, à des fins de clarté.
Voici comment modifier votre code existant de traitement d'images pour les PDF :
with open("earth.pdf", "rb") as f:
    file_bytes = base64.standard_b64encode(f.read()).decode("utf-8")

messages = []

add_user_message(
    messages,
    [
        {
            "type": "document",
            "source": {
                "type": "base64",
                "media_type": "application/pdf",
                "data": file_bytes,
            },
        },
        {"type": "text", "text": "Summarize the document in one sentence"},
    ],
)

chat(messages)
Changements clés par rapport au traitement d'images
Lorsque vous adaptez votre code de traitement d'images pour les PDF, vous devez mettre à jour plusieurs éléments :
- Remplacer l'extension de fichier
.pngpar.pdf - Mettre à jour le nom de la variable
image_bytesenfile_bytespour plus de clarté - Définir le type sur
"document"au lieu de"image" - Remplacer le type de média par
"application/pdf"au lieu de"image/png"
Ce que Claude peut extraire des PDF
Les capacités de traitement de PDF de Claude vont au-delà de la simple extraction de texte. Il peut analyser et comprendre :
- Le contenu textuel de l'ensemble du document
- Les images et graphiques intégrés dans le PDF
- Les tableaux et les relations entre leurs données
- La structure et la mise en forme du document
Cela fait de Claude essentiellement une solution tout-en-un pour extraire tout type d'information de documents PDF, que vous ayez besoin de résumés, d'analyses de données ou d'extraction de contenu spécifique.
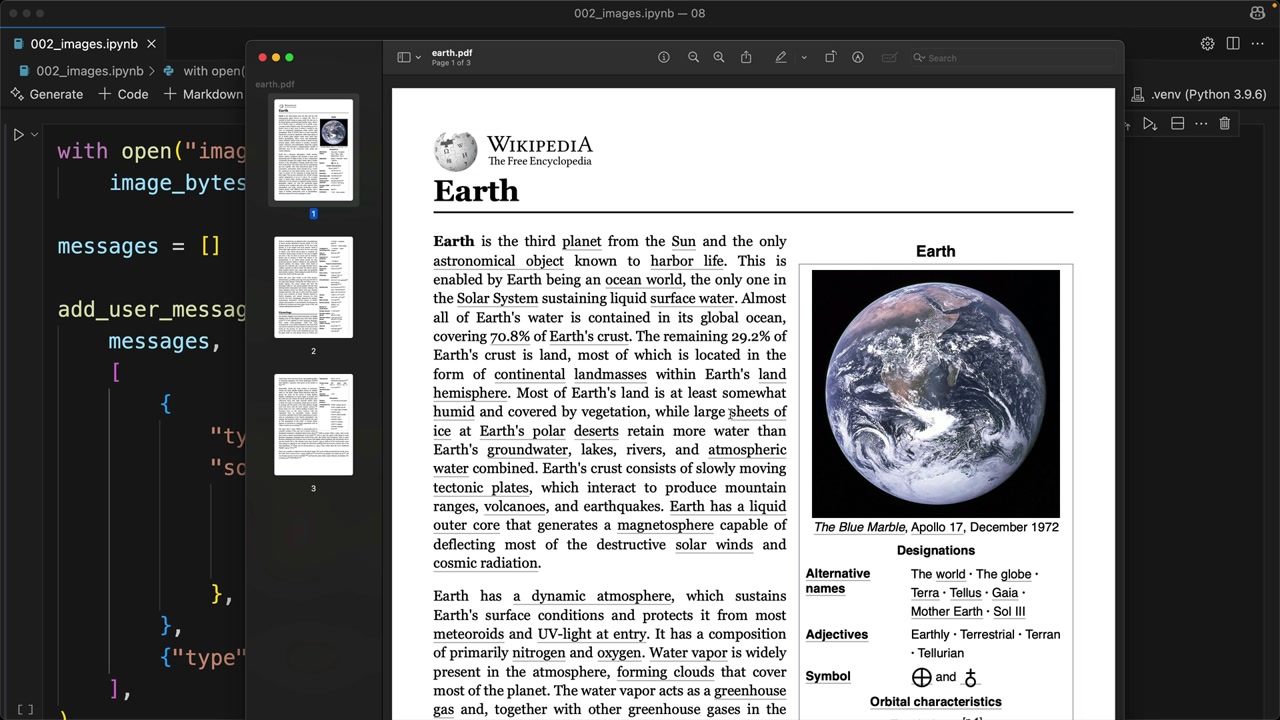
L'exemple ci-dessus montre Claude traitant avec succès un article Wikipédia sur la Terre enregistré au format PDF, démontrant comment il peut comprendre et résumer le contenu complexe d'un document en une seule phrase.