Lorsque vous évaluez des modèles d'IA qui génèrent du code, vous avez besoin de plus qu'une simple vérification que la réponse a du sens. Vous devez également vérifier que le code généré a bien une syntaxe valide et respecte le format correct. C'est là qu'intervient l'évaluation basée sur le code.
Fonctionnement de l'évaluation du code
L'évaluation du code valide deux aspects clés des réponses générées par l'IA :
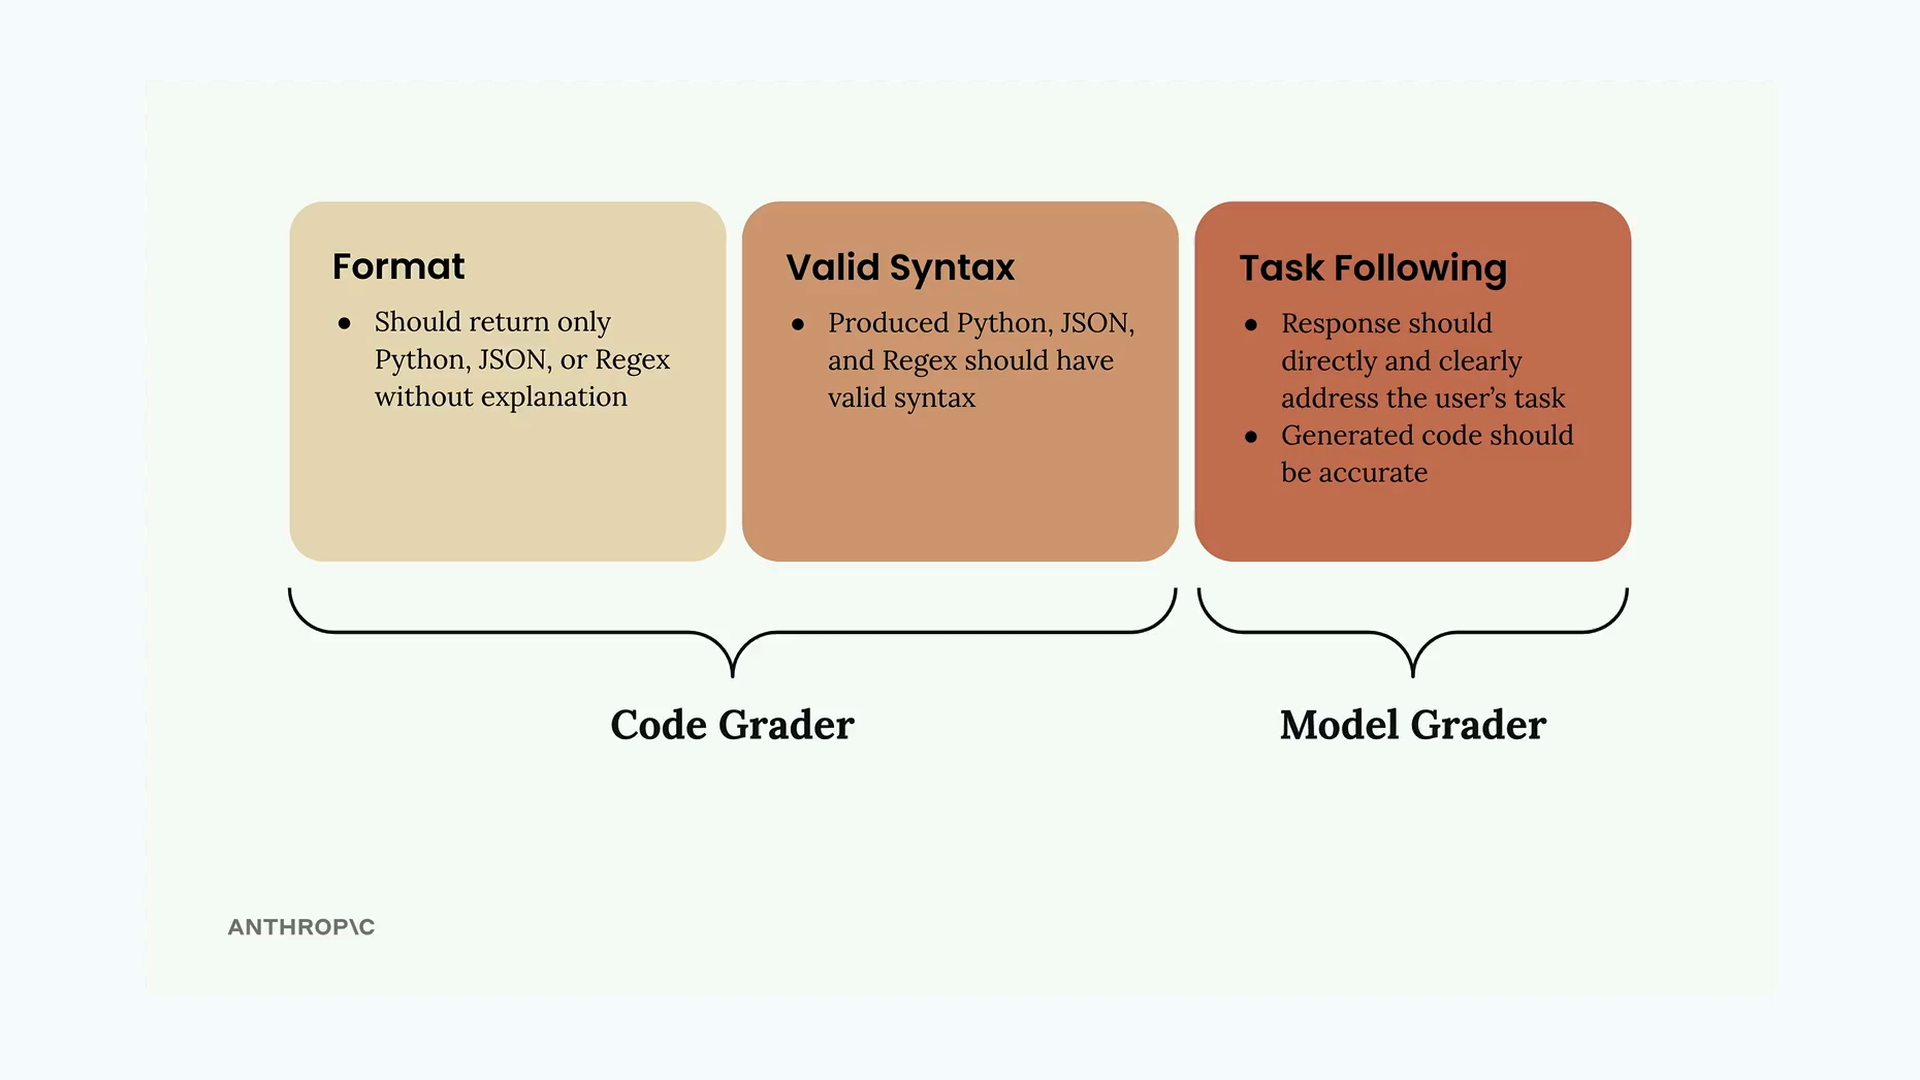
- Format - La réponse doit retourner uniquement le type de code demandé (Python, JSON ou Regex) sans explications
- Syntaxe valide - Le code généré doit effectivement s'analyser correctement en tant que langage visé
- Respect de la tâche - La réponse doit répondre directement à ce qui a été demandé et être exacte
Les deux premiers critères sont gérés par l'évaluateur de code, tandis que le respect de la tâche est évalué par l'évaluateur du modèle. Ensemble, ils fournissent une évaluation complète.
Fonctions de validation syntaxique
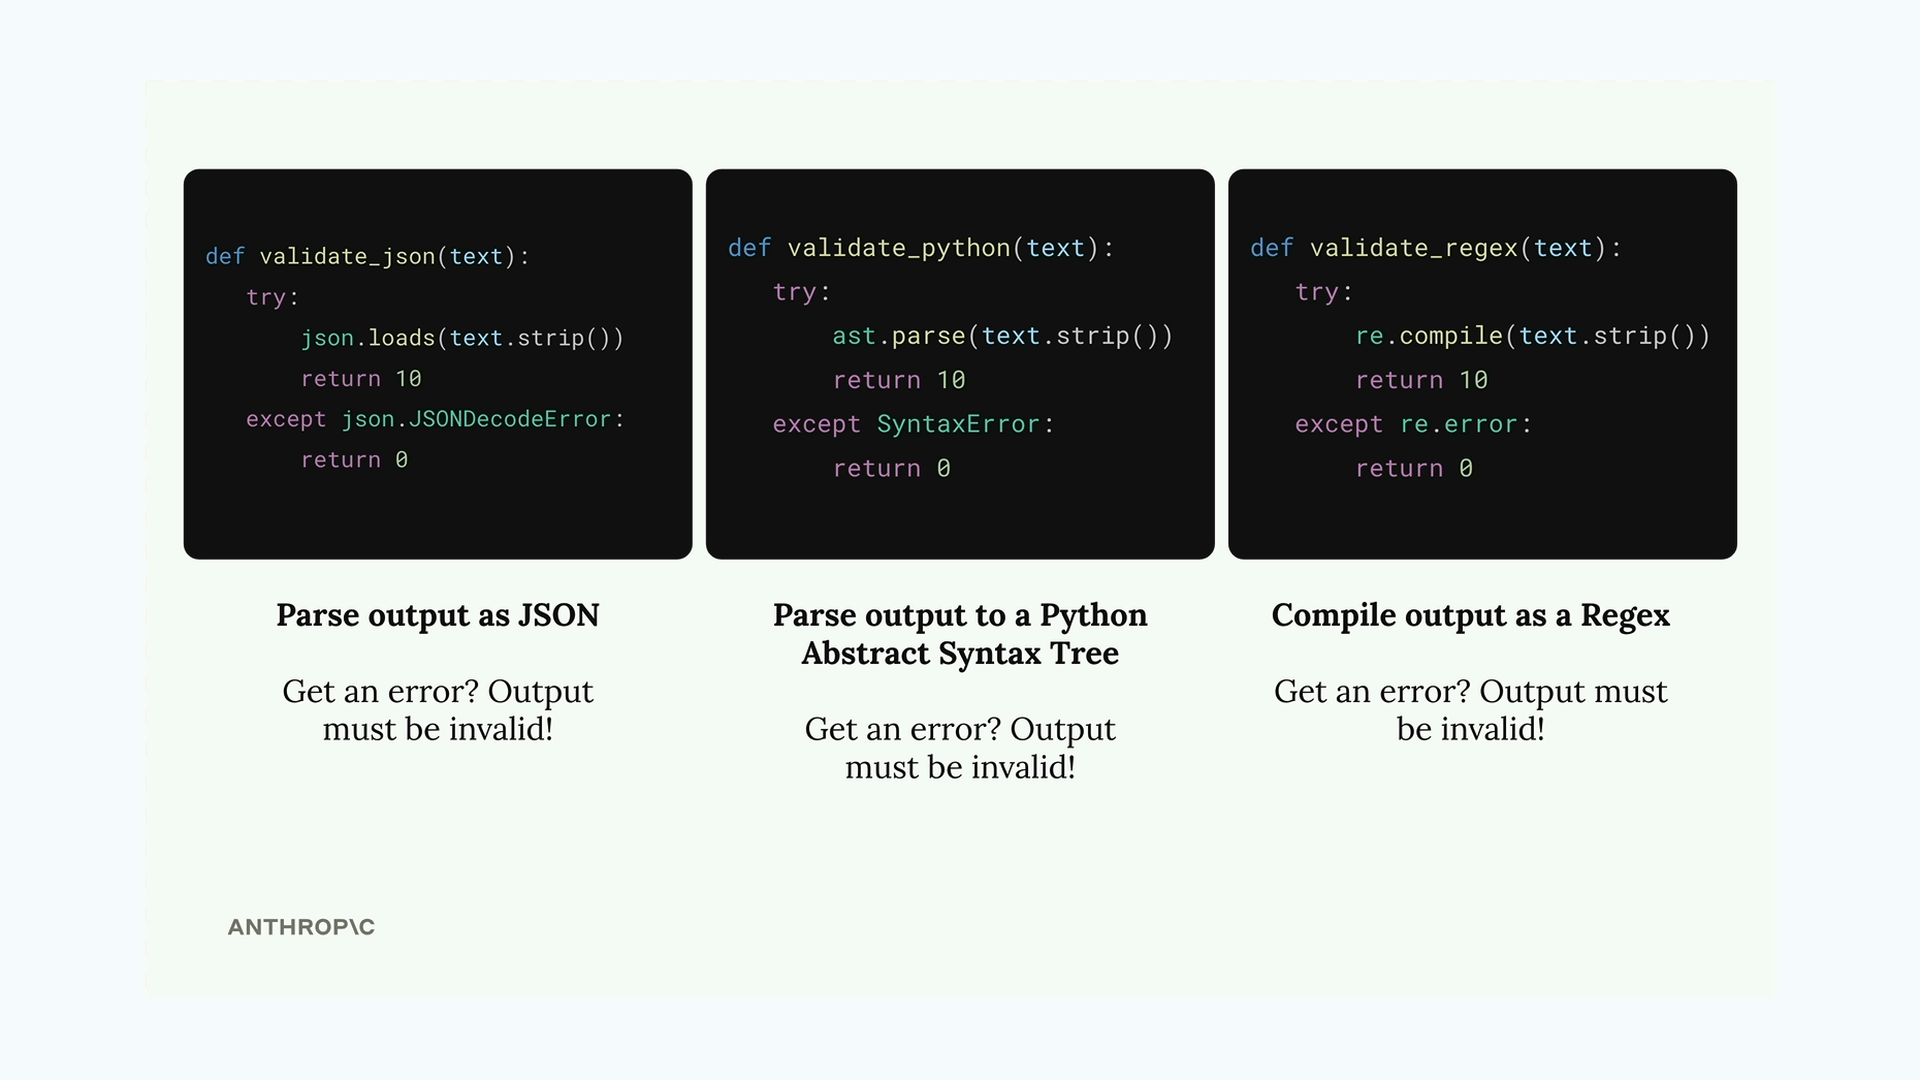
Pour vérifier si le code généré a une syntaxe valide, vous pouvez créer trois fonctions d'assistance qui tentent d'analyser la sortie :
import ast
import json
import re

def validate_json(text):
    try:
        json.loads(text.strip())
        return 10
    except json.JSONDecodeError:
        return 0

def validate_python(text):
    try:
        ast.parse(text.strip())
        return 10
    except SyntaxError:
        return 0

def validate_regex(text):
    try:
        re.compile(text.strip())
        return 10
    except re.error:
        return 0
Chaque fonction tente d'analyser le texte selon son format respectif. Si l'analyse réussit, elle renvoie un score parfait de 10. Si elle échoue avec une erreur, la syntaxe est invalide et renvoie 0.
Exigences du format de jeu de données
Pour que l'évaluateur de code sache quel validateur utiliser, vos cas de test doivent spécifier le format de sortie attendu :
{
    "task": "Create a Python function to validate an AWS IAM username",
    "format": "python"
}
Vous pouvez mettre à jour votre requête de génération de jeu de données pour inclure automatiquement ce champ de format en l'ajoutant à la structure de sortie d'exemple.
Amélioration de la clarté des requêtes
Pour obtenir de meilleurs résultats de votre modèle d'IA, rendez vos instructions de requête plus précises concernant le format de sortie attendu :
* Respond only with Python, JSON, or a plain Regex
* Do not add any comments or commentary or explanationVous pouvez également utiliser un message préremplie de l'assistant avec des blocs de code pour encourager le modèle à retourner uniquement le code brut :
add_assistant_message(messages, "```code")
output = chat(messages, stop_sequences=["```"])
Cela indique à Claude de commencer à générer le contenu du code sans avoir à préciser au préalable s'il s'agit de Python, JSON ou Regex.
Combinaison des scores
Tout d'abord, choisissez le validateur qui correspond à chaque cas de test :
def grade_syntax(output, test_case):
    if test_case["format"] == "json":
        return validate_json(output)
    if test_case["format"] == "python":
        return validate_python(output)
    return validate_regex(output)
La dernière étape consiste à fusionner le score de l'évaluateur du modèle avec le score de l'évaluateur de code. Une approche simple consiste à prendre la moyenne à l'intérieur de run_test_case :
model_grade = grade_by_model(test_case, output)
model_score = model_grade["score"]
syntax_score = grade_syntax(output, test_case)

score = (model_score + syntax_score) / 2
Cela donne un poids égal à la fois à la qualité du contenu et à l'exactitude technique. Vous pourriez ajuster ces pondérations en fonction de ce qui compte le plus pour votre cas d'usage spécifique.
Tester votre implémentation
Une fois que vous avez implémenté l'évaluation du code, exécutez votre évaluation pour obtenir un score de référence. Le score lui-même n'est intrinsèquement ni bon ni mauvais - ce qui compte, c'est de savoir si vous pouvez l'améliorer en affinant vos requêtes. Cela vous donne un moyen quantitatif de mesurer les progrès de l'ingénierie de requêtes plutôt que de vous fier à une évaluation subjective.