Maintenant que notre jeu de données d'évaluation est prêt, il est temps de construire le pipeline d'évaluation principal. Cela consiste à prendre chaque cas de test, à le fusionner avec notre requête, à le transmettre à Claude, puis à évaluer les résultats.
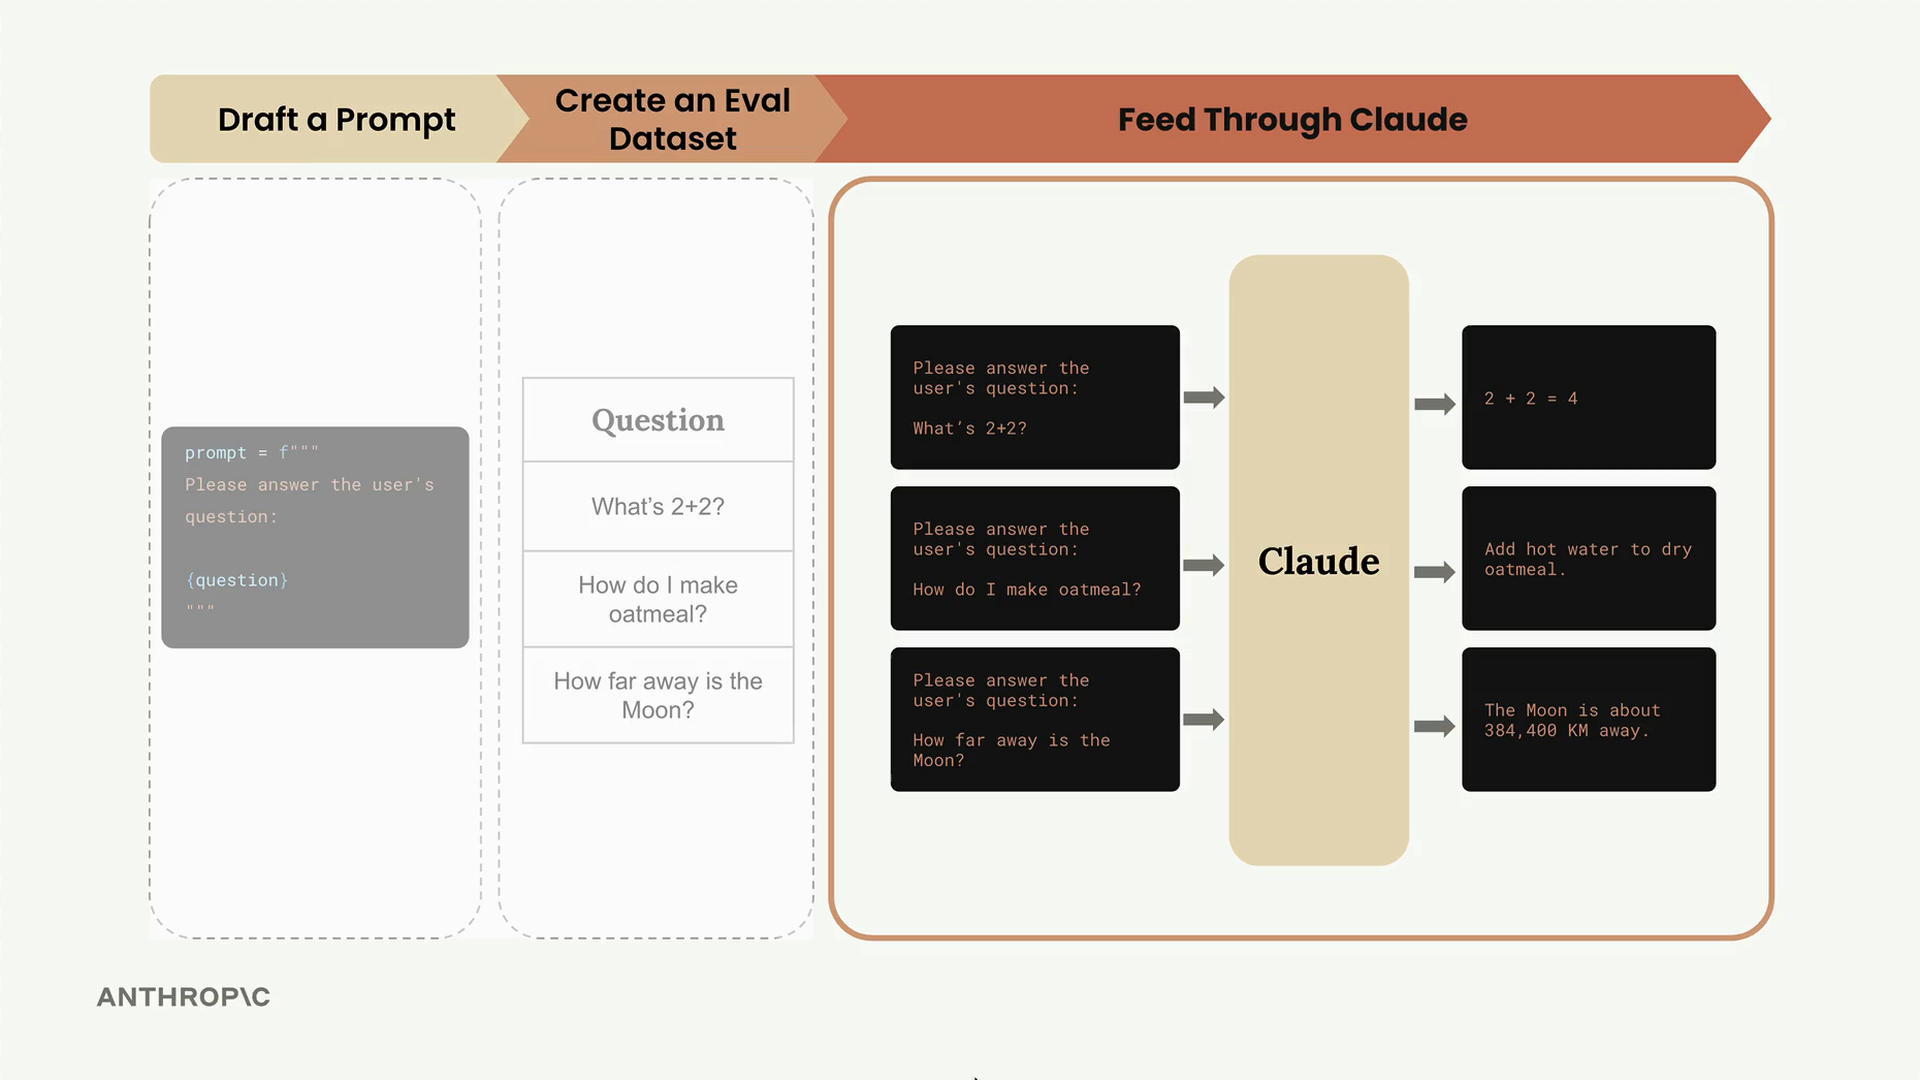
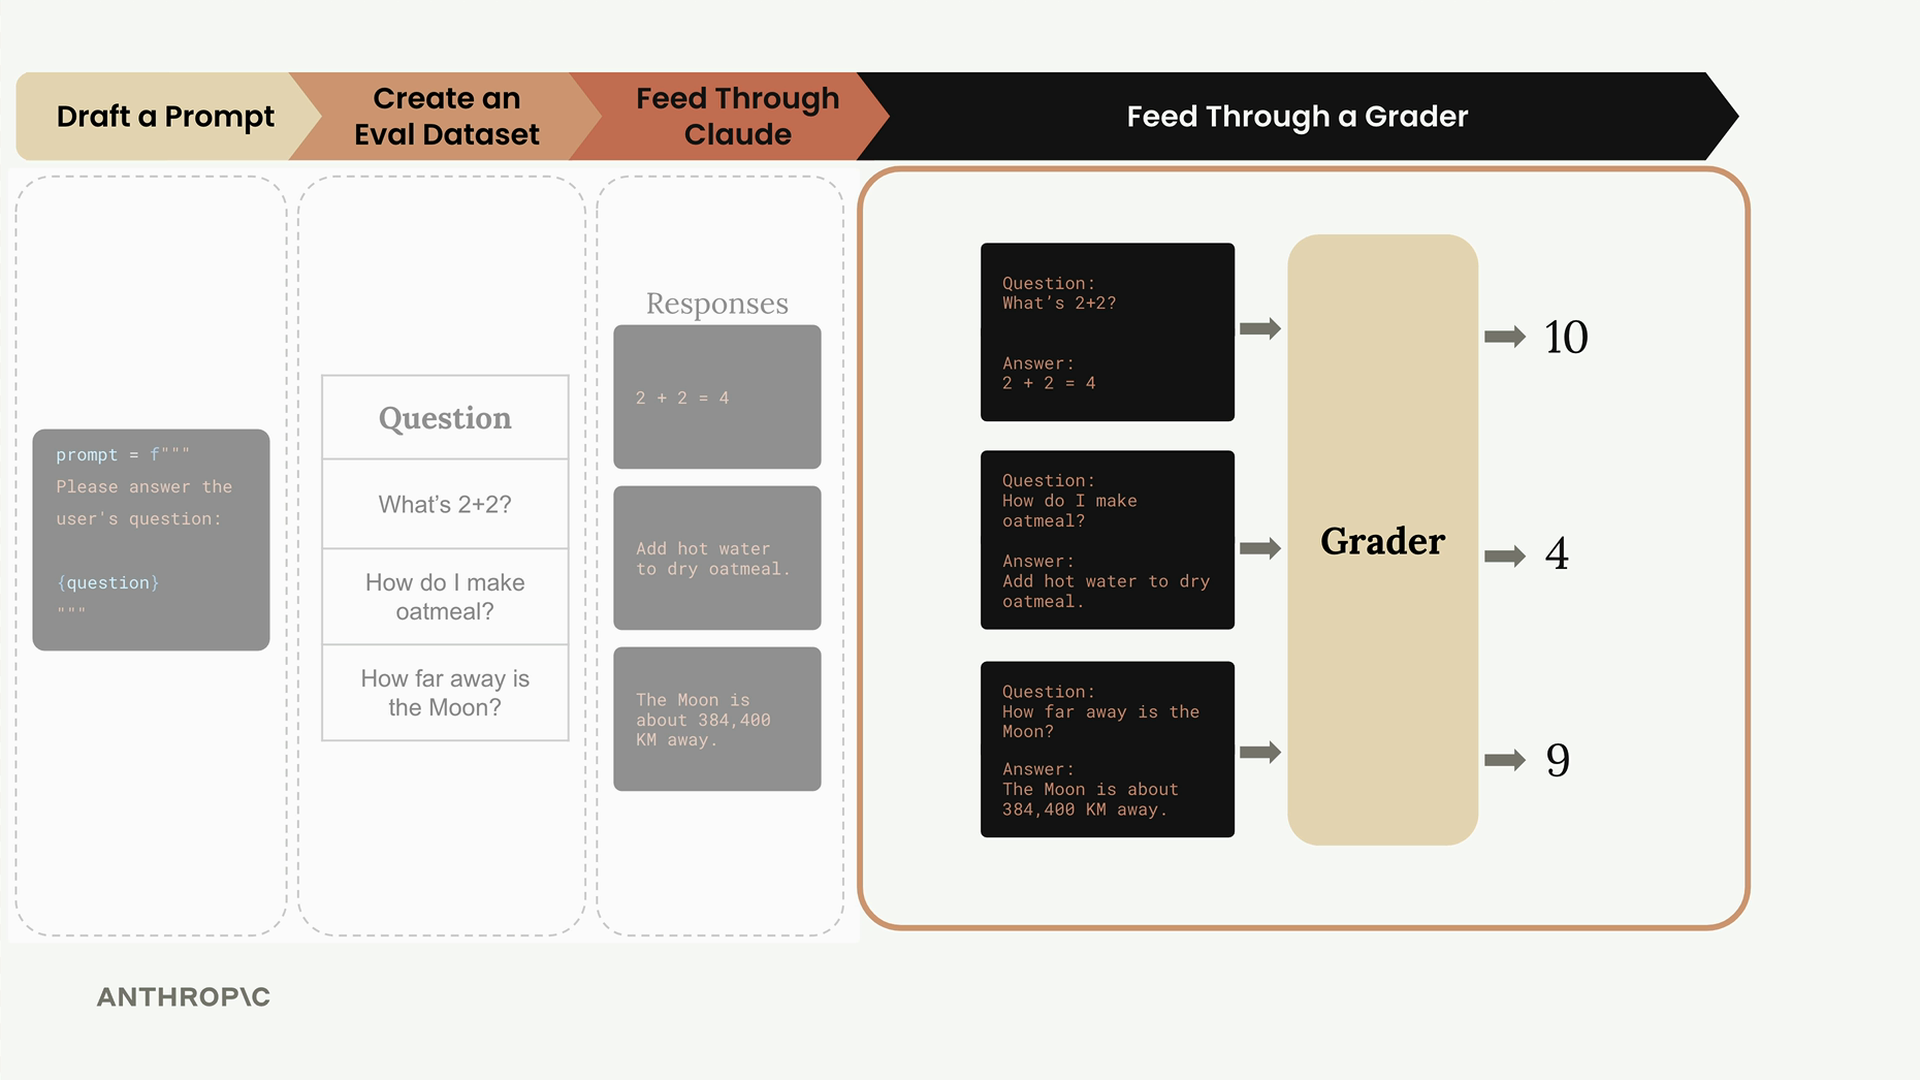
Le processus d'évaluation suit un flux de travail clair : nous prenons notre jeu de données de cas de test, nous combinons chacun avec notre modèle de requête, nous l'envoyons à Claude pour traitement, puis nous évaluons la sortie à l'aide d'un système de notation.
Construction des fonctions principales
Le pipeline d'évaluation se compose de trois fonctions principales, chacune ayant une responsabilité spécifique. Commençons par la plus simple - la fonction qui gère les requêtes individuelles.
La fonction run_prompt
Cette fonction prend un cas de test et le fusionne avec notre modèle de requête :
def run_prompt(test_case):
    """Merges the prompt and test case input, then returns the result"""
    prompt = f"""
Please solve the following task:

{test_case["task"]}
"""

    messages = []
    add_user_message(messages, prompt)
    output = chat(messages)
    return output
Pour l'instant, nous gardons la requête extrêmement simple. Nous n'incluons aucune instruction de formatage, donc Claude renverra probablement une sortie plus détaillée que nécessaire. Nous affinerons cela plus tard, à mesure que nous itérerons sur la conception de notre requête.
La fonction run_test_case
Cette fonction orchestre l'exécution d'un cas de test unique et la notation du résultat :
def run_test_case(test_case):
    """Calls run_prompt, then grades the result"""
    output = run_prompt(test_case)

    # TODO - Notation
    score = 10

    return {
        "output": output,
        "test_case": test_case,
        "score": score
    }
Pour l'instant, nous utilisons un score codé en dur de 10. La logique de notation est l'endroit où nous passerons un temps considérable dans les sections à venir, mais cet espace réservé nous permet de tester le pipeline global.
La fonction run_eval
Cette fonction coordonne l'ensemble du processus d'évaluation :
def run_eval(dataset):
    """Loads the dataset and calls run_test_case with each case"""
    results = []

    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    return results
Cette fonction traite chaque cas de test de notre jeu de données et rassemble tous les résultats dans une seule liste.
Exécution de l'évaluation
Pour exécuter notre pipeline d'évaluation, nous chargeons notre jeu de données et le faisons passer par nos fonctions :
with open("dataset.json", "r") as f:
    dataset = json.load(f)

results = run_eval(dataset)
La première fois que vous exécutez cela, attendez-vous à ce que cela prenne un certain temps - même avec Claude Haiku, cela peut prendre environ 30 secondes pour traiter un jeu de données complet. Nous aborderons les techniques d'optimisation plus tard.
Examen des résultats
L'évaluation renvoie un tableau JSON structuré où chaque objet représente le résultat d'un cas de test :
print(json.dumps(results, indent=2))
Chaque résultat contient trois informations clés :
- output : La réponse complète de Claude
- test_case : Le cas de test original qui a été traité
- score : Le score d'évaluation (actuellement codé en dur)
Comme vous pouvez le constater dans la sortie, Claude génère des réponses assez détaillées puisque nous n'avons pas encore fourni d'instructions de formatage spécifiques. C'est exactement le genre de problème que nous allons résoudre en affinant nos requêtes.
Ce que nous avons accompli
À ce stade, nous avons construit avec succès le pipeline d'évaluation principal. Nous pouvons prendre notre jeu de données, le traiter via Claude et rassembler des résultats structurés. L'élément manquant majeur est le système de notation - ce score codé en dur de 10 doit être remplacé par une véritable logique d'évaluation.
Ce pipeline représente le fondement de la plupart des systèmes d'évaluation de l'IA. Bien qu'il puisse sembler simple, vous venez de construire l'essentiel de ce qu'un pipeline d'évaluation fait réellement. La complexité réside dans les détails - de meilleures requêtes, une notation plus sophistiquée et des optimisations de performance.
Ensuite, nous plongerons dans le sujet crucial des évaluateurs, qui transformeront nos scores codés en dur en évaluations significatives des performances de Claude.