La mémorisation des requêtes est une fonctionnalité qui accélère les réponses de Claude et réduit le coût de la génération de texte en réutilisant le travail de calcul effectué lors des requêtes précédentes. Au lieu de jeter tout le travail de traitement après chaque requête, Claude peut l'enregistrer et le réutiliser lorsque vous renvoyez un contenu similaire.
Comment Claude traite normalement les requêtes
Pour comprendre la mémorisation des requêtes, examinons d'abord ce qui se passe lors d'une requête typique sans mémorisation activée.
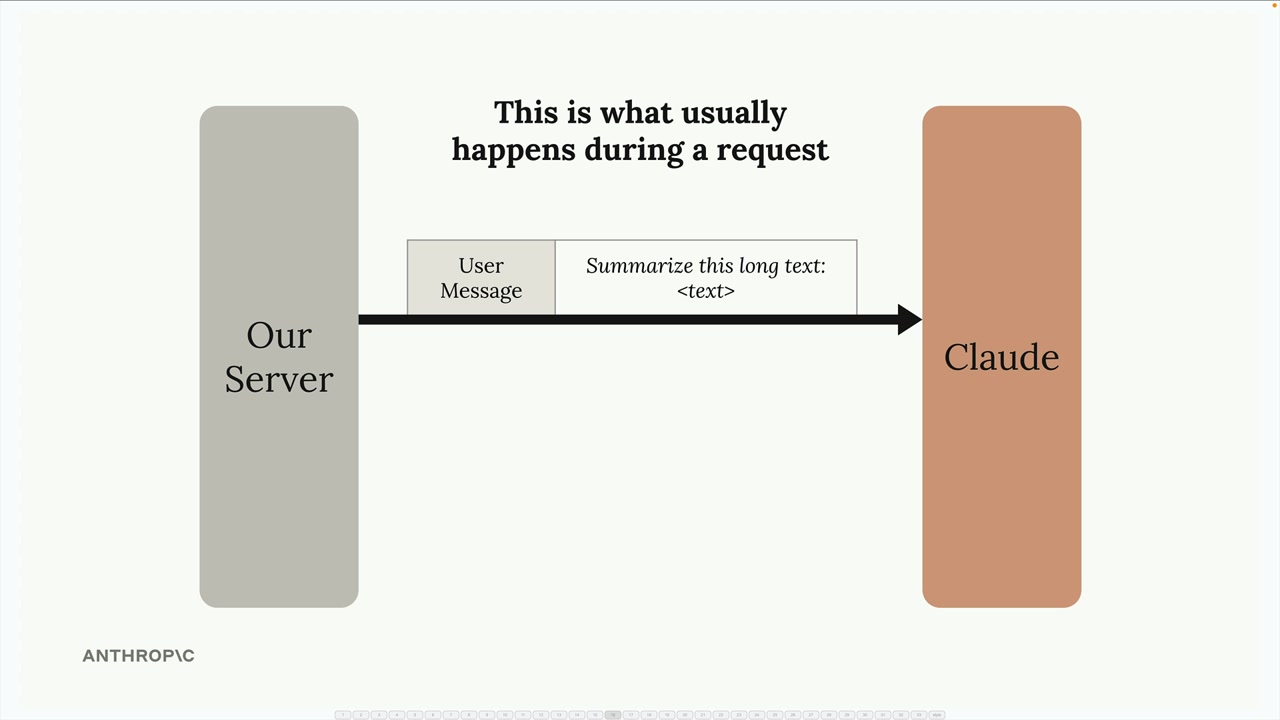
Lorsque vous envoyez un message à Claude, il ne commence pas immédiatement à générer une réponse. Au lieu de cela, Claude effectue un travail de prétraitement considérable sur votre saisie :
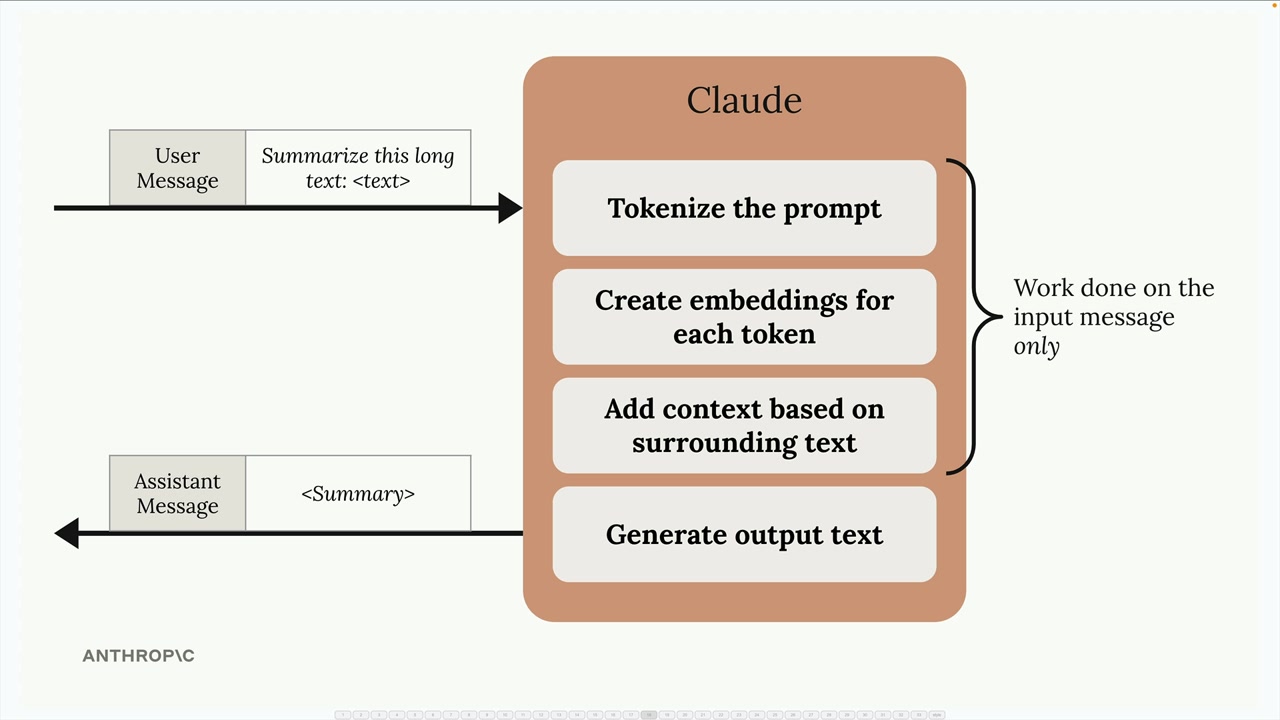
- Décompose la requête en plus petits éléments (jetons)
- Crée des embeddings pour chaque jeton
- Ajoute du contexte en fonction du texte environnant
- Ce n'est qu'ensuite qu'il génère le texte de sortie proprement dit
Après vous avoir envoyé la réponse, Claude jette tout ce travail de calcul : la tokenisation, les embeddings et l'analyse contextuelle sont tous abandonnés.
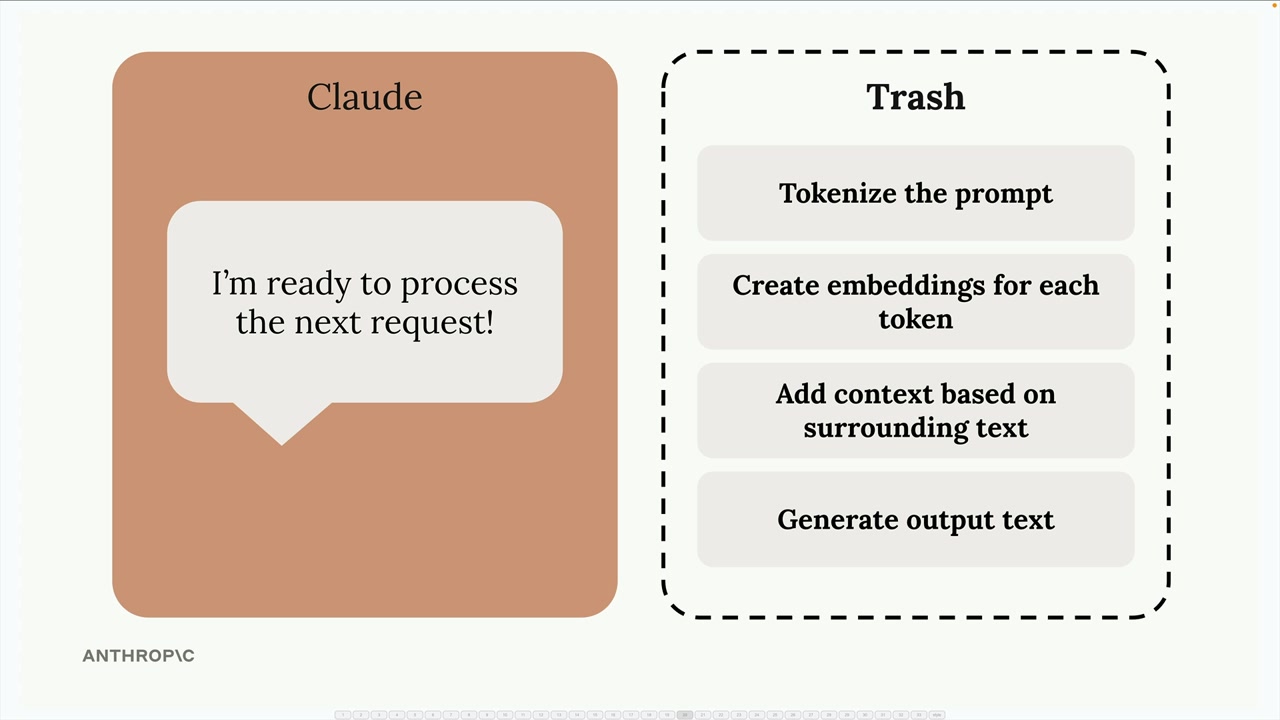
Le problème du travail jeté
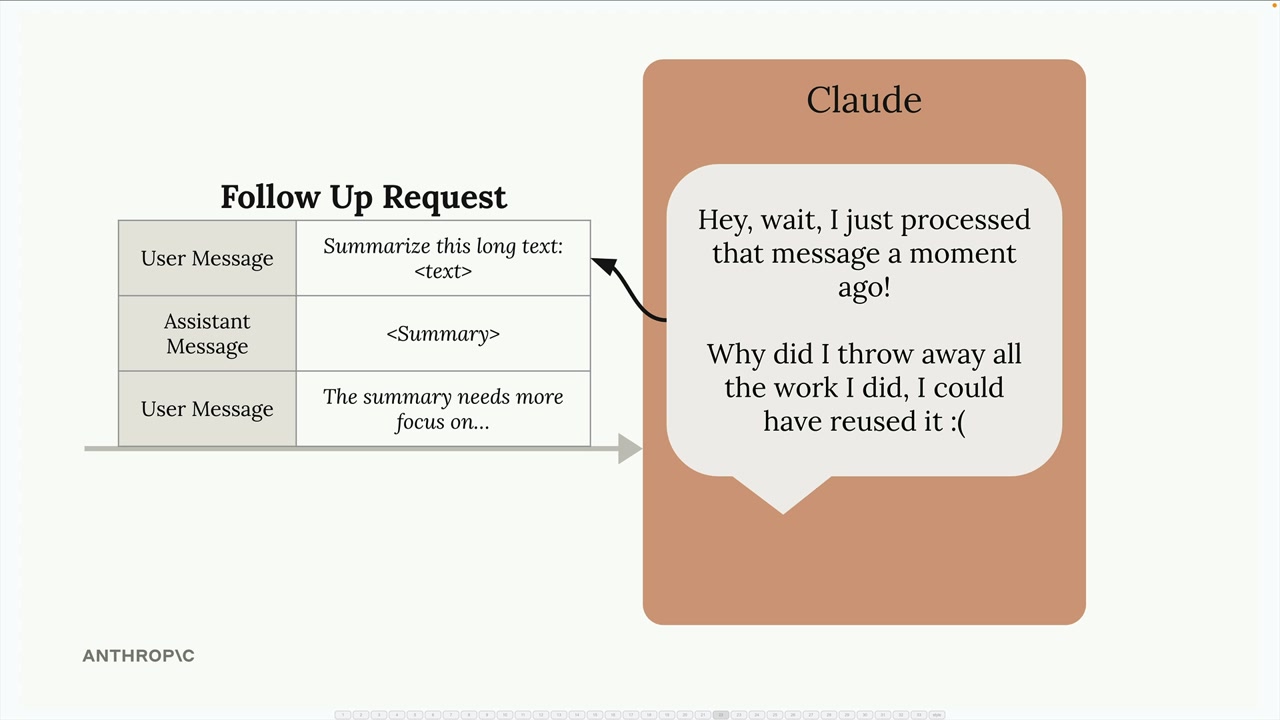
Cela devient inefficace lorsque vous effectuez des requêtes de suivi qui incluent le même contenu. Par exemple, dans une conversation où vous demandez à Claude d'affiner un résumé du même long texte :
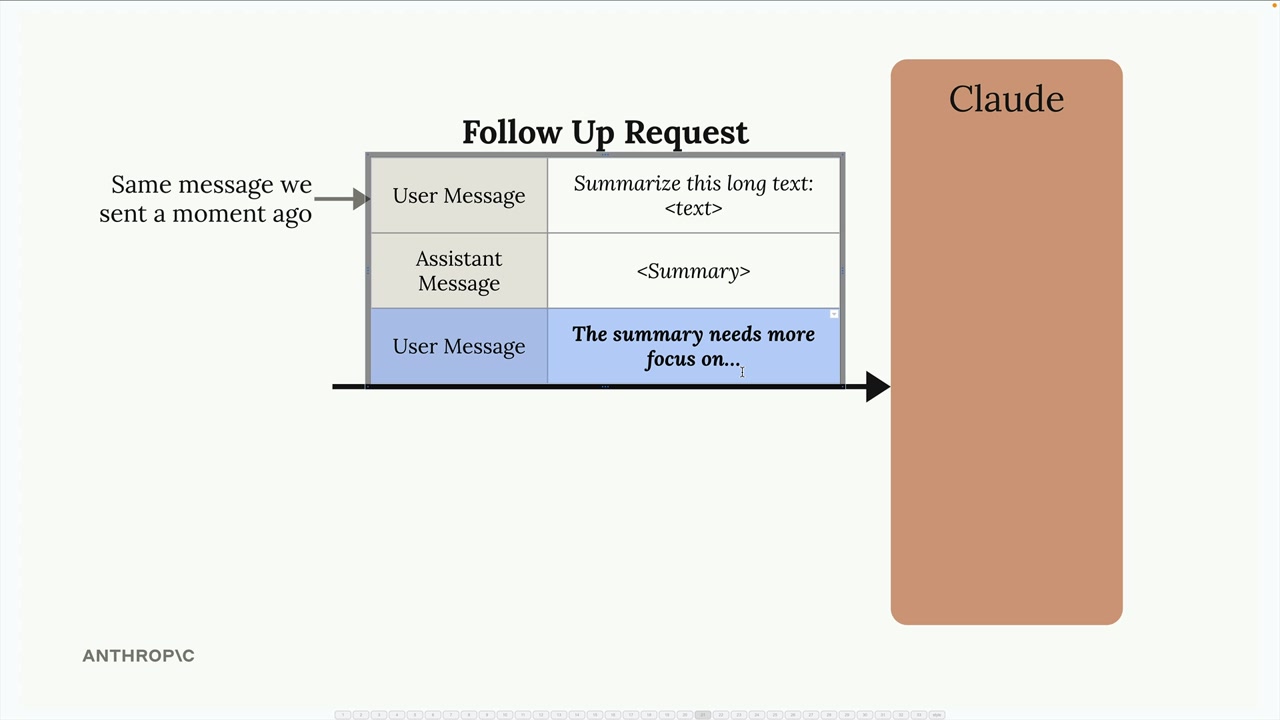
Claude doit répéter exactement le même travail de prétraitement sur un contenu qu'il vient d'analyser quelques instants plus tôt. Comme Claude pourrait se dire : « Je viens de traiter ce message et de jeter tout le travail que j'ai effectué — j'aurais pu le réutiliser ! »
Comment la mémorisation des requêtes résout ce problème
La mémorisation des requêtes modifie ce flux de travail en enregistrant le travail de prétraitement au lieu de le jeter :
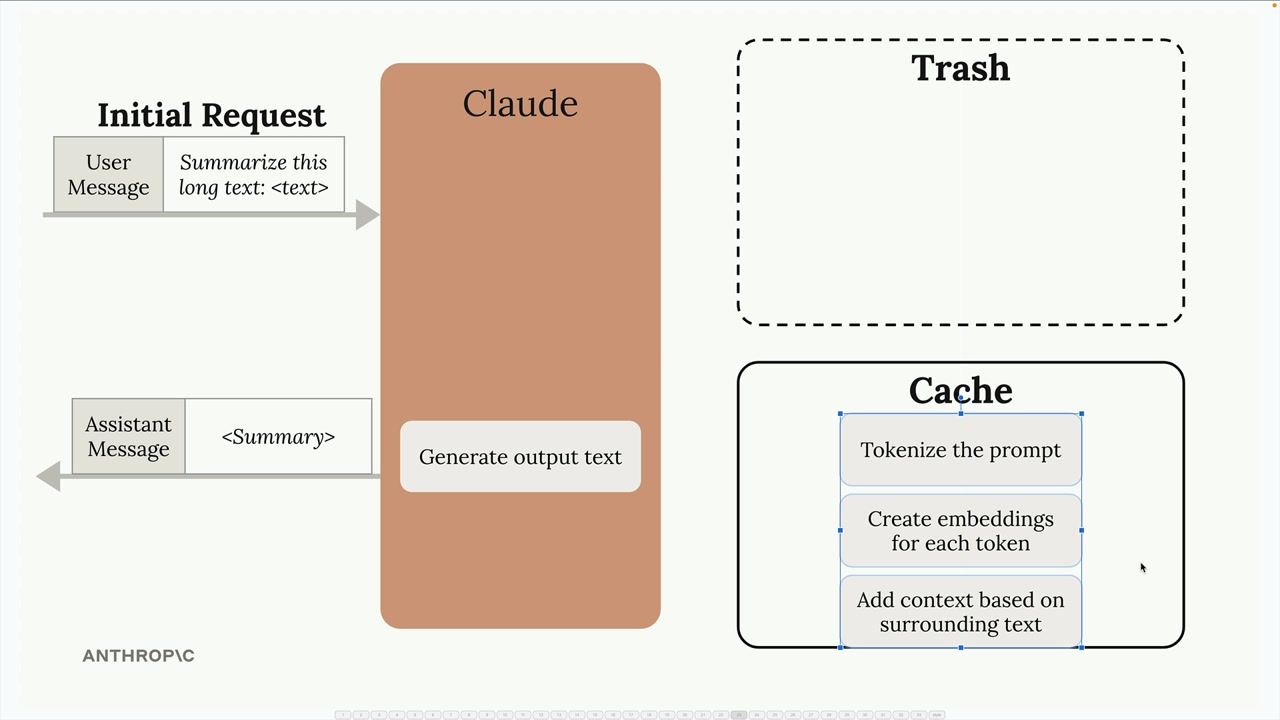
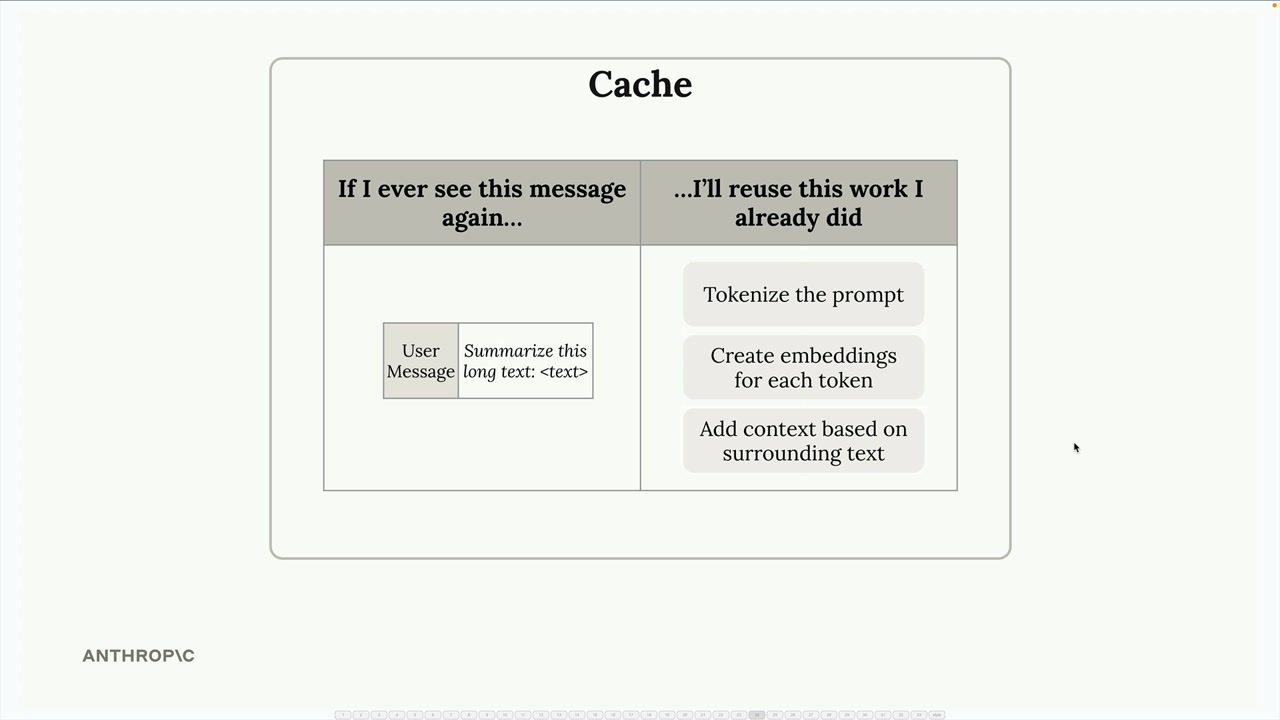
Lorsque vous effectuez une requête initiale, Claude effectue tout le prétraitement habituel mais stocke les résultats dans un cache au lieu de les jeter. Le cache agit comme une table de correspondance qui indique : « Si je revois un jour ce message, je réutiliserai ce travail que j'ai déjà effectué. »
Avantages et limites principaux
La mémorisation des requêtes offre plusieurs avantages :
- Réponses plus rapides : les requêtes utilisant du contenu mis en cache s'exécutent plus rapidement
- Coûts réduits : vous payez moins cher pour les portions mises en cache de vos requêtes
- Optimisation automatique : la requête initiale écrit dans le cache, les requêtes de suivi y lisent
Cependant, il existe des limites importantes à garder à l'esprit :
- Durée du cache : par défaut, le contenu mis en cache est conservé pendant 5 minutes, et chaque réutilisation renouvelle ce délai sans coût supplémentaire. Vous pouvez éventuellement prolonger la durée de vie à 1 heure, ce qui implique un prix d'écriture en cache plus élevé.
- Cas d'usage limités : uniquement bénéfique lorsque vous envoyez de manière répétée le même contenu
- Exigence de fréquence élevée : le plus efficace lorsque le même contenu apparaît extrêmement fréquemment dans vos requêtes
La mémorisation des requêtes est particulièrement efficace pour des scénarios tels que les flux de travail d'analyse de documents, où vous posez plusieurs questions sur le même document volumineux, ou les tâches d'édition itérative où le contenu de base reste constant pendant que vous affinez des aspects spécifiques.