Nous avons construit des implémentations distinctes pour la recherche sémantique (utilisant des embeddings vectoriels) et la recherche lexicale (utilisant BM25). Il est maintenant temps de les combiner en un pipeline de recherche unifié qui tire parti des forces des deux approches.
L'architecture multi-index
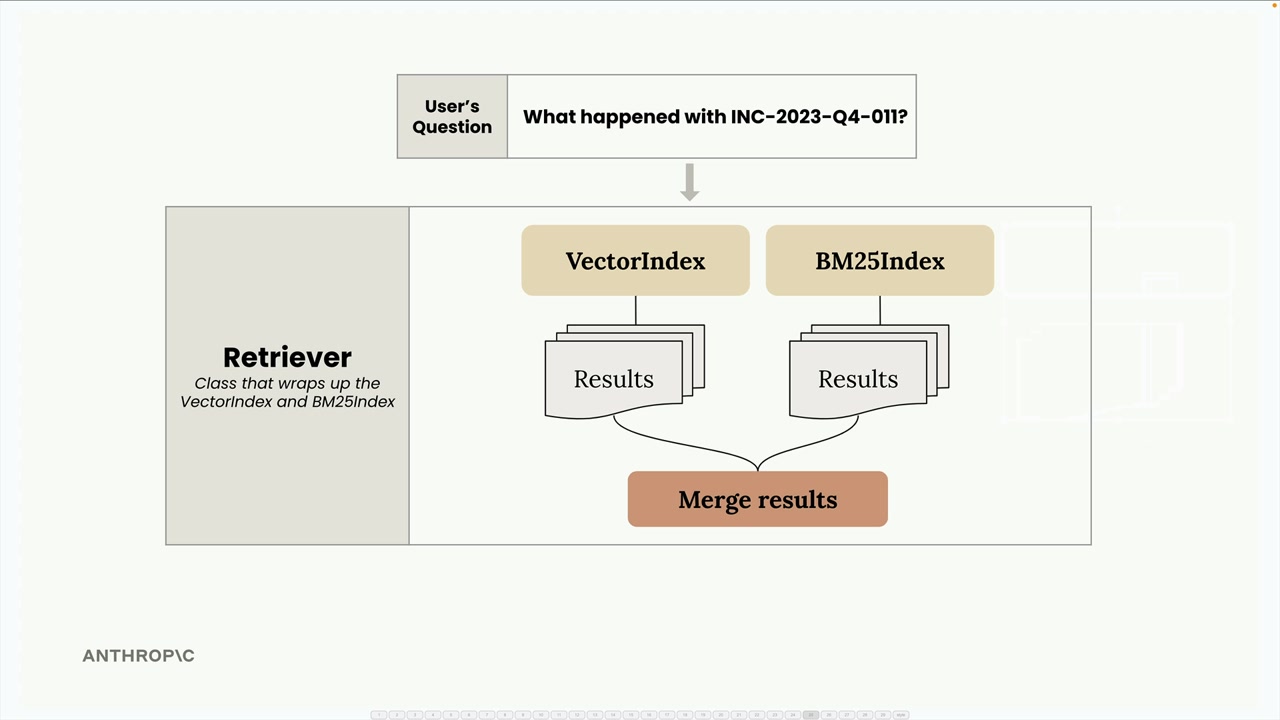
Nos classes VectorIndex et BM25Index partagent des API presque identiques : elles disposent toutes deux de méthodes add_document() et search(). Cette cohérence permet de les envelopper facilement ensemble dans une nouvelle classe appelée Retriever.
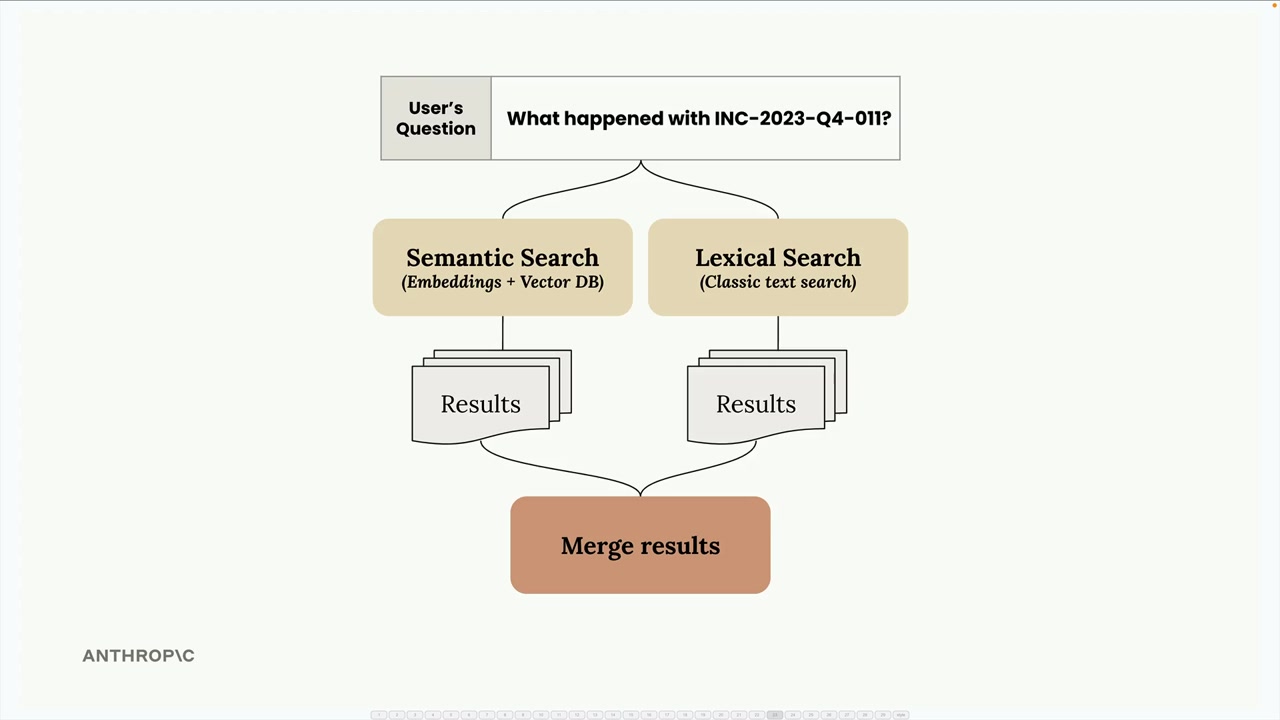
Le Retriever agit comme un coordinateur qui transmet les requêtes utilisateur aux deux index, recueille leurs résultats, et les fusionne en utilisant une technique appelée fusion par rang réciproque (reciprocal rank fusion).
Comprendre la fusion par rang réciproque
Fusionner les résultats de différentes méthodes de recherche n'est pas aussi simple que de simplement concaténer des listes. Chaque méthode utilise un système de notation différent, nous avons donc besoin d'un moyen de normaliser et de combiner leurs classements de manière équitable.
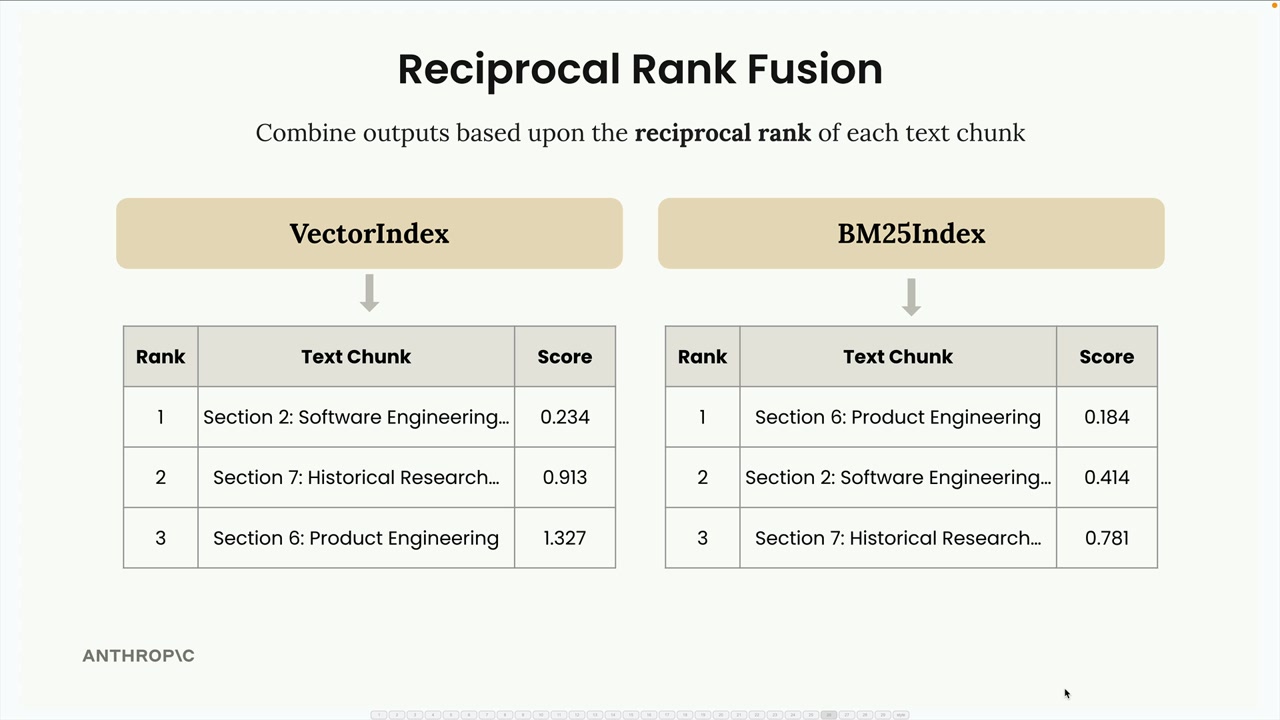
Voici comment fonctionne la fusion par rang réciproque avec un exemple. Supposons que nous recherchions des informations sur « INC-2023-Q4-011 » et obtenions ces résultats :
- VectorIndex renvoie : Section 2 (rang 1), Section 7 (rang 2), Section 6 (rang 3)
- BM25Index renvoie : Section 6 (rang 1), Section 2 (rang 2), Section 7 (rang 3)
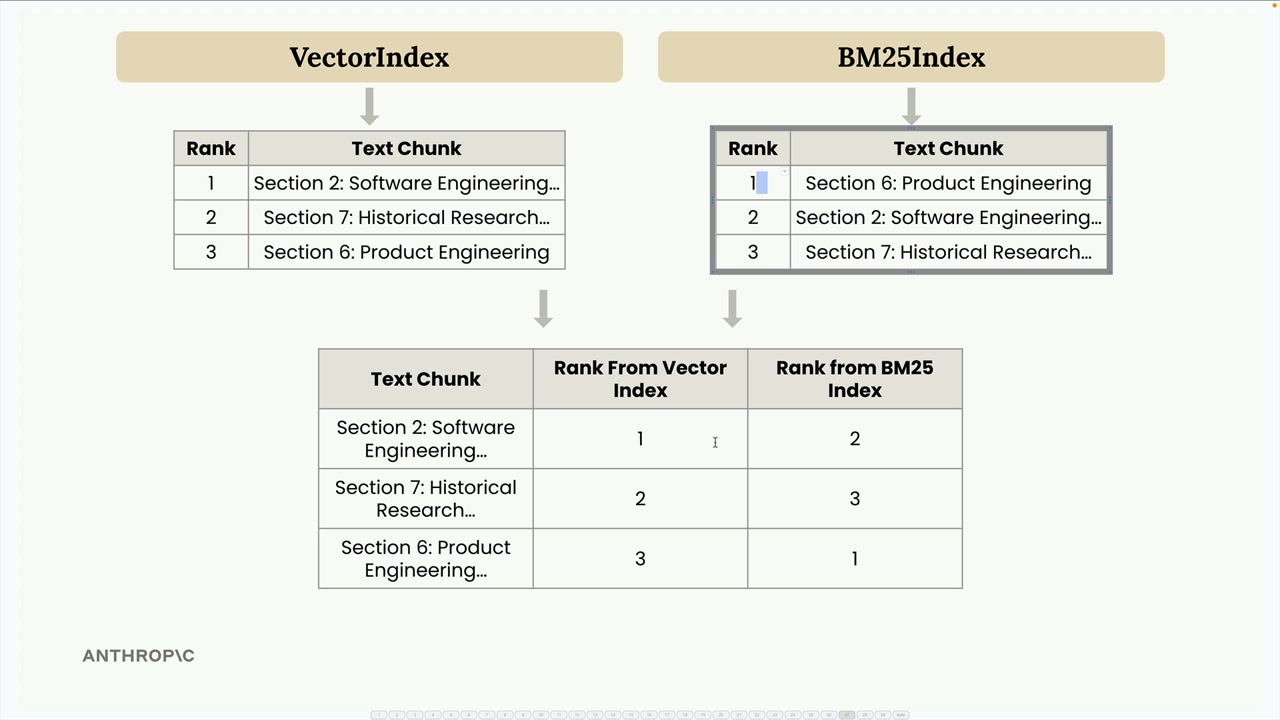
Nous combinons ces résultats dans un seul tableau montrant le rang de chaque fragment de texte dans les deux index, puis nous appliquons la formule RRF :
RRF_score(d) = Σ(1 / (k + rank_i(d)))Où k est une constante (souvent 60, mais nous utiliserons 1 pour des résultats plus clairs) et rank_i(d) est le rang du document d dans le i-ème classement.
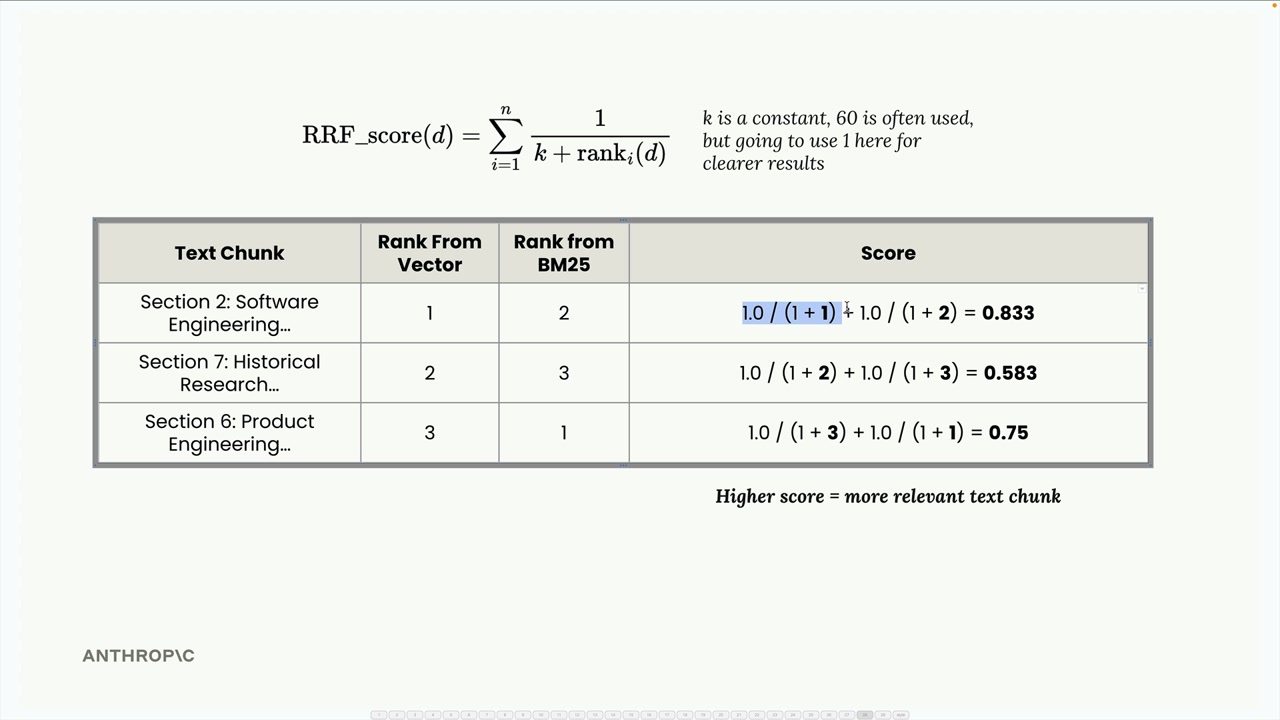
Pour notre exemple :
- Section 2 : 1,0/(1+1) + 1,0/(1+2) = 0,833
- Section 7 : 1,0/(1+2) + 1,0/(1+3) = 0,583
- Section 6 : 1,0/(1+3) + 1,0/(1+1) = 0,75
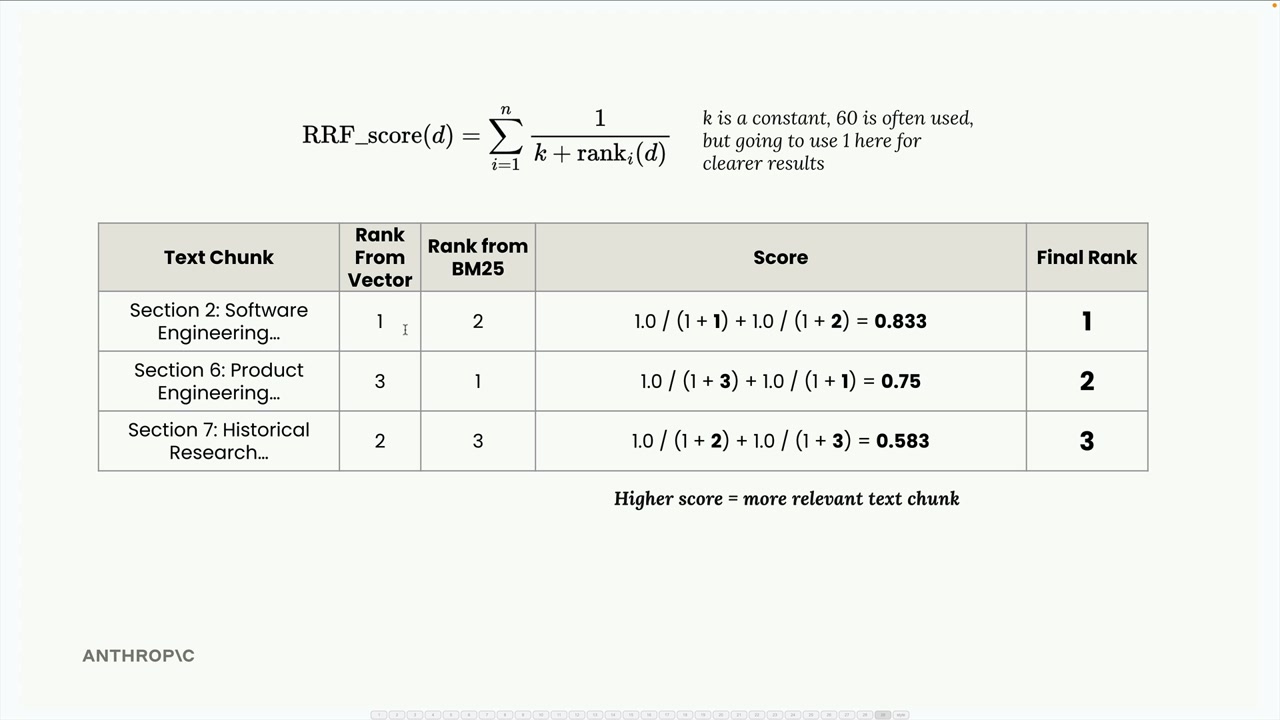
Le classement final devient : Section 2 (0,833), Section 6 (0,75), Section 7 (0,583). Cela a un sens intuitif : la Section 2 a bien performé dans les deux index, elle remonte donc au sommet.
Détails d'implémentation
La classe Retriever enveloppe plusieurs index de recherche et fournit une interface unifiée :
class Retriever:
    def __init__(self, *indexes: SearchIndex):
        if len(indexes) == 0:
            raise ValueError("At least one index must be provided")
        self._indexes = list(indexes)

    def add_document(self, document: Dict[str, Any]):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text: str, k: int = 1, k_rrf: int = 60):
        # Obtenir les résultats de tous les index
        all_results = []
        for idx, results in enumerate(all_results):
            for rank, (doc, _) in enumerate(results):
                # Suivre les rangs des documents entre les index
                # Appliquer la formule de notation RRF
        # Renvoyer les résultats fusionnés et triés
L'idée clé est qu'en maintenant des API cohérentes entre différentes implémentations de recherche, nous pouvons les combiner facilement sans couplage étroit.
Tester l'approche hybride
Vous souvenez-vous de notre problème précédent où la recherche de « que s'est-il passé avec INC-2023-Q4-011 ? » renvoyait des résultats inattendus avec l'approche vectorielle seule ? L'incident de cybersécurité (Section 10) arrivait en premier, mais l'analyse financière (Section 3) arrivait en second au lieu de la section d'ingénierie logicielle plus pertinente.
Avec notre retriever hybride, nous obtenons désormais de bien meilleurs résultats :
- Section 10 : Analyse de cybersécurité - Rapport de réponse à incident (la plus pertinente)
- Section 2 : Ingénierie logicielle - Améliorations de stabilité du projet Phoenix (la deuxième plus pertinente)
- Section 5 : Développements juridiques (la troisième)
Cela démontre comment la combinaison de la recherche sémantique et lexicale peut surmonter les limites de chaque approche utilisée seule.
Extensibilité
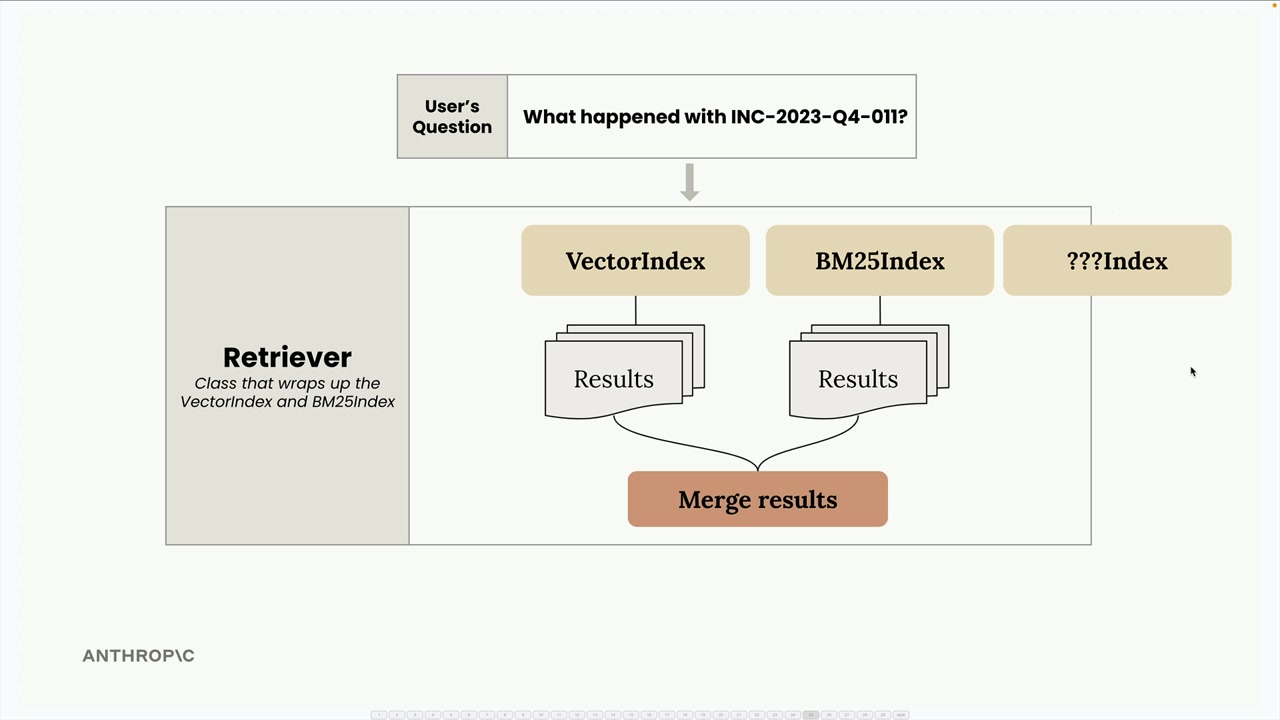
La beauté de cette architecture réside dans son extensibilité. Puisque tous les index implémentent le même protocole SearchIndex avec les méthodes add_document() et search(), vous pouvez facilement ajouter de nouvelles méthodologies de recherche :
Vous voulez ajouter un index basé sur des mots-clés ? Une recherche basée sur des graphes ? Un index de domaine spécialisé ? Il suffit d'implémenter la même interface et le Retriever l'incorporera automatiquement dans le processus de fusion.
Cette approche modulaire permet à chaque implémentation de recherche de rester ciblée et testable, tout en offrant un moyen propre de combiner leurs forces dans le système final.