Lorsque vous développez des applications avec Claude, comprendre l'ensemble du cycle de vie d'une requête vous aide à prendre de meilleures décisions architecturales et à déboguer les problèmes plus efficacement. Examinons ce qui se passe entre le moment où un utilisateur clique sur « envoyer » dans votre interface de chat et celui où la réponse de Claude apparaît à l'écran.
Le flux de requête en cinq étapes
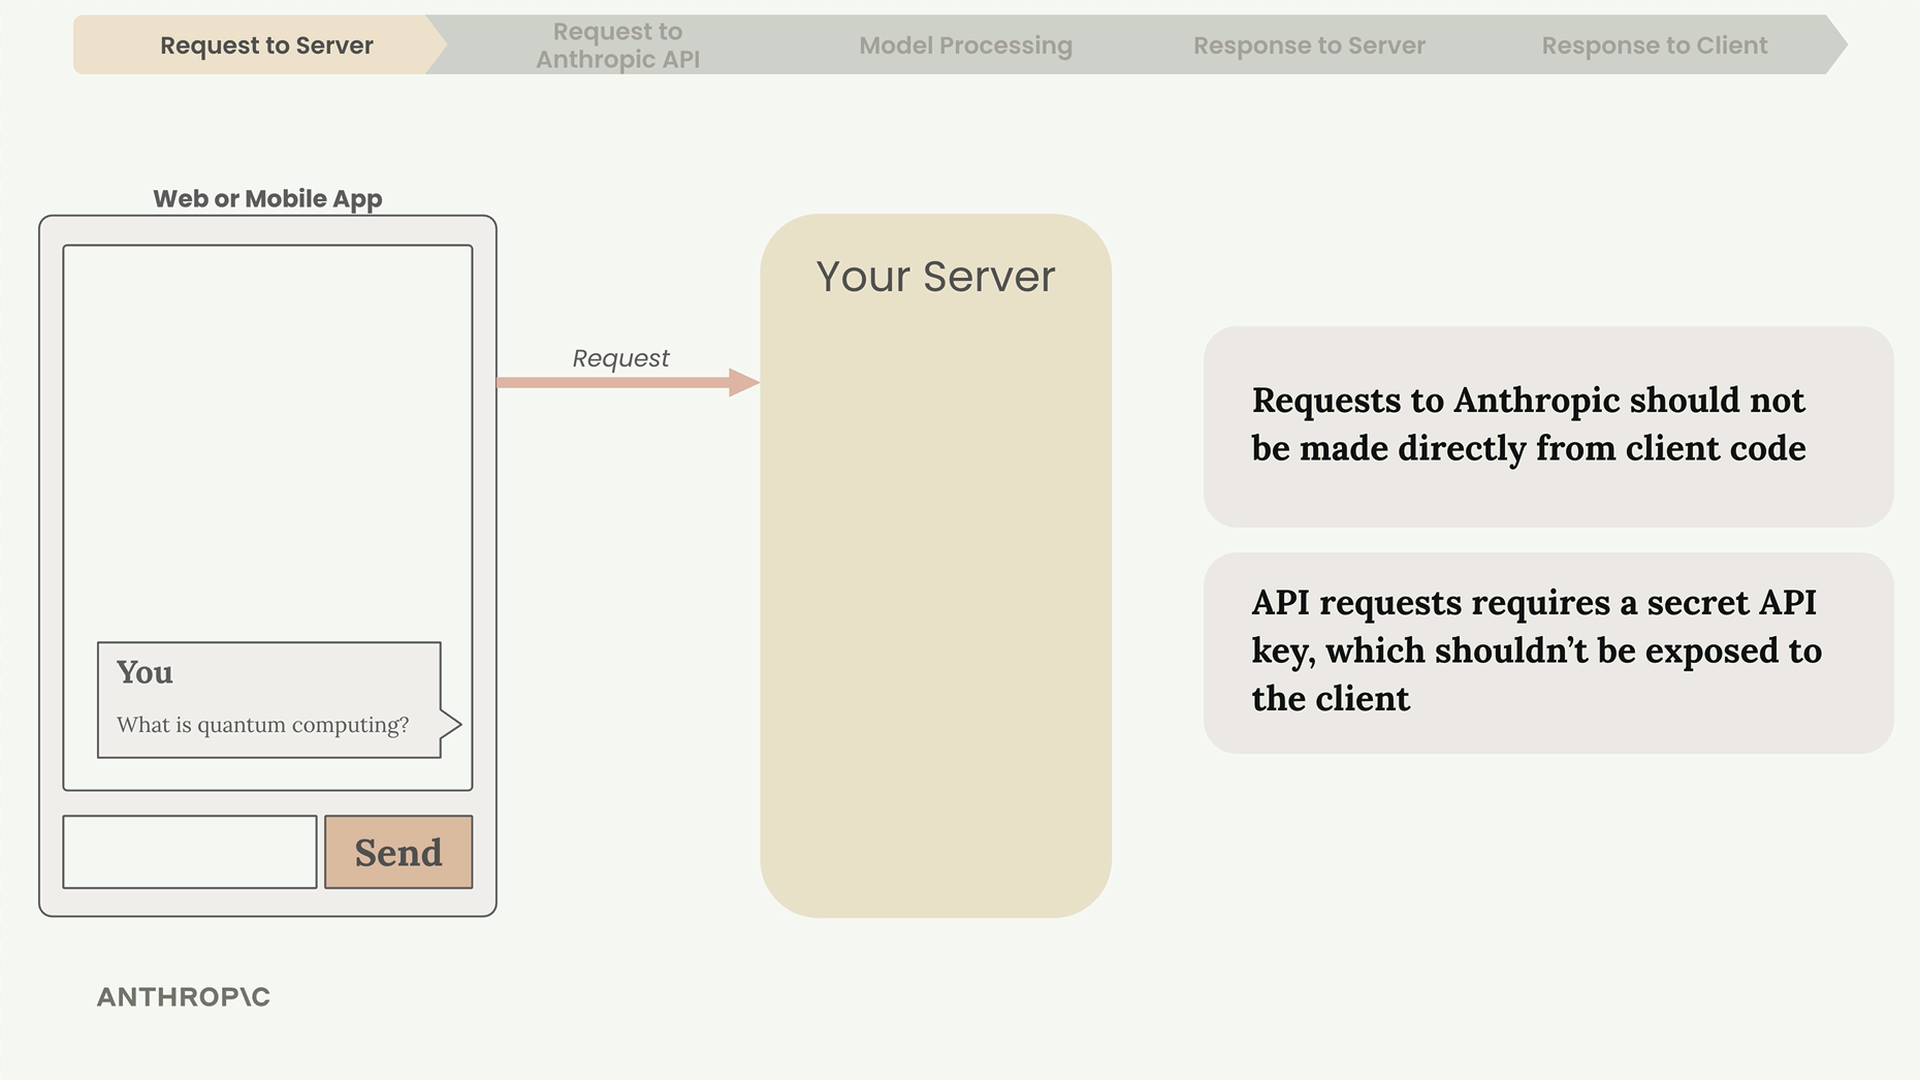
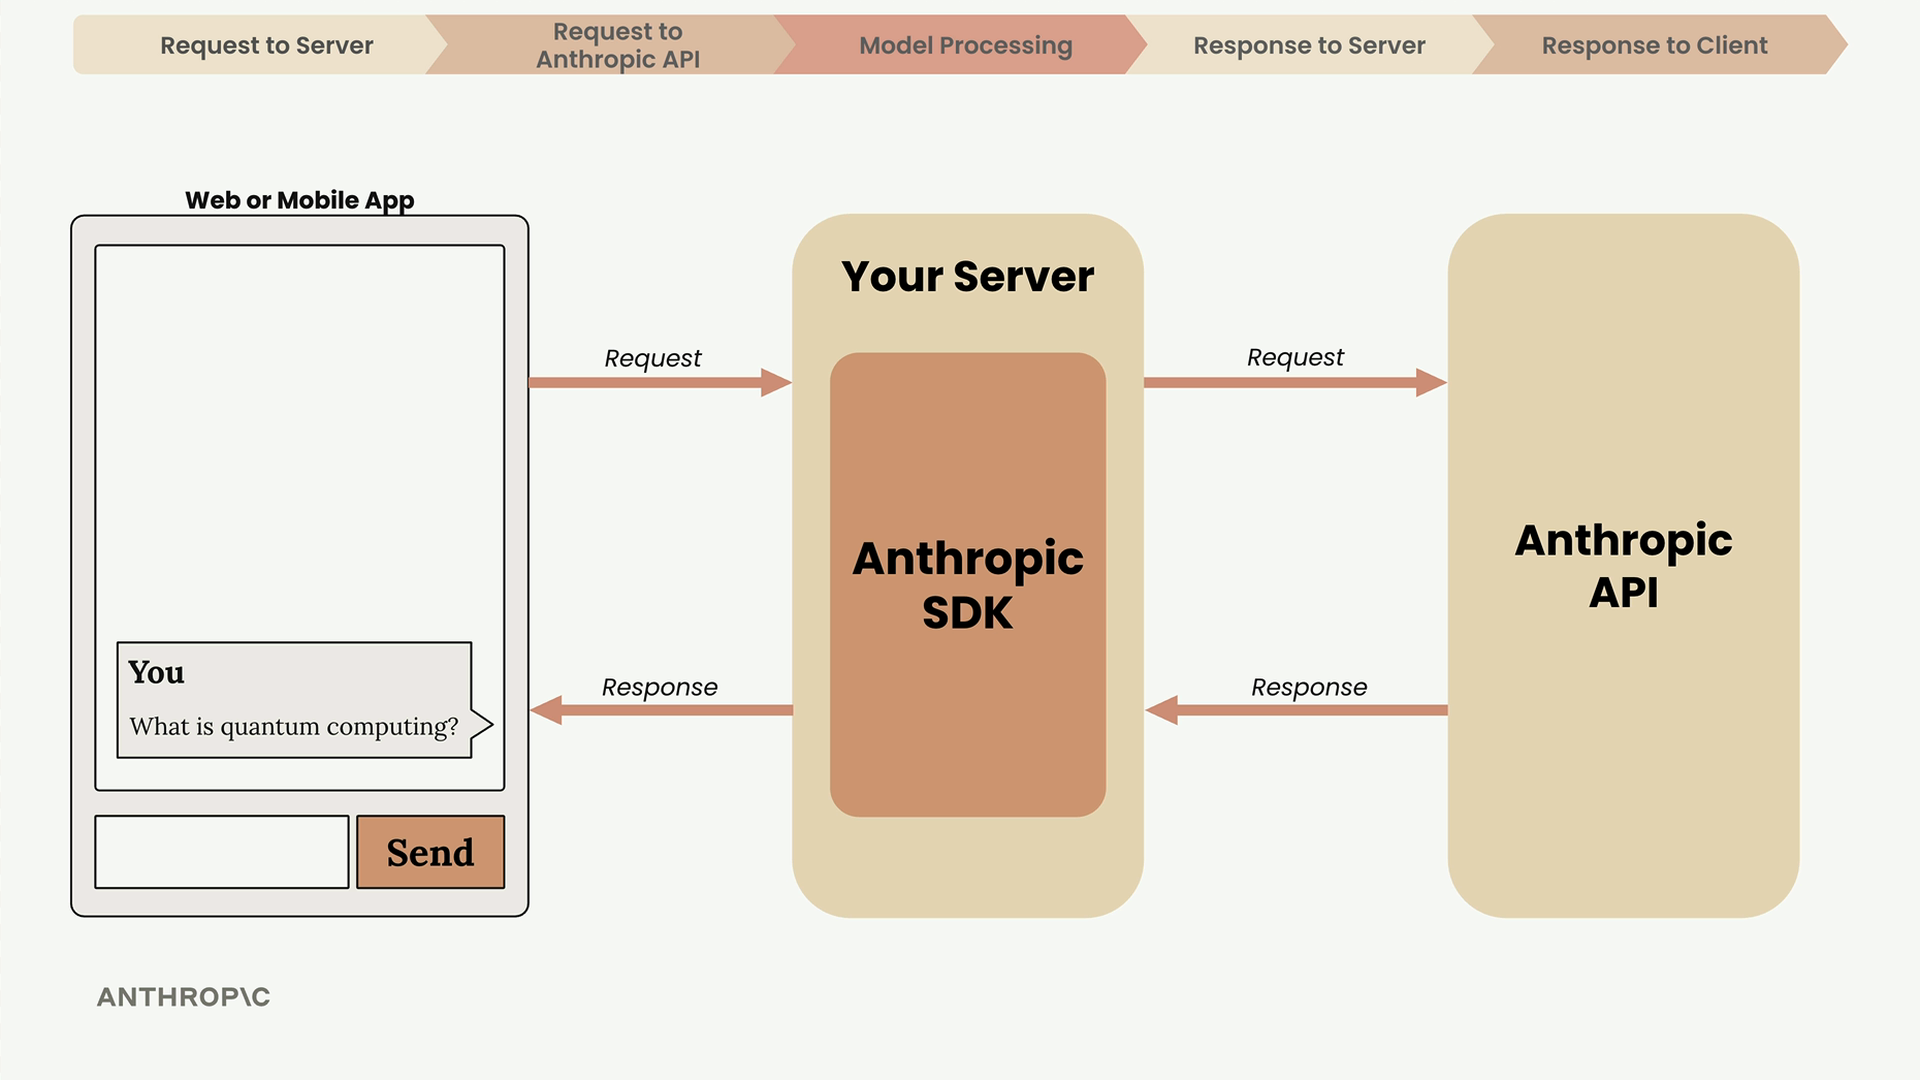
Chaque interaction avec Claude suit un schéma prévisible comportant cinq phases distinctes : requête vers le serveur, requête vers l'API Anthropic, traitement par le modèle, réponse vers le serveur et réponse vers le client.
Pourquoi vous avez besoin d'un serveur
Vous ne devez jamais effectuer de requêtes vers l'API Anthropic directement depuis du code côté client. Voici pourquoi :
- Les requêtes API nécessitent une clé API secrète pour l'authentification
- Exposer cette clé dans le code client crée une grave faille de sécurité
- N'importe qui pourrait extraire la clé et effectuer des requêtes non autorisées
À la place, votre application web ou mobile envoie des requêtes à votre propre serveur, qui communique ensuite avec l'API Anthropic à l'aide de la clé stockée de manière sécurisée.
Effectuer des requêtes API
Lorsque votre serveur contacte l'API Anthropic, vous pouvez utiliser soit un SDK officiel, soit effectuer de simples requêtes HTTP. Anthropic fournit des SDK pour Python, TypeScript, JavaScript, Go et Ruby.
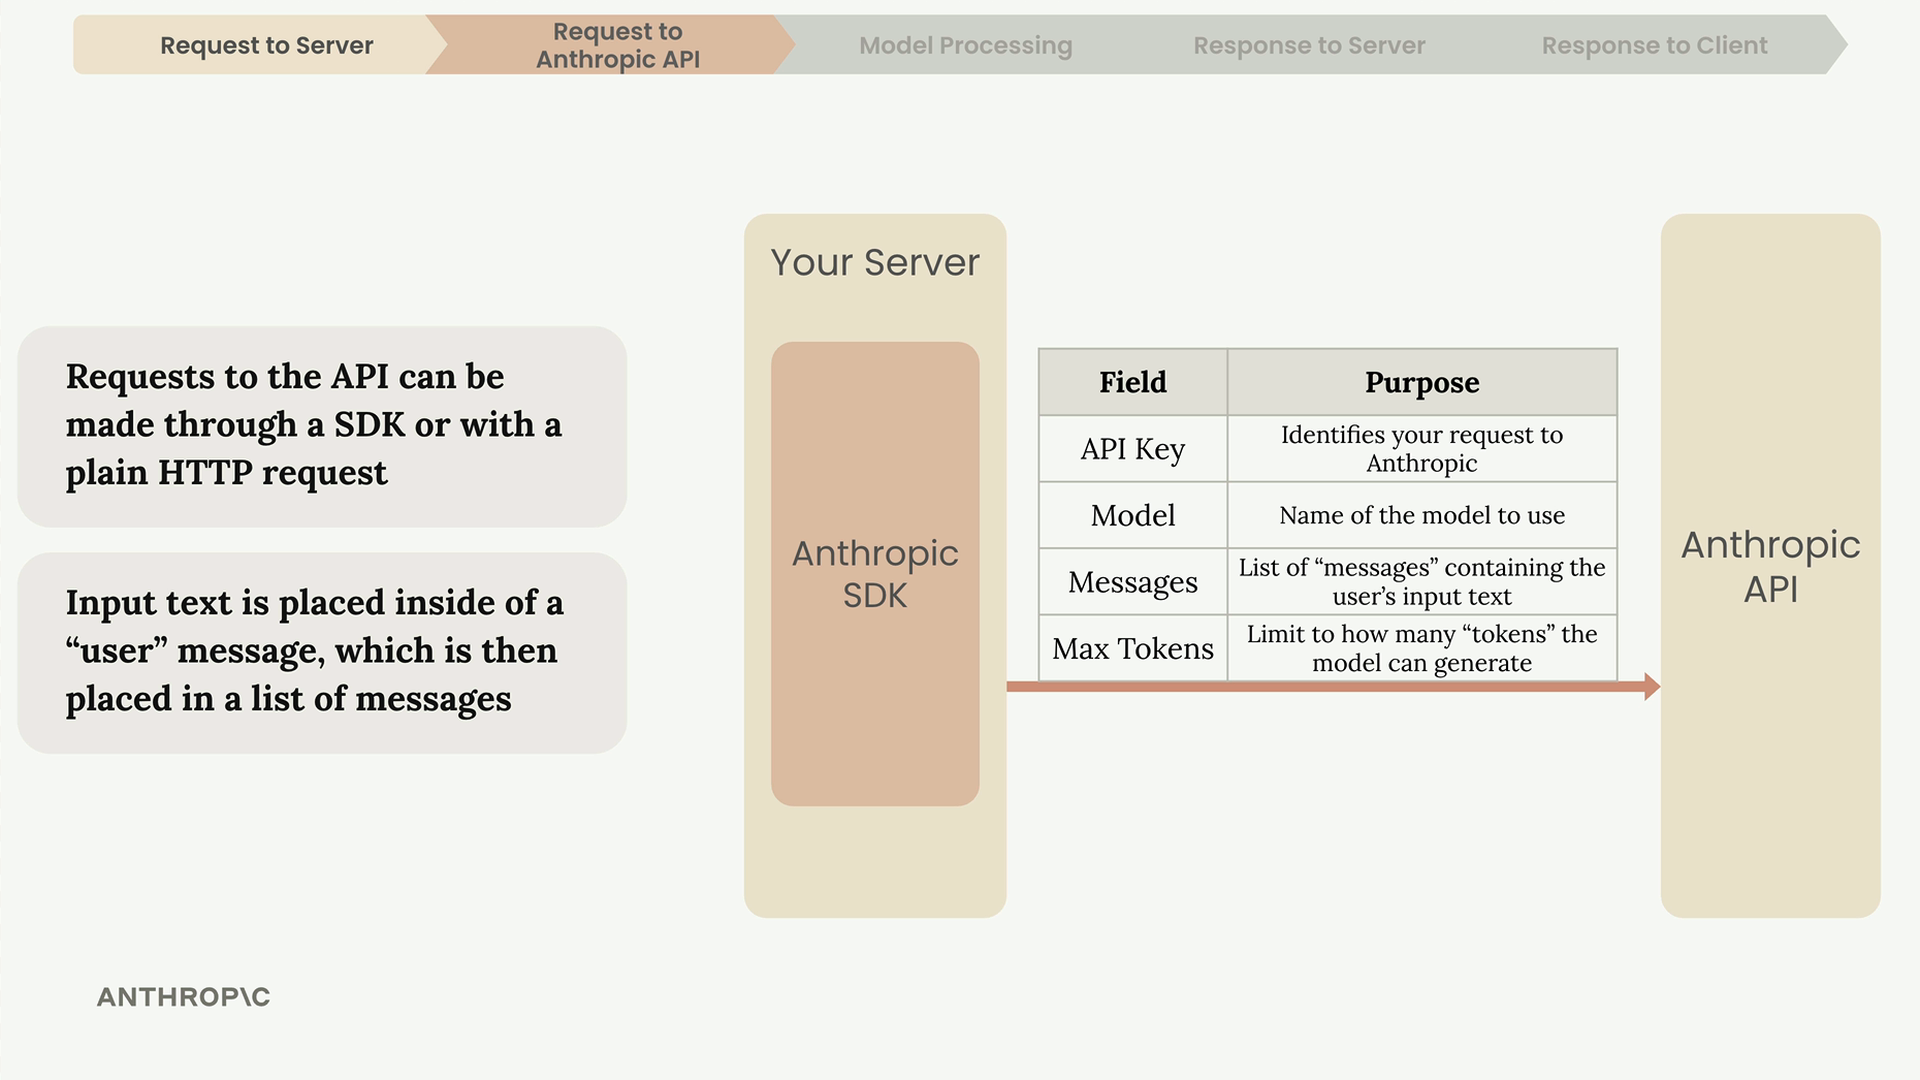
Chaque requête doit inclure les champs essentiels suivants :
- Clé API - Identifie votre requête auprès d'Anthropic
- Modèle - Nom du modèle à utiliser (comme « claude-haiku-4-5 »)
- Messages - Liste contenant le texte saisi par l'utilisateur
- Jetons maximum - Limite du nombre de jetons que Claude peut générer
À l'intérieur du traitement de Claude
Une fois qu'Anthropic reçoit votre requête, Claude la traite en quatre étapes principales : tokenisation, embedding, contextualisation et génération.
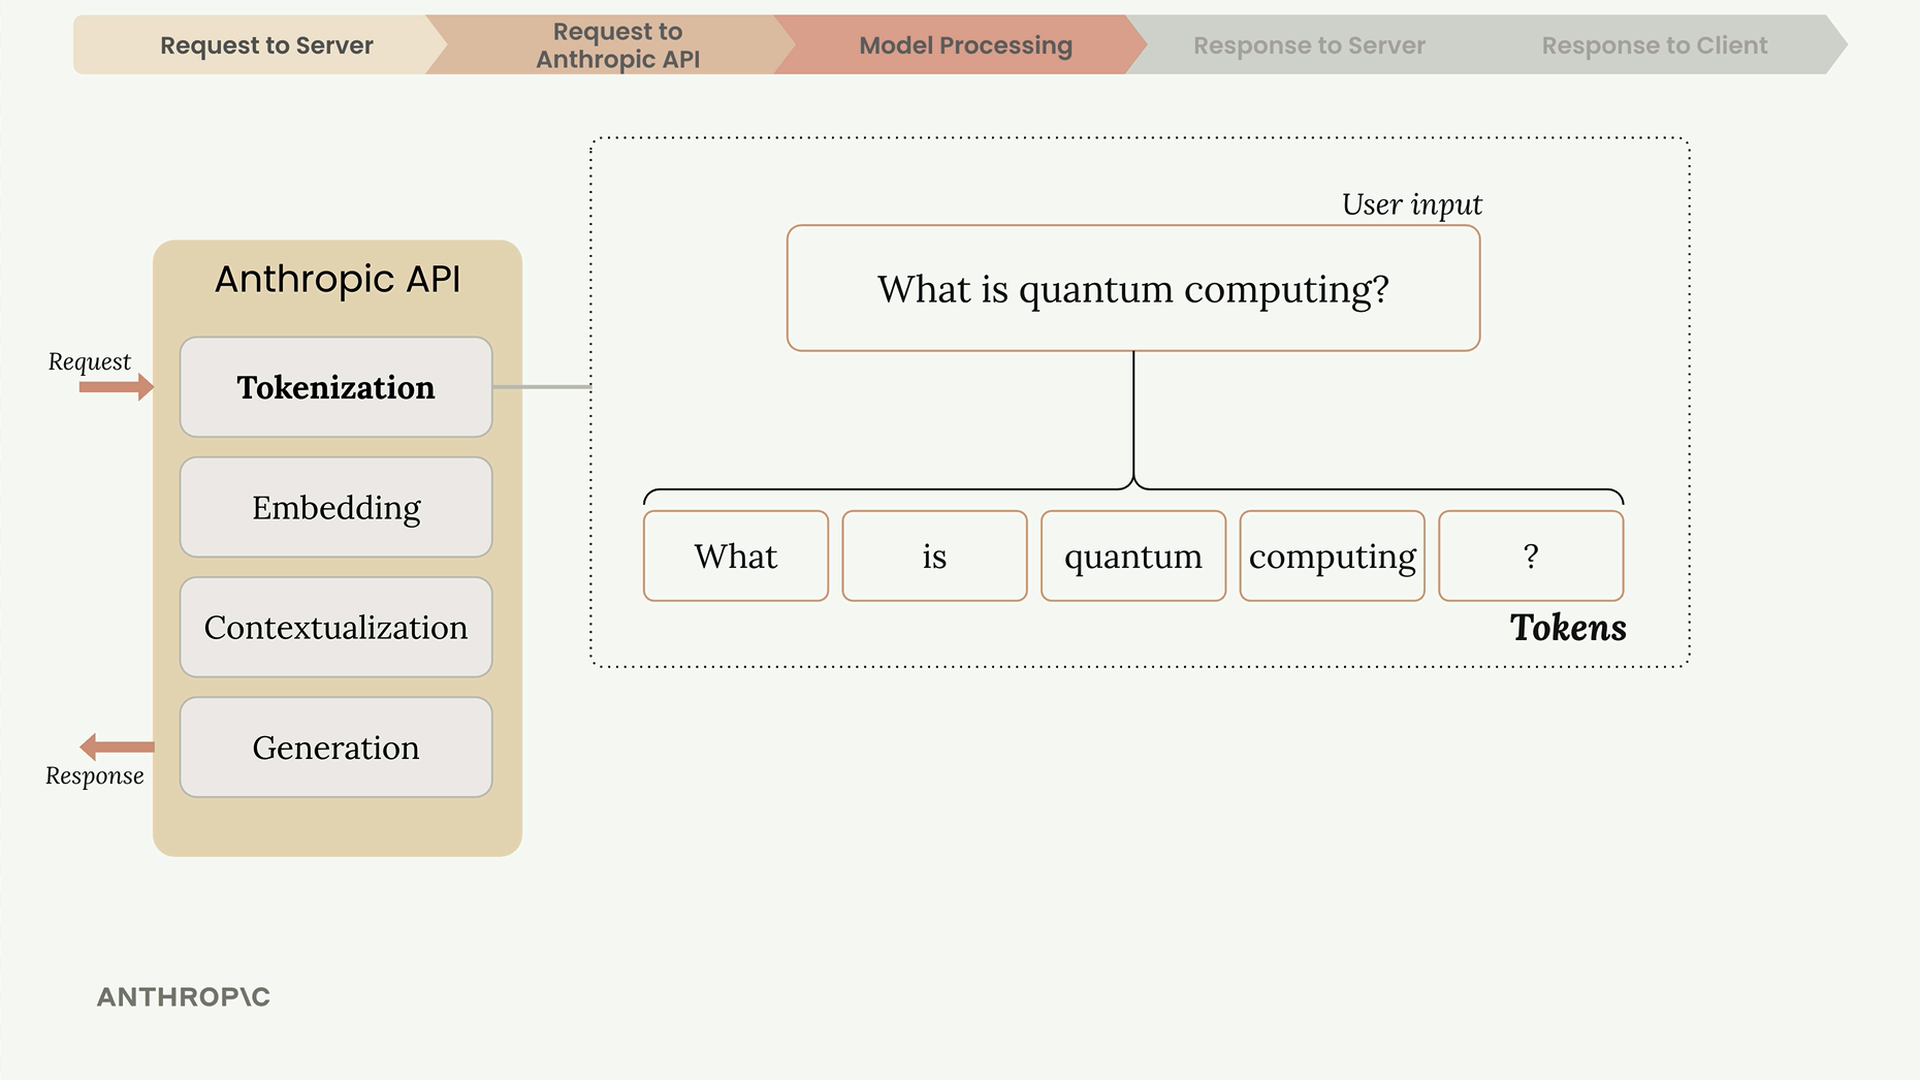
Tokenisation
Claude commence par découper votre texte saisi en plus petits morceaux appelés jetons. Il peut s'agir de mots entiers, de parties de mots, d'espaces ou de symboles. Pour simplifier, considérez chaque mot comme un seul jeton.
Embedding
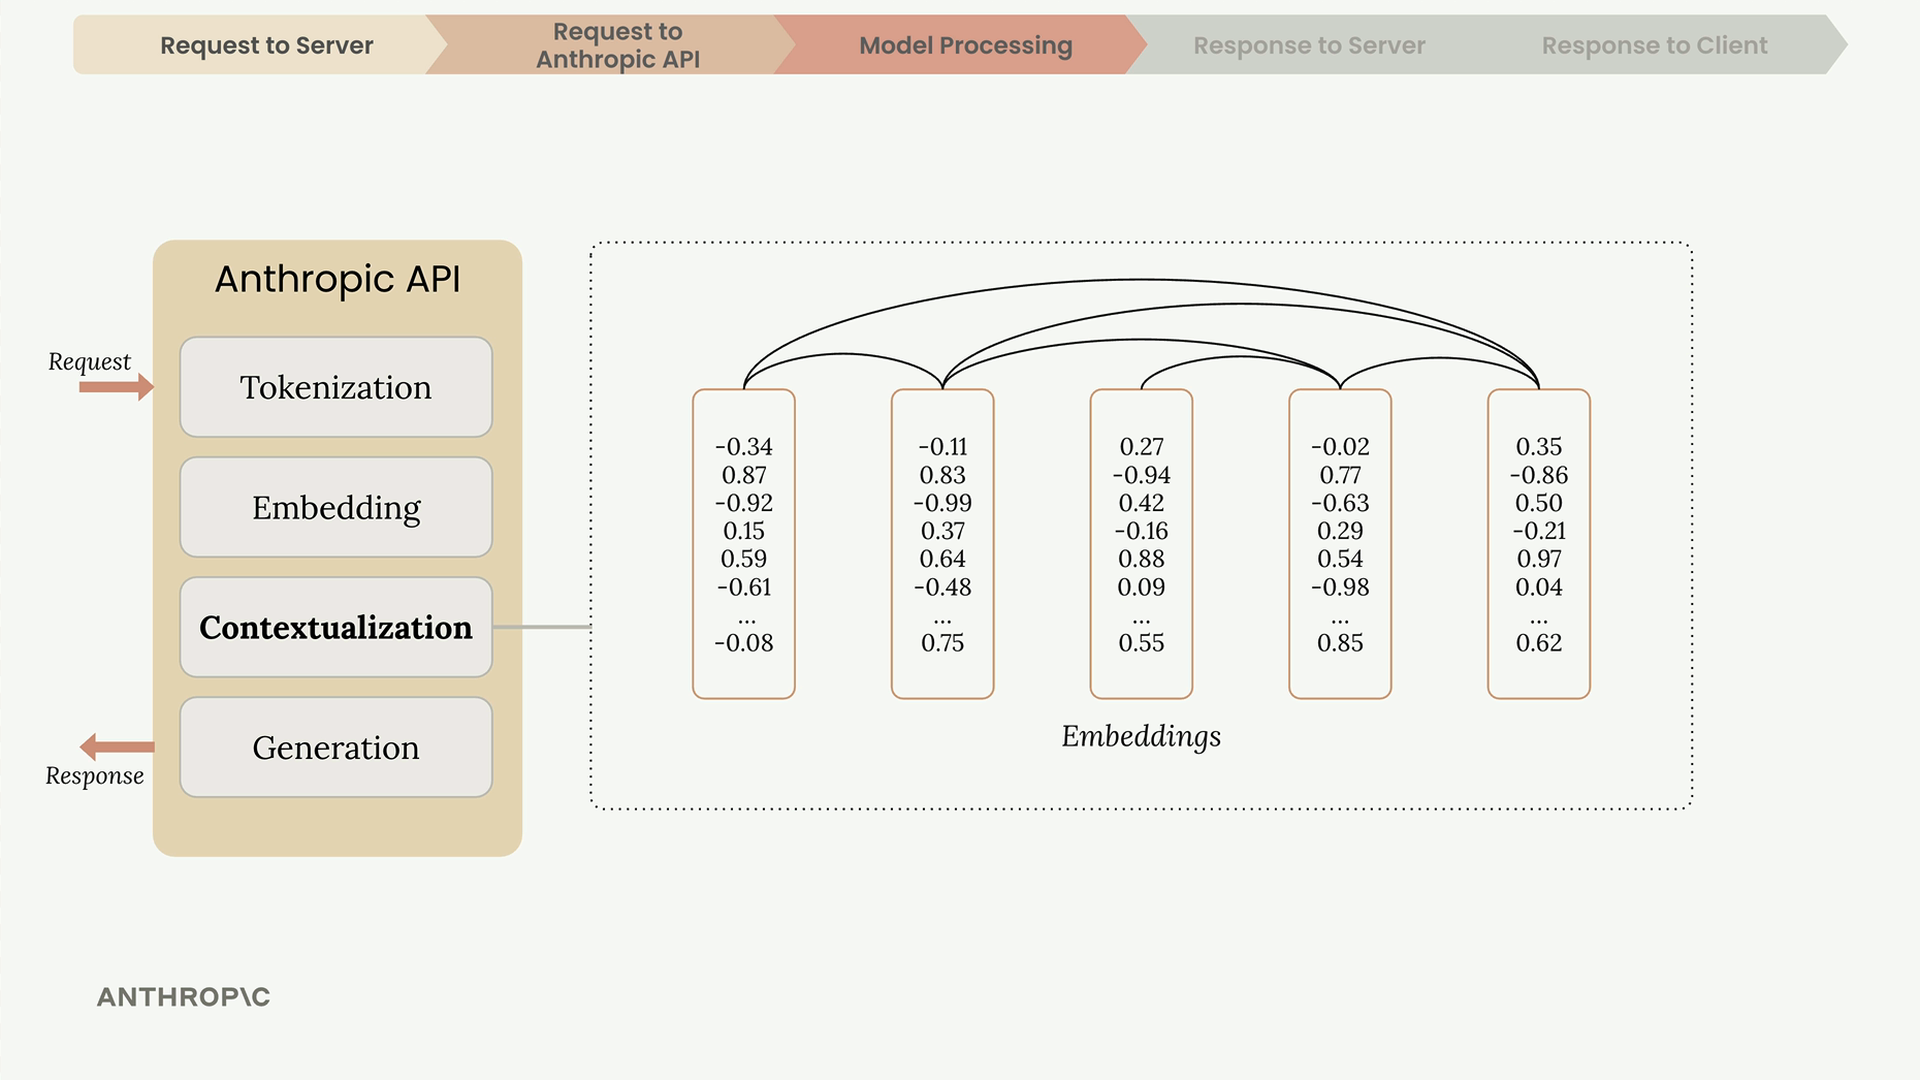
Chaque jeton est converti en un embedding, c'est-à-dire une longue liste de nombres qui représente tous les sens possibles de ce mot. Considérez les embeddings comme des définitions numériques qui capturent les relations sémantiques.
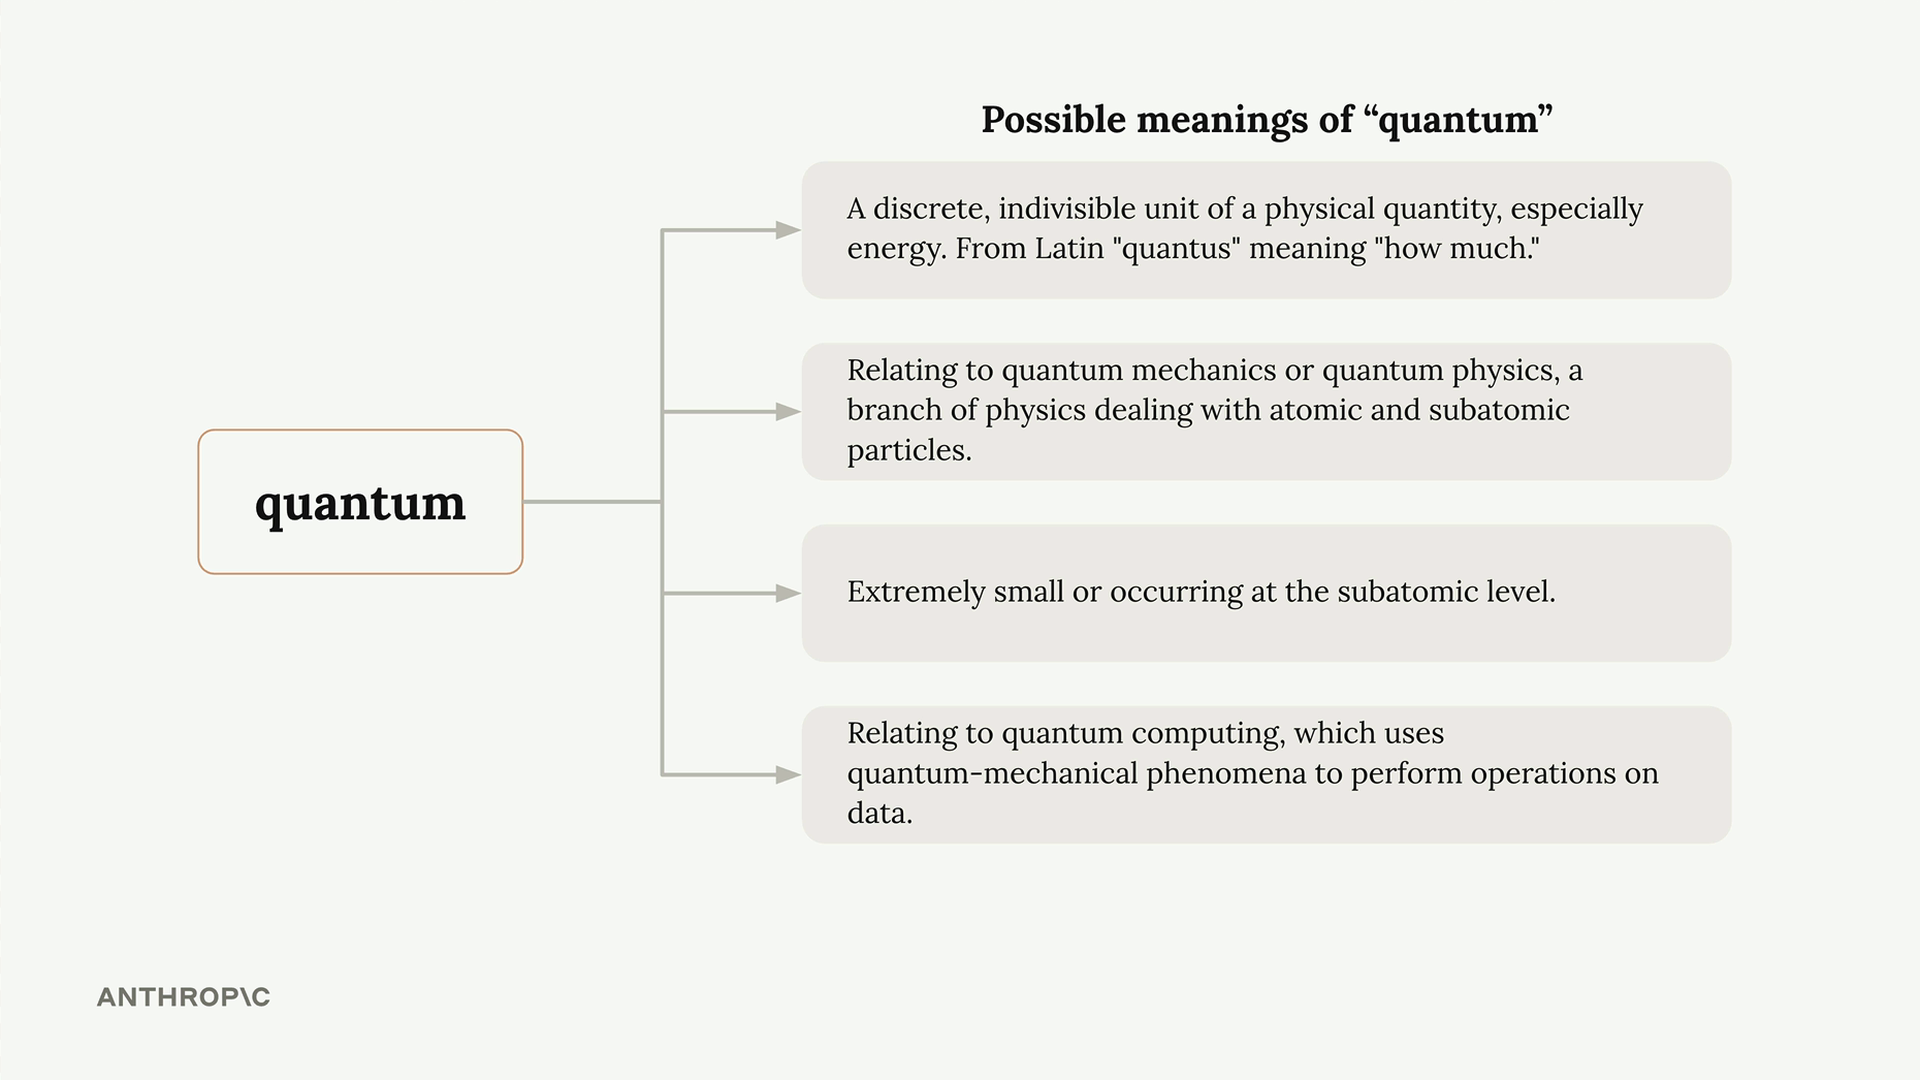
Les mots ont souvent plusieurs sens. Par exemple, « quantum » pourrait faire référence à :
- Une unité discrète de grandeur physique (physique)
- La mécanique quantique ou des concepts de physique quantique
- Quelque chose d'extrêmement petit ou subatomique
- Des applications d'informatique quantique
Contextualisation
Claude affine chaque embedding en fonction des mots environnants afin de déterminer le sens le plus probable dans son contexte. Ce processus ajuste les représentations numériques pour mettre en avant la définition appropriée.
Génération
Les embeddings contextualisés passent par une couche de sortie qui calcule les probabilités pour chaque mot suivant possible. Claude ne choisit pas toujours le mot ayant la probabilité la plus élevée : il utilise un mélange de probabilité et de hasard contrôlé pour créer des réponses naturelles et variées.
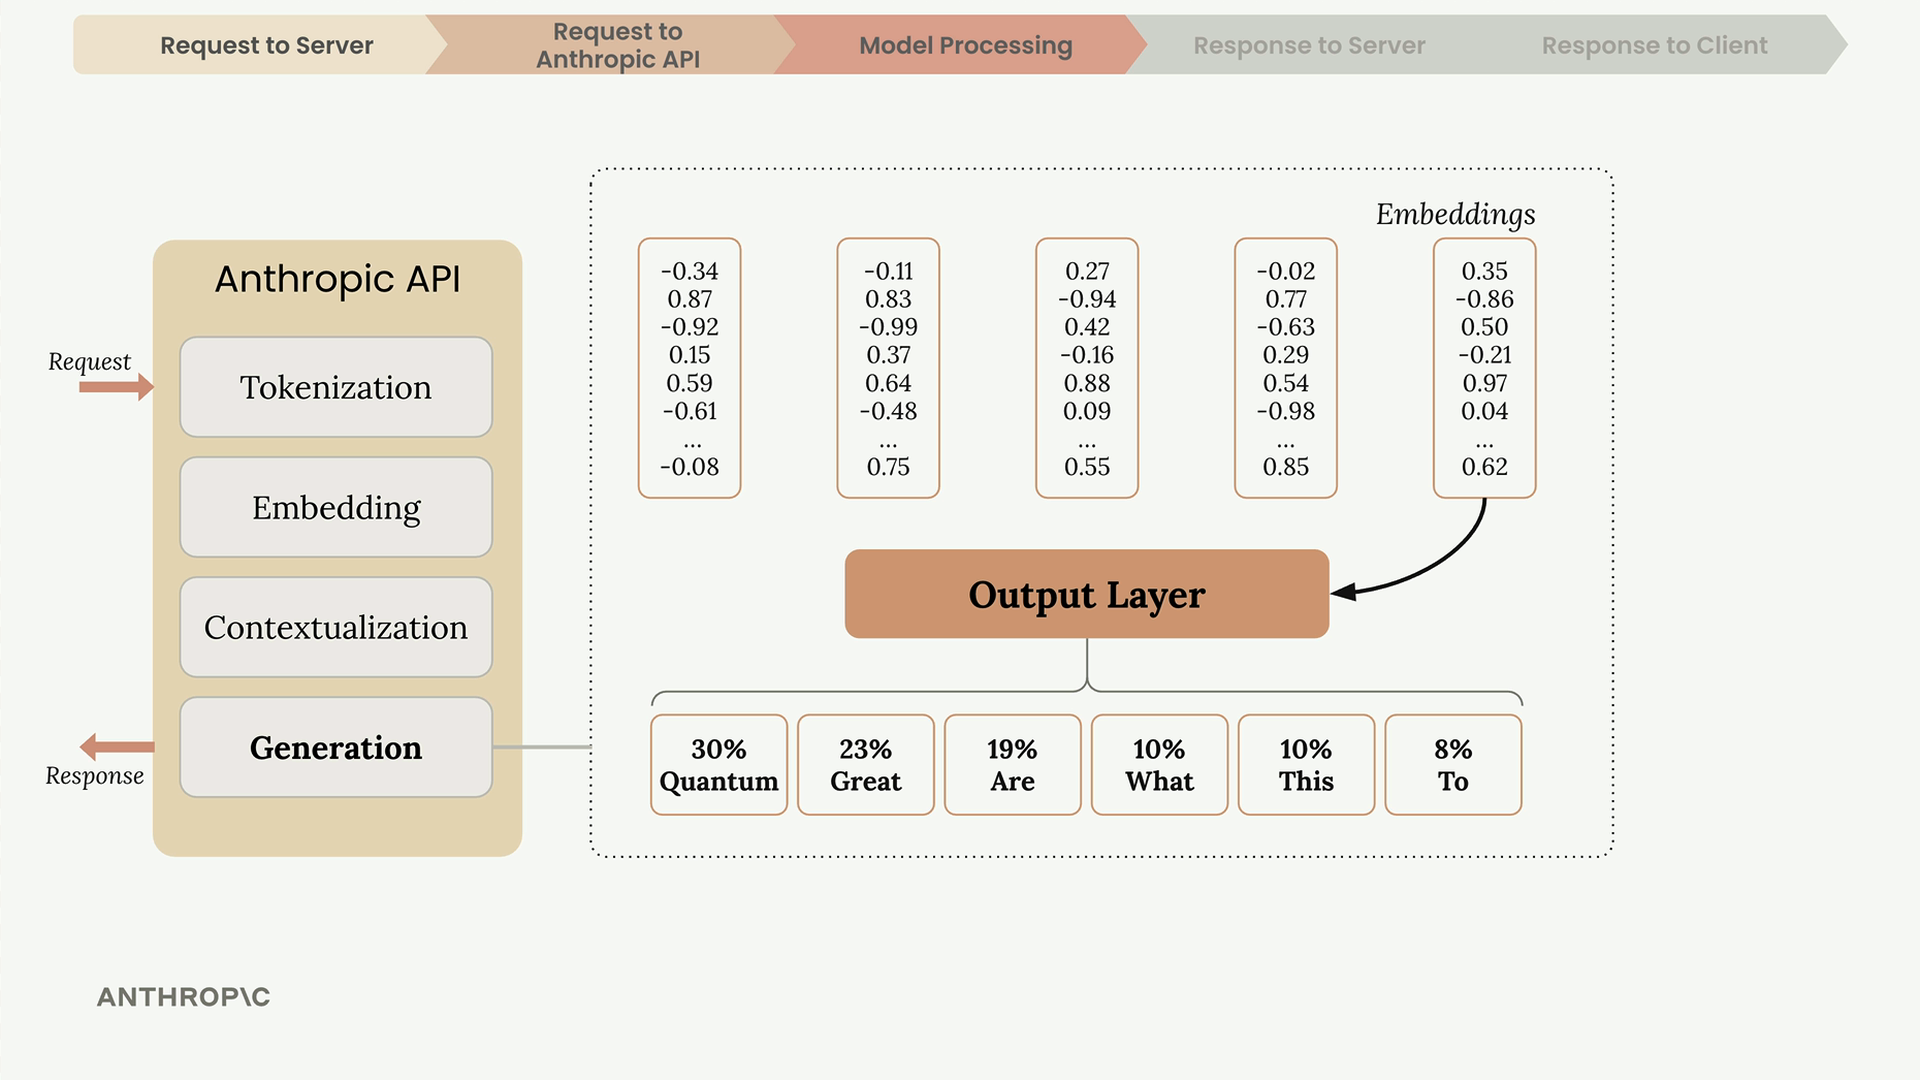
Après avoir sélectionné chaque mot, Claude l'ajoute à la séquence et répète l'ensemble du processus pour le mot suivant.
Quand Claude arrête de générer
Après chaque jeton, Claude vérifie plusieurs conditions pour décider s'il doit continuer :
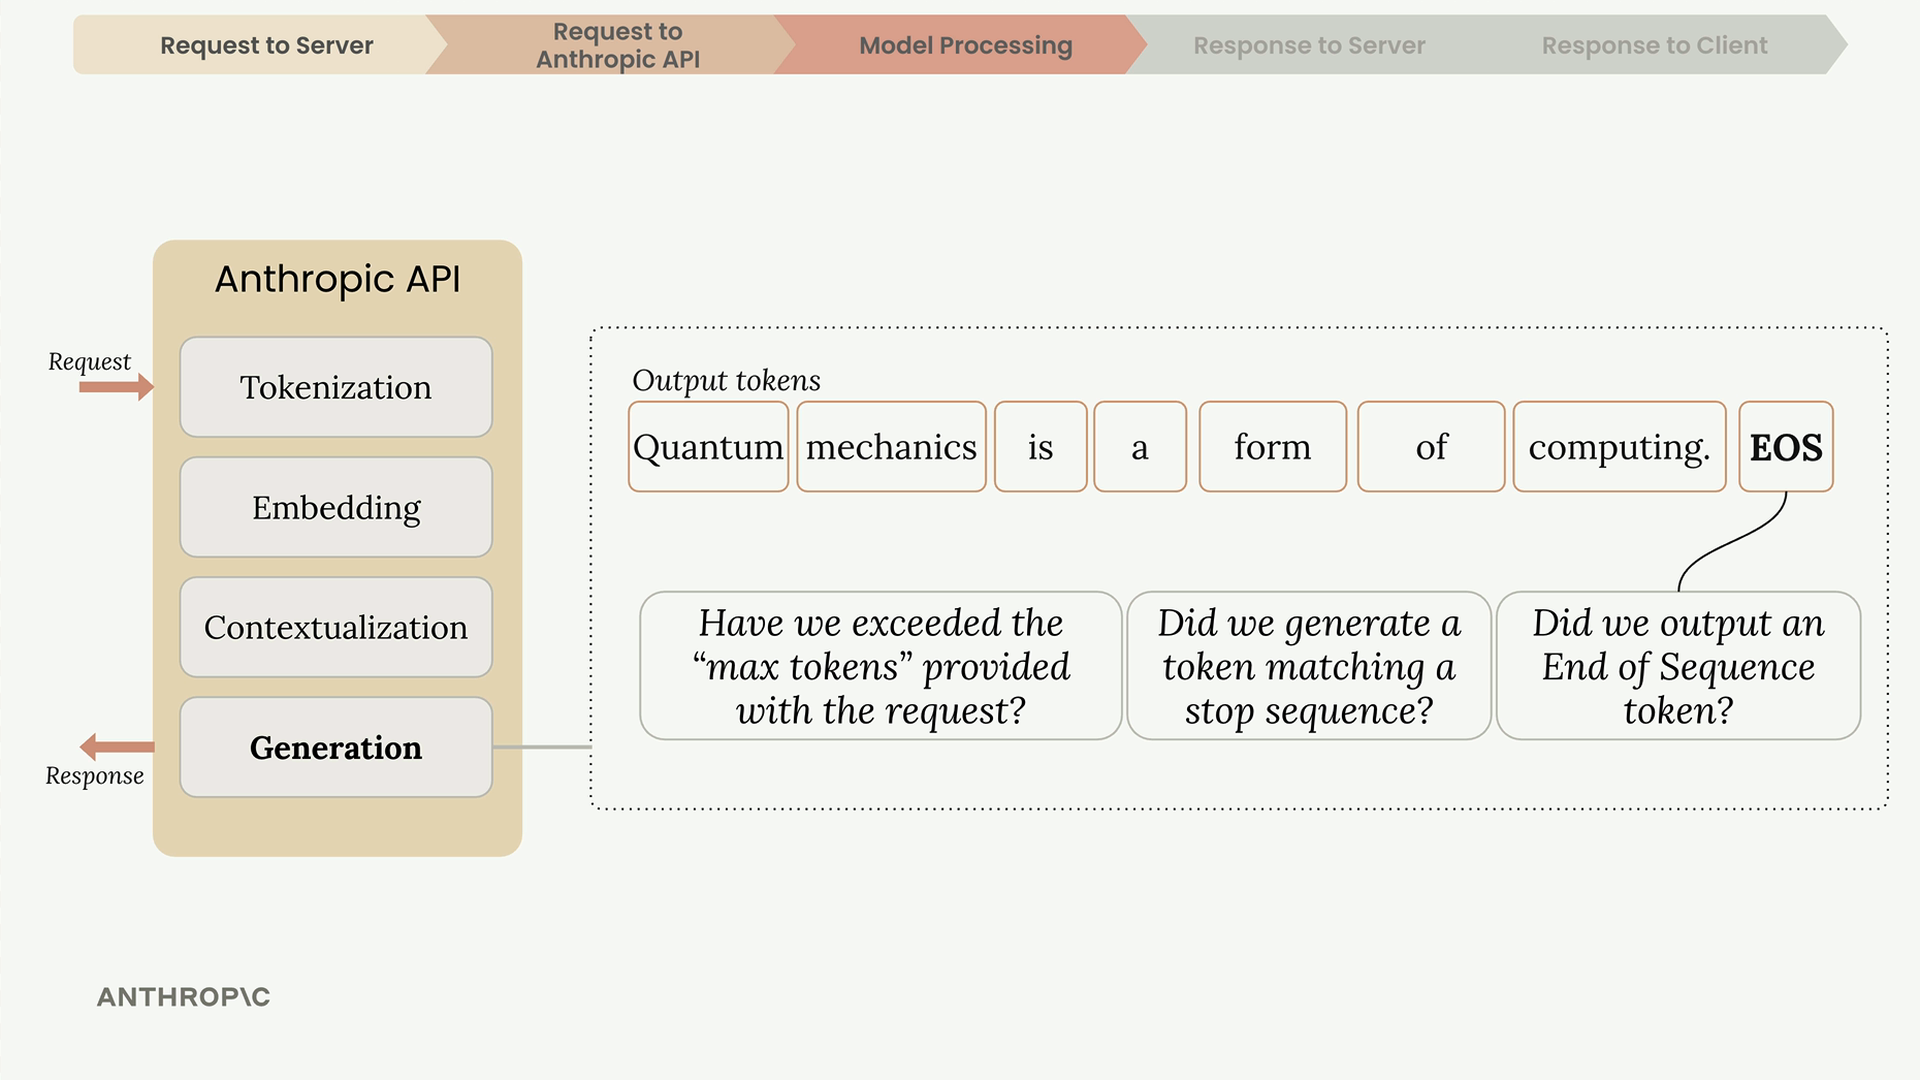
- Nombre maximal de jetons atteint - A-t-il atteint la limite que vous avez spécifiée ?
- Fin naturelle - A-t-il généré un jeton de fin de séquence ?
- Séquence d'arrêt - A-t-il rencontré une phrase d'arrêt prédéfinie ?
La réponse de l'API
Une fois la génération terminée, l'API renvoie une réponse structurée contenant :
- Message - Le texte généré
- Utilisation - Le nombre de jetons d'entrée et de sortie
- Motif d'arrêt - La raison pour laquelle la génération s'est arrêtée
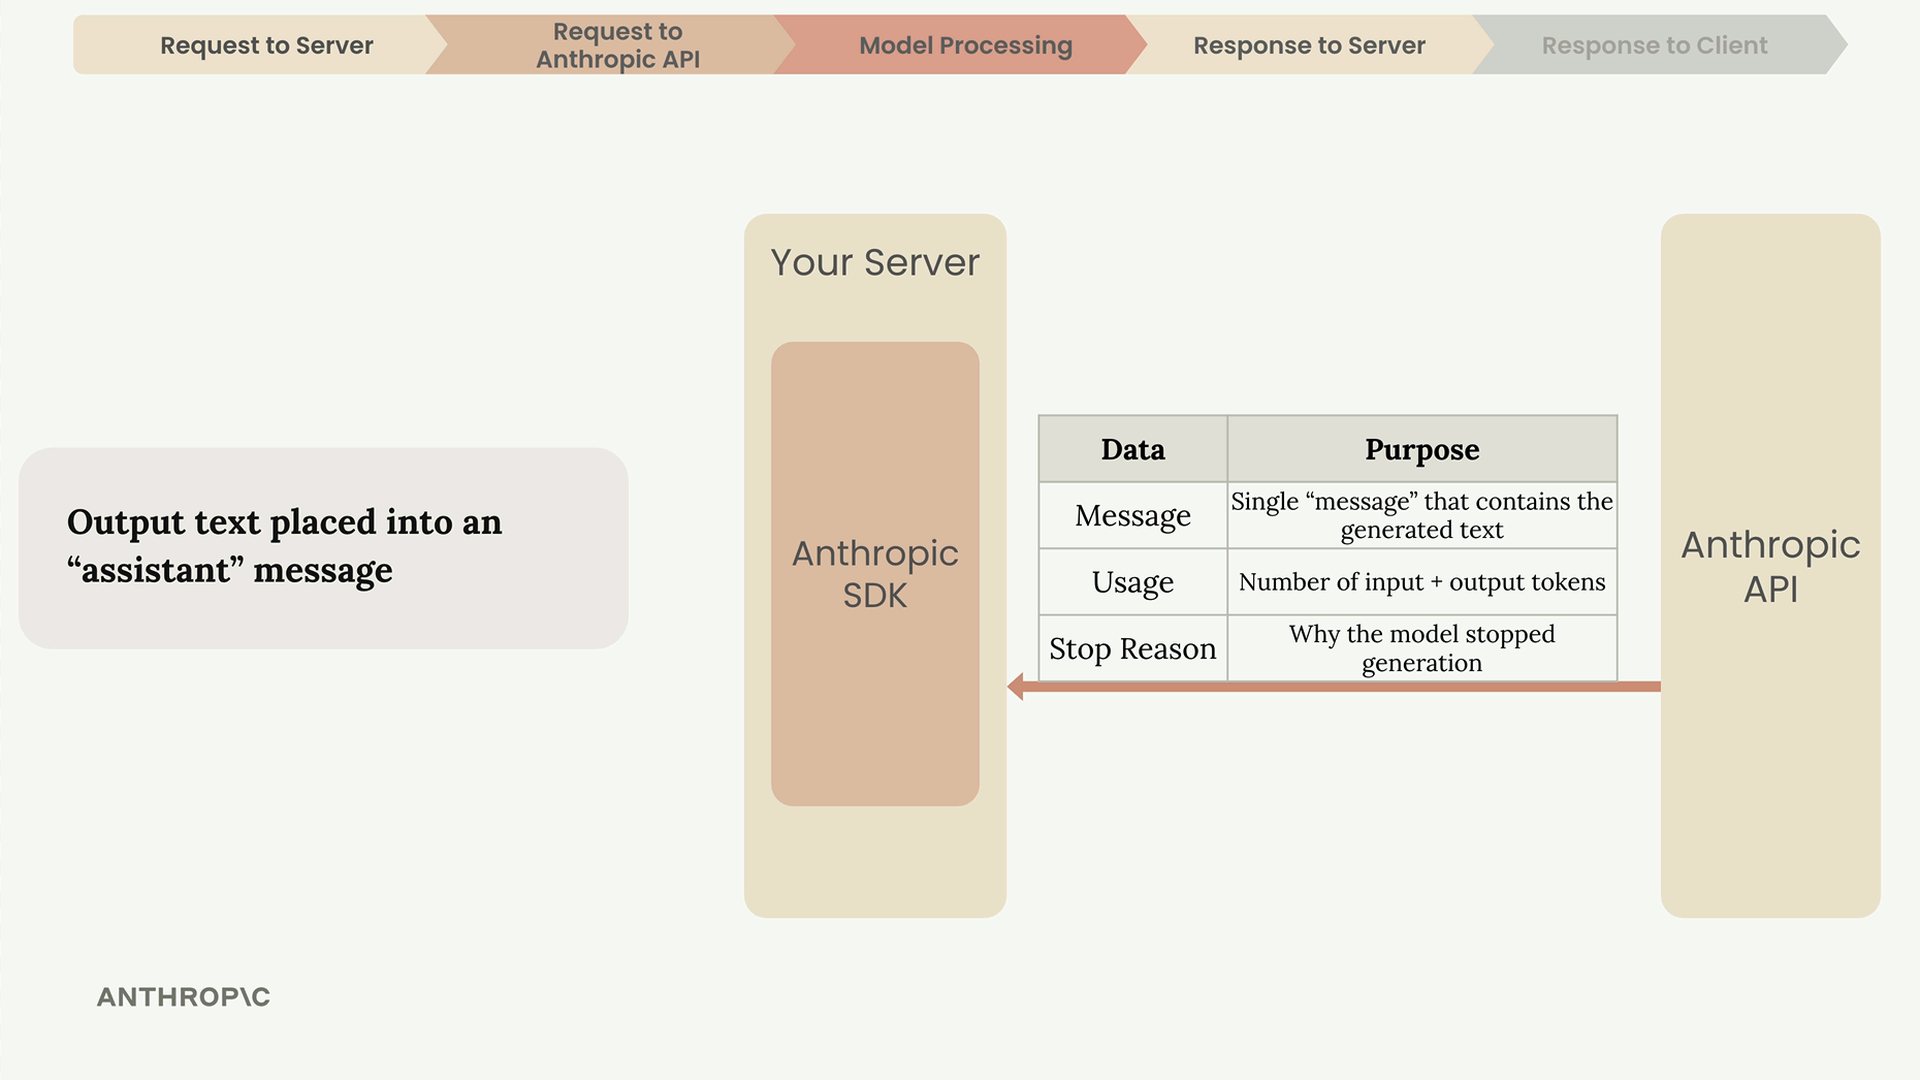
Votre serveur reçoit cette réponse et transmet le texte généré à votre application cliente, où il apparaît dans l'interface utilisateur.
Points clés à retenir
Comprendre ce flux vous aide à :
- Concevoir des architectures sécurisées qui protègent vos clés API
- Définir des limites de jetons appropriées pour votre cas d'usage
- Gérer les différents motifs d'arrêt dans la logique de votre application
- Déboguer les problèmes en comprenant où ils peuvent survenir dans le pipeline
Ne vous inquiétez pas de mémoriser chaque détail : l'objectif est de vous familiariser avec la terminologie et le processus global que vous rencontrerez en travaillant avec l'API de Claude.