Nachdem wir nun die Grundlagen von RAG, Text-Chunking und Embeddings behandelt haben, gehen wir die komplette RAG-Pipeline Schritt für Schritt durch. Dieses detaillierte Beispiel zeigt dir genau, wie alle Teile in einer echten Implementierung zusammenpassen.
Schritt 1: Zerlege deinen Quelltext in Chunks
Zuerst nehmen wir unser Quelldokument und zerlegen es in handhabbare Chunks. Für dieses Beispiel verwenden wir zwei einfache Textabschnitte:
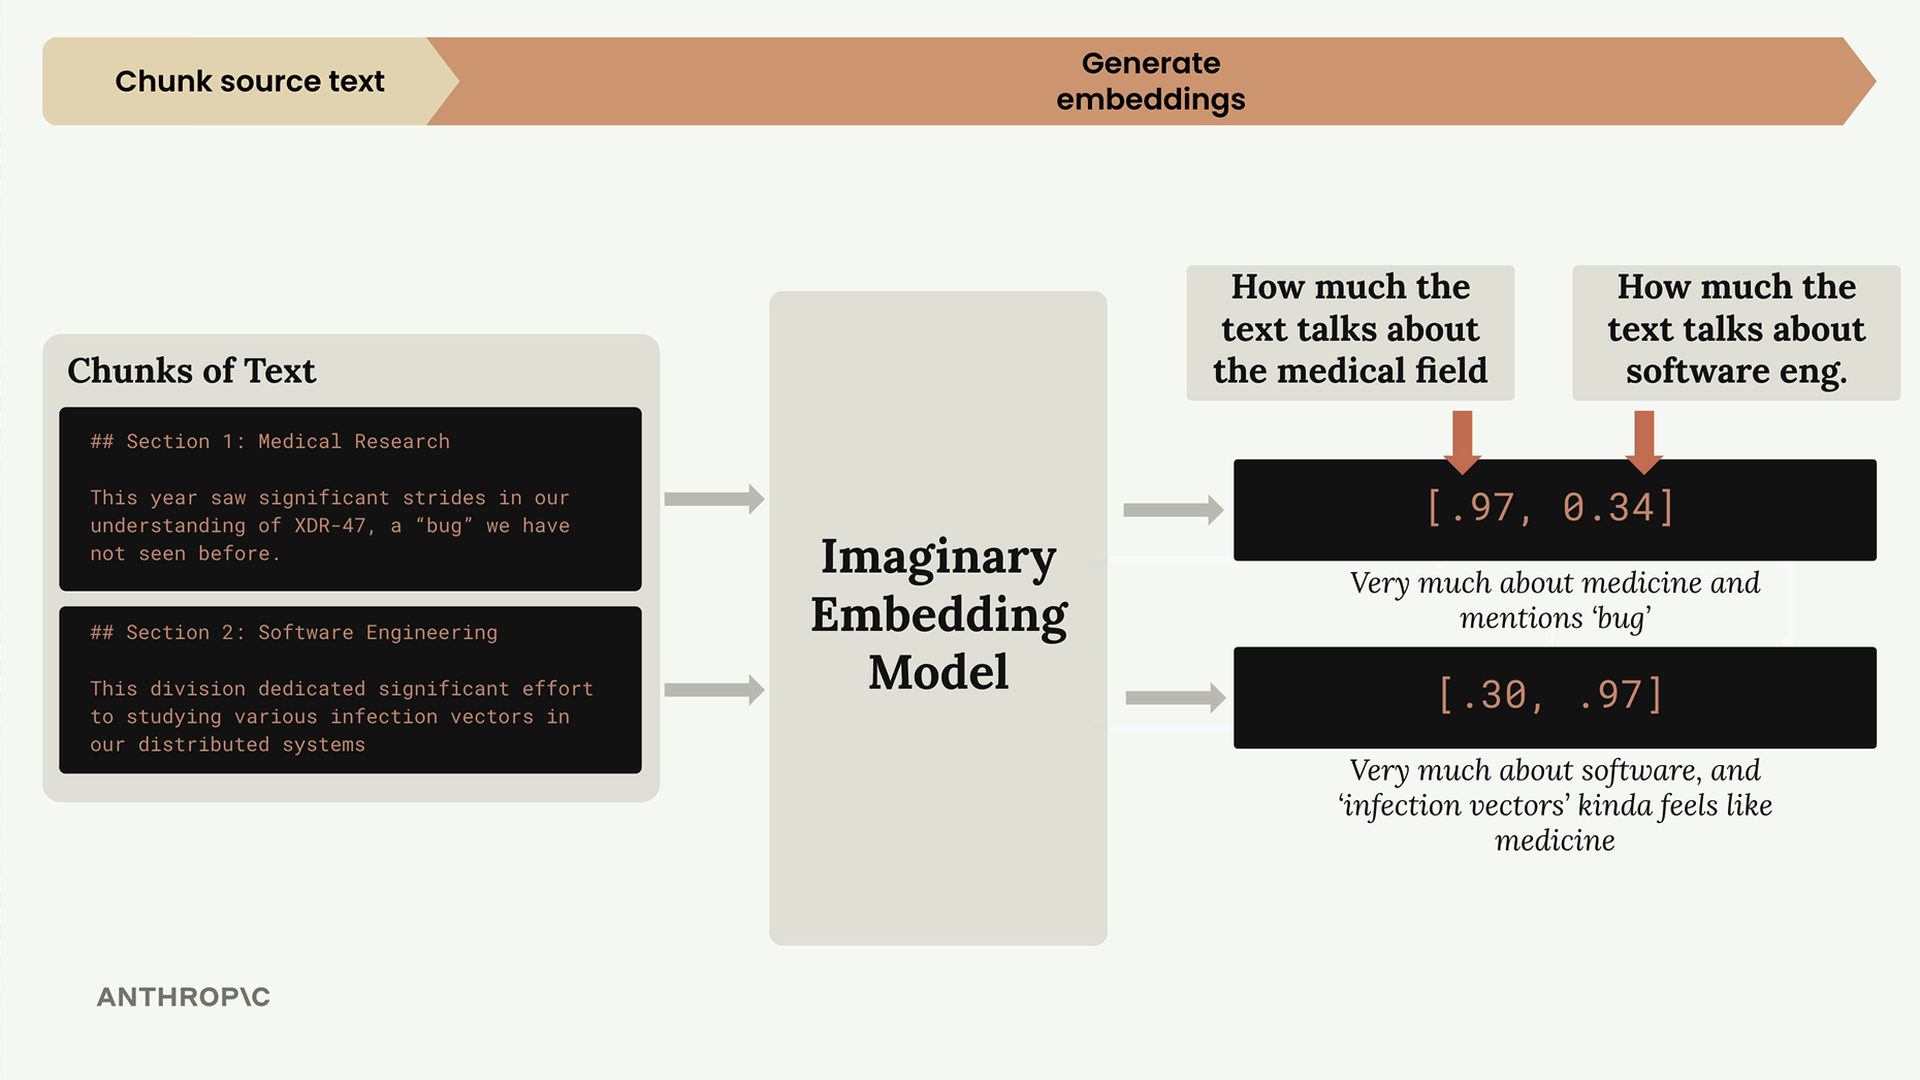
- Abschnitt 1: Medizinische Forschung – „Dieses Jahr hat bedeutende Fortschritte im Verständnis von XDR-47 gebracht, einem 'Bug', den wir zuvor noch nicht gesehen haben."
- Abschnitt 2: Software-Engineering – „Diese Abteilung widmete sich intensiv der Untersuchung verschiedener Infektionsvektoren in unseren verteilten Systemen"
Schritt 2: Erzeuge Embeddings
Als Nächstes wandeln wir jeden Text-Chunk in numerische Embeddings um. Um dieses Konzept klar zu machen, stellen wir uns vor, wir hätten ein perfektes Embedding-Modell, das immer genau zwei Zahlen zurückgibt, und wir wissen, wofür jede Zahl steht:
In unserem imaginären Modell:
- Erste Zahl: Wie stark der Text vom medizinischen Bereich handelt
- Zweite Zahl: Wie stark der Text von Software-Engineering handelt
Unser medizinischer Forschungsabschnitt erhält also ein Embedding von [0.97, 0.34] – sehr medizinisch, etwas software-bezogen wegen des Wortes „Bug". Der Software-Engineering-Abschnitt erhält [0.30, 0.97] – sehr software-lastig, aber „Infektionsvektoren" hat medizinische Konnotationen.
Normalisierung
Bevor diese Embeddings gespeichert werden, durchlaufen sie einen Normalisierungsprozess, der jeden Vektor so skaliert, dass er eine Länge von 1,0 hat. Dies wird normalerweise automatisch von deiner Embedding-API übernommen, aber es ist wichtig zu verstehen, dass es passiert.
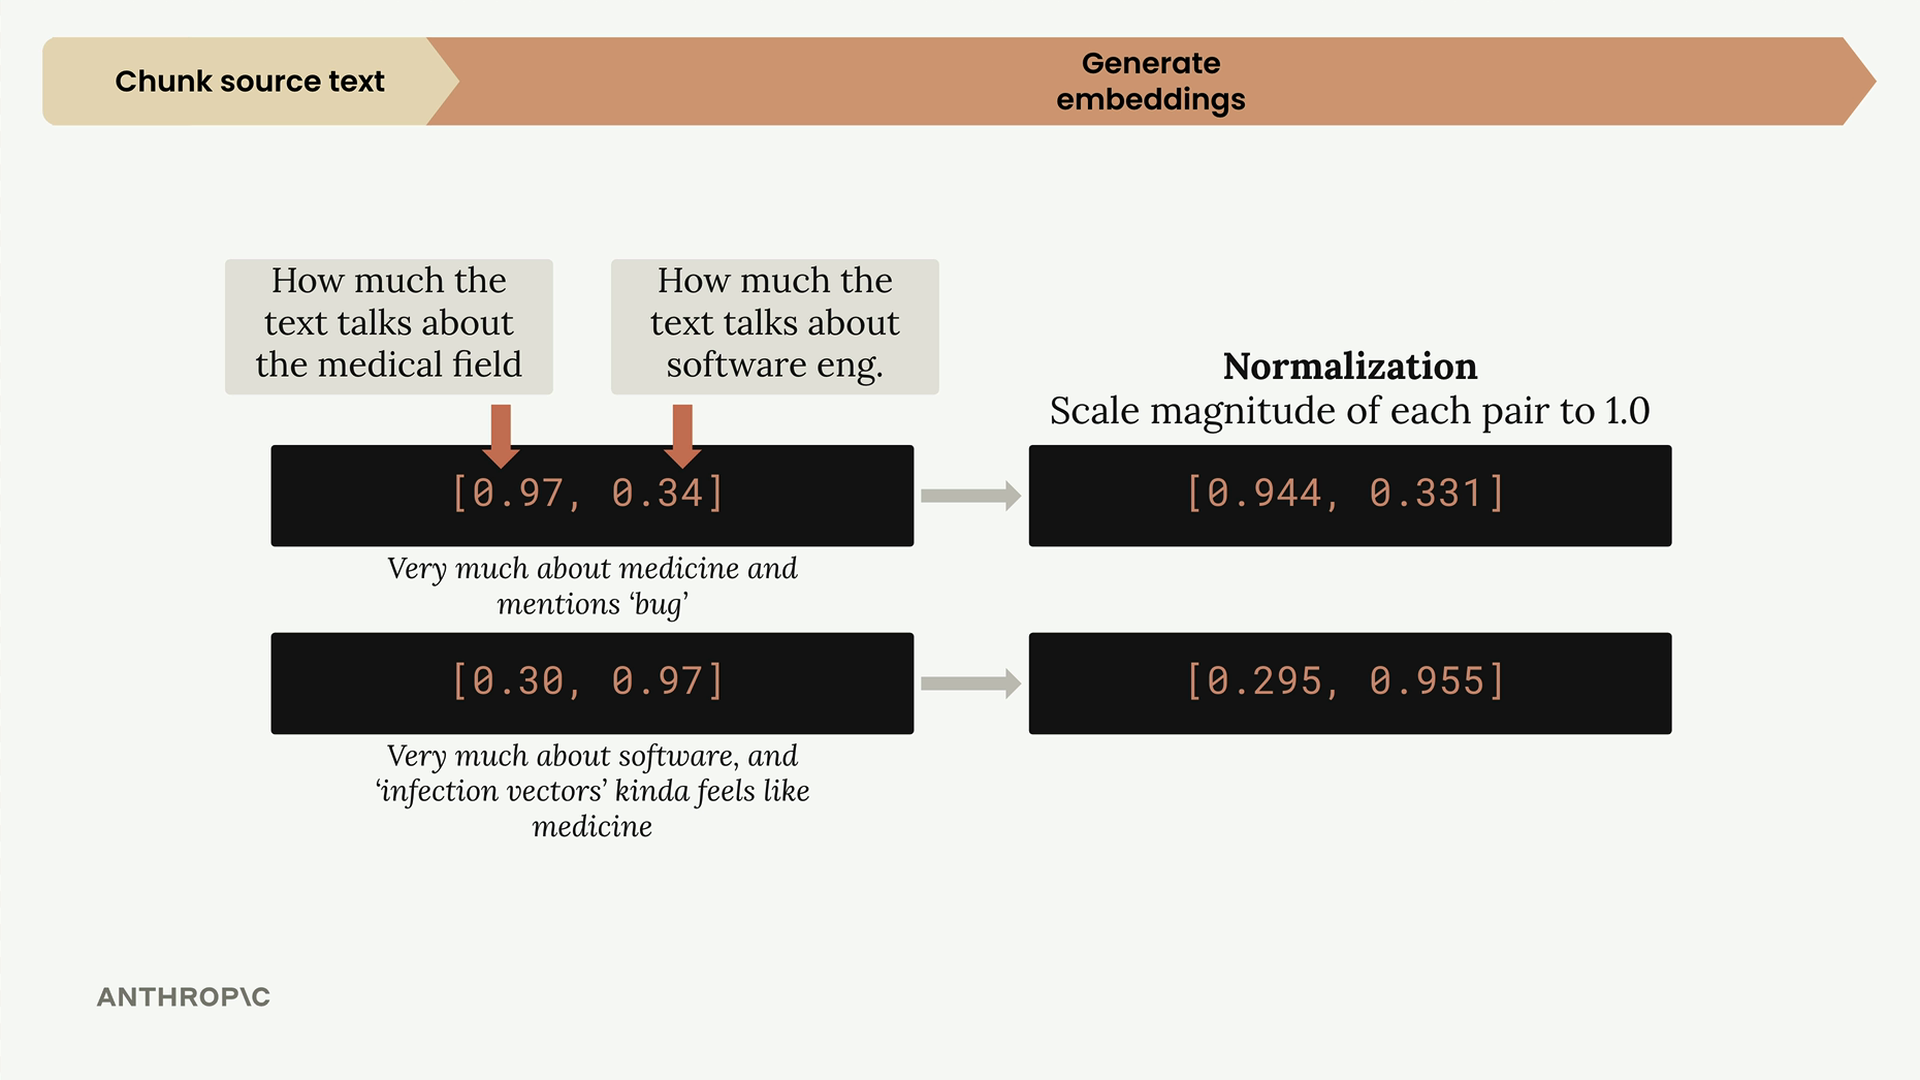
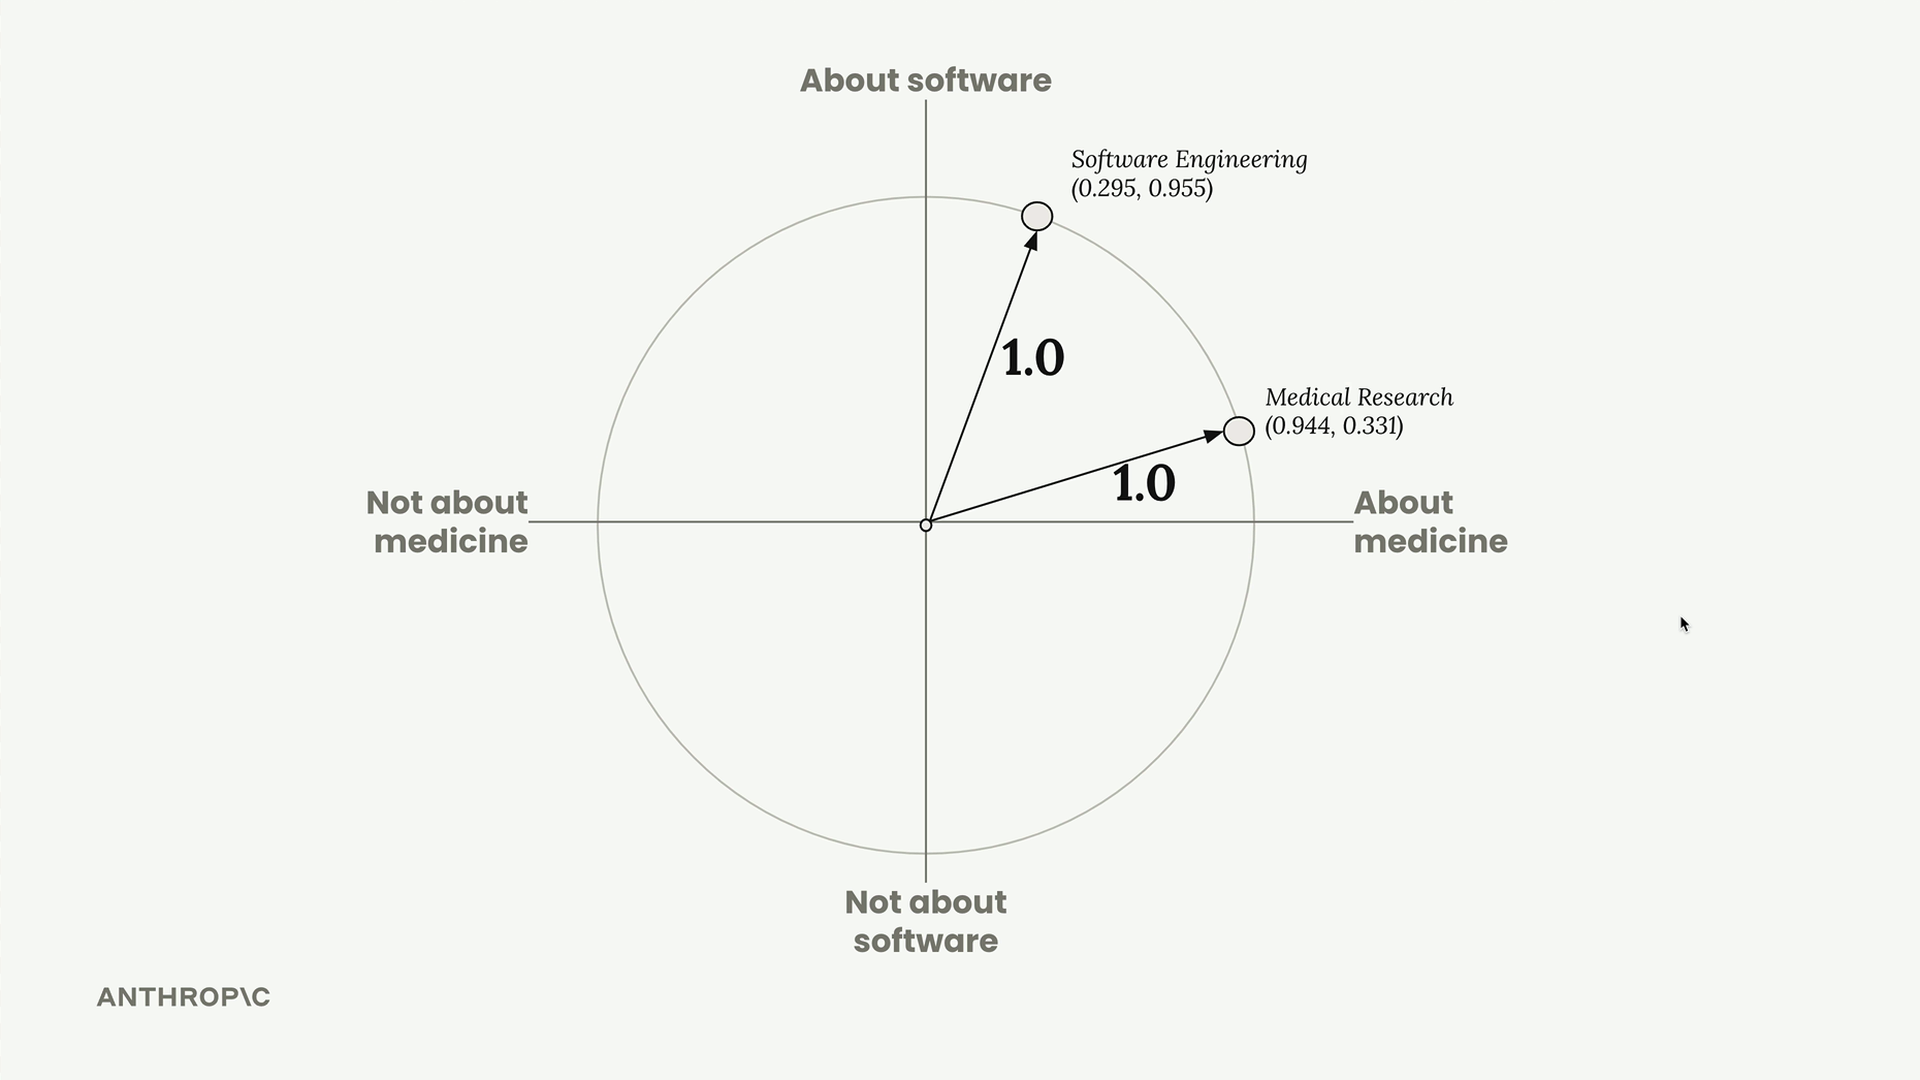
Nach der Normalisierung werden unsere Embeddings zu [0.944, 0.331] und [0.295, 0.955]. Wir können diese auf einem Einheitskreis visualisieren, bei dem jeder Punkt genau am Rand des Kreises liegt.
Schritt 3: Speichern in der Vektordatenbank
Die normalisierten Embeddings werden in einer Vektordatenbank gespeichert – einer spezialisierten Datenbank, die für das Speichern, Vergleichen und Durchsuchen langer Zahlenlisten wie unserer Embeddings optimiert ist.
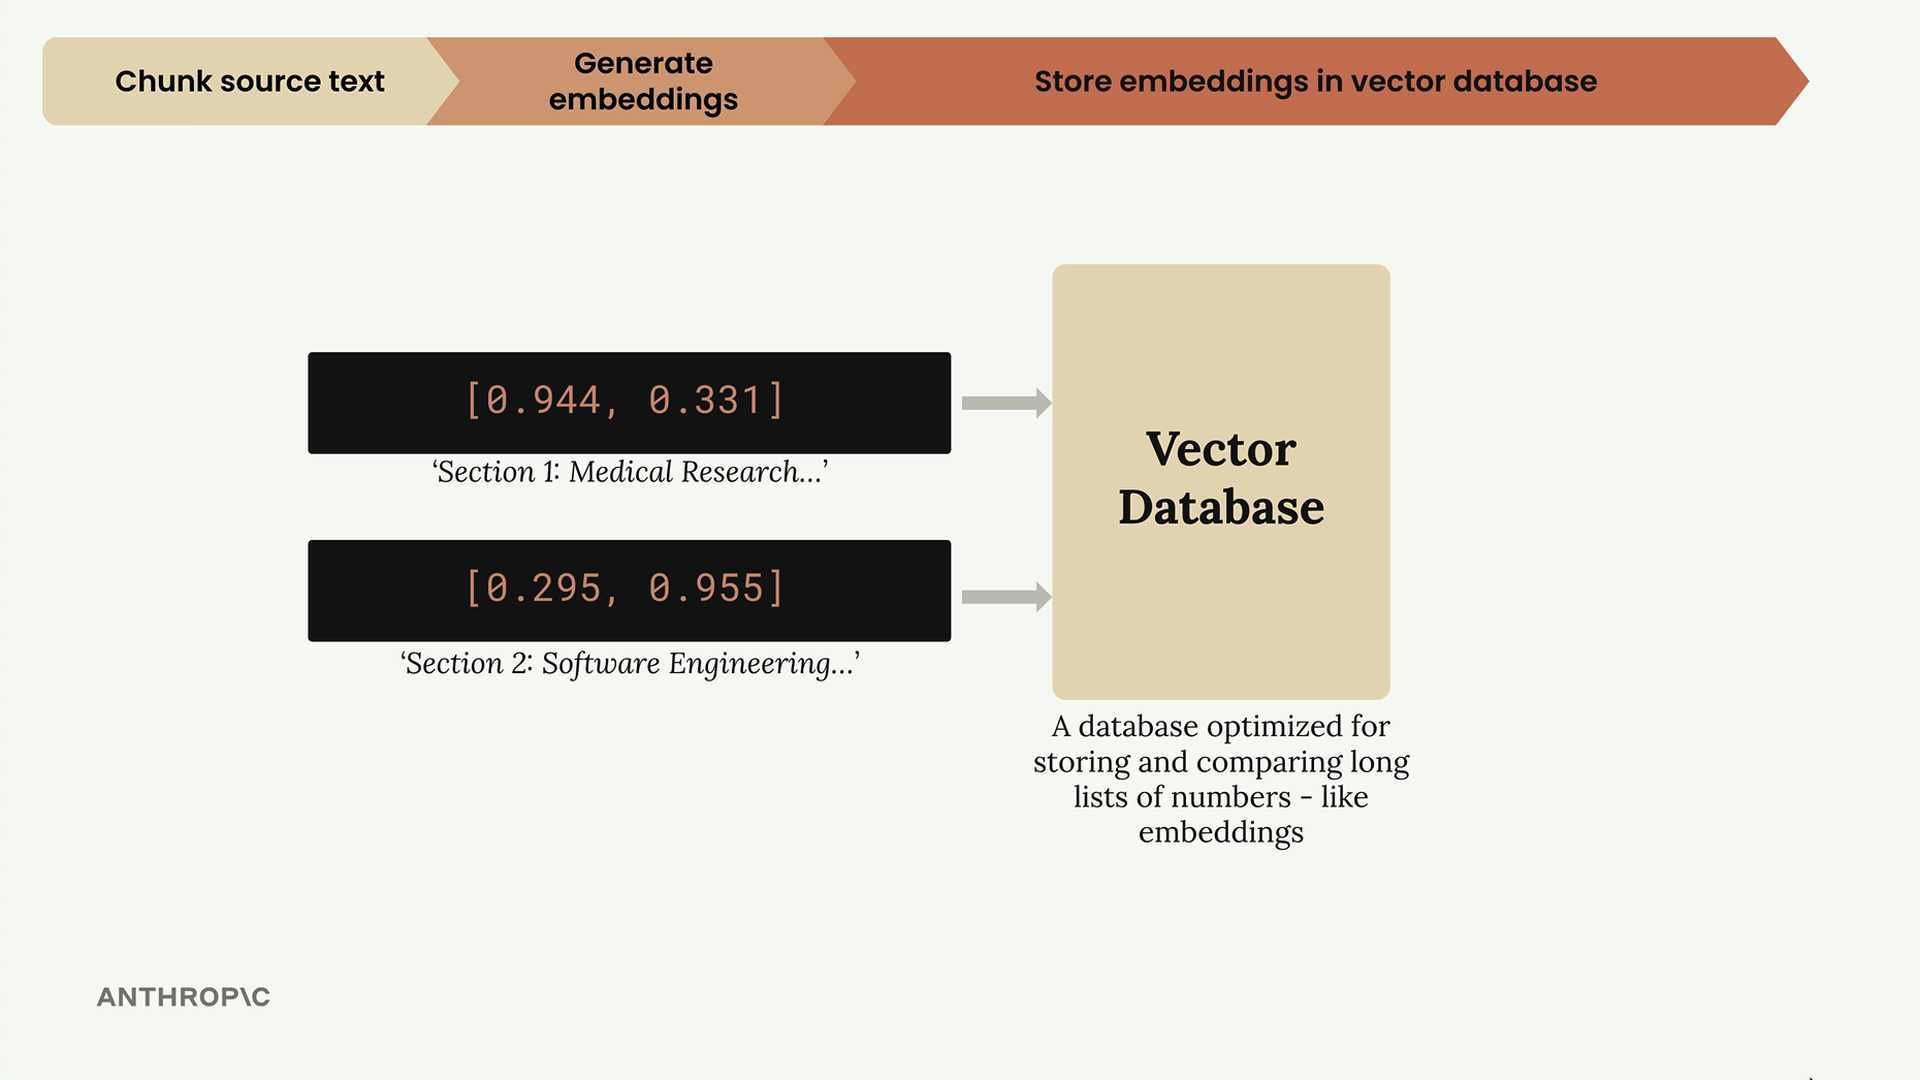
An diesem Punkt halten wir inne. Alle bisherigen Arbeiten waren Vorverarbeitung, die im Voraus stattfindet. Jetzt warten wir darauf, dass ein Nutzer eine Anfrage stellt.
Schritt 4: Verarbeite die Nutzeranfrage
Wenn ein Nutzer eine Frage stellt wie „Ich interessiere mich für das Unternehmen. Was genau hat die Software-Engineering-Abteilung dieses Jahr gemacht?", führen wir seine Anfrage durch dasselbe Embedding-Modell.
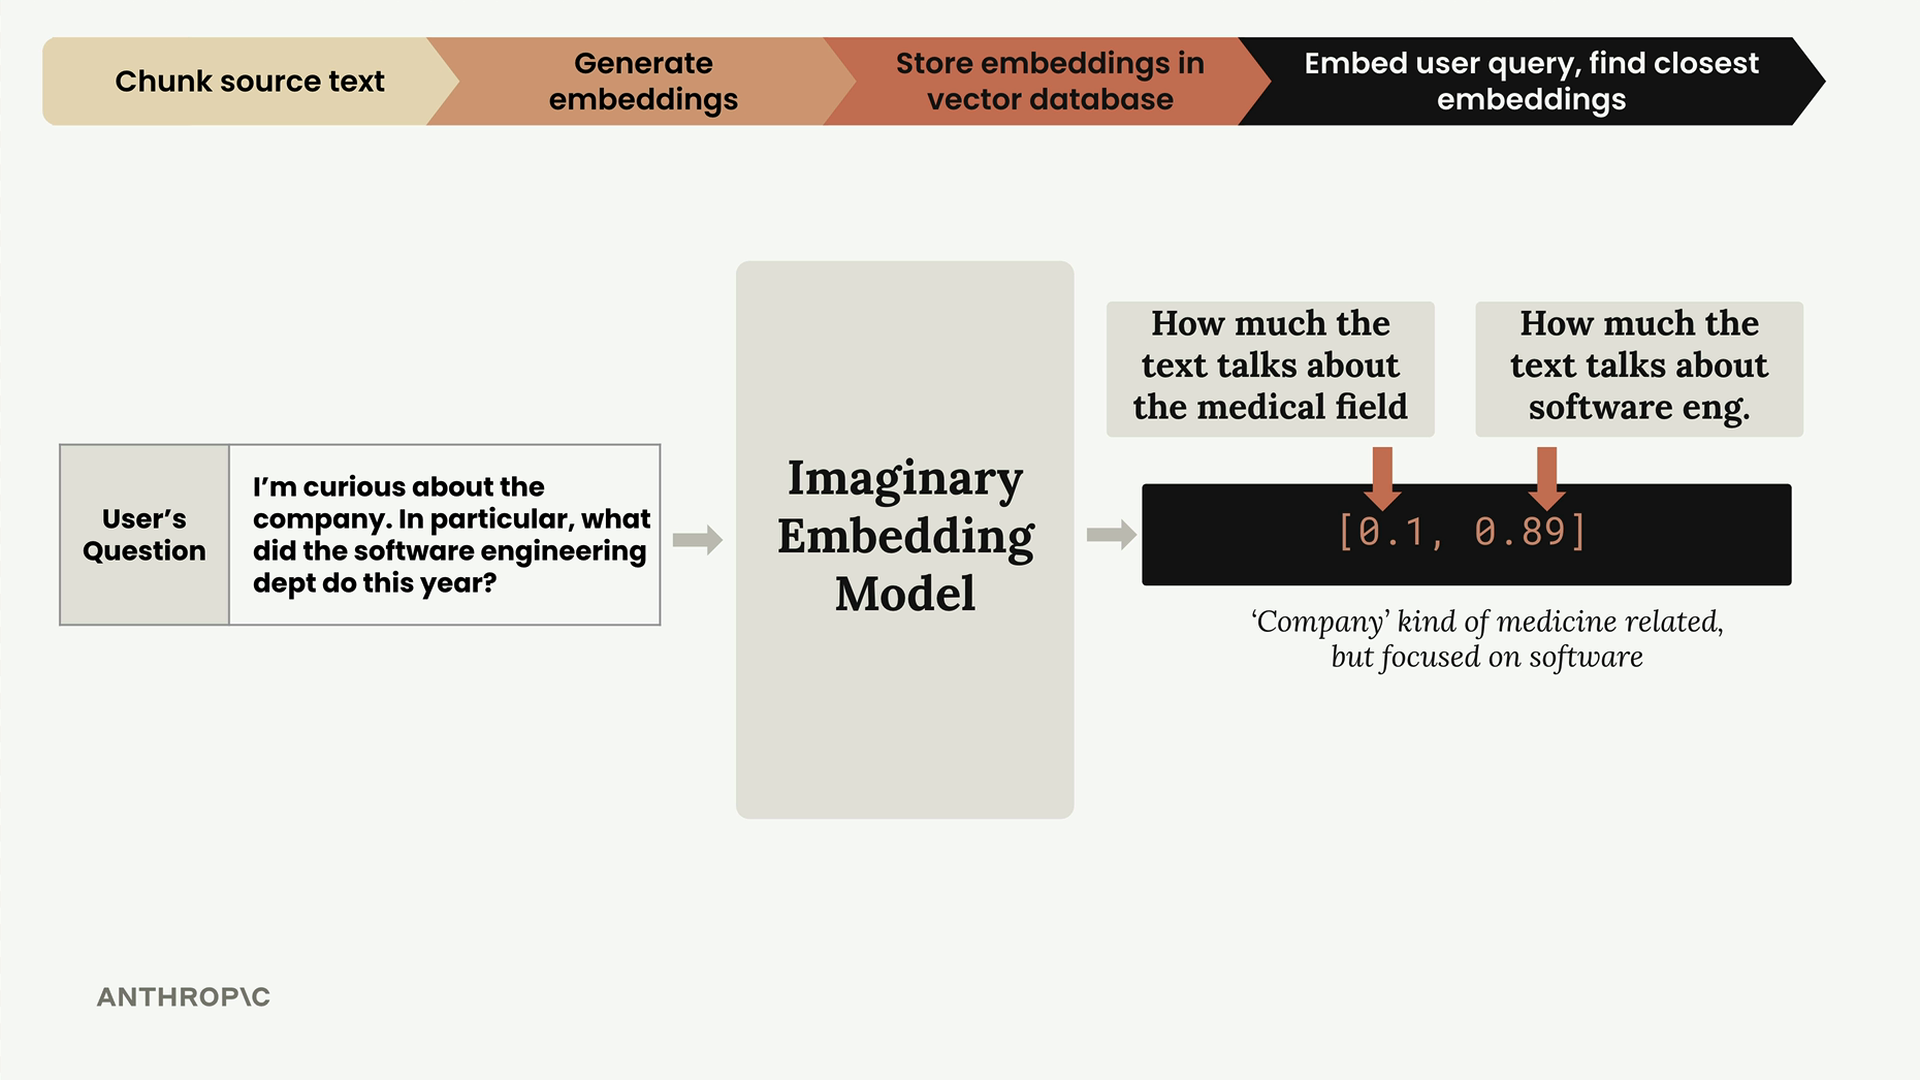
Diese Anfrage wird als [0.1, 0.89] eingebettet – niedriger Medizin-Score, hoher Software-Engineering-Score. Nach der Normalisierung wird sie zu [0.112, 0.993].
Schritt 5: Finde ähnliche Embeddings
Jetzt fragen wir die Vektordatenbank: „Finde das gespeicherte Embedding, das diesem Embedding der Nutzeranfrage am nächsten ist." Die Datenbank gibt den Software-Engineering-Abschnitt zurück, da er am ähnlichsten ist.
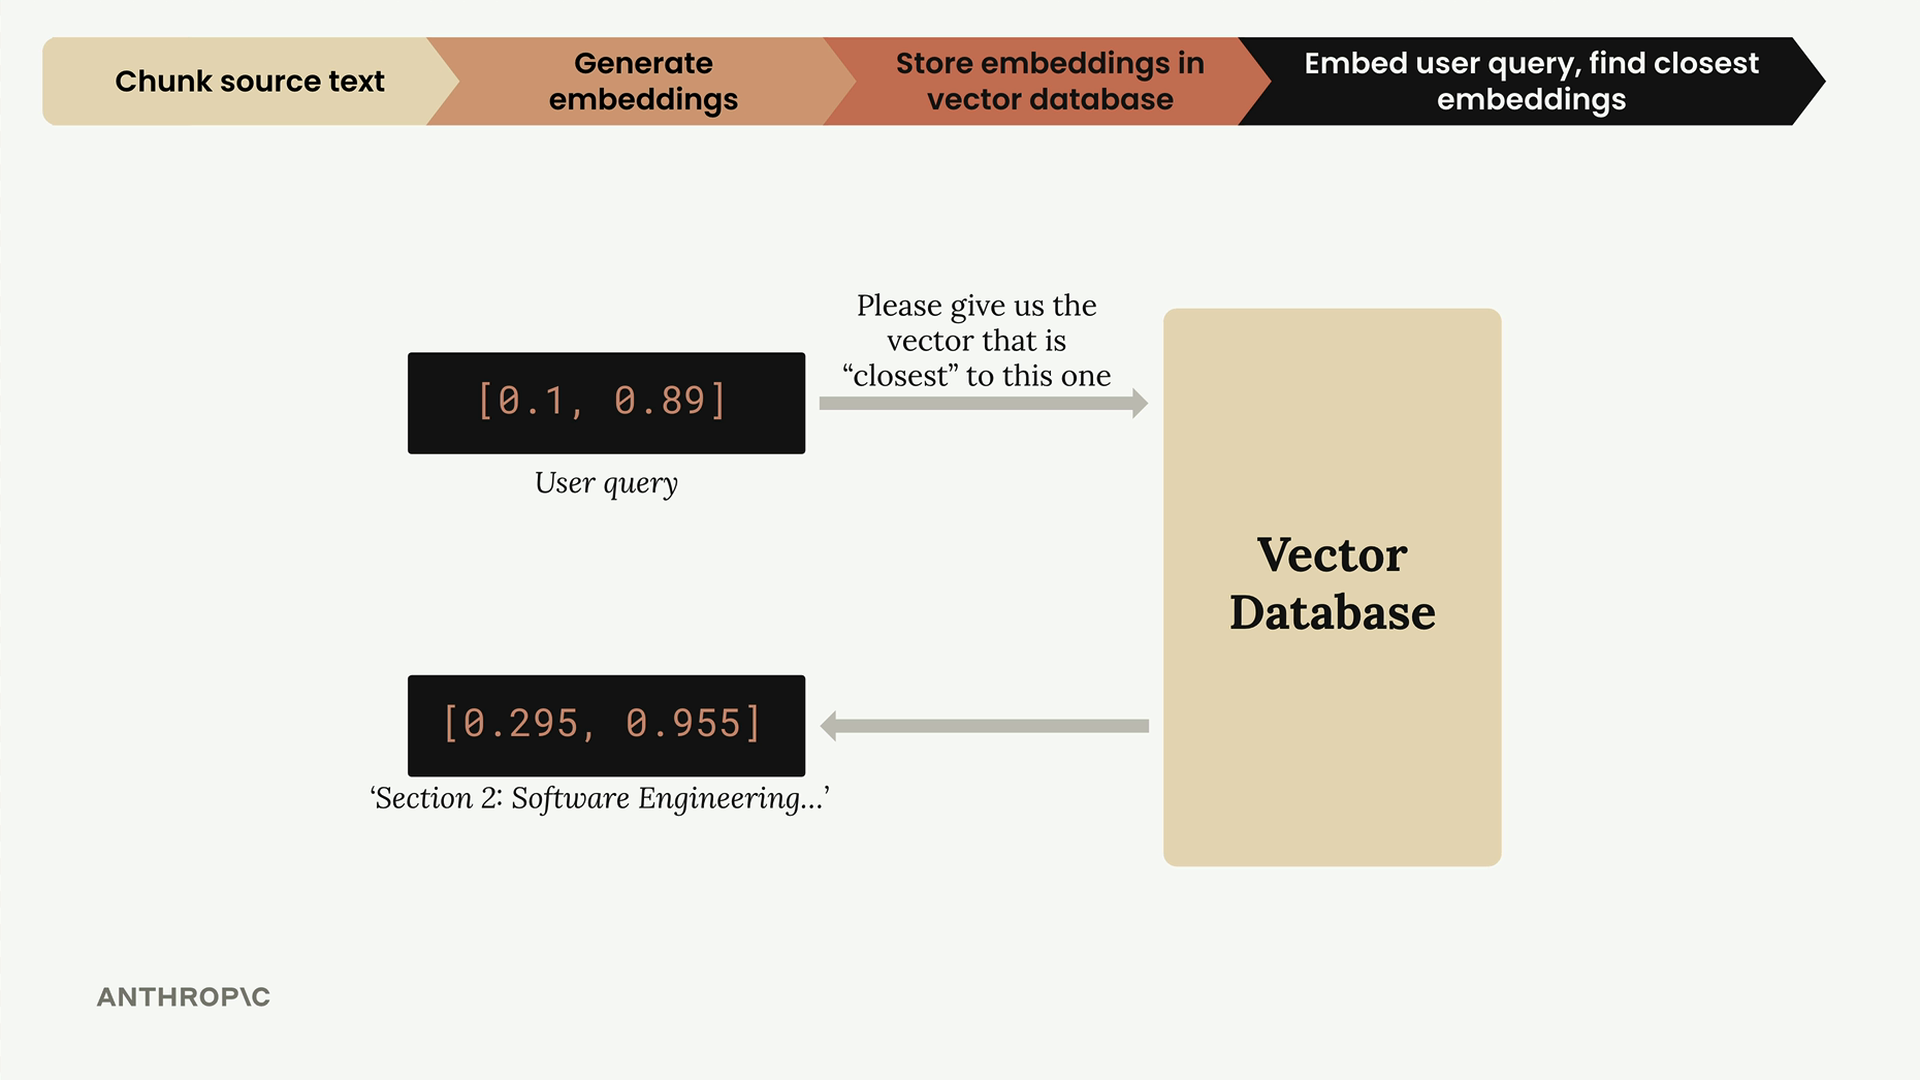
Wie Ähnlichkeit funktioniert: Kosinus-Ähnlichkeit
Die Vektordatenbank verwendet die Kosinus-Ähnlichkeit, um zu bestimmen, welche Embeddings am ähnlichsten sind. Diese misst den Kosinus des Winkels zwischen zwei Vektoren.
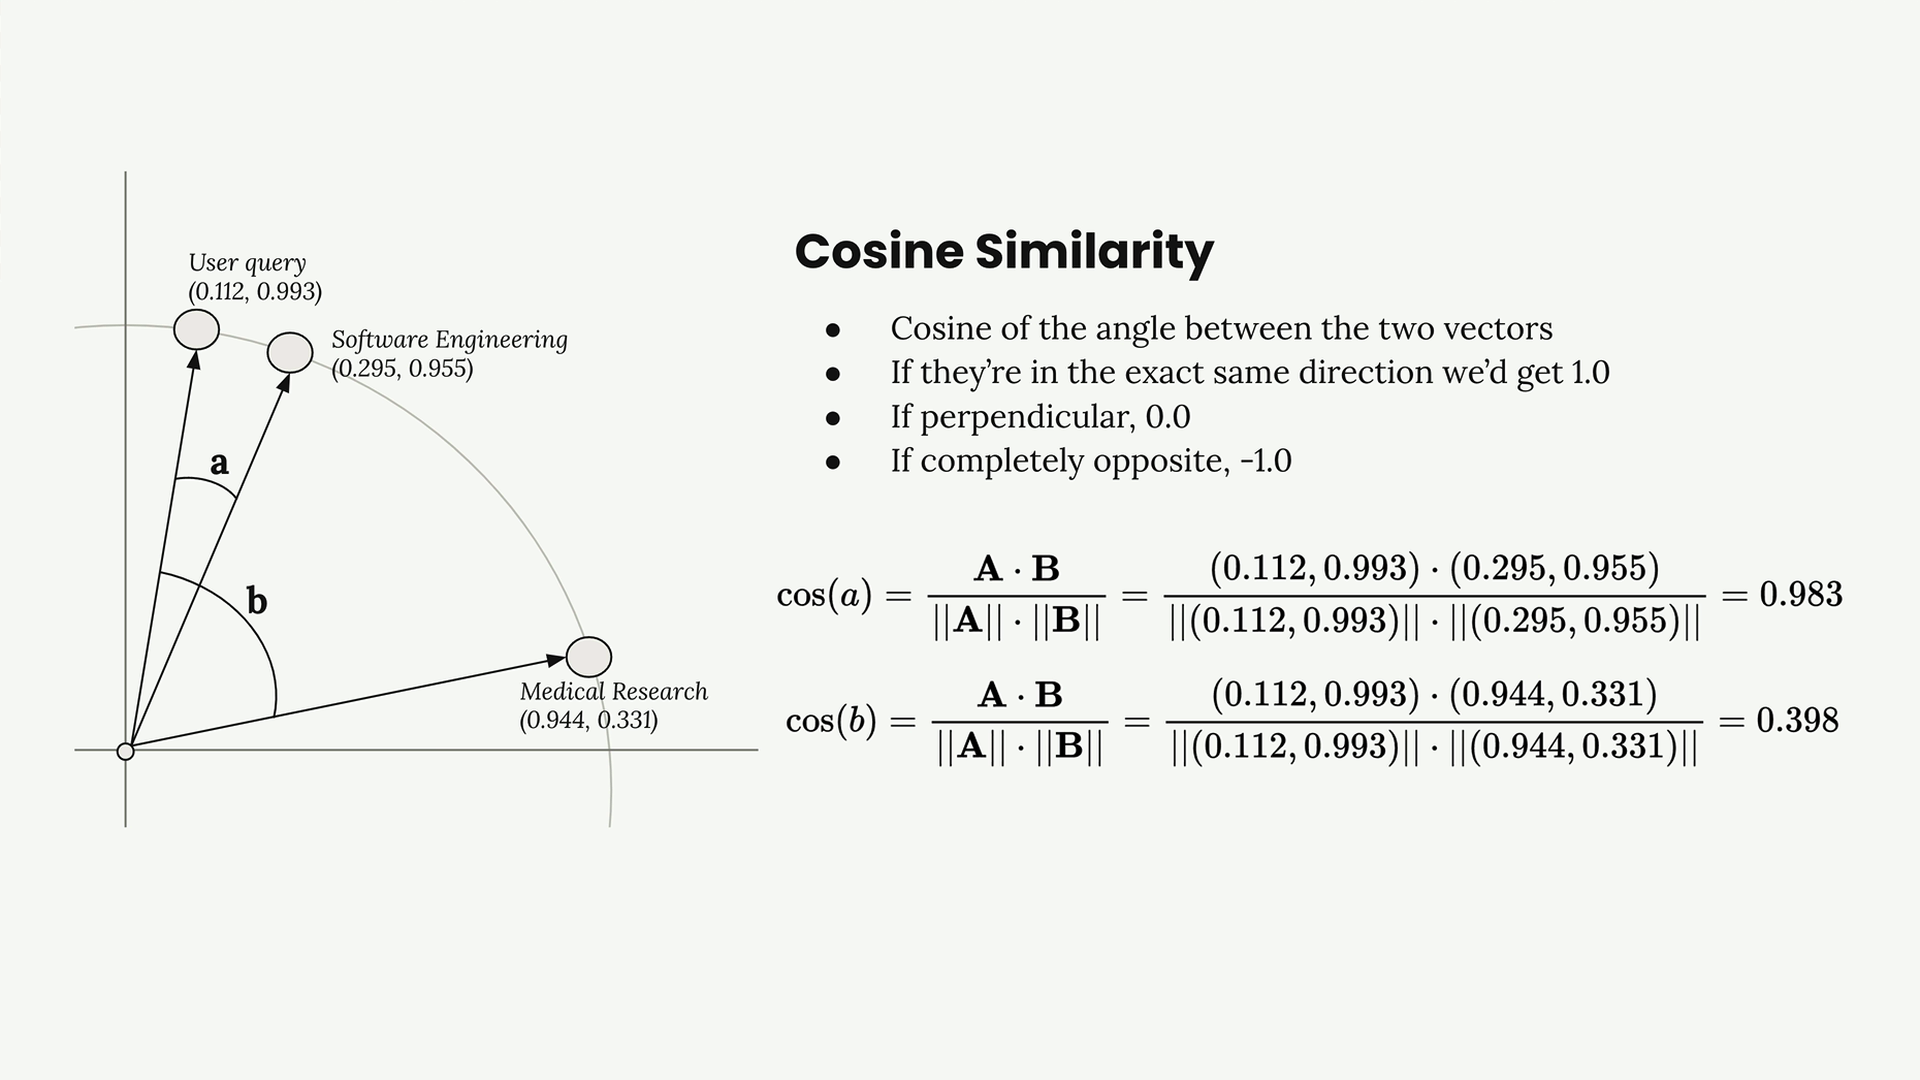
Wichtige Punkte zur Kosinus-Ähnlichkeit:
- Die Ergebnisse reichen von -1 bis 1
- Werte nahe 1 bedeuten sehr ähnlich
- Werte nahe 0 bedeuten senkrecht (nicht verwandt)
- Werte nahe -1 bedeuten völlig entgegengesetzt
Die Berechnung verwendet die Skalarprodukt-Formel: cos(a) = (A · B) / (||A|| · ||B||)
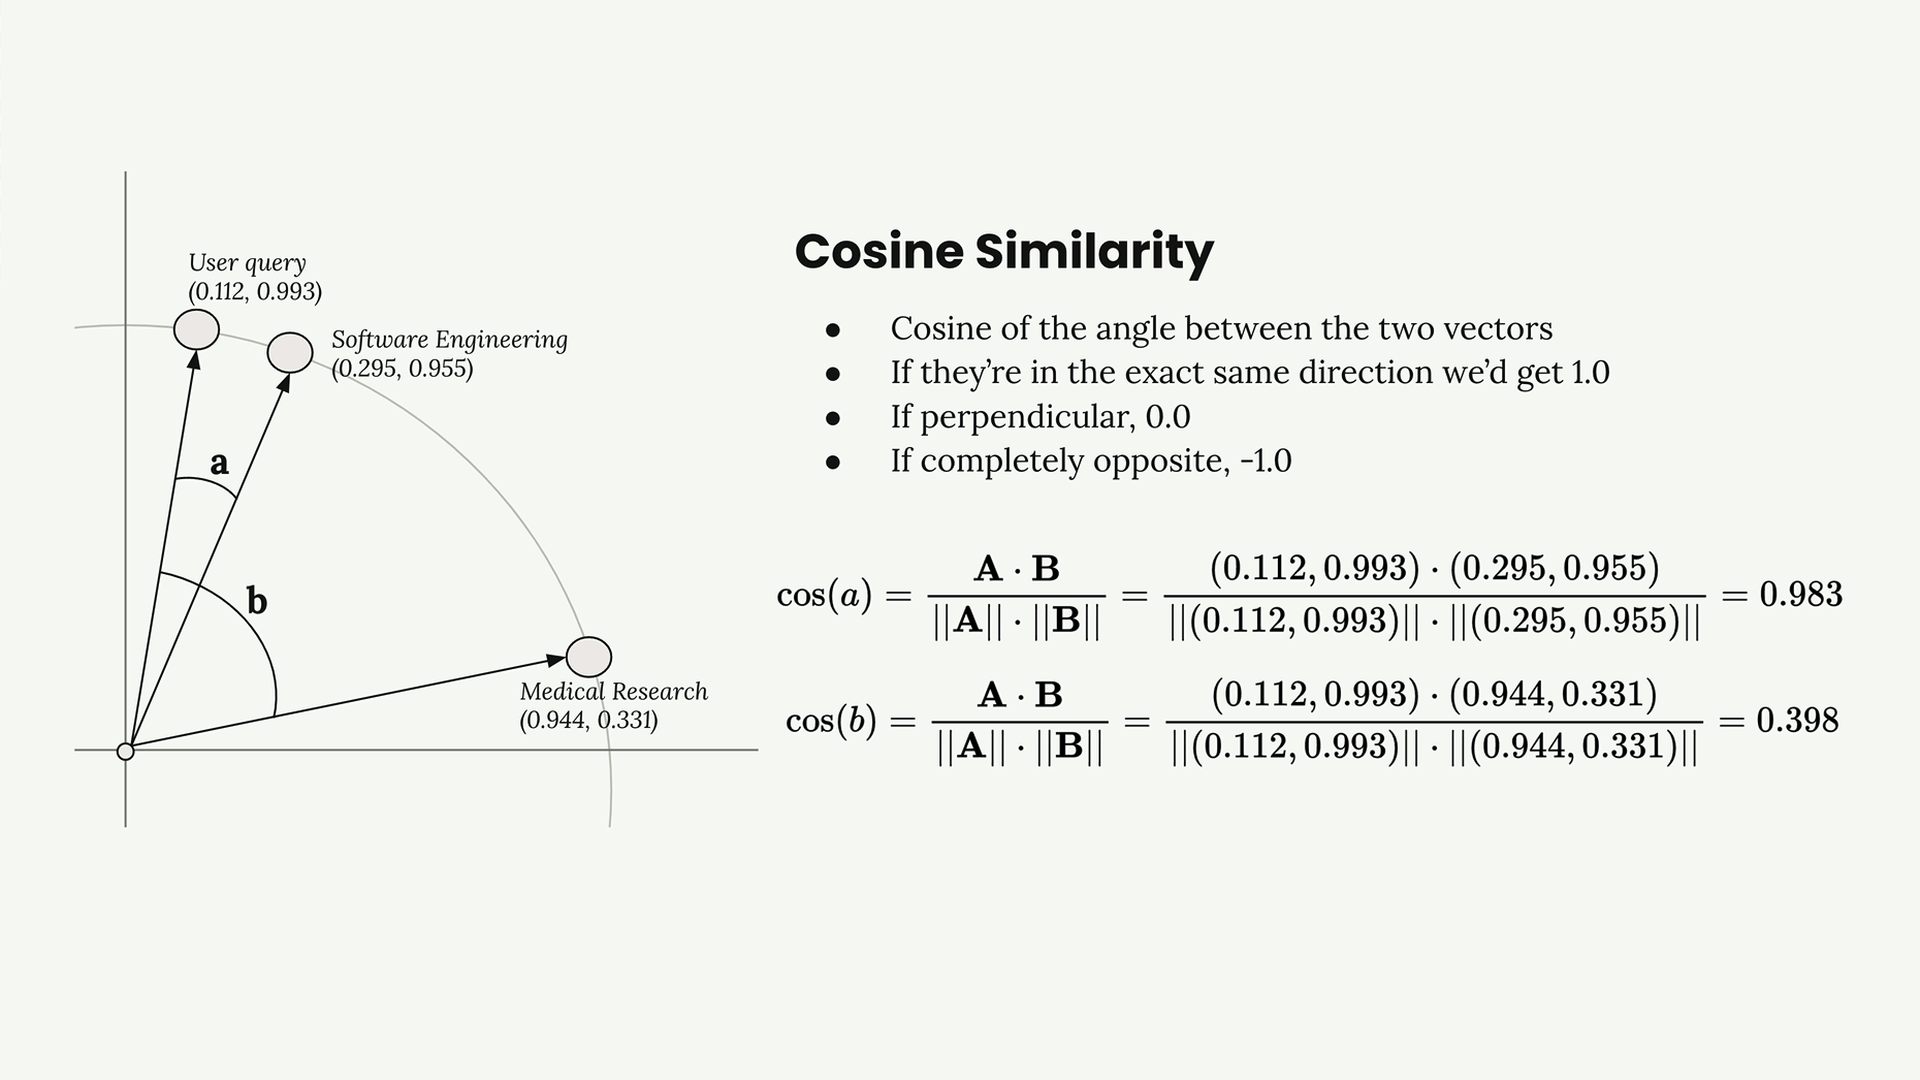
In unserem Beispiel hat die Nutzeranfrage eine Kosinus-Ähnlichkeit von 0,983 mit dem Software-Engineering-Chunk und nur 0,398 mit dem medizinischen Forschungs-Chunk. Der Software-Engineering-Chunk ist eindeutig die bessere Übereinstimmung.
Kosinus-Distanz
Du wirst in der Dokumentation von Vektordatenbanken oft auf „Kosinus-Distanz" stoßen. Das ist einfach 1 - Kosinus-Ähnlichkeit, was uns eine leichter interpretierbare Zahl liefert, bei der gilt:
- Werte nahe 0 bedeuten hohe Ähnlichkeit
- Größere Werte bedeuten geringere Ähnlichkeit
Schritt 6: Erstelle den finalen Prompt
Schließlich nehmen wir die Frage des Nutzers und den relevantesten Text-Chunk, den wir gefunden haben, und kombinieren sie zu einem Prompt für Claude:
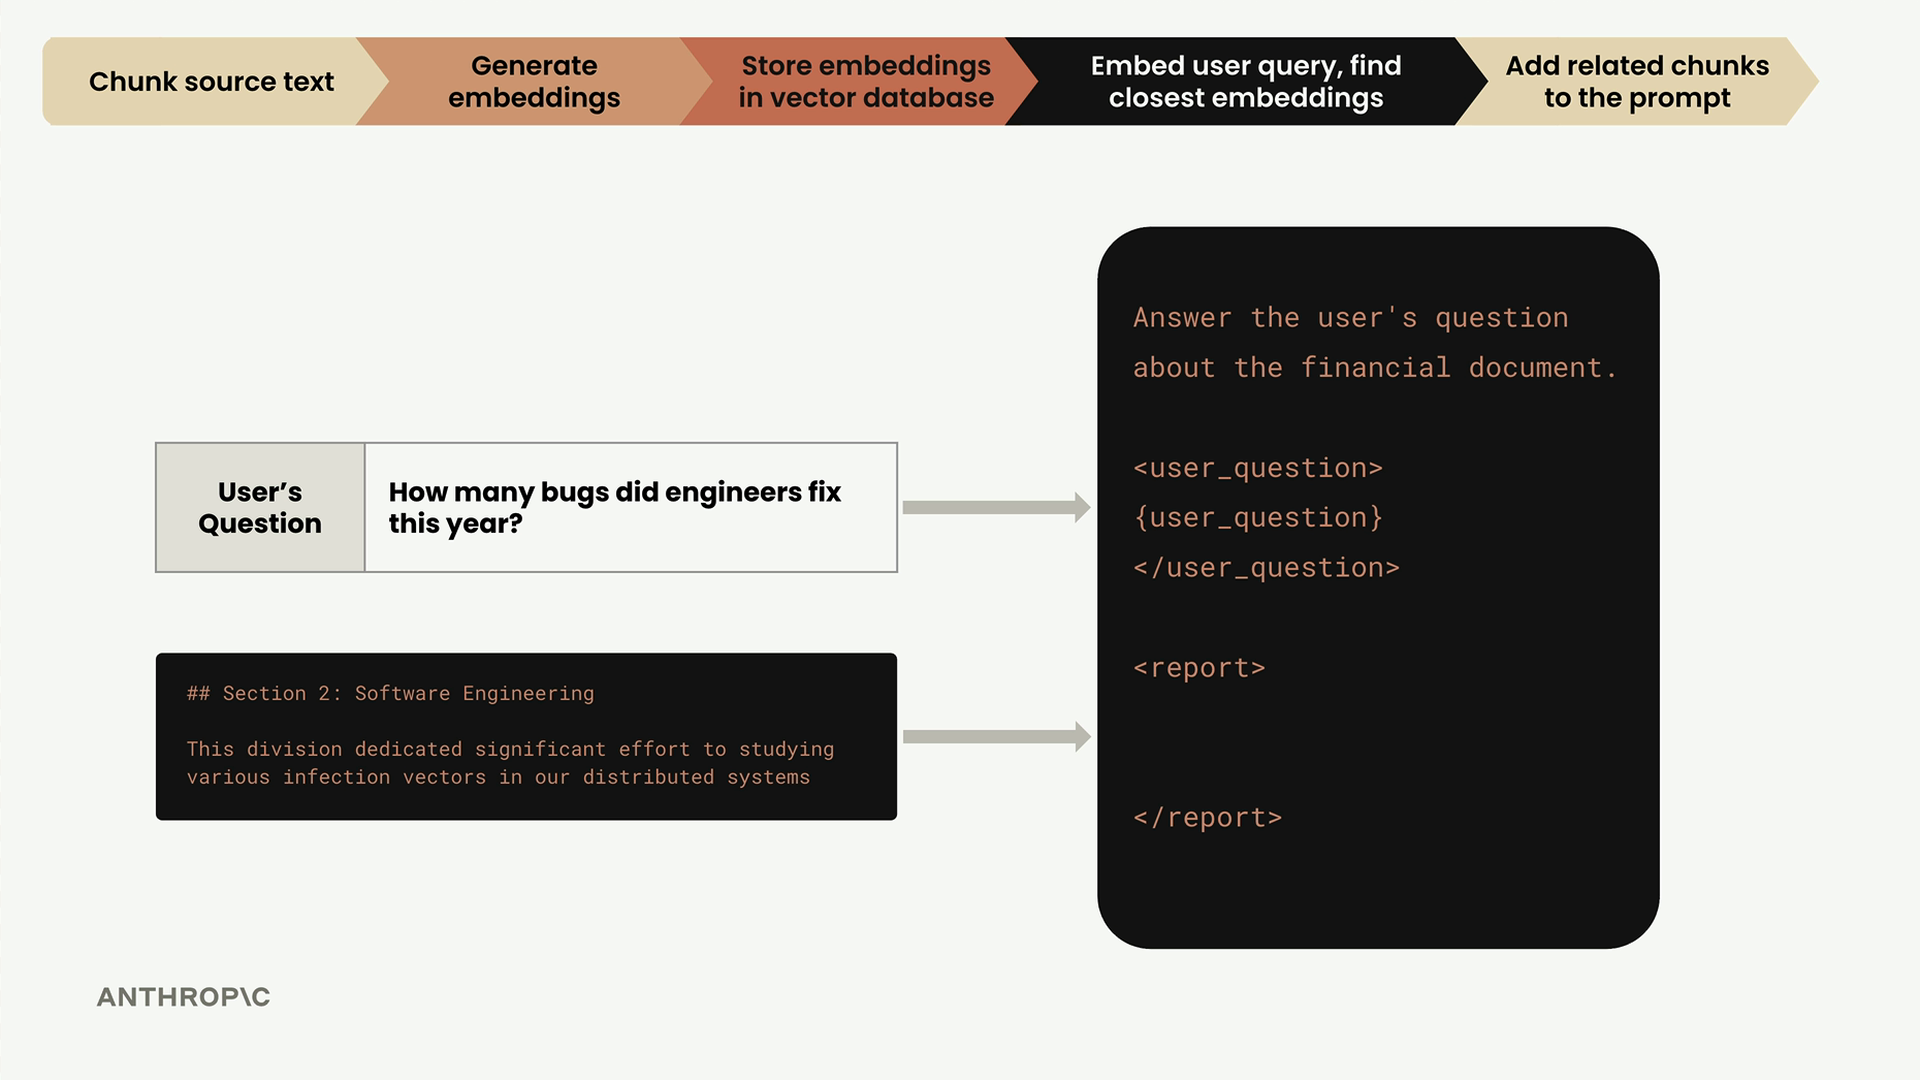
Der Prompt enthält sowohl die Frage des Nutzers als auch den relevanten Kontext aus unserem Dokument, sodass Claude eine fundierte Antwort basierend auf den spezifischen Informationen in unserer Wissensdatenbank geben kann.
Der vollständige Ablauf
Das ist die gesamte RAG-Pipeline von Anfang bis Ende:
- Zerlege Quelldokumente in Chunks
- Erzeuge Embeddings für jeden Chunk
- Speichere die Embeddings in einer Vektordatenbank
- Wenn ein Nutzer eine Frage stellt, bette seine Anfrage ein
- Finde die ähnlichsten gespeicherten Embeddings mithilfe der Kosinus-Ähnlichkeit
- Füge die relevanten Chunks zusammen mit der Nutzerfrage zu einem Prompt hinzu
- Sende den erweiterten Prompt an Claude für eine Antwort
Wenn du diesen Prozess und die zugrunde liegende Mathematik verstehst, kannst du effektiv mit Vektordatenbanken arbeiten und Probleme beheben, wenn dein RAG-System nicht die erwarteten Ergebnisse liefert.