Claude ist nicht nur zum Schreiben von Code in deinem Editor da. Es kann auch deine Produktionsanwendungen überwachen und Fehler automatisch beheben, sobald sie auftreten. Das schafft einen leistungsstarken automatisierten Debugging-Workflow, der Probleme erkennen und beheben kann, bevor sie sich auf deine Nutzer auswirken.
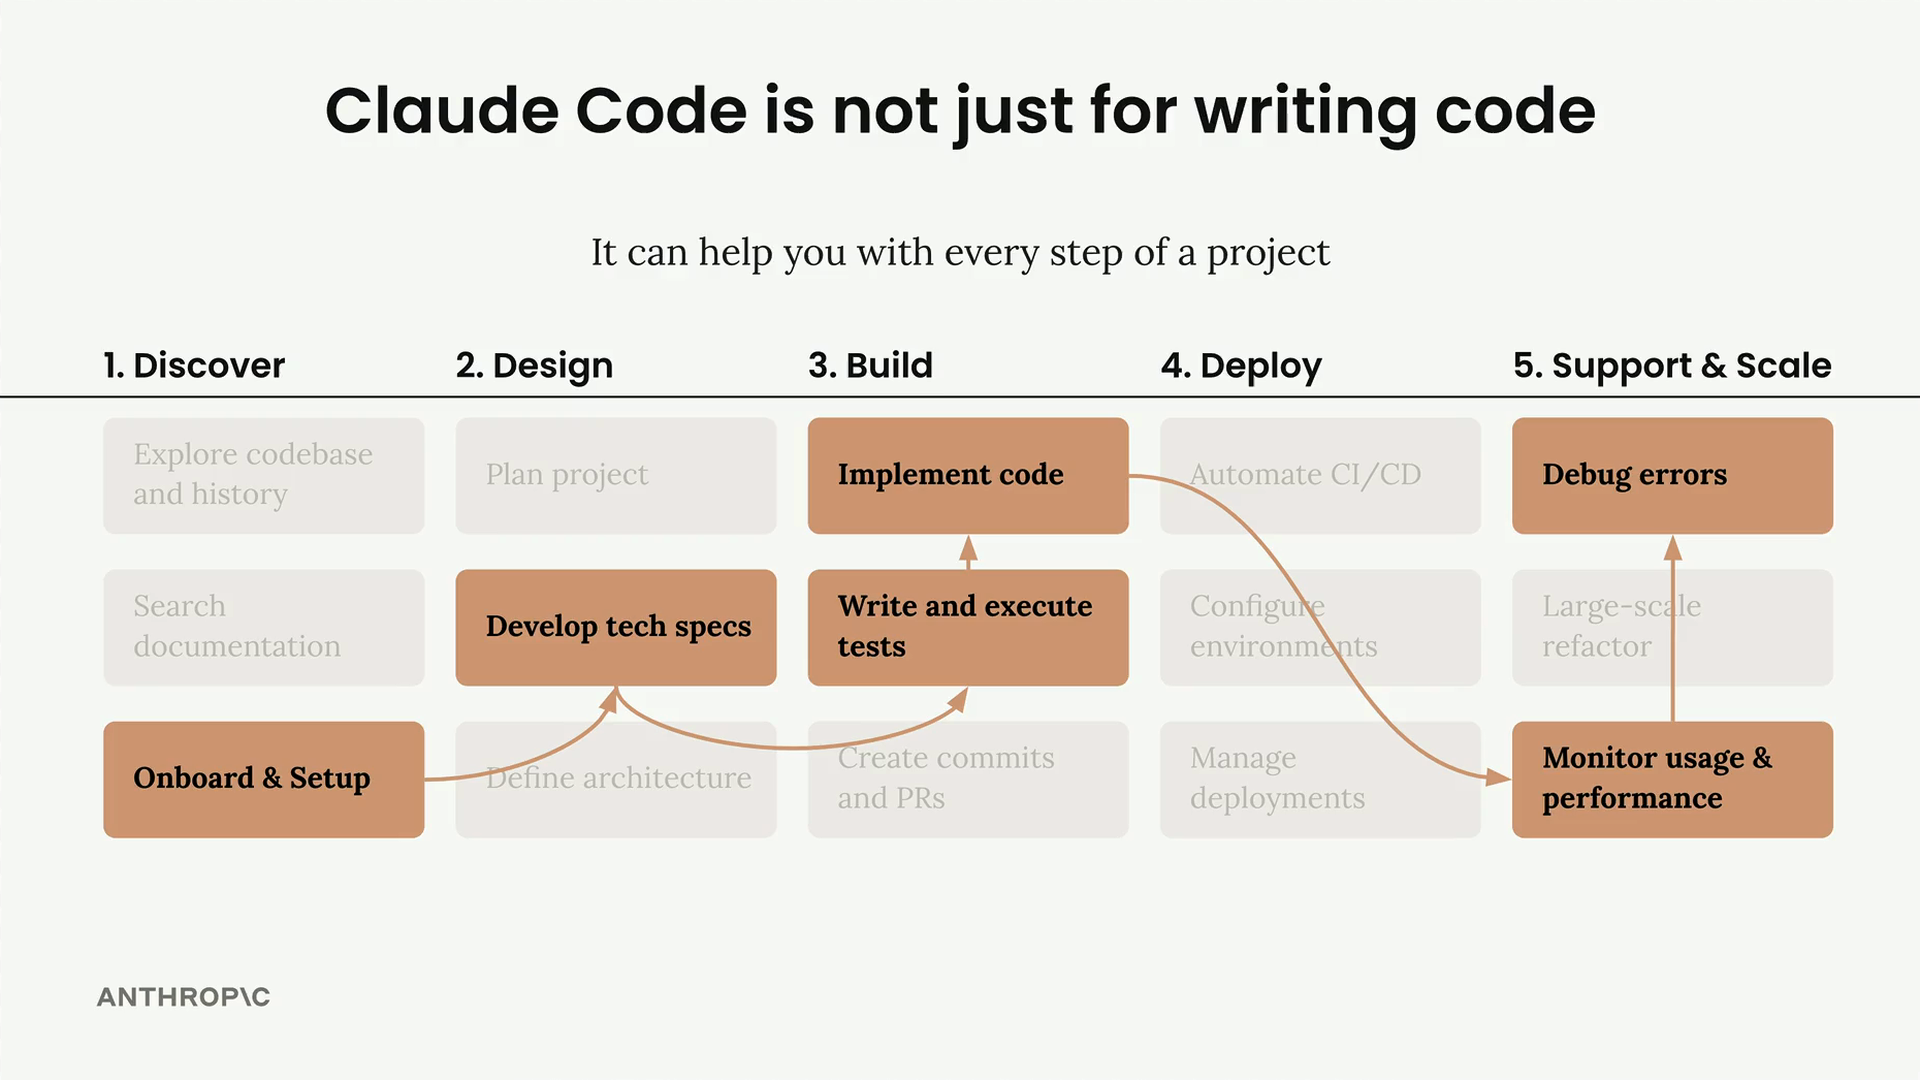
Das Problem: Fehler, die nur in der Produktion auftreten
Eines der frustrierendsten Debugging-Szenarien ist, wenn deine Anwendung in der Entwicklung einwandfrei funktioniert, in der Produktion aber fehlschlägt. Du testest vielleicht alles lokal, deployst voller Zuversicht, nur um dann festzustellen, dass bestimmte Funktionen in der Live-Umgebung nicht funktionieren.
Stell dir eine einfache Chatbot-Anwendung vor, die bei lokalen Tests tadellos funktioniert. Du kannst Fragen stellen, Tabellen mit Fake-Daten generieren, und alles reagiert wie erwartet. Aber wenn du denselben Code auf AWS Amplify deployst und identische Tests durchführst, schlägt die Tabellenerstellung stillschweigend fehl – die Anfrage geht durch, aber es erscheinen keine Daten.
Der traditionelle Debugging-Ansatz
Normalerweise müsstest du:
- Die CloudWatch-Logs durchsuchen, um Fehlermeldungen zu finden
- Komplexe Fehlerdetails und Stack-Traces analysieren
- Manuell herausfinden, warum sich der Code in der Produktion anders verhält
- Das Problem beheben und erneut deployen
Dieser Prozess kann zeitaufwändig sein, besonders wenn man mit kryptischen Fehlermeldungen wie „The provided model identifier is invalid“ zu tun hat, die in umfangreichen Log-Ausgaben vergraben sind.
Automatisierte Fehlererkennung und -behebung
Statt manuellem Debugging kannst du eine GitHub Action erstellen, die jeden Tag automatisch läuft, um deine Produktionsumgebung zu überwachen. Dieser Workflow übergibt den gesamten Debugging-Prozess an Claude.
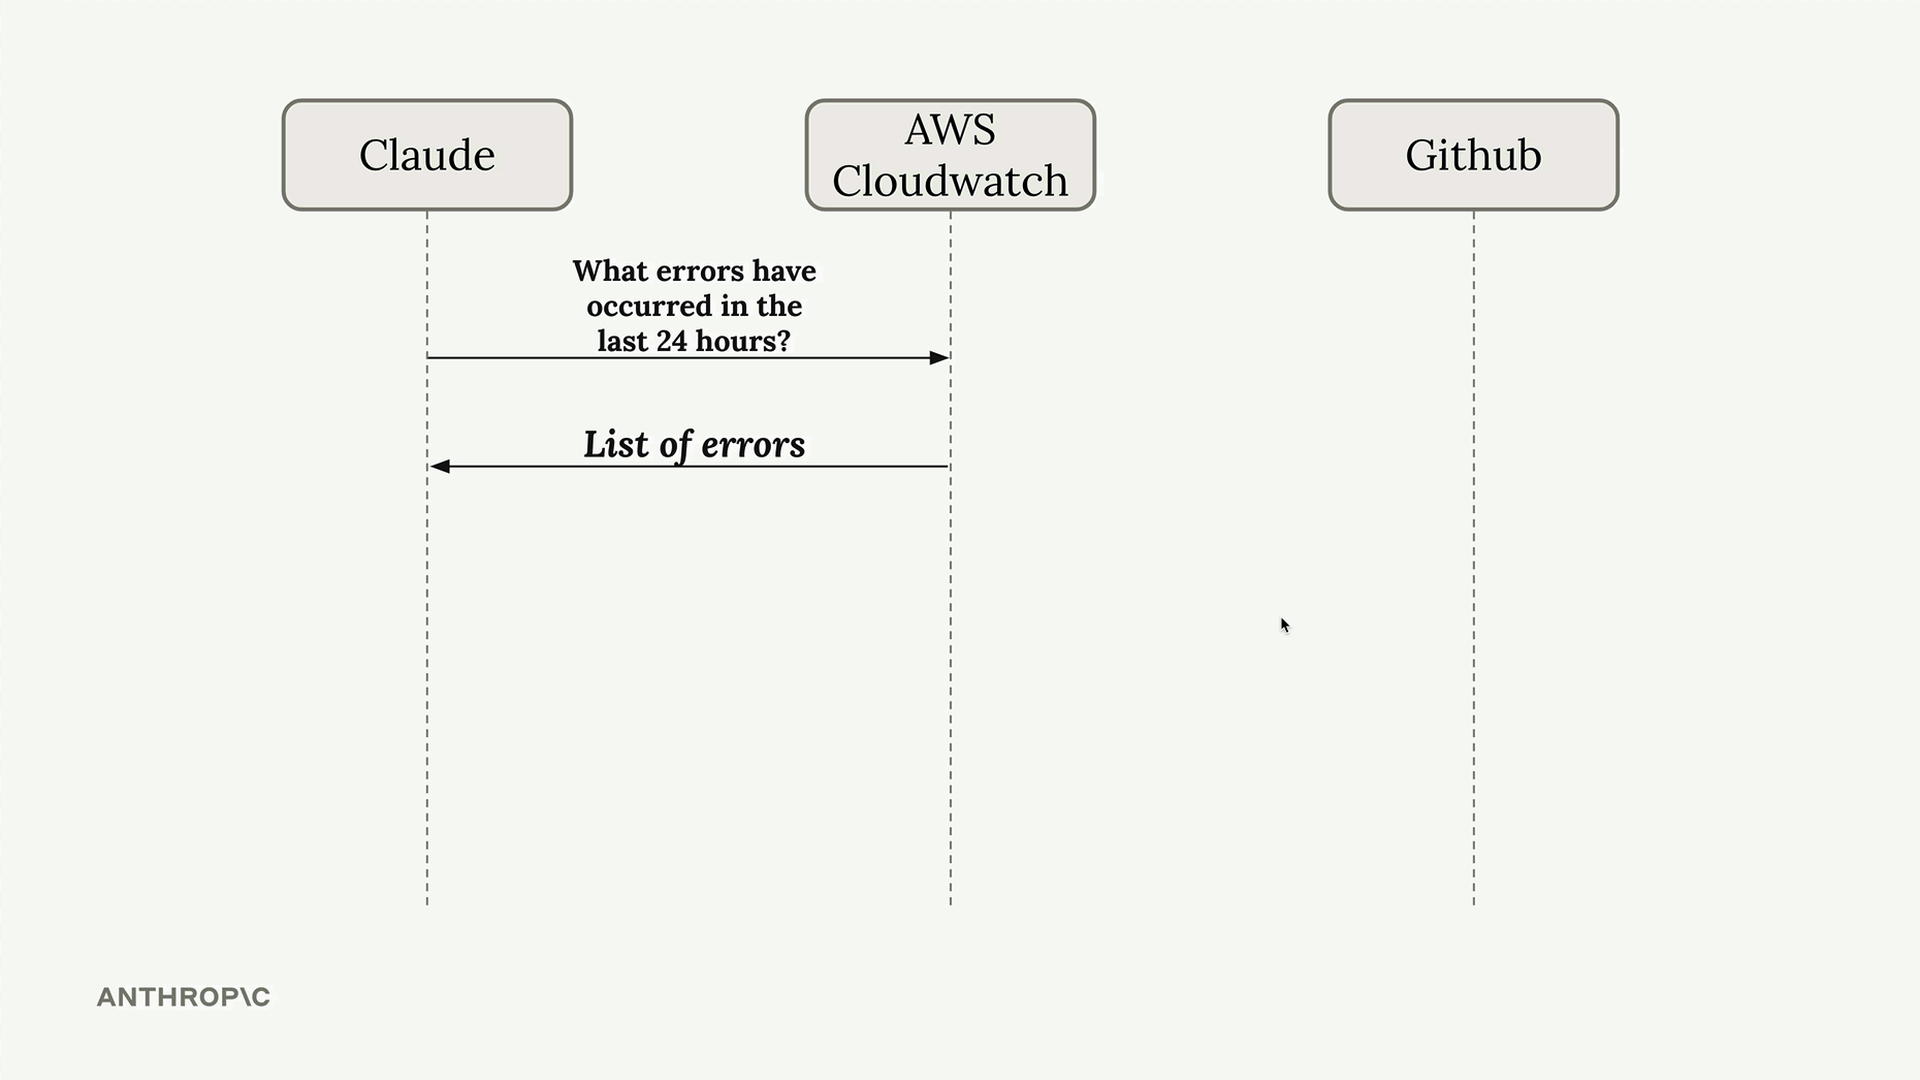
So funktioniert der automatisierte Workflow:
- Einrichtung: Die GitHub Action checkt dein Repository aus, installiert Abhängigkeiten und richtet Claude ein
- Log-Analyse: Nutzt die AWS CLI, um CloudWatch-Logs der letzten 24 Stunden abzurufen
- Fehlerverarbeitung: Claude analysiert die Logs, entfernt Duplikate und identifiziert eindeutige Fehler
- Umsetzung der Fixes: Claude versucht, jeden Fehler durch Anpassung des entsprechenden Codes zu beheben
- Erstellung des Pull Requests: Committet die Fixes und öffnet automatisch einen Pull Request zur Überprüfung
Praxisbeispiel
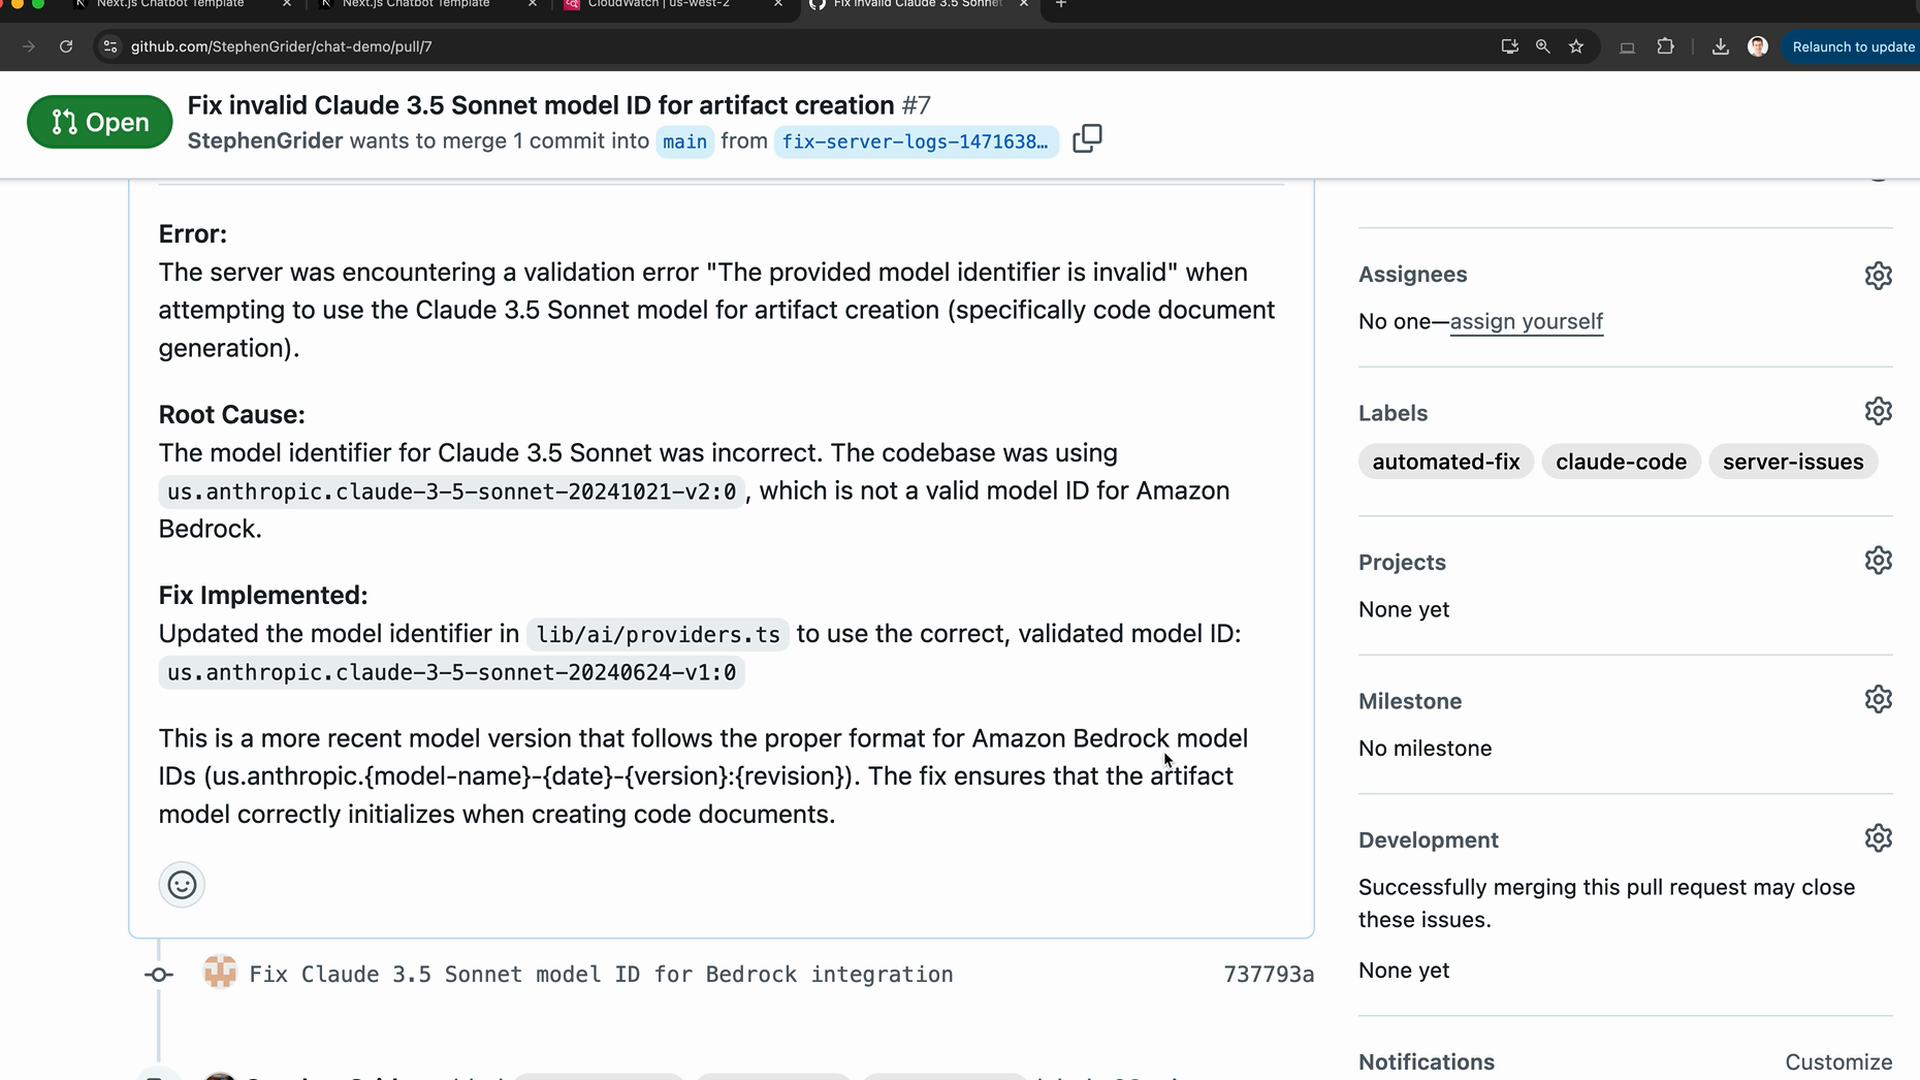
Im Chatbot-Beispiel stellte Claude fest, dass die Produktionsumgebung eine ungültige Modell-ID verwendete. Der Fehler trat aufgrund eines Tippfehlers in der Modell-ID auf, der nur in der Produktionskonfiguration referenziert wurde.
Claude identifizierte das Problem, fand das korrekte Format der Modell-ID und aktualisierte die Konfigurationsdatei. Der Fix wurde anschließend mit einer klaren Erklärung dessen, was schiefgelaufen war und wie es behoben wurde, committet.
Vorteile des automatisierten Debuggings
- Proaktive Überwachung: Erfasst Fehler, bevor du überhaupt weißt, dass sie existieren
- Zeitersparnis: Erspart manuelle Log-Durchsuchung und Debugging-Sitzungen
- Klare Dokumentation: Jeder Fix kommt mit detaillierten Erklärungen
- Überprüfungsprozess: Pull Requests ermöglichen es dir, Fixes vor dem Mergen zu überprüfen
- Kontinuierliche Verbesserung: Läuft automatisch, um neue Probleme zu erkennen, sobald sie auftreten
Überlegungen zur Umsetzung
Beim Einrichten automatisierter Debugging-Workflows solltest du:
- Geeignete AWS-Berechtigungen für den CloudWatch-Zugriff konfigurieren
- Sinnvolle Grenzwerte für die Anzahl der verarbeiteten Fehler festlegen, um innerhalb der Kontextfenster zu bleiben
- Logik zur Deduplizierung ähnlicher Fehler einbauen
- Sicherstellen, dass der Workflow über die nötigen Schreibrechte im Repository verfügt, um Pull Requests zu erstellen
- In Erwägung ziehen, den Workflow während verkehrsarmer Zeiten laufen zu lassen
Dieser automatisierte Ansatz verwandelt Debugging von einem reaktiven, manuellen Prozess in ein proaktives, automatisiertes System, das deine Anwendungen mit minimalem Eingreifen reibungslos am Laufen hält.