Beim Aufbau von Prompt-Evaluierungs-Workflows liefern Grader objektive Signale zur Ausgabequalität. Ein Grader nimmt die Modellausgabe entgegen und gibt eine Art messbares Feedback zurück – typischerweise eine Zahl zwischen 1 und 10, wobei 10 hohe Qualität und 1 schlechte Qualität darstellt.
Arten von Gradern
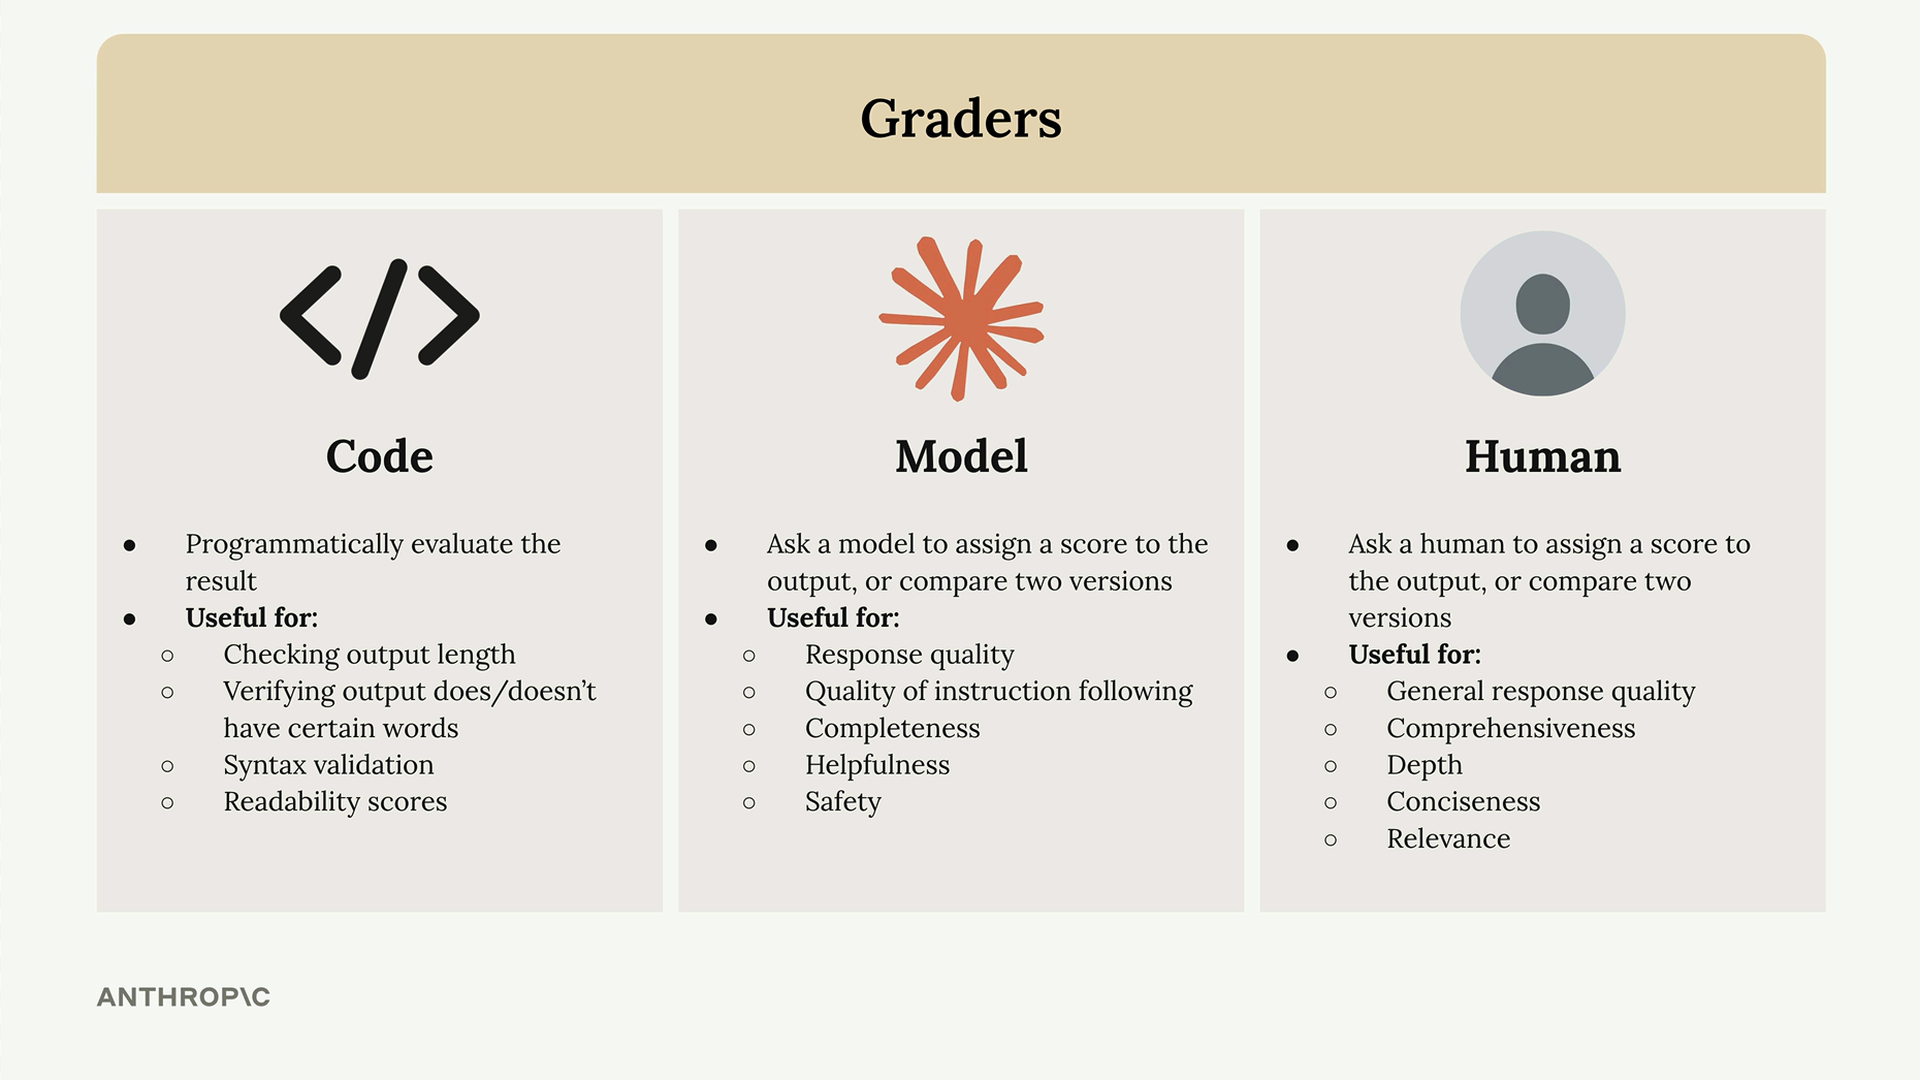
Es gibt drei Hauptansätze zur Bewertung von Modellausgaben:
- Code-Grader – Bewerten Ausgaben programmatisch mithilfe benutzerdefinierter Logik
- Modell-Grader – Verwenden ein anderes KI-Modell zur Qualitätsbeurteilung
- Menschliche Grader – Lassen Menschen Ausgaben manuell überprüfen und bewerten
Code-Grader
Mit Code-Gradern kannst du jede programmatische Prüfung implementieren, die du dir vorstellen kannst. Übliche Einsatzzwecke sind:
- Überprüfung der Ausgabelänge
- Überprüfung, ob die Ausgabe bestimmte Wörter enthält oder nicht
- Syntaxvalidierung für JSON, Python oder Regex
- Lesbarkeitswerte
Die einzige Anforderung ist, dass dein Code bei der Ausführung ein messbares Signal zurückgibt.
Modell-Grader
Modell-Grader stellen eine zusätzliche API-Anfrage, um die ursprüngliche Ausgabe zu bewerten. Dieser Ansatz bietet enorme Flexibilität zur Beurteilung von:
- Antwortqualität
- Qualität der Befolgung von Anweisungen
- Vollständigkeit
- Hilfsbereitschaft
- Sicherheit
Menschliche Grader
Menschliche Grader bieten die größte Flexibilität, sind jedoch zeitaufwendig und mühsam. Sie eignen sich zur Bewertung von:
- Allgemeiner Antwortqualität
- Umfassendheit
- Tiefe
- Prägnanz
- Relevanz
Definieren von Bewertungskriterien
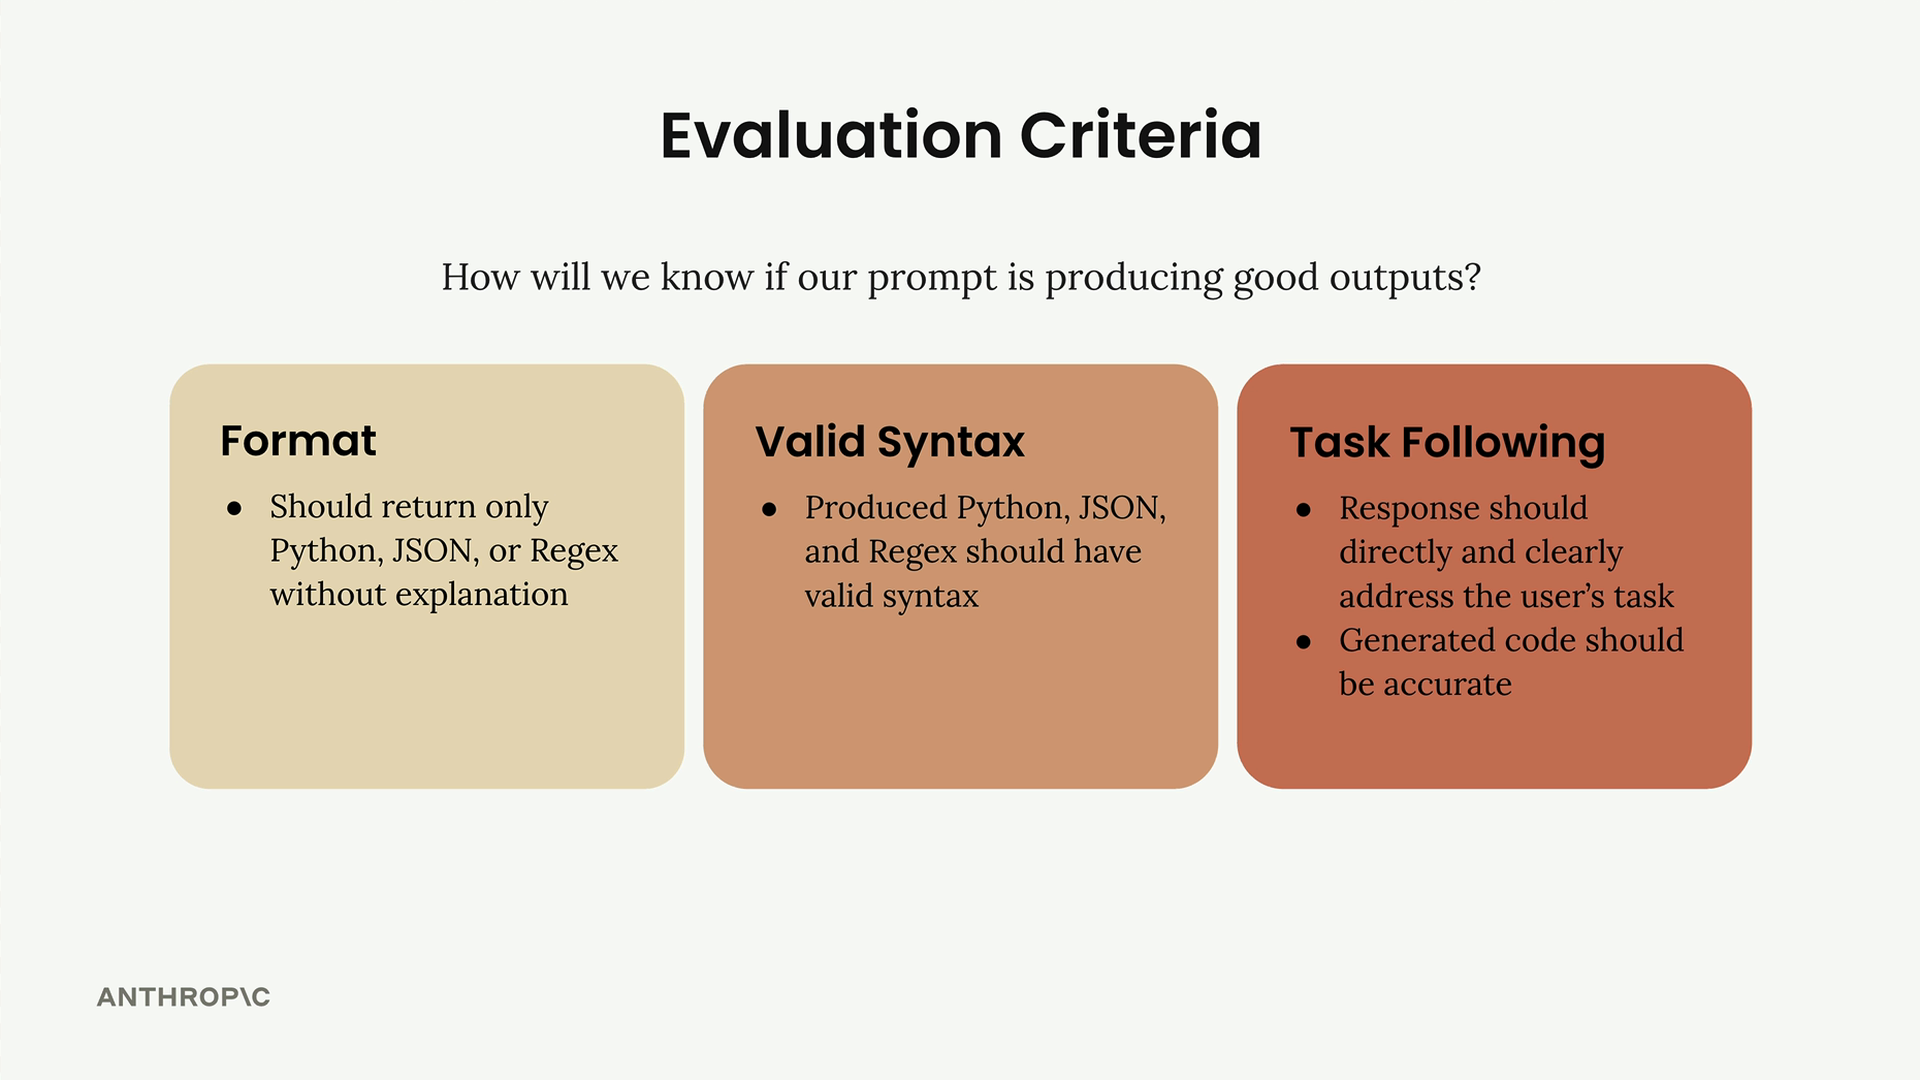
Bevor du einen Grader implementierst, benötigst du klare Bewertungskriterien. Bei einem Code-Generierungs-Prompt könntest du dich auf Folgendes konzentrieren:
- Format – Sollte nur Python, JSON oder Regex ohne Erklärung zurückgeben
- Gültige Syntax – Der erzeugte Code sollte gültige Syntax haben
- Aufgabenbefolgung – Die Antwort sollte die Aufgabe des Nutzers direkt mit korrektem Code adressieren
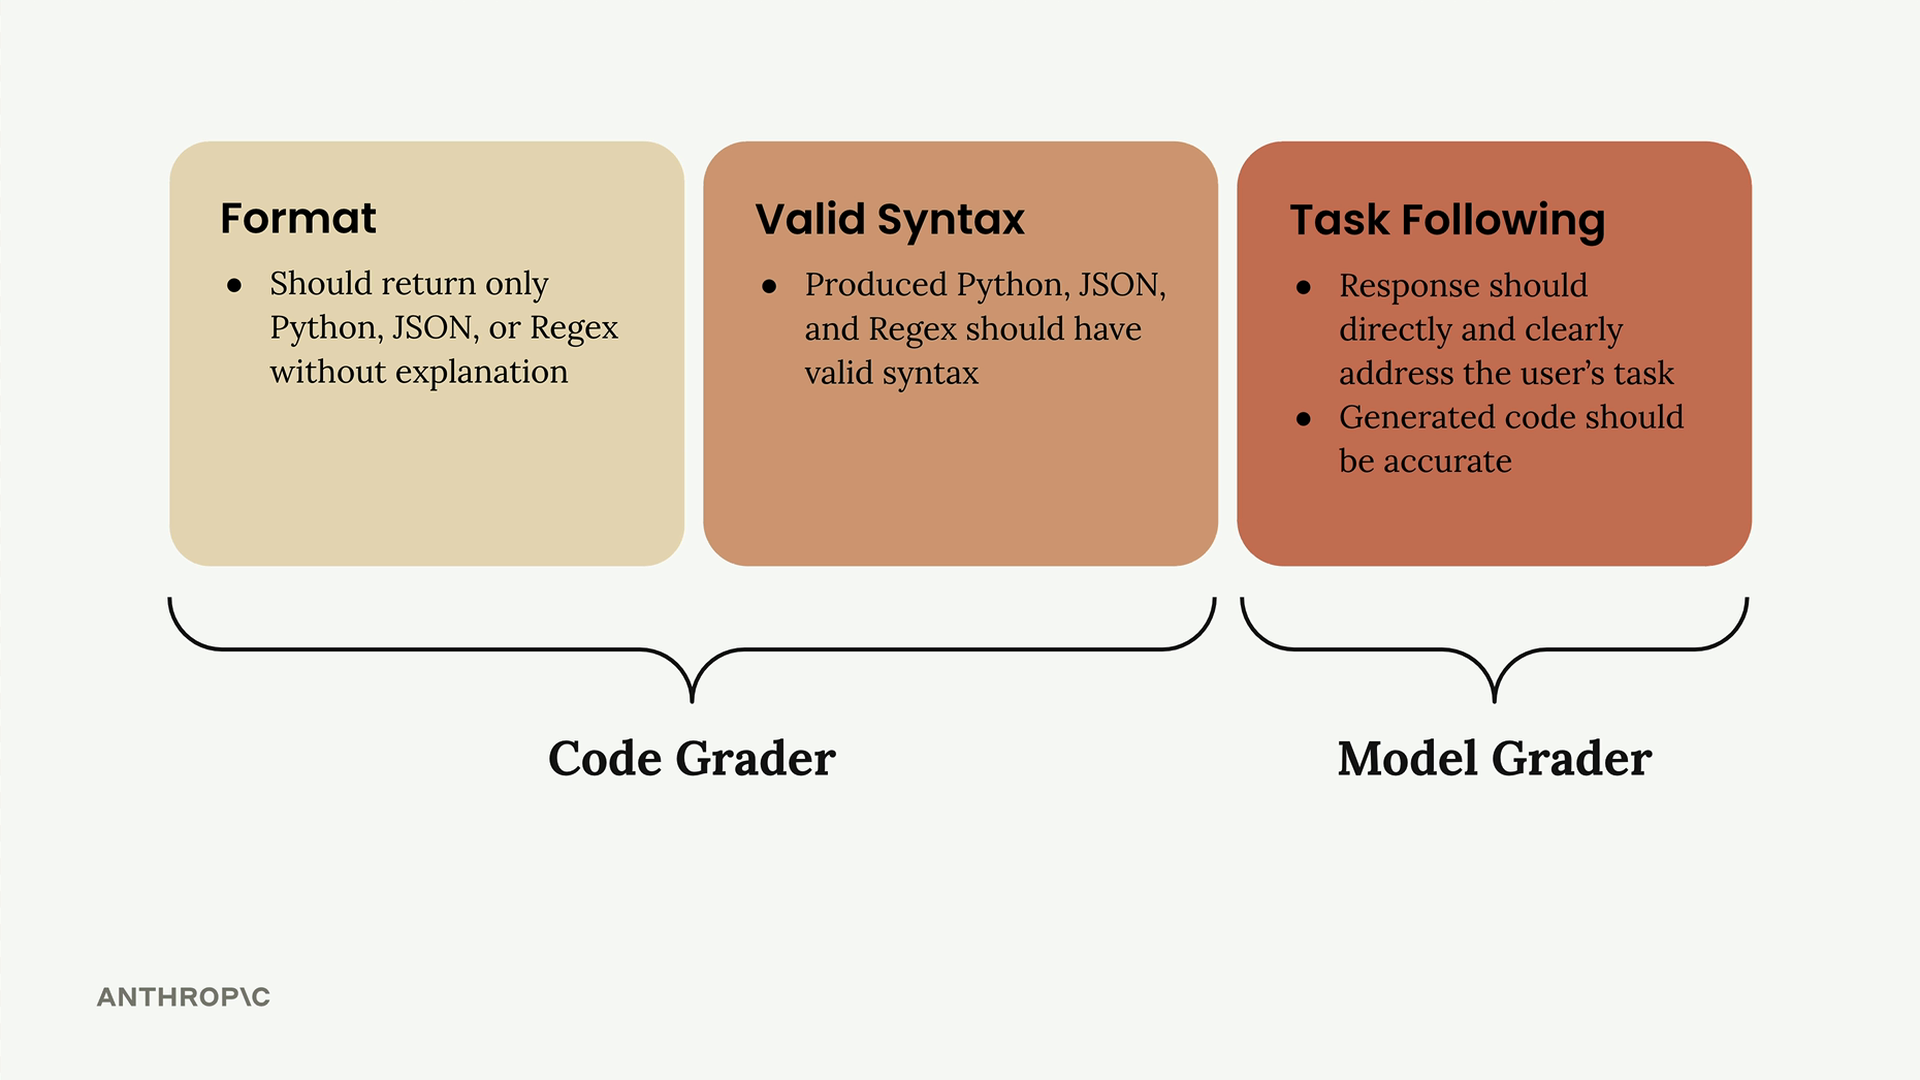
Die ersten beiden Kriterien funktionieren gut mit Code-Gradern, während sich die Aufgabenbefolgung aufgrund ihrer Flexibilität besser für Modell-Grader eignet.
Implementieren eines Modell-Graders
So baust du eine Modell-Grader-Funktion:
def grade_by_model(test_case, output):
    # Bewertungs-Prompt erstellen
    eval_prompt = f"""
    You are an expert code reviewer. Evaluate this AI-generated solution.

    Task: {test_case["task"]}
    Solution: {output}

    Provide your evaluation as a structured JSON object with:
    - "strengths": An array of 1-3 key strengths
    - "weaknesses": An array of 1-3 key areas for improvement
    - "reasoning": A concise explanation of your assessment
    - "score": A number between 1-10
    """

    messages = []
    add_user_message(messages, eval_prompt)
    add_assistant_message(messages, "```json")

    eval_text = chat(messages, stop_sequences=["```"])
    return json.loads(eval_text)
Die zentrale Erkenntnis besteht darin, neben der Bewertung auch nach Stärken, Schwächen und Begründung zu fragen. Ohne diesen Kontext neigen Modelle dazu, standardmäßig auf mittelmäßige Bewertungen um 6 zurückzugreifen.
Integration des Graders
Aktualisiere deine Testfall-Funktion, um den Modell-Grader zu verwenden:
def run_test_case(test_case):
    output = run_prompt(test_case)

    # Modellbewertung abrufen
    model_grade = grade_by_model(test_case, output)
    score = model_grade["score"]
    reasoning = model_grade["reasoning"]

    return {
        "output": output,
        "test_case": test_case,
        "score": score,
        "reasoning": reasoning
    }
Berechnen von Durchschnittswerten
Um eine Gesamtleistungsmetrik zu erhalten, berechne den Durchschnittswert über alle Testfälle hinweg:
from statistics import mean

def run_eval(dataset):
    results = []

    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    average_score = mean([result["score"] for result in results])
    print(f"Average score: {average_score}")

    return results
Dies liefert dir eine konkrete, objektive Metrik, um die Prompt-Leistung im Laufe der Zeit zu verfolgen. Obwohl Modell-Grader etwas inkonsistent sein können, bieten sie einen Ausgangspunkt, um deine Prompts systematisch zu messen und zu verbessern.