Ein typischer Prompt-Evaluierungs-Workflow folgt einem systematischen Ansatz, um deine Prompts objektiv zu messen und zu verbessern. Es gibt viele verschiedene Möglichkeiten, diese Workflows zusammenzustellen, sowie diverse Open-Source- und kostenpflichtige Tools, aber das Verständnis des Kernprozesses hilft dir, klein anzufangen und bei Bedarf zu skalieren.
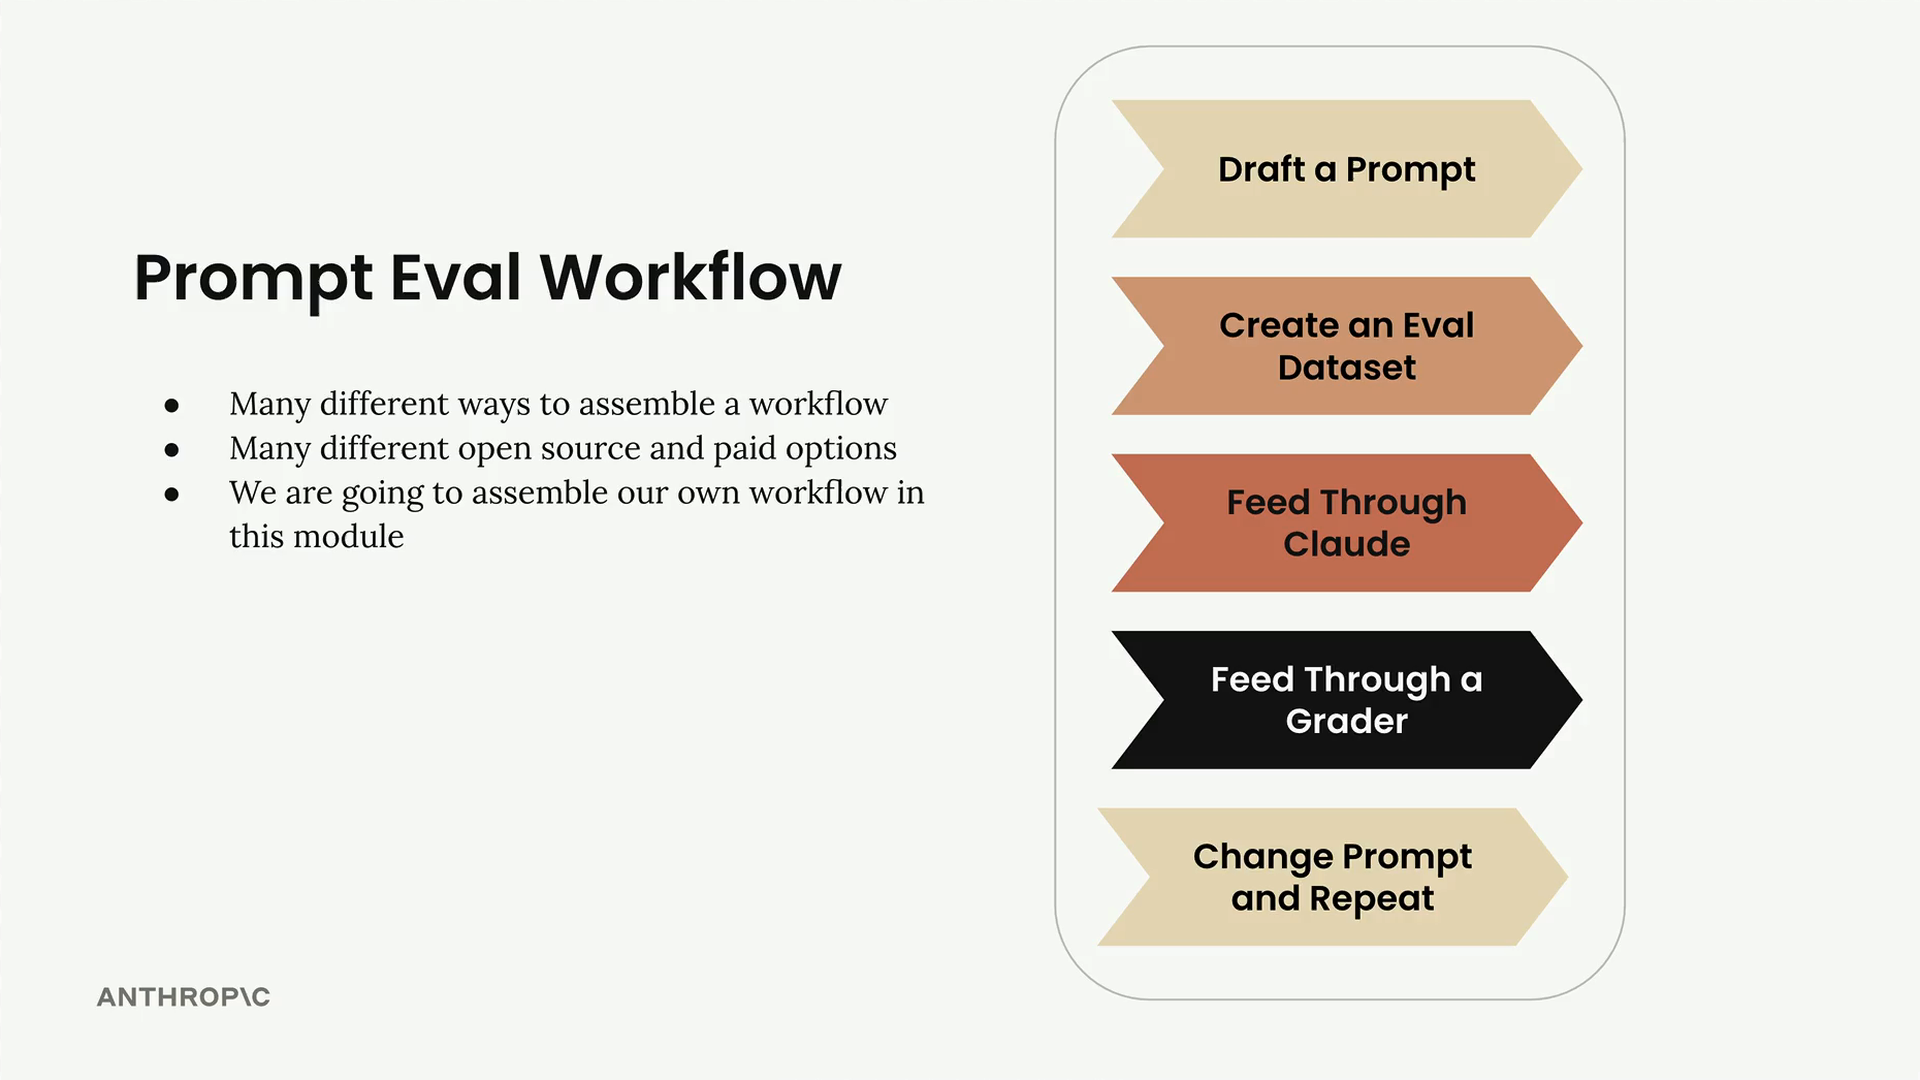
Schritt 1: Entwirf deinen ursprünglichen Prompt
Beginne damit, einen einfachen Prompt zu schreiben, den du verbessern möchtest. Für dieses Beispiel verwenden wir eine einfache Prompt-Struktur:
prompt = f"""
Please answer the user's question:

{question}
"""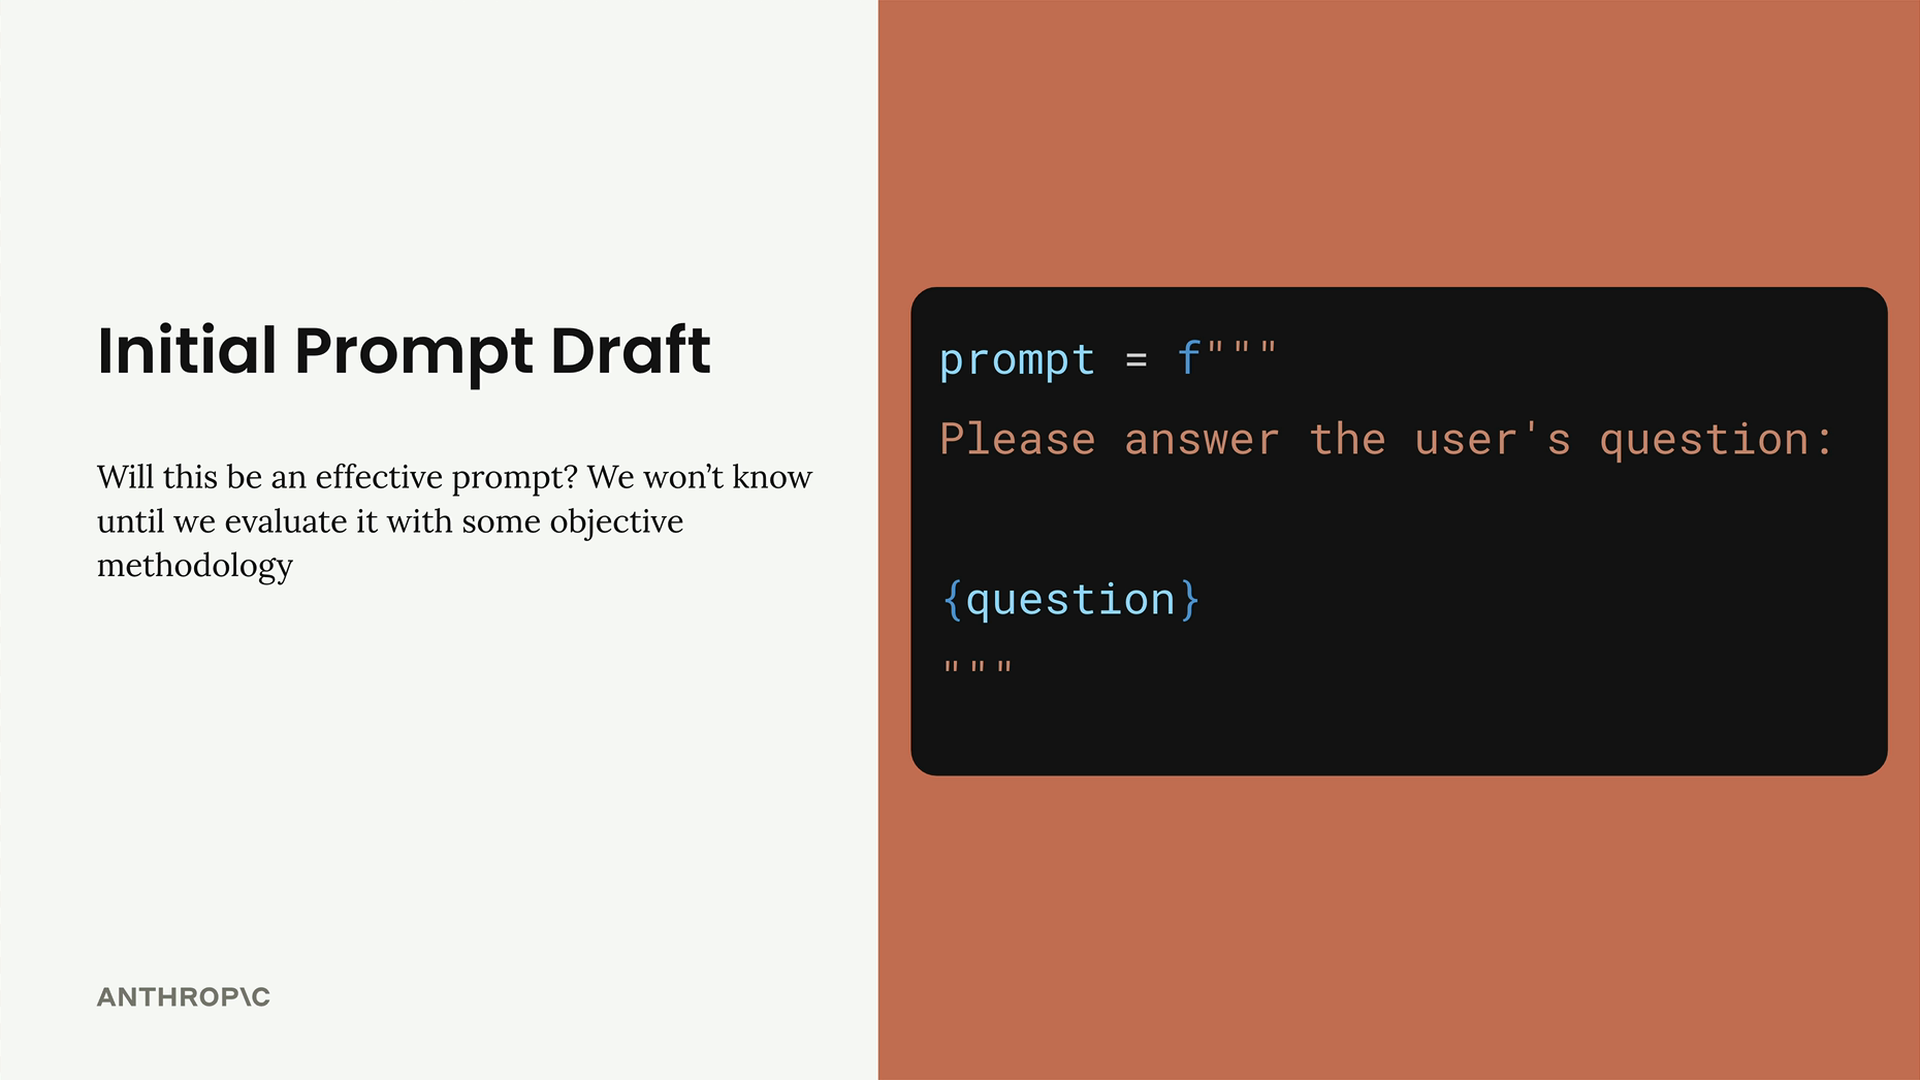
Dies gibt uns eine Ausgangsbasis, von der aus wir arbeiten können. Wir werden erst wissen, ob er effektiv ist, wenn wir ihn mit einer objektiven Methodik evaluieren.
Schritt 2: Erstelle einen Evaluierungsdatensatz
Dein Evaluierungsdatensatz enthält Beispiel-Eingaben, die du in deinen Prompt einspeist. Da unser Prompt nur eine Eingabe hat (die Frage des Nutzers), benötigen wir eine Sammlung verschiedener Fragen zum Testen.
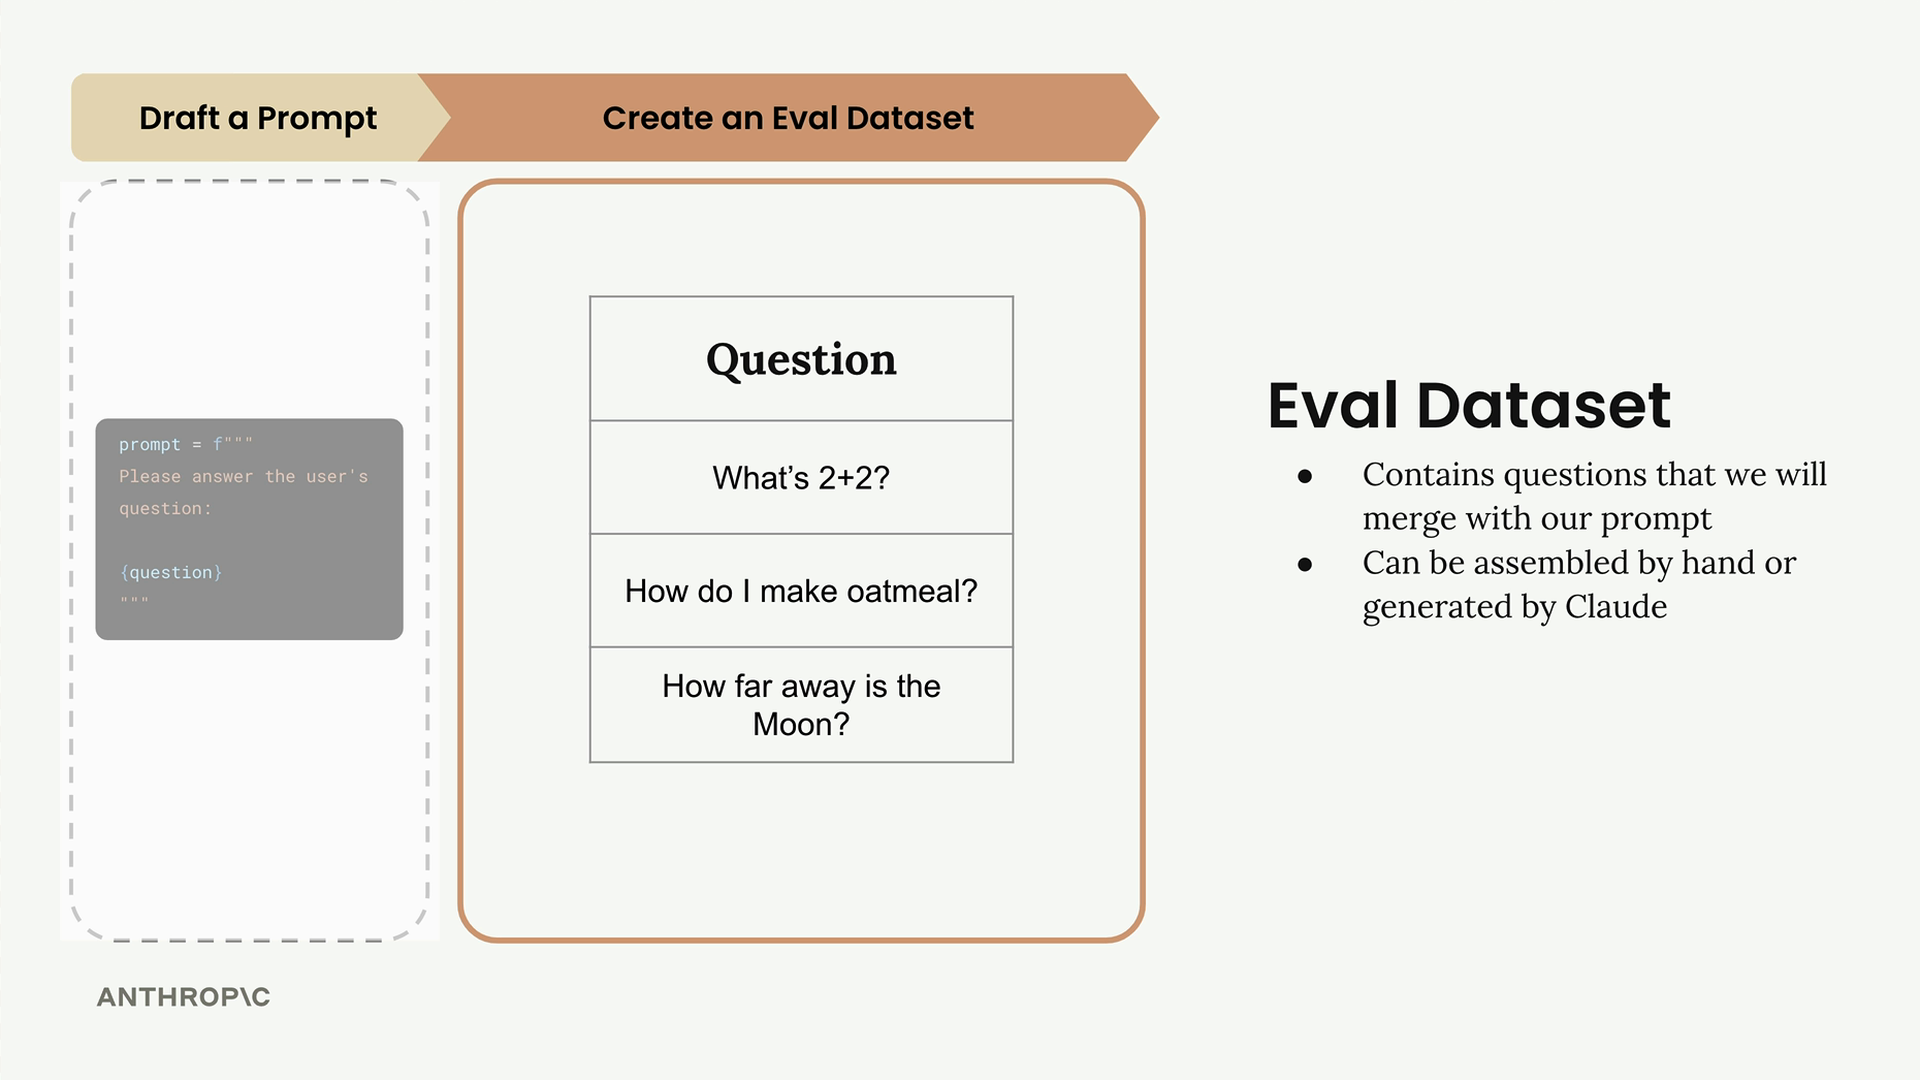
Der Datensatz enthält Fragen, die wir mit unserem Prompt zusammenführen. Du kannst diese Datensätze von Hand zusammenstellen oder sie mit Claude generieren. In realen Evaluierungen hast du möglicherweise zehn, hunderte oder sogar tausende verschiedene Datensätze, aber für dieses Beispiel beginnen wir mit nur drei Fragen:
- Was ist 2+2?
- Wie bereite ich Haferbrei zu?
- Wie weit ist der Mond entfernt?
Schritt 3: Durch Claude laufen lassen
Nimm jede Frage aus deinem Datensatz und führe sie mit deiner Prompt-Vorlage zusammen, um vollständige Prompts zu erstellen. Sende dann jeden davon an Claude und sammle die Antworten.
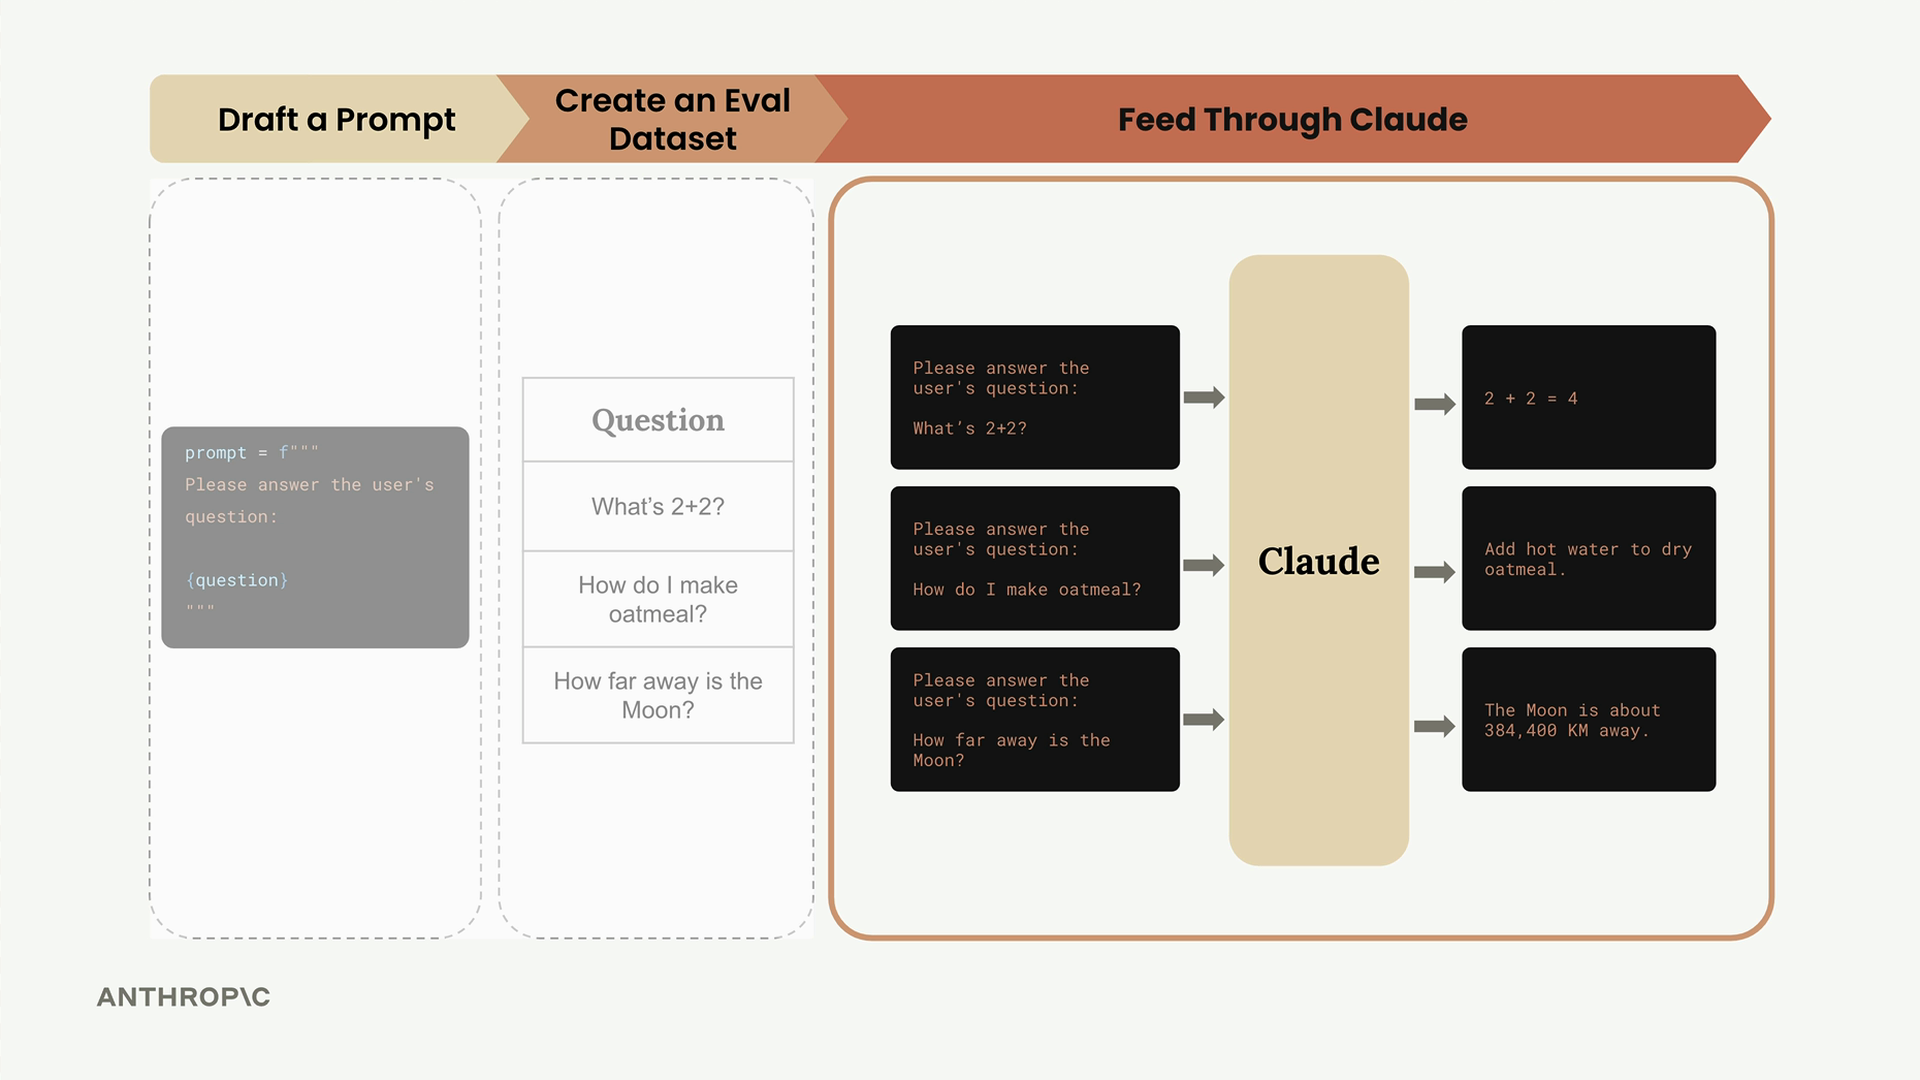
Zum Beispiel wird die erste Frage zu einem vollständigen Prompt, auf den Claude antworten kann. Du wiederholst diesen Prozess für alle Datensätze in deinem Datensatz und erhältst Antworten wie „2 + 2 = 4“, detaillierte Anleitungen für Haferbrei und Informationen über die Entfernung des Mondes.
Schritt 4: Durch einen Grader laufen lassen
Jetzt kommt der entscheidende Schritt: die objektive Bewertung von Claudes Antworten. Nimm jedes Frage-Antwort-Paar und speise es in einen Grader ein, der die Qualität von Claudes Antwort bewertet.
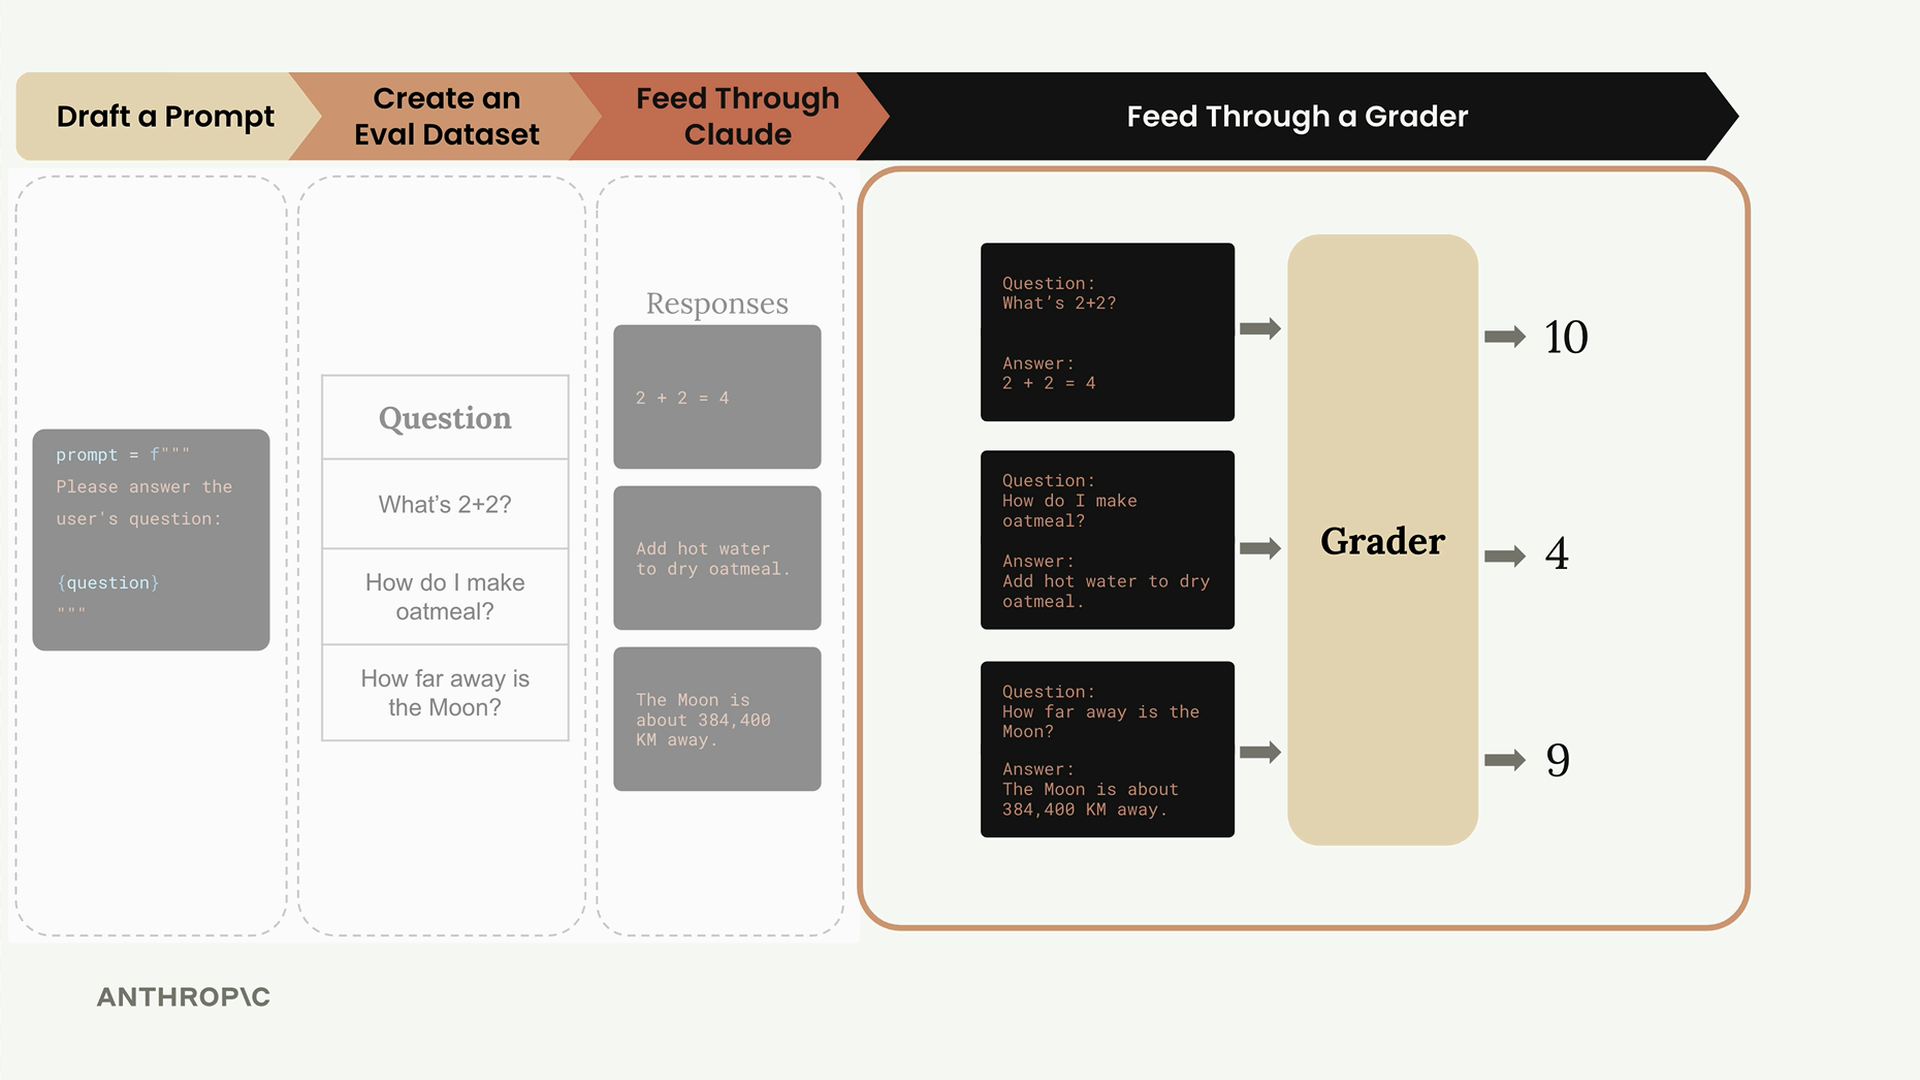
Der Grader vergibt Punktzahlen (typischerweise 1-10) basierend auf der Antwortqualität:
- 10 = Perfekte Antwort, kein Verbesserungsbedarf
- 4 = Definitiv Verbesserungsbedarf
- 1 = Schlechte oder falsche Antwort
In unserem Beispiel könnten die Antworten mit 10, 4 bzw. 9 bewertet werden. Berechne den Durchschnitt dieser Punktzahlen, um eine Gesamtleistungskennzahl zu erhalten: 7,66.
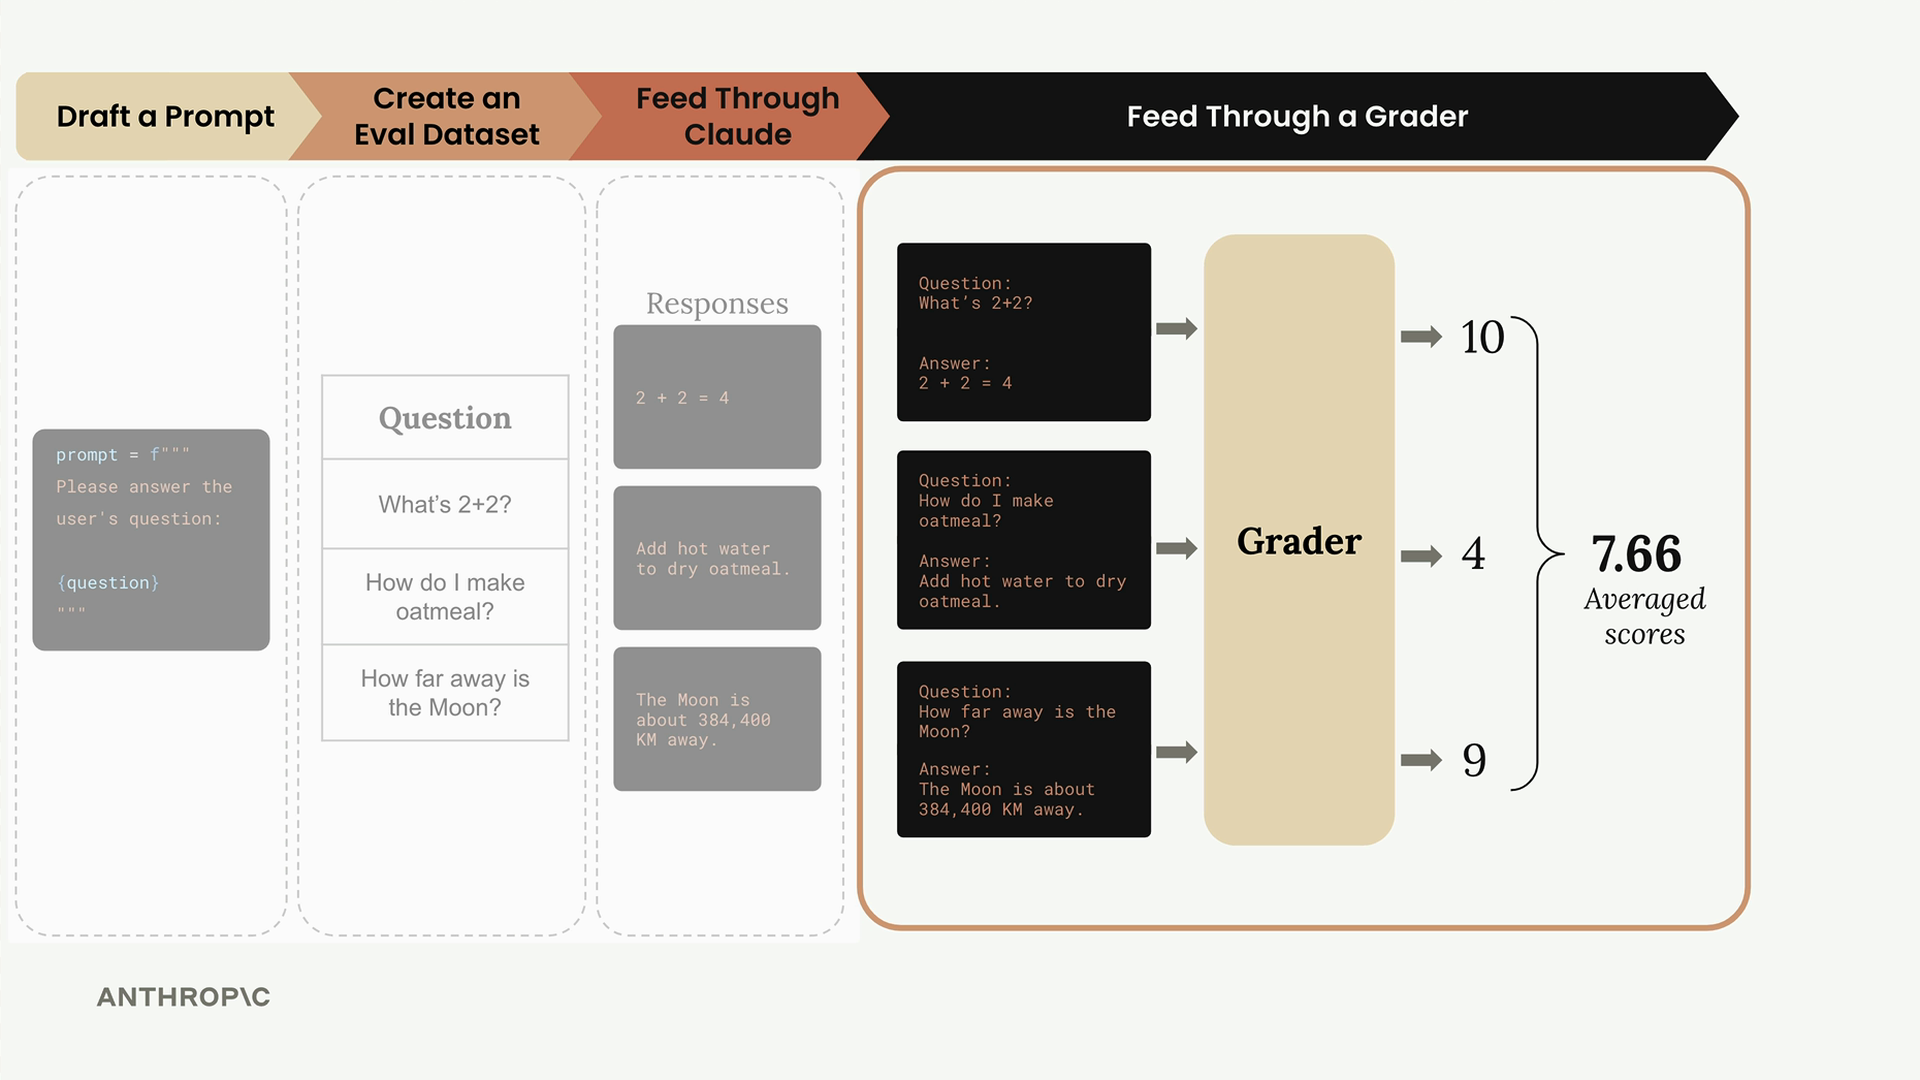
Schritt 5: Prompt ändern und wiederholen
Mit deiner festgelegten Ausgangsbewertung kannst du nun deinen Prompt iterieren. Versuche, spezifischere Anweisungen hinzuzufügen, um Claudes Antworten zu leiten:
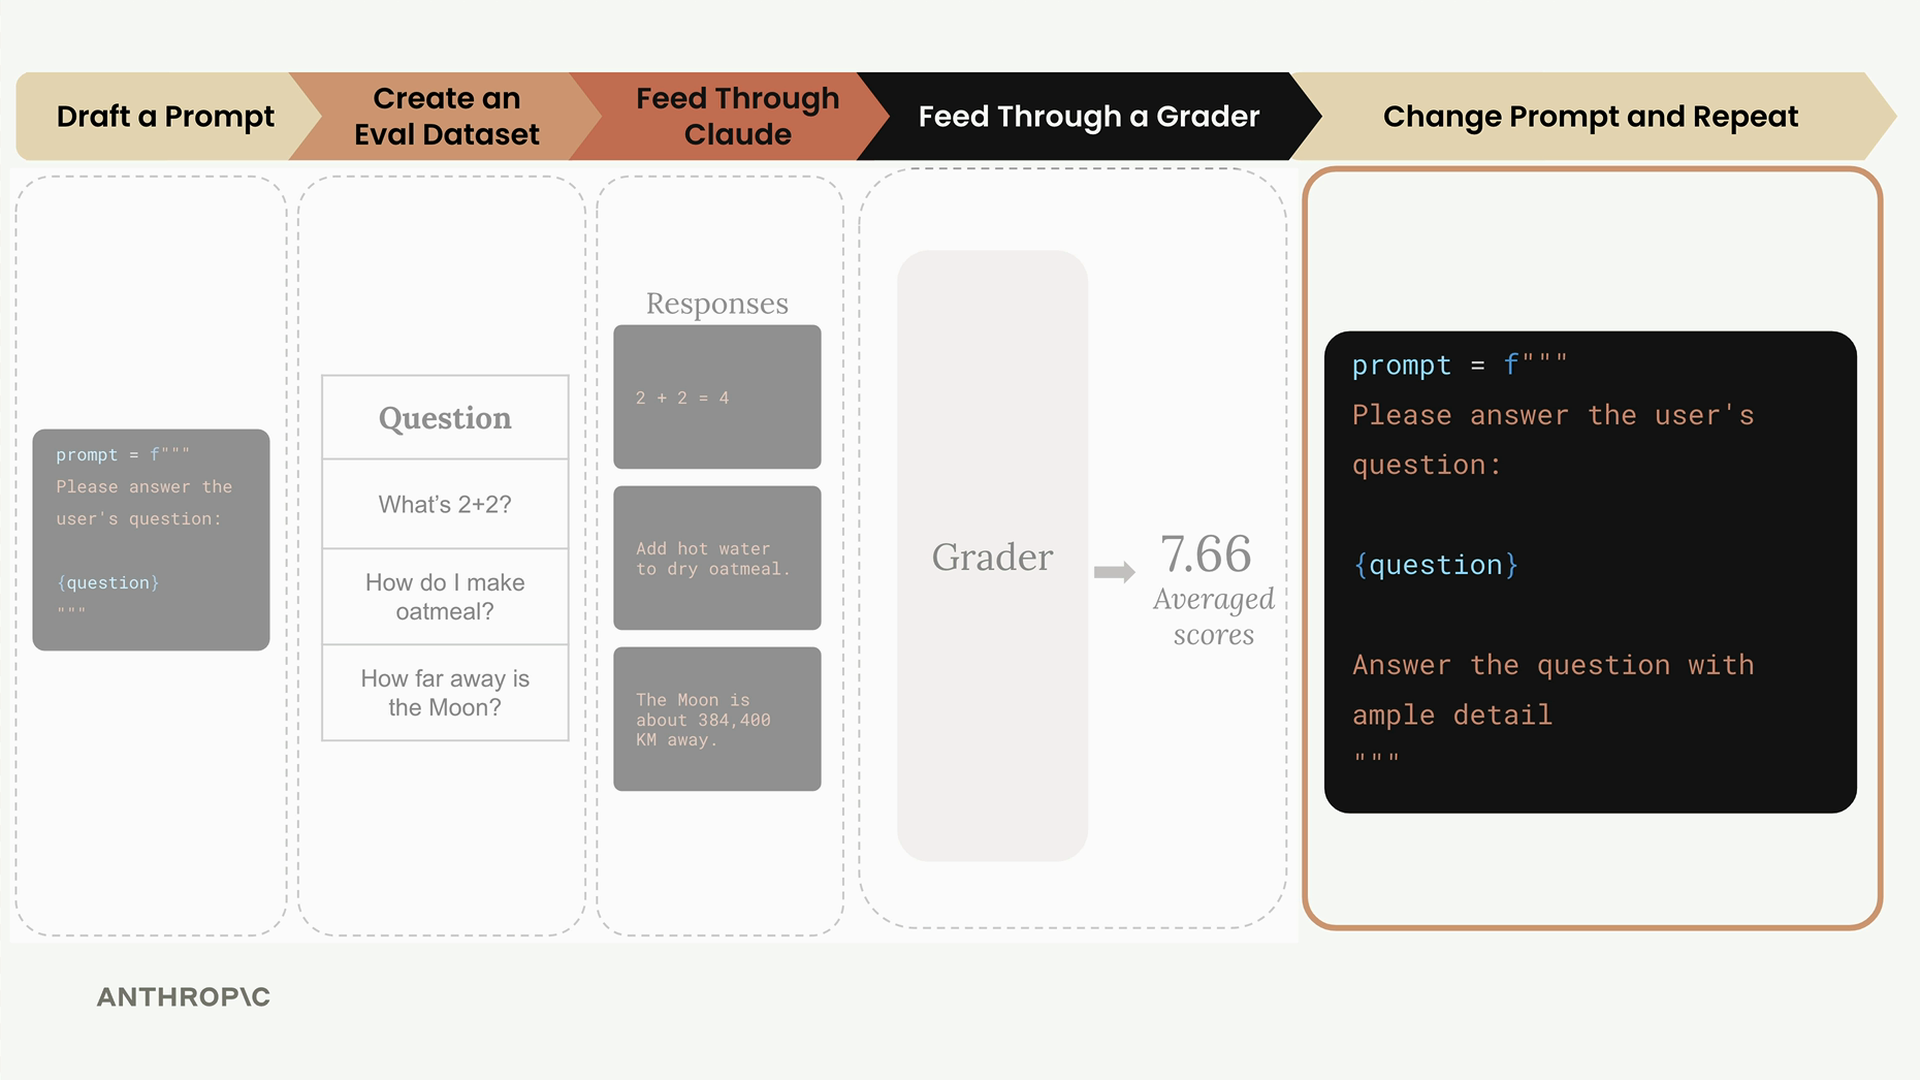
prompt = f"""
Please answer the user's question:

{question}

Answer the question with ample detail
"""
Führe diesen verbesserten Prompt erneut durch die gesamte Evaluierungs-Pipeline. Vergleiche die Punktzahlen, um zu sehen, welche Version besser abschneidet.
Prompt-Bewertung und Iteration
Die Stärke dieses Workflows liegt darin, objektive Messungen für jede Prompt-Version zu erhalten. Du kannst Punktzahlen über verschiedene Iterationen hinweg vergleichen und die Version mit der besten Leistung verwenden oder weiter iterieren, um noch bessere Ansätze zu finden.
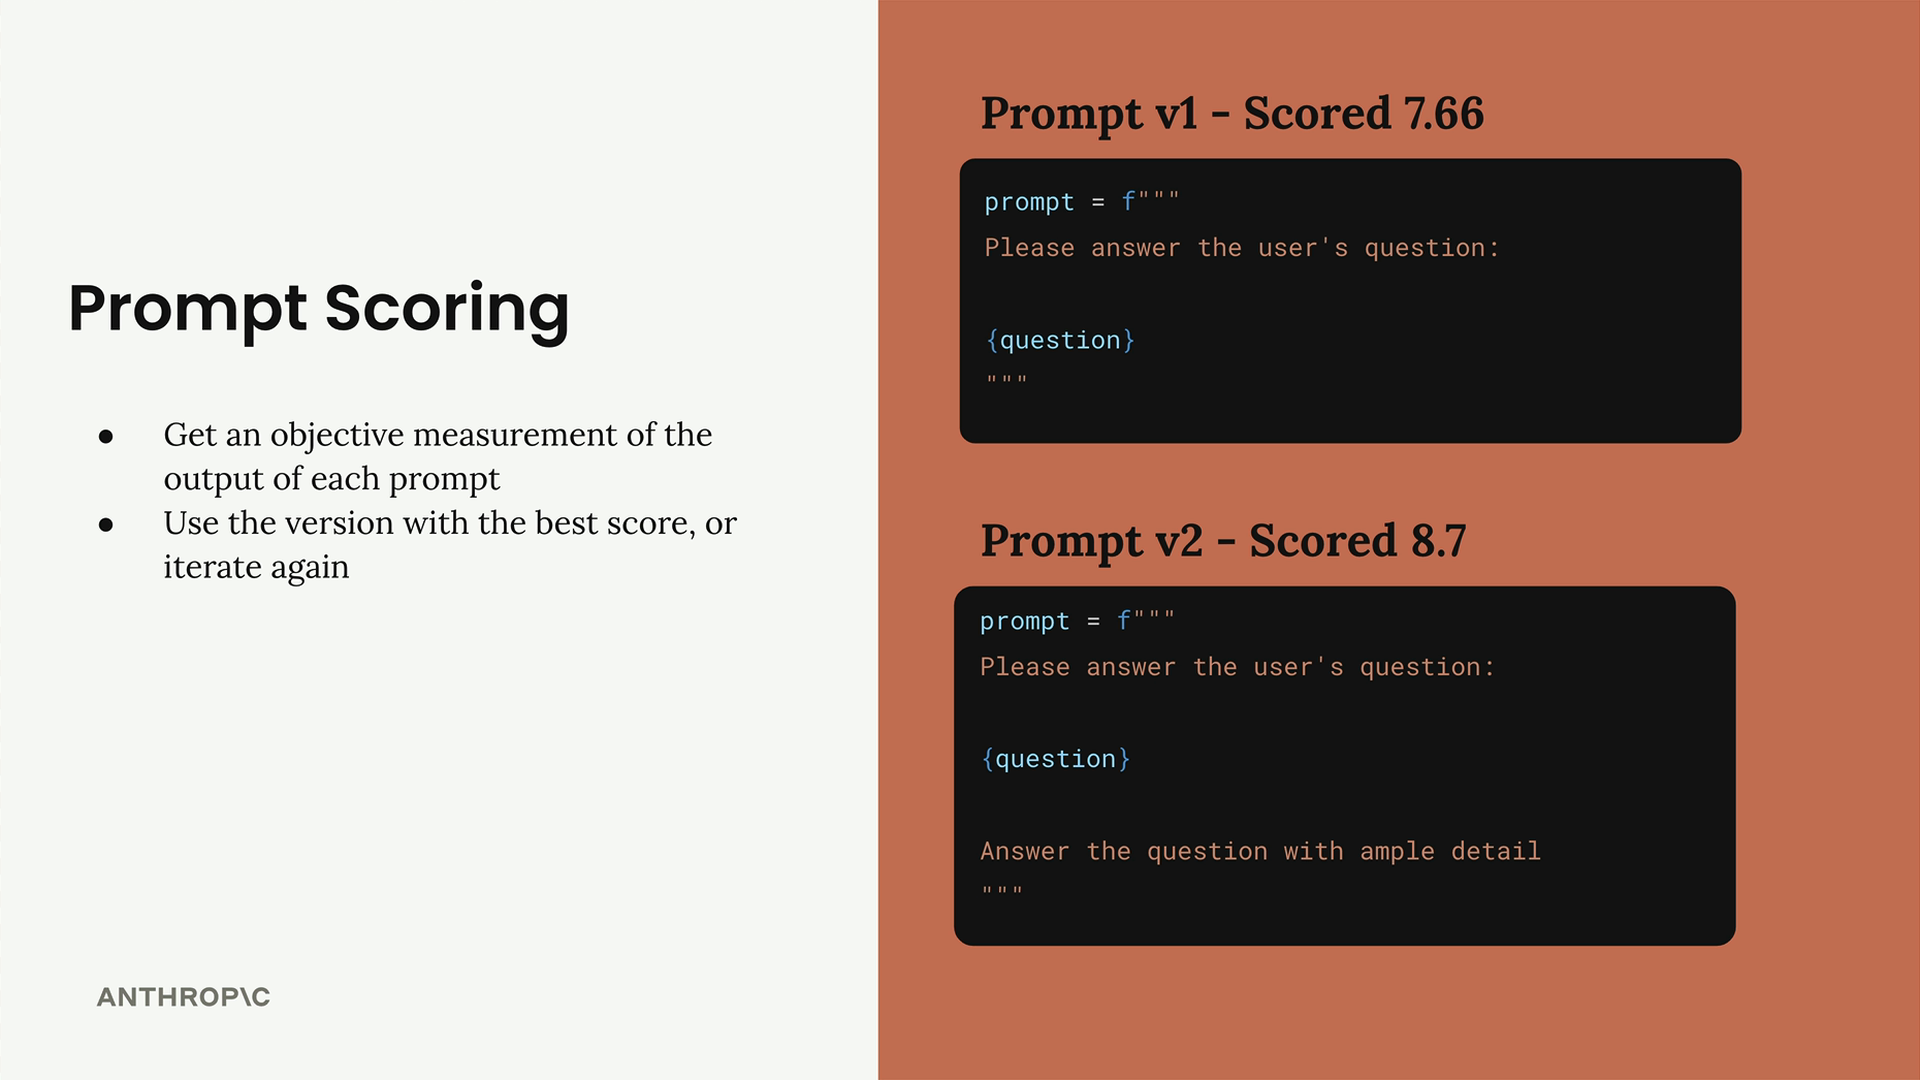
In unserem Beispiel:
- Prompt v1 erzielte 7,66 Punkte
- Prompt v2 erzielte 8,7 Punkte
Die höhere Punktzahl für v2 deutet darauf hin, dass das Hinzufügen von „Beantworte die Frage mit ausreichend Detail“ die Leistung des Prompts über unsere Testfälle hinweg verbessert hat.
Dieser systematische Ansatz gibt dir eine objektive Möglichkeit, Prompt-Verbesserungen zu messen, anstatt dich auf subjektive Einschätzungen zu verlassen. Du kannst mit einer einfachen Implementierung beginnen und nach und nach anspruchsvollere Bewertungskriterien hinzufügen, wenn deine Anforderungen wachsen.