Kontextuelles Retrieval ist eine Technik, die die Genauigkeit von RAG-Pipelines verbessert, indem sie ein grundlegendes Problem löst: Wenn du ein Dokument in Chunks aufteilst, verliert jeder Chunk seine Verbindung zum breiteren Dokumentkontext.
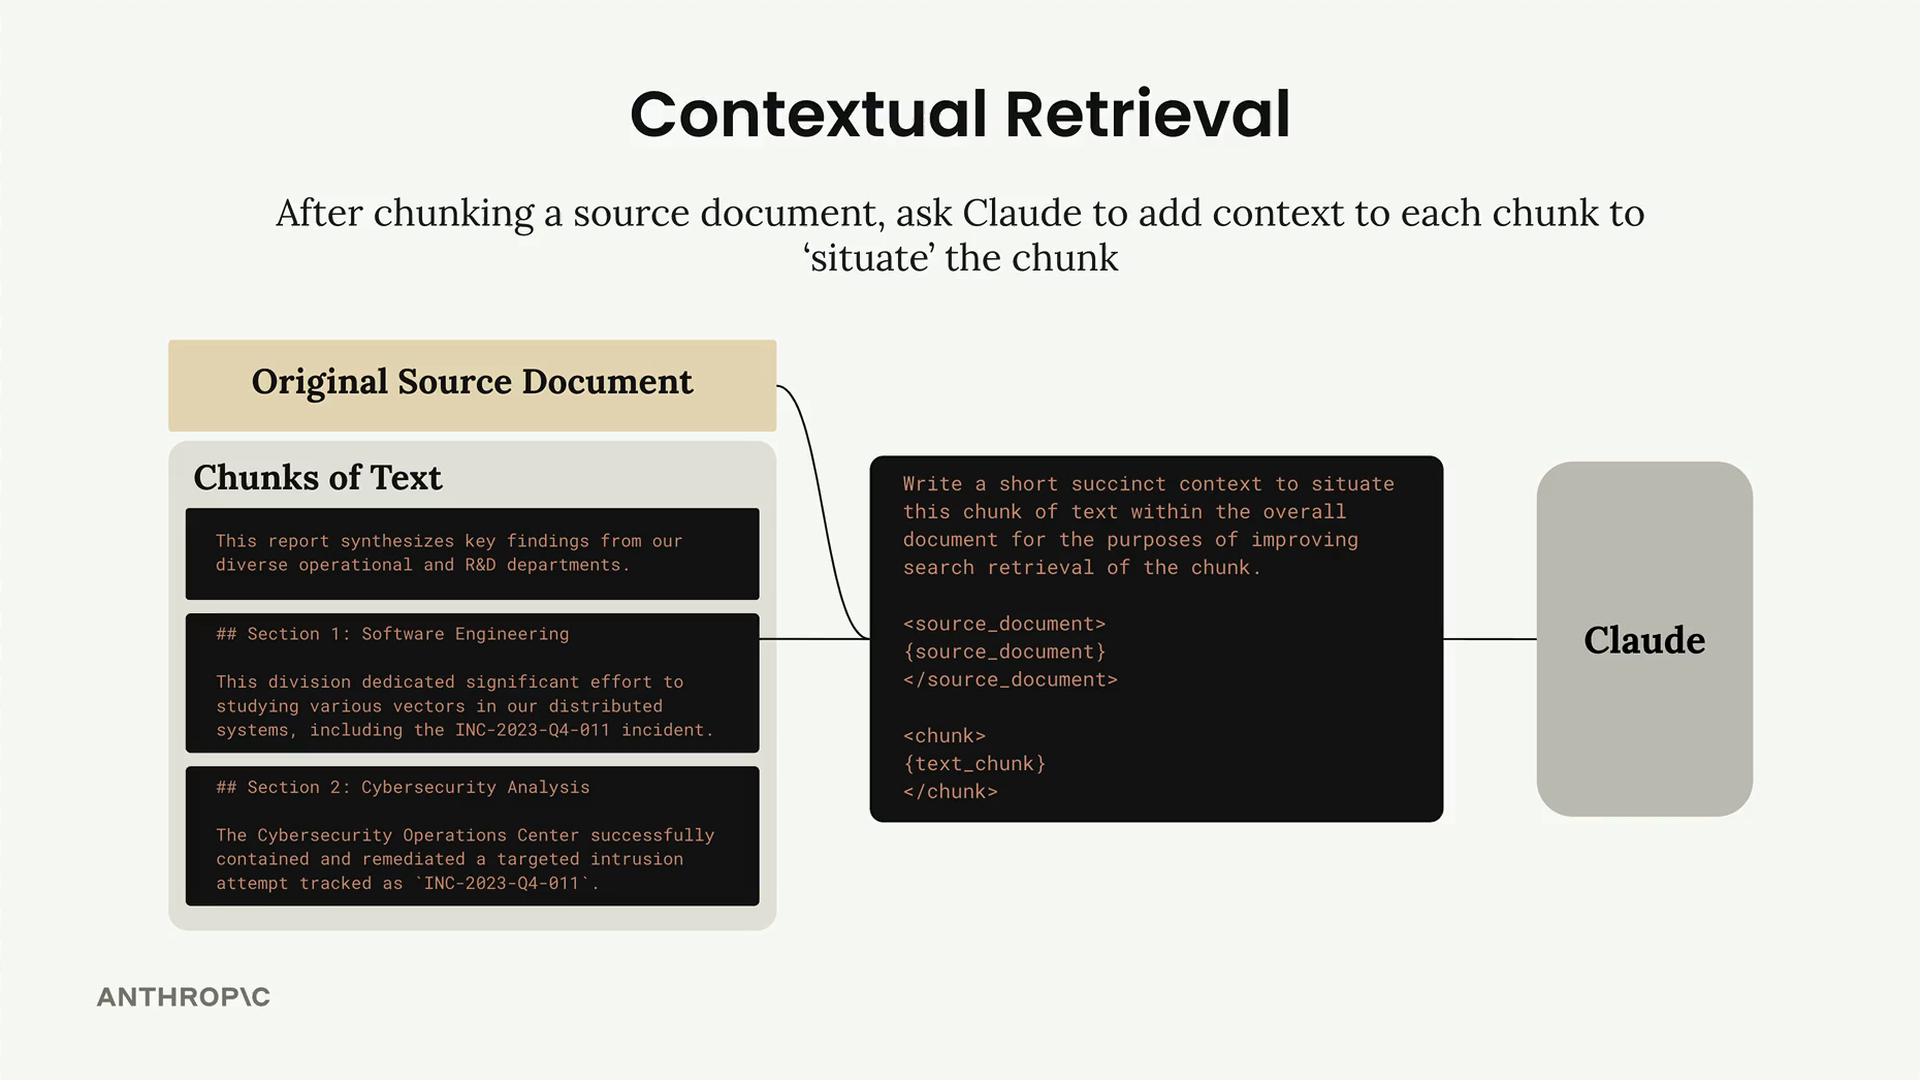
Die Grundidee ist einfach. Nachdem du dein Quelldokument in Chunks aufgeteilt hast, bittest du Claude, jedem Chunk Kontext hinzuzufügen, bevor er in deiner Retriever-Datenbank gespeichert wird. Dieser Vorverarbeitungsschritt hilft dabei, jeden Chunk innerhalb des größeren Dokuments zu „verorten“.
Funktionsweise
Für jeden Text-Chunk sendest du sowohl den Chunk als auch das ursprüngliche Quelldokument mit einem Prompt wie diesem an Claude:
Write a short and succinct snippet of text to situate this chunk within the
overall source document for the purposes of improving search retrieval of the chunk.

Here is the original source document:
<document>
{source_text}
</document>

Here is the chunk we want to situate within the whole document:
<chunk>
{text_chunk}
</chunk>

Answer only with the succinct context and nothing else.Claude könnte einen Kontext wie diesen generieren: „Dieser Abschnitt stammt aus einem größeren Bericht über eine fachübergreifende Gruppe. Er enthält eine Erwähnung von INC-2023-04-011, die auch im Abschnitt Cybersecurity-Analyse erwähnt wird.“
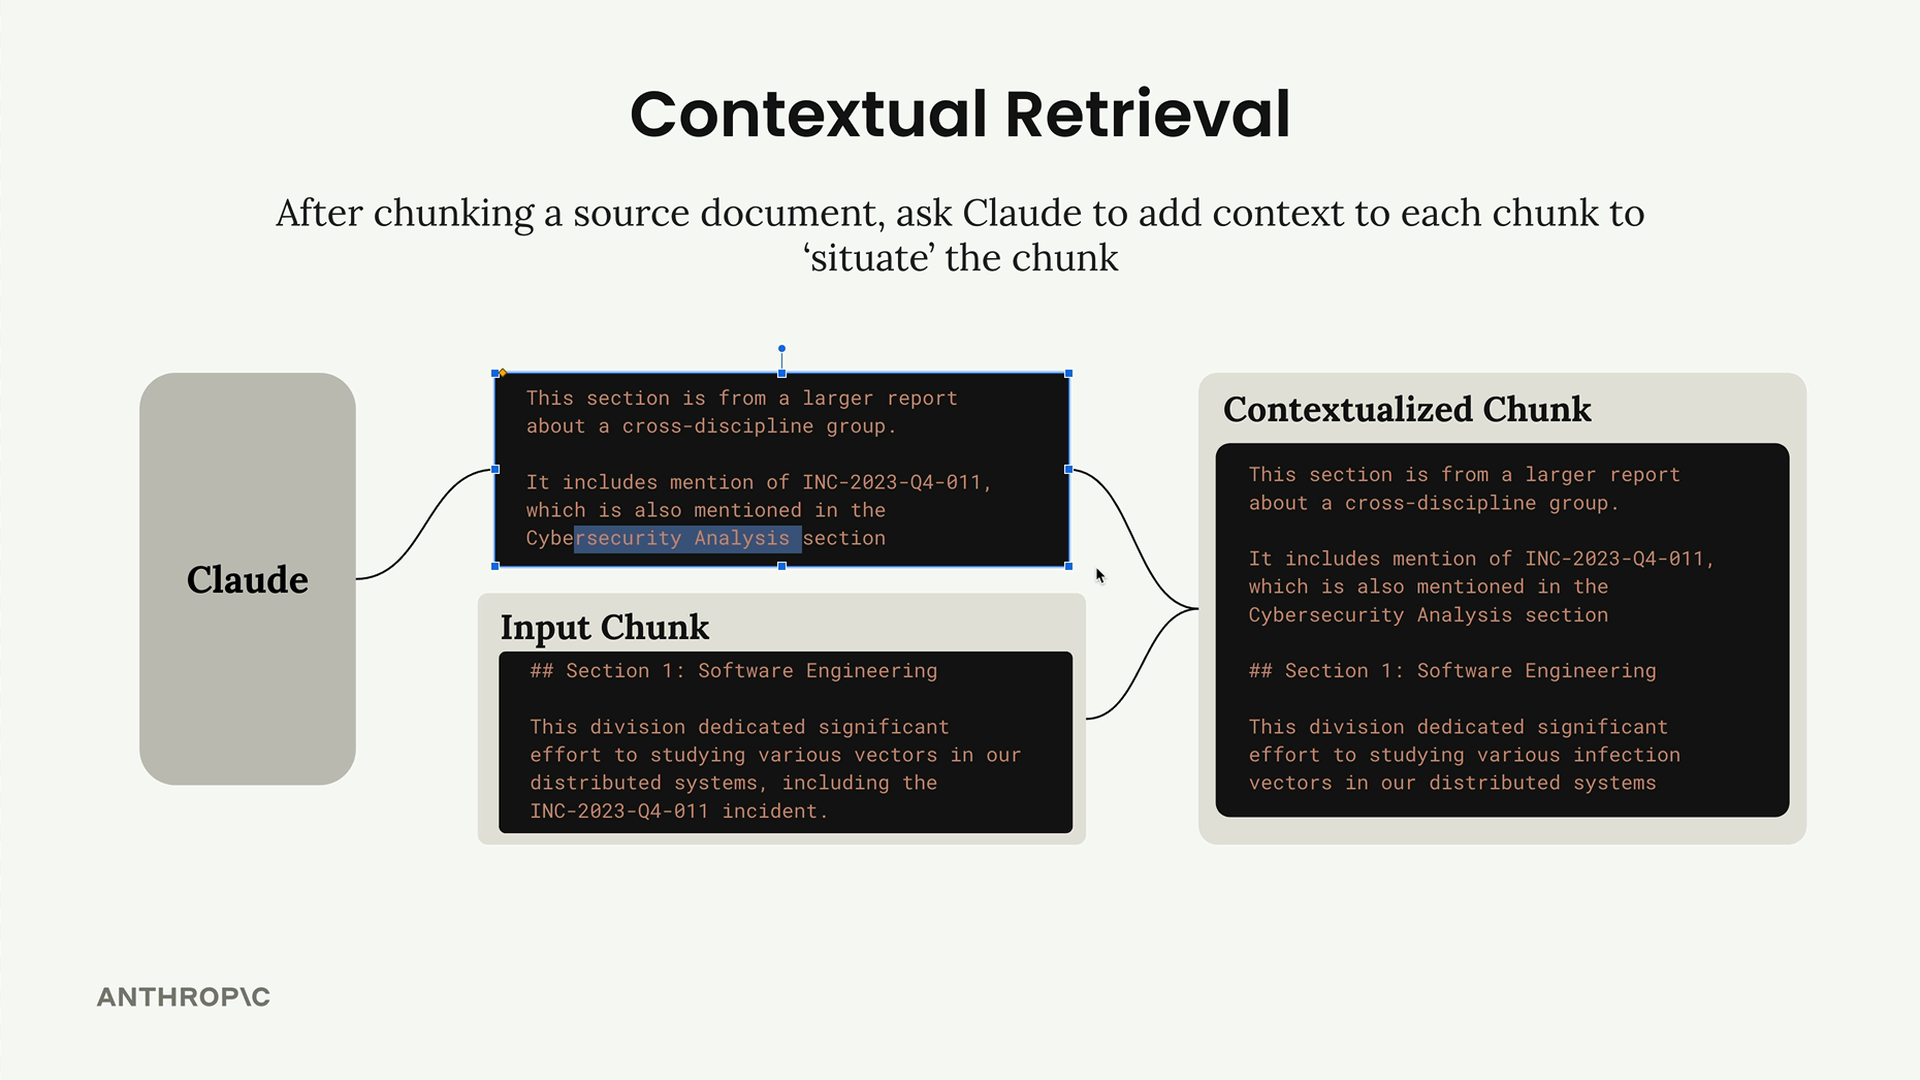
Anschließend kombinierst du diesen generierten Kontext mit dem ursprünglichen Chunk-Text, um einen „kontextualisierten Chunk“ zu erstellen, der in deinen Vektor- und BM25-Indizes gespeichert wird.
Umgang mit großen Dokumenten
Wenn dein Quelldokument zu groß ist, um in einen einzelnen Prompt zu passen, kannst du anstelle des gesamten Dokuments eine reduzierte Menge an Kontext bereitstellen.
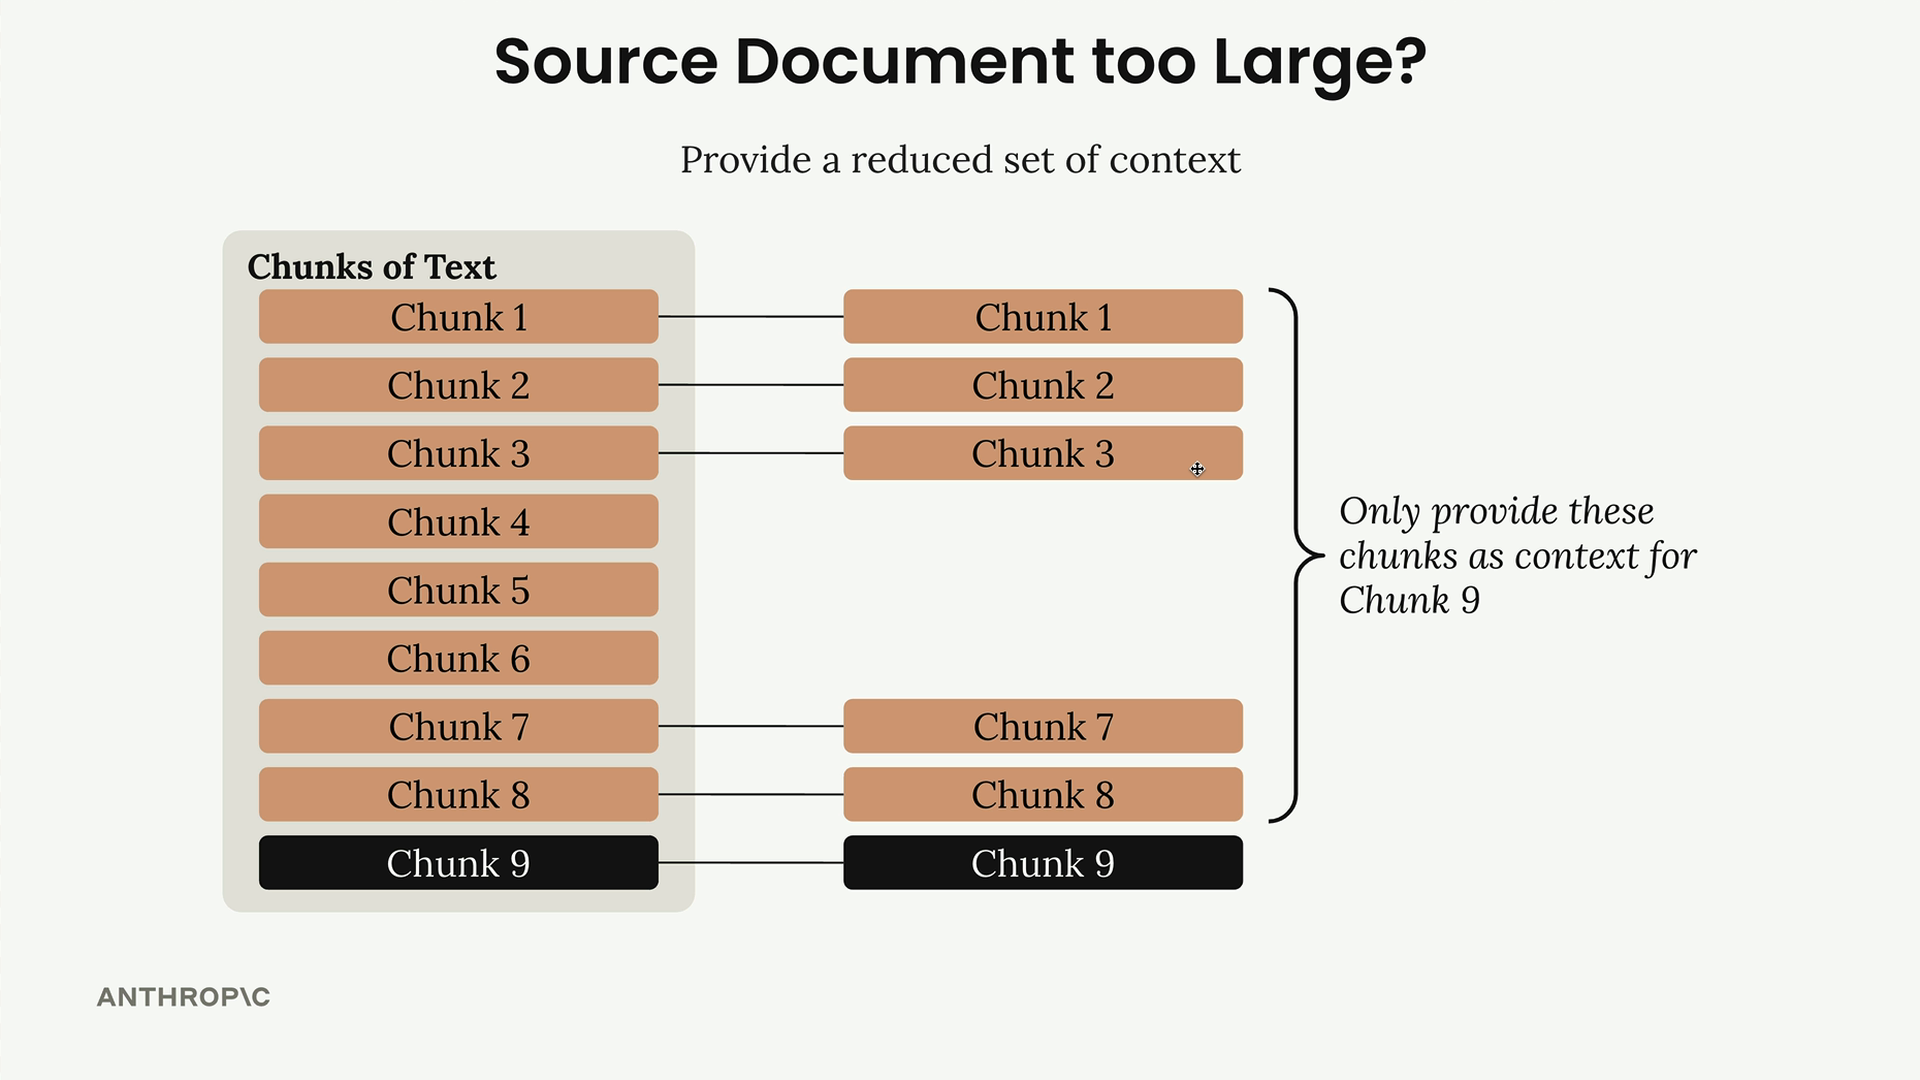
Für jeden Chunk, den du kontextualisierst, solltest du Folgendes einbeziehen:
- Einige Chunks vom Anfang des Dokuments (die oft Zusammenfassungen oder Abstracts enthalten)
- Chunks, die dem Ziel-Chunk unmittelbar vorausgehen (sie liefern lokalen Kontext)
Dieser Ansatz gibt Claude genug Informationen, um aussagekräftigen Kontext zu generieren, ohne den Prompt mit dem gesamten Dokument zu überfrachten.
Implementierungsbeispiel
Hier ist eine einfache Implementierung der Funktion für kontextuelles Retrieval:
def add_context(text_chunk, source_text):
    prompt = f"""
    Write a short and succinct snippet of text to situate this chunk within the
    overall source document for the purposes of improving search retrieval of the chunk.

    Here is the original source document:
    <document>
    {source_text}
    </document>

    Here is the chunk we want to situate within the whole document:
    <chunk>
    {text_chunk}
    </chunk>

    Answer only with the succinct context and nothing else.
    """

    messages = []
    add_user_message(messages, prompt)
    result = chat(messages)

    return result["text"] + "\n" + text_chunk
Beim Verarbeiten deiner Dokument-Chunks würdest du jeden einzelnen durchlaufen und kontextualisierte Versionen generieren:
# Kontext zu jedem Chunk hinzufügen, dann zum Retriever hinzufügen
for i, chunk in enumerate(chunks):
    # Kontext aus Start-Chunks und vorhergehenden Chunks erstellen
    context_parts = []
    context_parts.extend(chunks[:min(num_start_chunks, len(chunks))])

    start_idx = max(0, i - num_prev_chunks)
    context_parts.extend(chunks[start_idx:i])

    context = "\n".join(context_parts)

    contextualized_chunk = add_context(chunk, context)
    retriever.add_document({"content": contextualized_chunk})
Erwartete Ergebnisse
Der generierte Kontext liefert wertvolle Informationen über die Dokumentstruktur und die Zusammenhänge. Claude könnte einen Chunk beispielsweise so beschreiben: „Abschnitt 2 eines jährlichen interdisziplinären Forschungsberichts, der die Bemühungen des Software Engineering zur Lösung von Stabilitätsproblemen im Projekt Phoenix beschreibt. Er folgt auf den Abschnitt Methodik und geht dem Abschnitt Finanzanalyse voraus und bildet Teil eines umfassenden Berichts, der zehn Forschungsbereiche der Organisation abdeckt.“
Dieser zusätzliche Kontext hilft dem Retrieval-System, nicht nur besser zu verstehen, was jeder Chunk enthält, sondern auch, wie er in die größere Dokumentstruktur passt und sich zu anderen Abschnitten verhält. Während du bei einfachen Dokumenten möglicherweise keine dramatischen Verbesserungen siehst, wird kontextuelles Retrieval zunehmend wertvoller, je komplexer deine Dokumente mit verwickelten Querverweisen und Abhängigkeiten zwischen Abschnitten werden.