Diese Schritt-für-Schritt-Anleitung demonstriert die vollständige RAG-(Retrieval-Augmented-Generation-)Implementierung anhand eines praktischen Beispiels. Wir bauen eine Vektordatenbank von Grund auf und führen alle fünf Schritte des RAG-Workflows anhand eines Beispielberichtdokuments aus.
Einrichten der Vektordatenbank
Die Implementierung verwendet eine benutzerdefinierte VectorIndex-Klasse, die das Speichern von Embeddings und die Durchführung von Ähnlichkeitssuchen übernimmt. Diese Klasse bietet die Kernfunktionalität, die wir für unsere Vektordatenbank-Operationen benötigen.
Die fünfstufige RAG-Implementierung
Schritt 1: Den Text nach Abschnitt aufteilen
Zunächst laden und zerlegen wir unser Ausgangsdokument mit demselben abschnittsbasierten Chunking-Ansatz wie zuvor:
with open("./report.md", "r") as f:
    text = f.read()

chunks = chunk_by_section(text)
Dadurch wird unser Bericht in logische Abschnitte aufgeteilt, die unabhängig voneinander verarbeitet werden können.
Schritt 2: Embeddings für jeden Chunk generieren
Als Nächstes erstellen wir Embeddings für jeden Chunk mithilfe einer List Comprehension:
embeddings = [generate_embedding(chunk) for chunk in chunks]Dieser Schritt umfasst mehrere API-Aufrufe und braucht daher einige Zeit, bis er abgeschlossen ist. Jeder Chunk wird in eine numerische Vektordarstellung umgewandelt.
Schritt 3: Embeddings in der Vektordatenbank speichern
Jetzt erstellen wir unseren Vektorspeicher und befüllen ihn sowohl mit den Embeddings als auch mit dem zugehörigen Text:
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
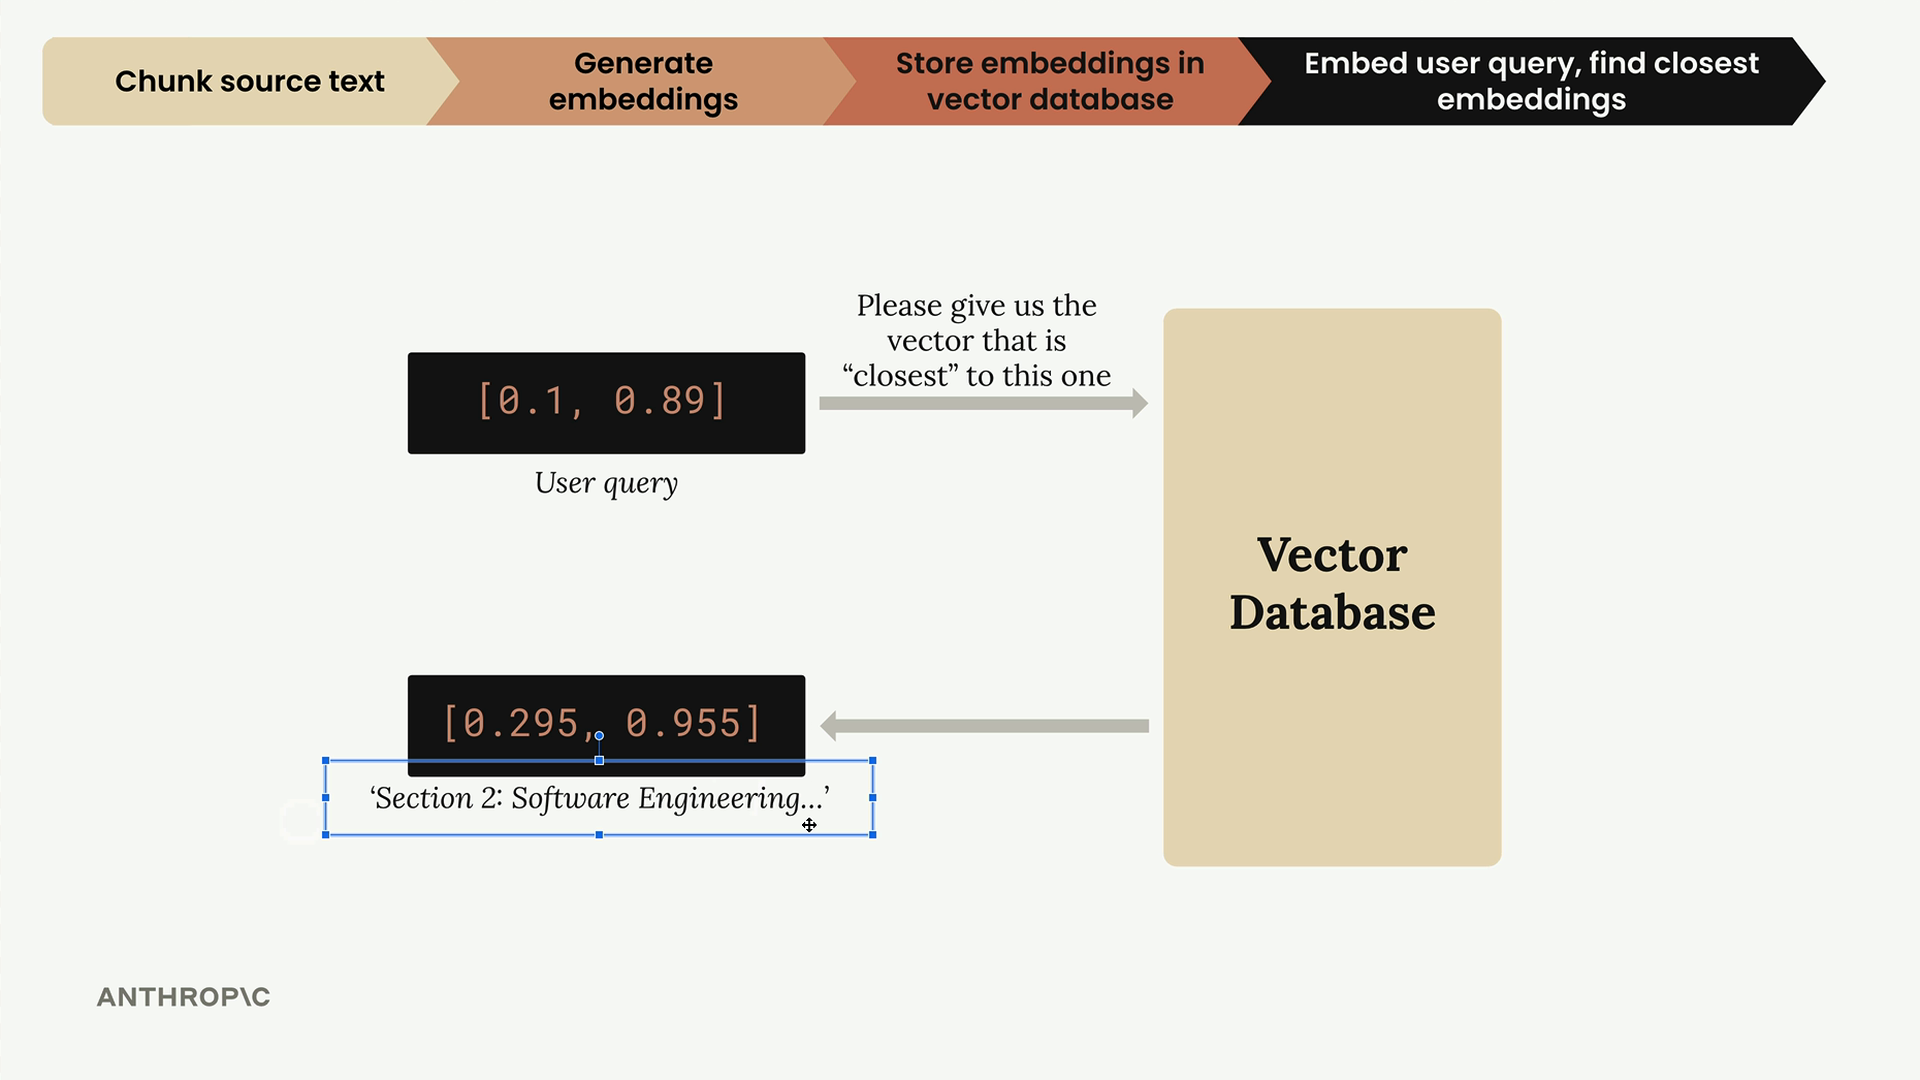
Die entscheidende Erkenntnis ist hier, dass wir sowohl das Embedding als auch den Originaltext speichern. Eine bloße Liste von Zahlen zurückzubekommen, ist nicht nützlich – wir brauchen den tatsächlichen Textinhalt, der zu diesen Embeddings gehört. Diese Metadaten ermöglichen es uns, später aussagekräftige Ergebnisse abzurufen.
Schritt 4: Embedding für die Nutzeranfrage generieren
Wenn ein Nutzer eine Frage stellt, wandeln wir sie in dasselbe Embedding-Format um:
user_embedding = generate_embedding("What did the software engineering dept do last year?")Dadurch entsteht eine Vektordarstellung der Frage des Nutzers, die mit unseren gespeicherten Embeddings verglichen werden kann.
Schritt 5: Relevante Chunks suchen und abrufen
Schließlich durchsuchen wir unseren Vektorspeicher, um den ähnlichsten Inhalt zu finden:
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
Dies liefert die beiden relevantesten Chunks zusammen mit ihren Kosinus-Distanz-Werten. Geringere Distanzen zeigen eine höhere Ähnlichkeit an.
Die Ergebnisse verstehen
Die Suche liefert Ergebnisse, die nach Relevanz geordnet sind. In unserem Beispiel hatte der Abschnitt zum Software-Engineering die geringste Distanz (0,71) und war damit die relevanteste Übereinstimmung. Der Abschnitt zur Methodik folgte an zweiter Stelle mit einer Distanz von 0,72.
Die Distanzmetrik hilft dir zu verstehen, wie zuversichtlich das System hinsichtlich der Relevanz jedes Ergebnisses ist. Geringere Distanzen bedeuten bessere Übereinstimmungen mit der Anfrage des Nutzers.
Warum Text zusammen mit Embeddings gespeichert wird
Eine entscheidende Designentscheidung besteht darin, den Originaltext zusammen mit jedem Embedding zu speichern. Ohne dies würdest du nur Zahlenfelder zurückbekommen, die für die Generierung von Antworten nicht nützlich sind. Indem du den Quelltext einbeziehst, kannst du die abgerufenen Chunks sofort nutzen, um deinem Sprachmodell Kontext zu liefern.
Damit ist der grundlegende RAG-Workflow abgeschlossen, auch wenn es zusätzliche Optimierungen und Verbesserungen gibt, die die Leistung in realen Szenarien weiter steigern können.