Der Aufbau eines individuellen Prompt-Evaluierungsworkflows beginnt mit der Festlegung eines klaren Ziels und der Generierung von Testdaten. In diesem Fall erstellen wir einen Prompt, der Benutzern dabei hilft, AWS-spezifischen Code zu schreiben – entweder Python-Funktionen, JSON-Konfigurationen oder reguläre Ausdrücke – ohne zusätzliche Erklärungen oder Formatierung.
Das Ziel festlegen
Der Prompt soll die Aufgabenbeschreibung eines Benutzers entgegennehmen und einen von drei Ausgabetypen zurückgeben:
- Python-Code
- JSON-Konfiguration
- Reguläre Ausdrücke
Die zentrale Anforderung ist, dass die Antworten ausschließlich den angeforderten Code enthalten sollen, ohne Kopf- oder Fußzeilen oder Erklärungen.
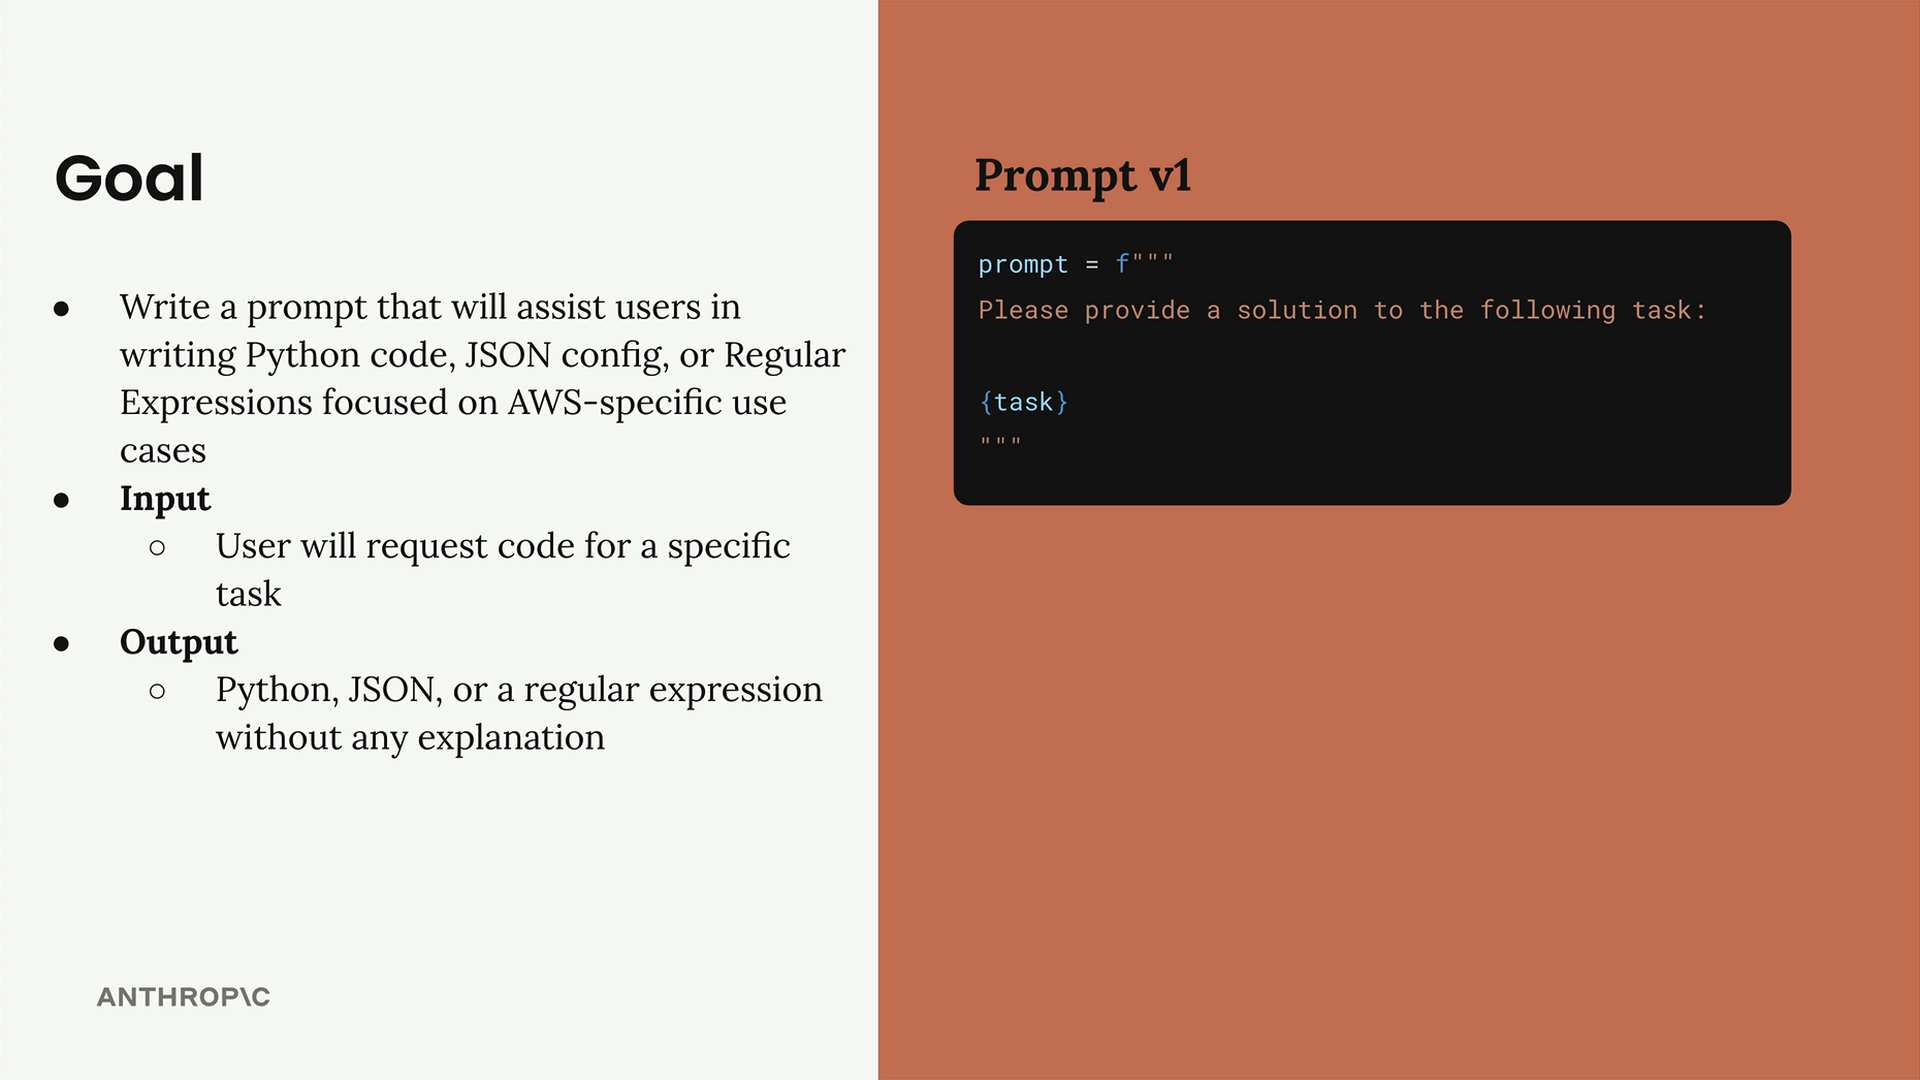
Mit einer einfachen ersten Version zu beginnen, hält die Sache überschaubar. Die erste Prompt-Vorlage ist unkompliziert: „Please provide a solution to the following task: {task}“
Evaluierungsdatensätze erstellen
Ein Evaluierungsdatensatz enthält Eingabebeispiele, die du in deinen Prompt einspeist. Jeder Testfall wird mit deinem Prompt kombiniert und an Claude gesendet, sodass du sehen kannst, wie gut der Prompt in unterschiedlichen Szenarien abschneidet.
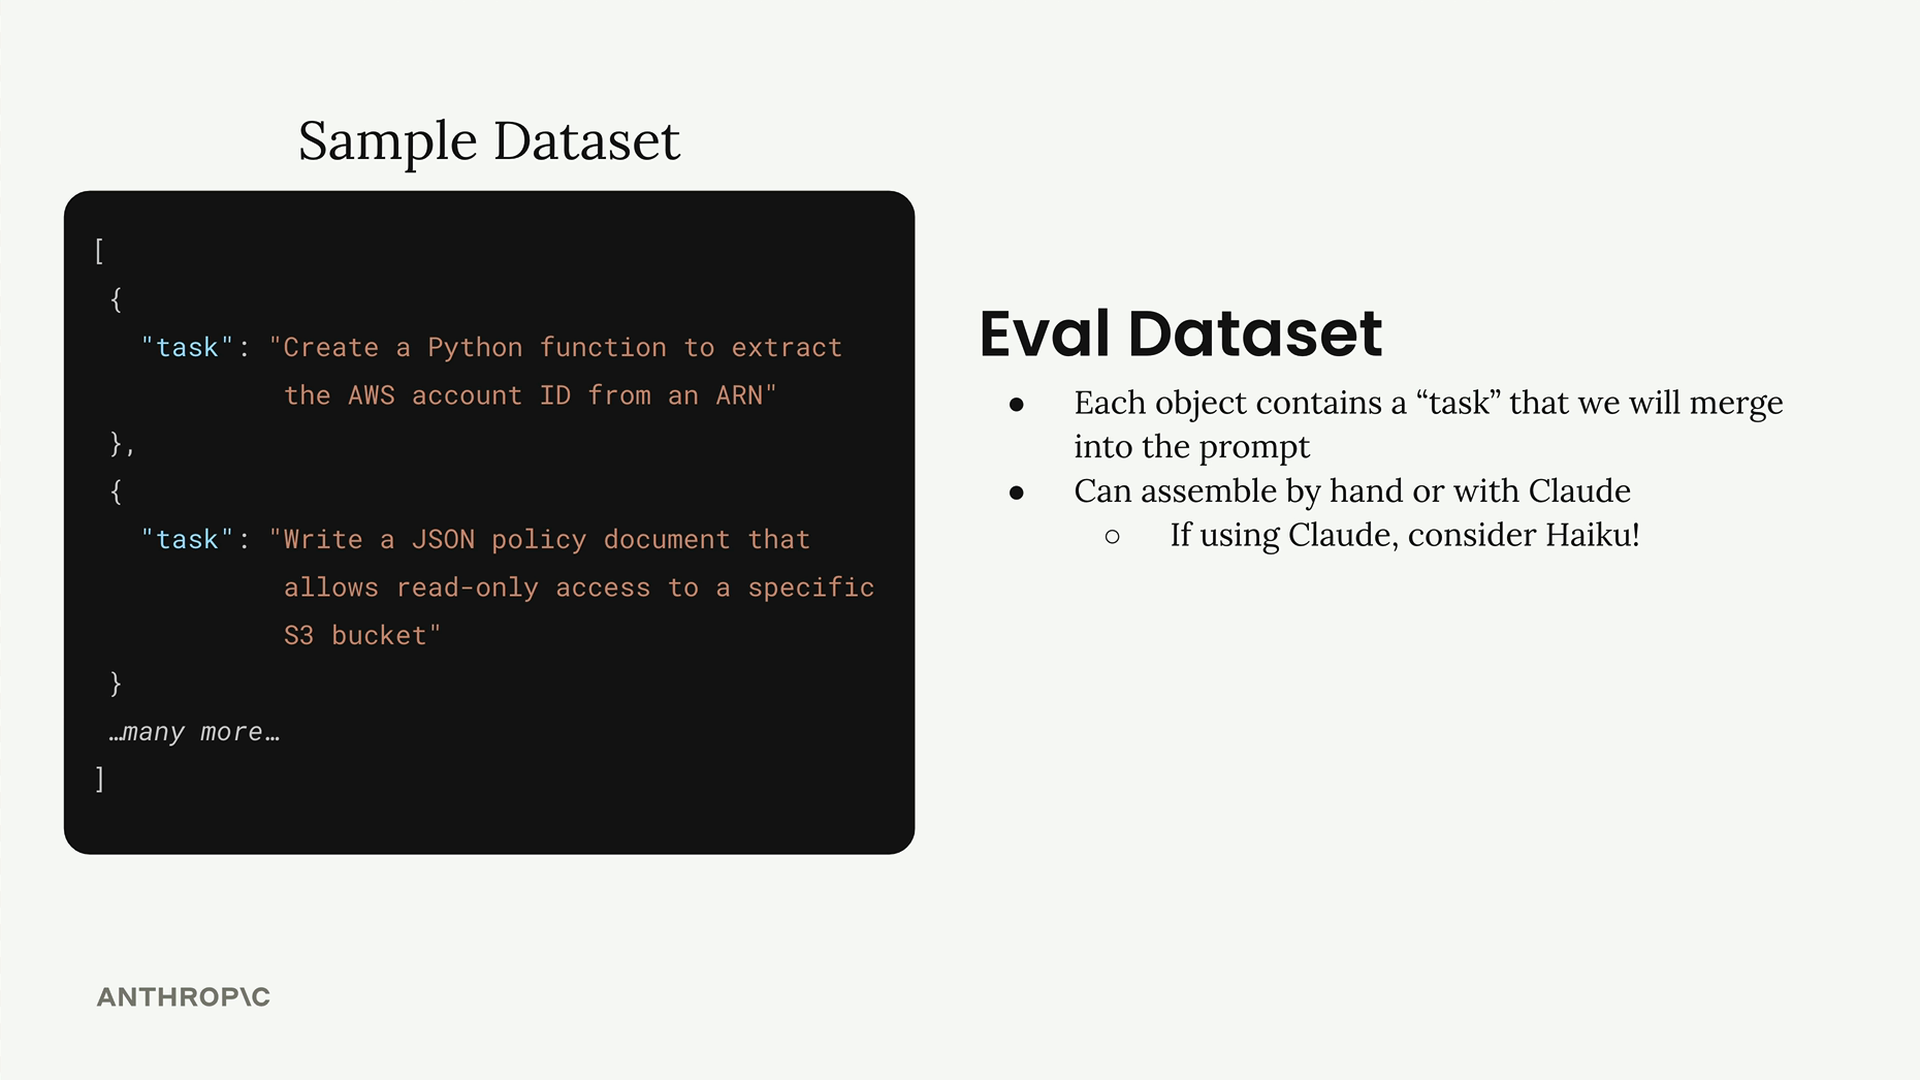
Du kannst Datensätze auf zwei Arten erstellen:
- Testfälle manuell von Hand schreiben
- Sie automatisch mithilfe von Claude generieren
Für die automatische Generierung ist die Verwendung eines schnelleren Modells wie Haiku sinnvoll, da du mehrere Testfälle generierst.
Testdaten mit Code generieren
Die Funktion zur Datensatzgenerierung verwendet Claude, um realistische Testszenarien zu erstellen. Hier ist die grundlegende Struktur:
def generate_dataset():
    prompt = """
    Generate 3 AWS-related tasks that require Python, JSON, or Regex solutions.

    Focus on tasks that can be solved by writing a single Python function,
    a single JSON object, or tasks that do not require writing much code.

    Example output:
    [
        {
            "task": "Description of task"
        },
        ...additional
    ]

    Please generate 3 objects.
    """

    messages = []
    add_user_message(messages, prompt)
    add_assistant_message(messages, "```json")
    text = chat(messages, stop_sequences=["```"])
    return json.loads(text)
Dieser Ansatz nutzt die Technik der vorausgefüllten Assistant-Nachricht mit Stoppsequenzen, um saubere JSON-Antworten zu extrahieren. Die Assistant-Nachricht beginnt mit ```json und stoppt bei der abschließenden ```, wodurch sichergestellt wird, dass du korrekt formatierte Daten erhältst.
Deinen Datensatz speichern
Speichere den Datensatz nach der Generierung, um ihn nicht ständig neu generieren zu müssen:
dataset = generate_dataset()
with open("dataset.json", "w") as f:
    json.dump(dataset, f, indent=2)
Der generierte Datensatz erstellt realistische AWS-Aufgaben wie das Extrahieren von Konto-IDs aus ARNs, das Schreiben von JSON-Schemas für EC2-Konfigurationen und das Erstellen von Regex-Mustern für S3-Bucket-Namen. Während drei Testfälle für die erste Entwicklung ausreichen, würde die Produktionsevaluierung deutlich mehr Beispiele mit größerer Vielfalt benötigen.
Diese Grundlage bietet dir einen wiederholbaren Prozess zur Erstellung von Evaluierungsdatensätzen, die auf deinen spezifischen Anwendungsfall abgestimmt sind, und bereitet die nächsten Schritte vor: die Durchführung von Evaluierungen und die Messung der Prompt-Leistung.