Wird geladen
Beim Erstellen von Anwendungen mit KI-Modellen musst du den Datenfluss von der Benutzereingabe bis zur von der KI generierten Antwort verstehen. Lass uns durchgehen, wie das mit AWS Bedrock funktioniert, und sehen, was hinter den Kulissen einer typischen Chat-Anwendung passiert.
Wie Chat-Anwendungen funktionieren
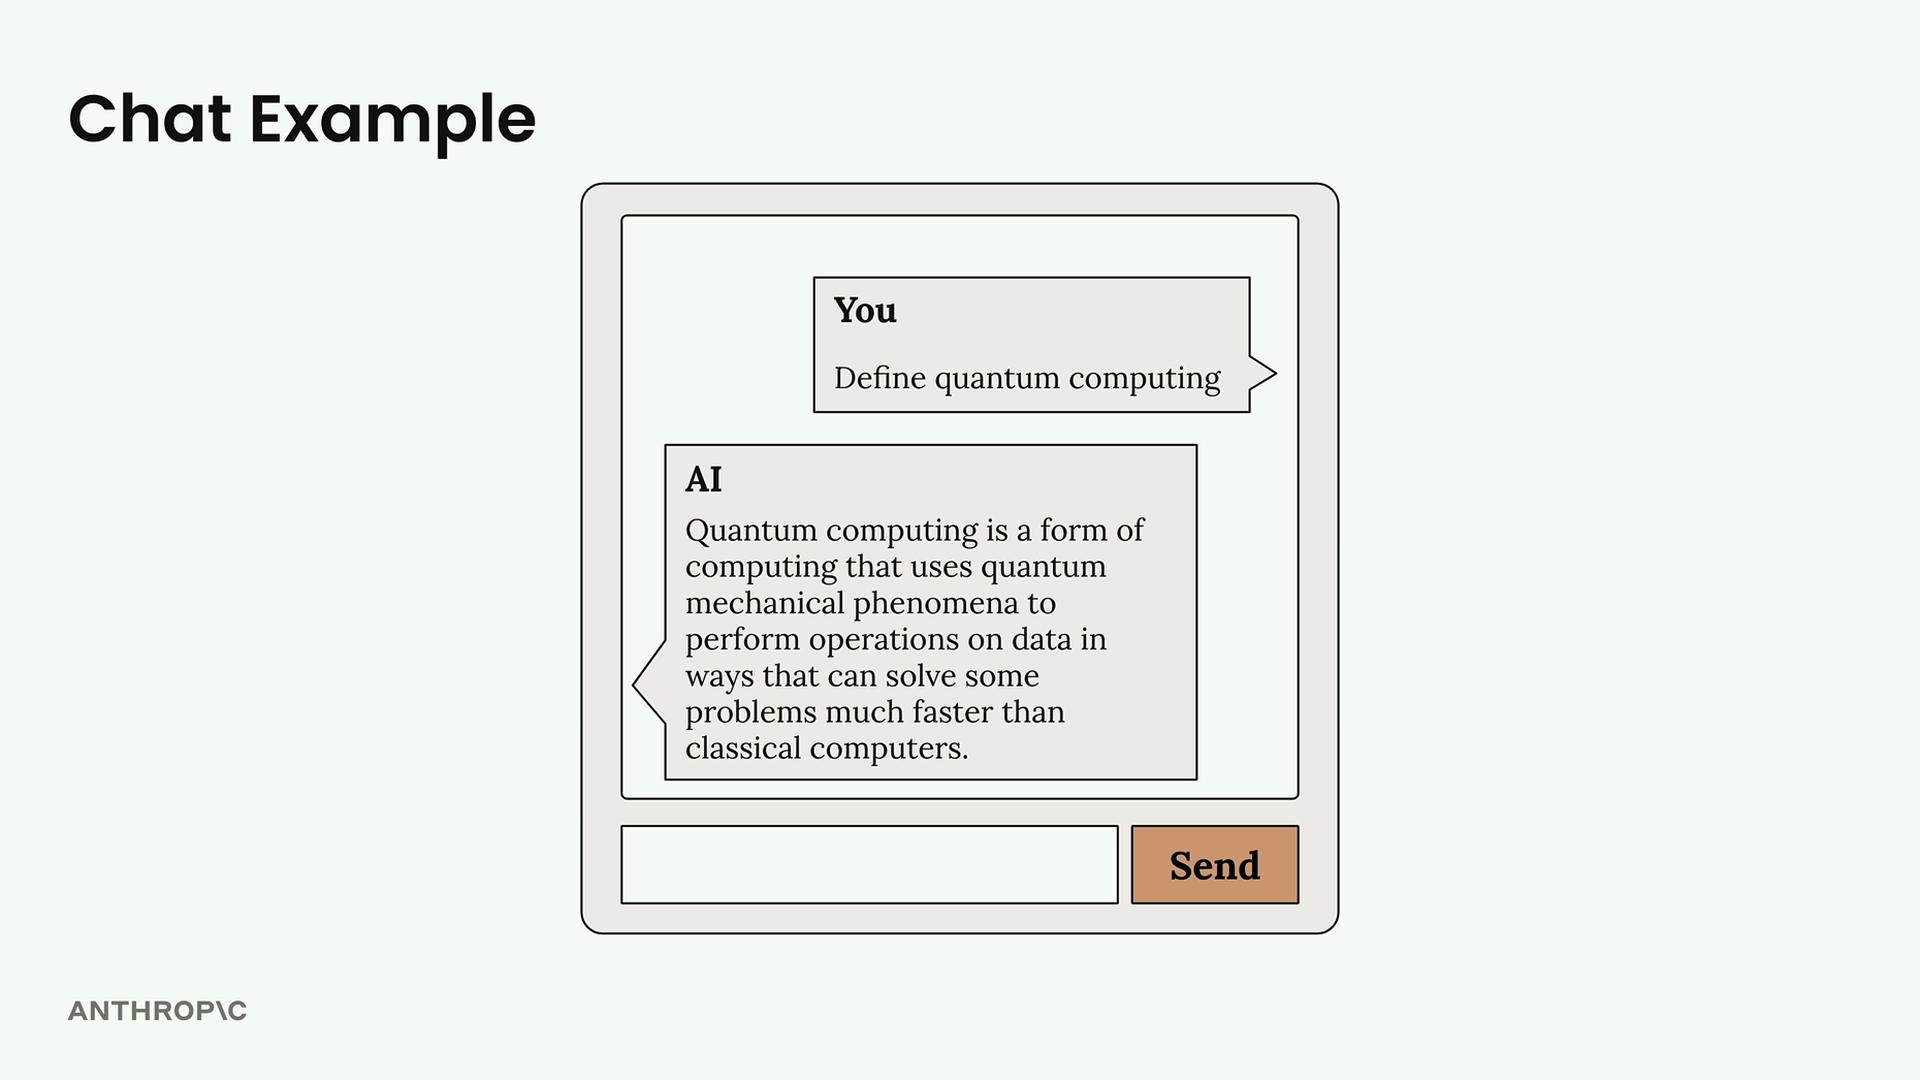
Stell dir vor, du erstellst eine Web-App mit einer einfachen Chat-Oberfläche. Ein Benutzer tippt „Definiere Quantencomputing“ und klickt auf „Senden“. Hier ist, was tatsächlich passiert:
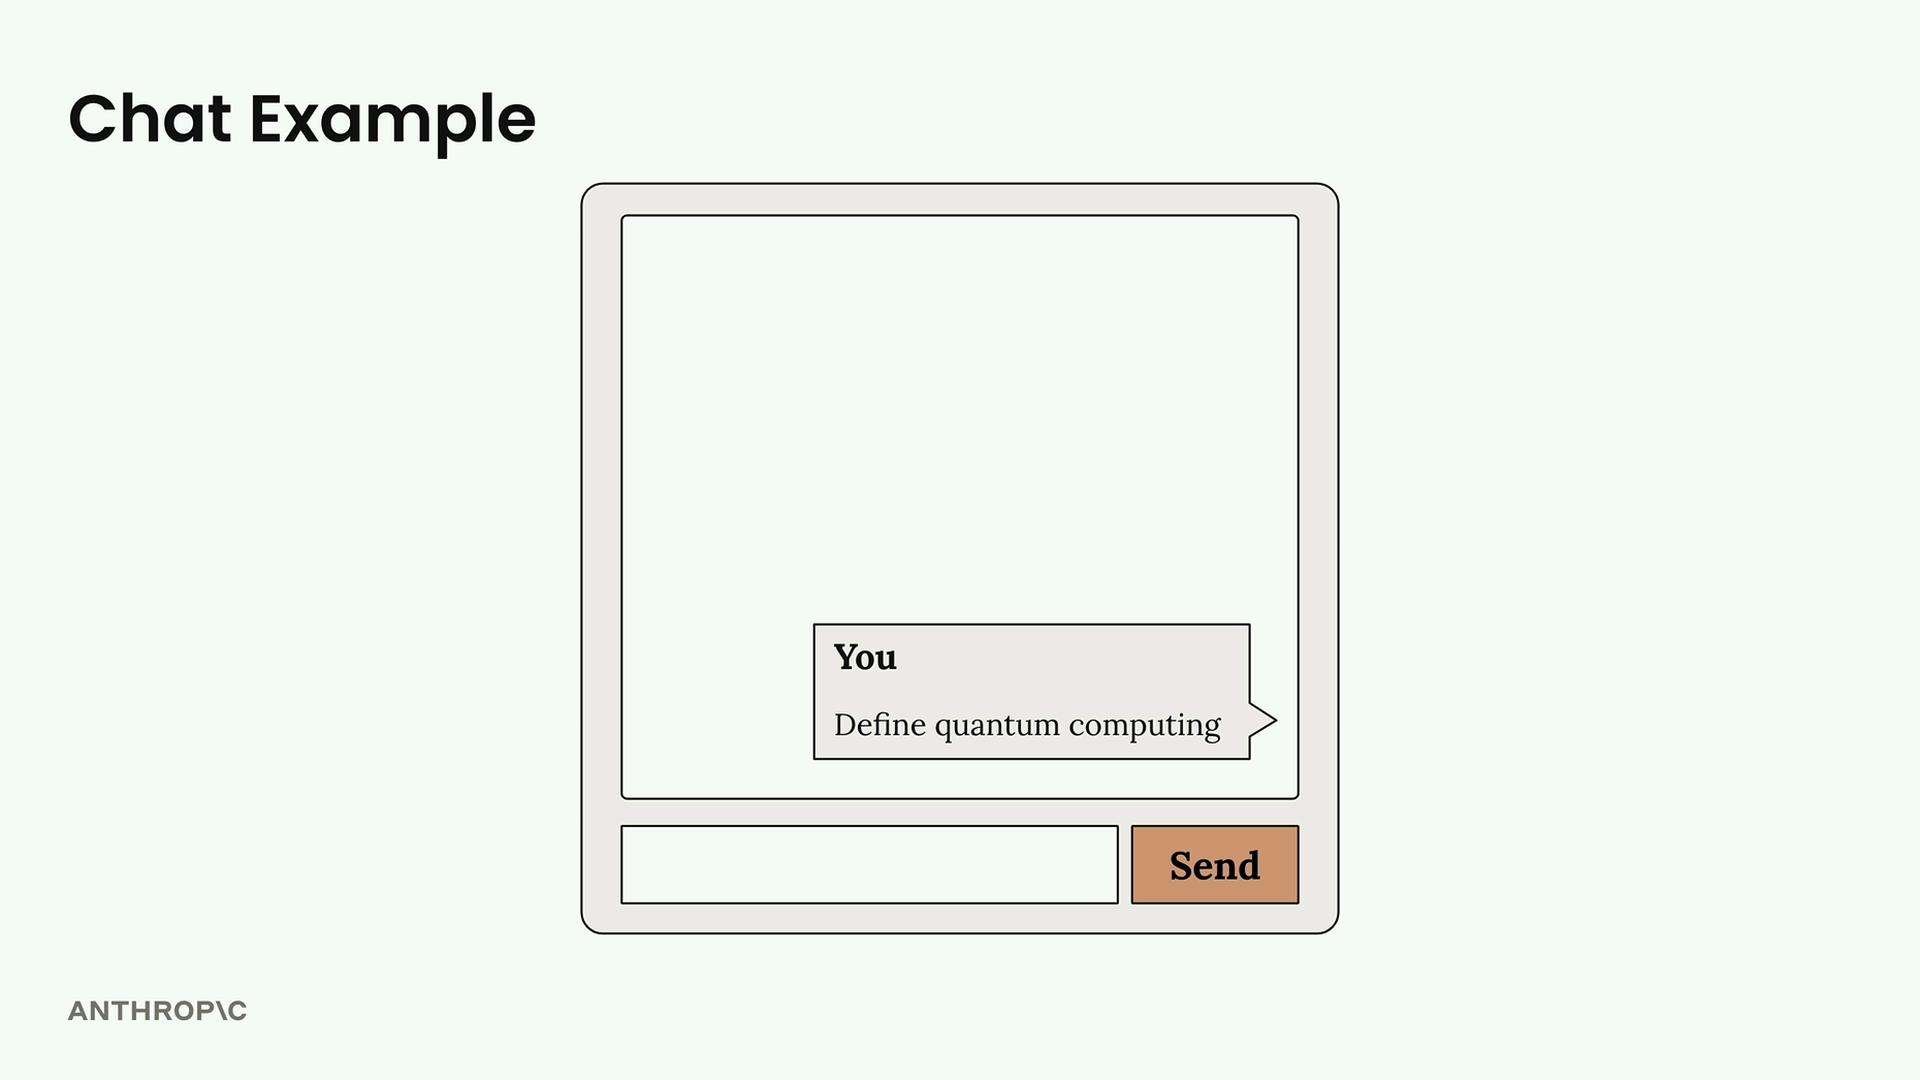
Der Benutzer sieht eine übersichtliche Oberfläche, aber dahinter arbeitet ein ganzes System, um diese Antwort zu erzeugen.
Der Anfrageablauf
Wenn ein Benutzer Text übermittelt, durchläuft diese Nachricht folgenden Weg:
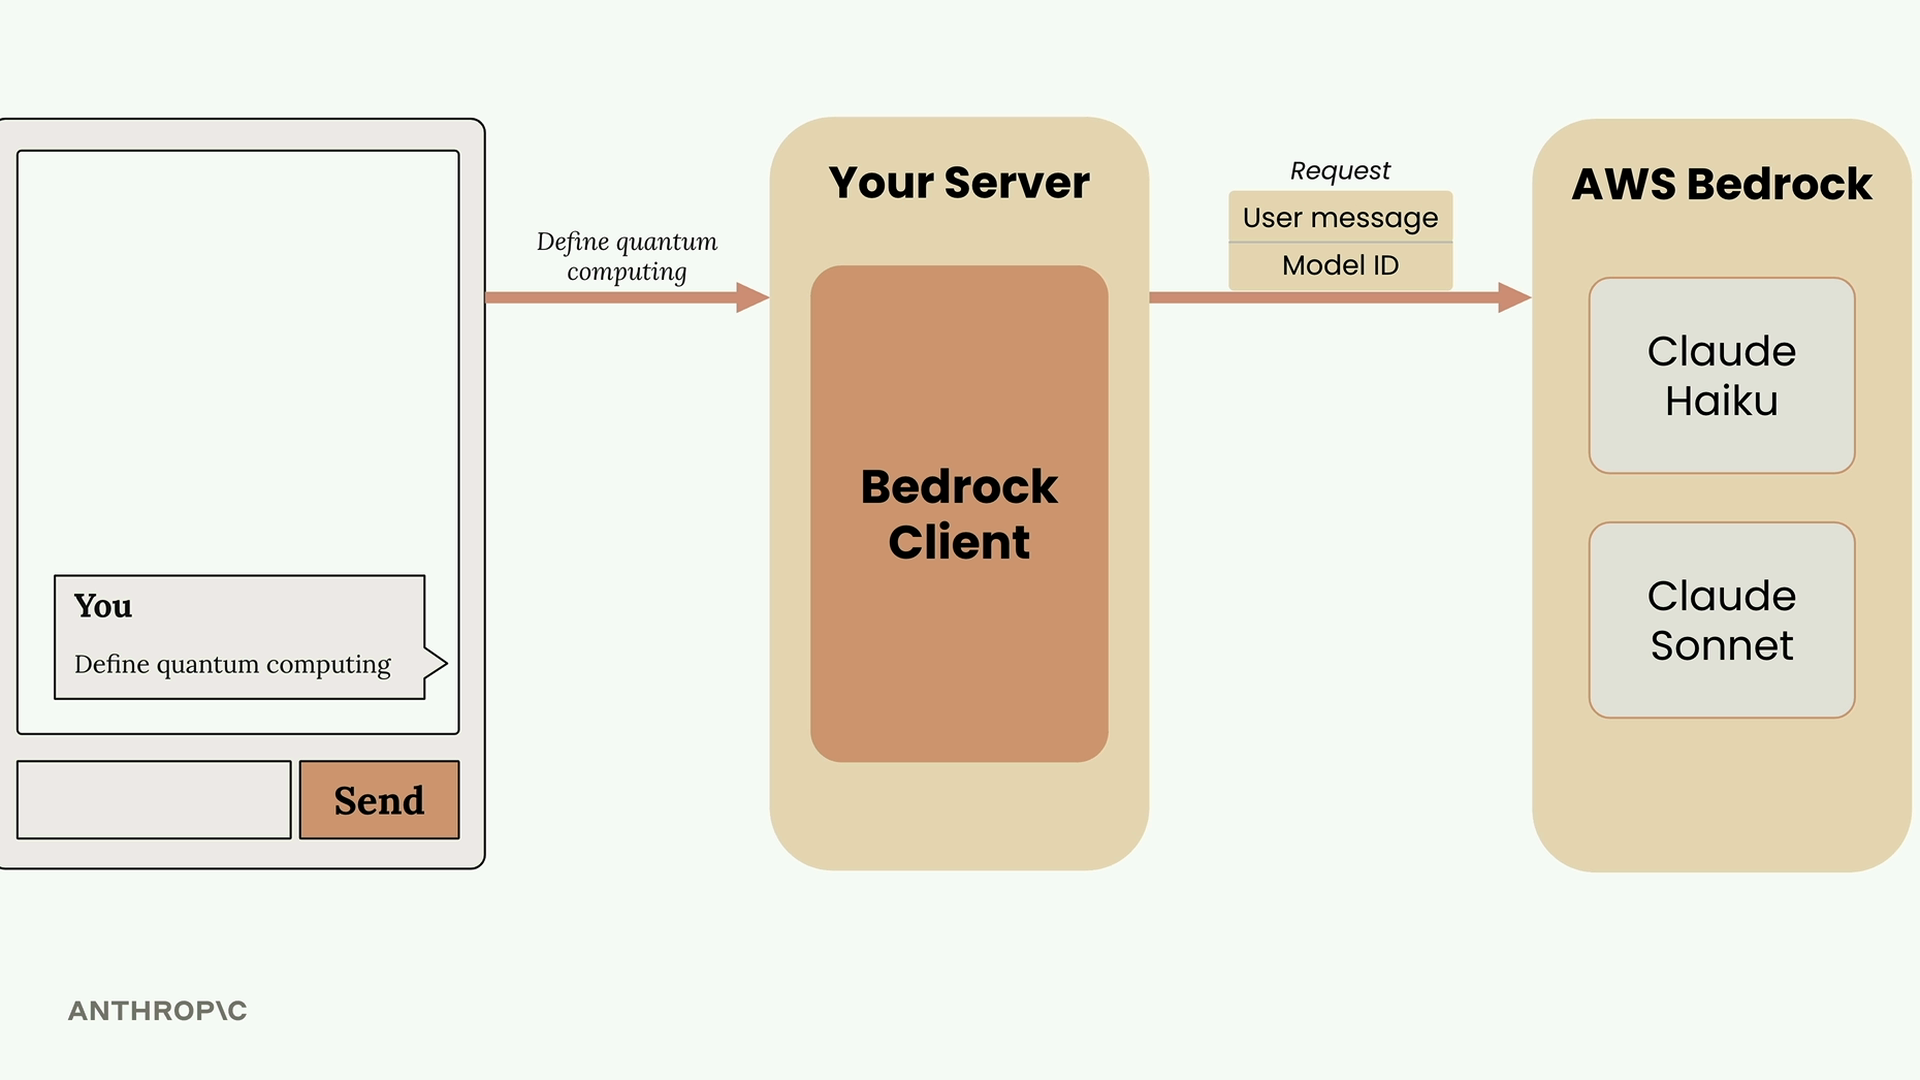
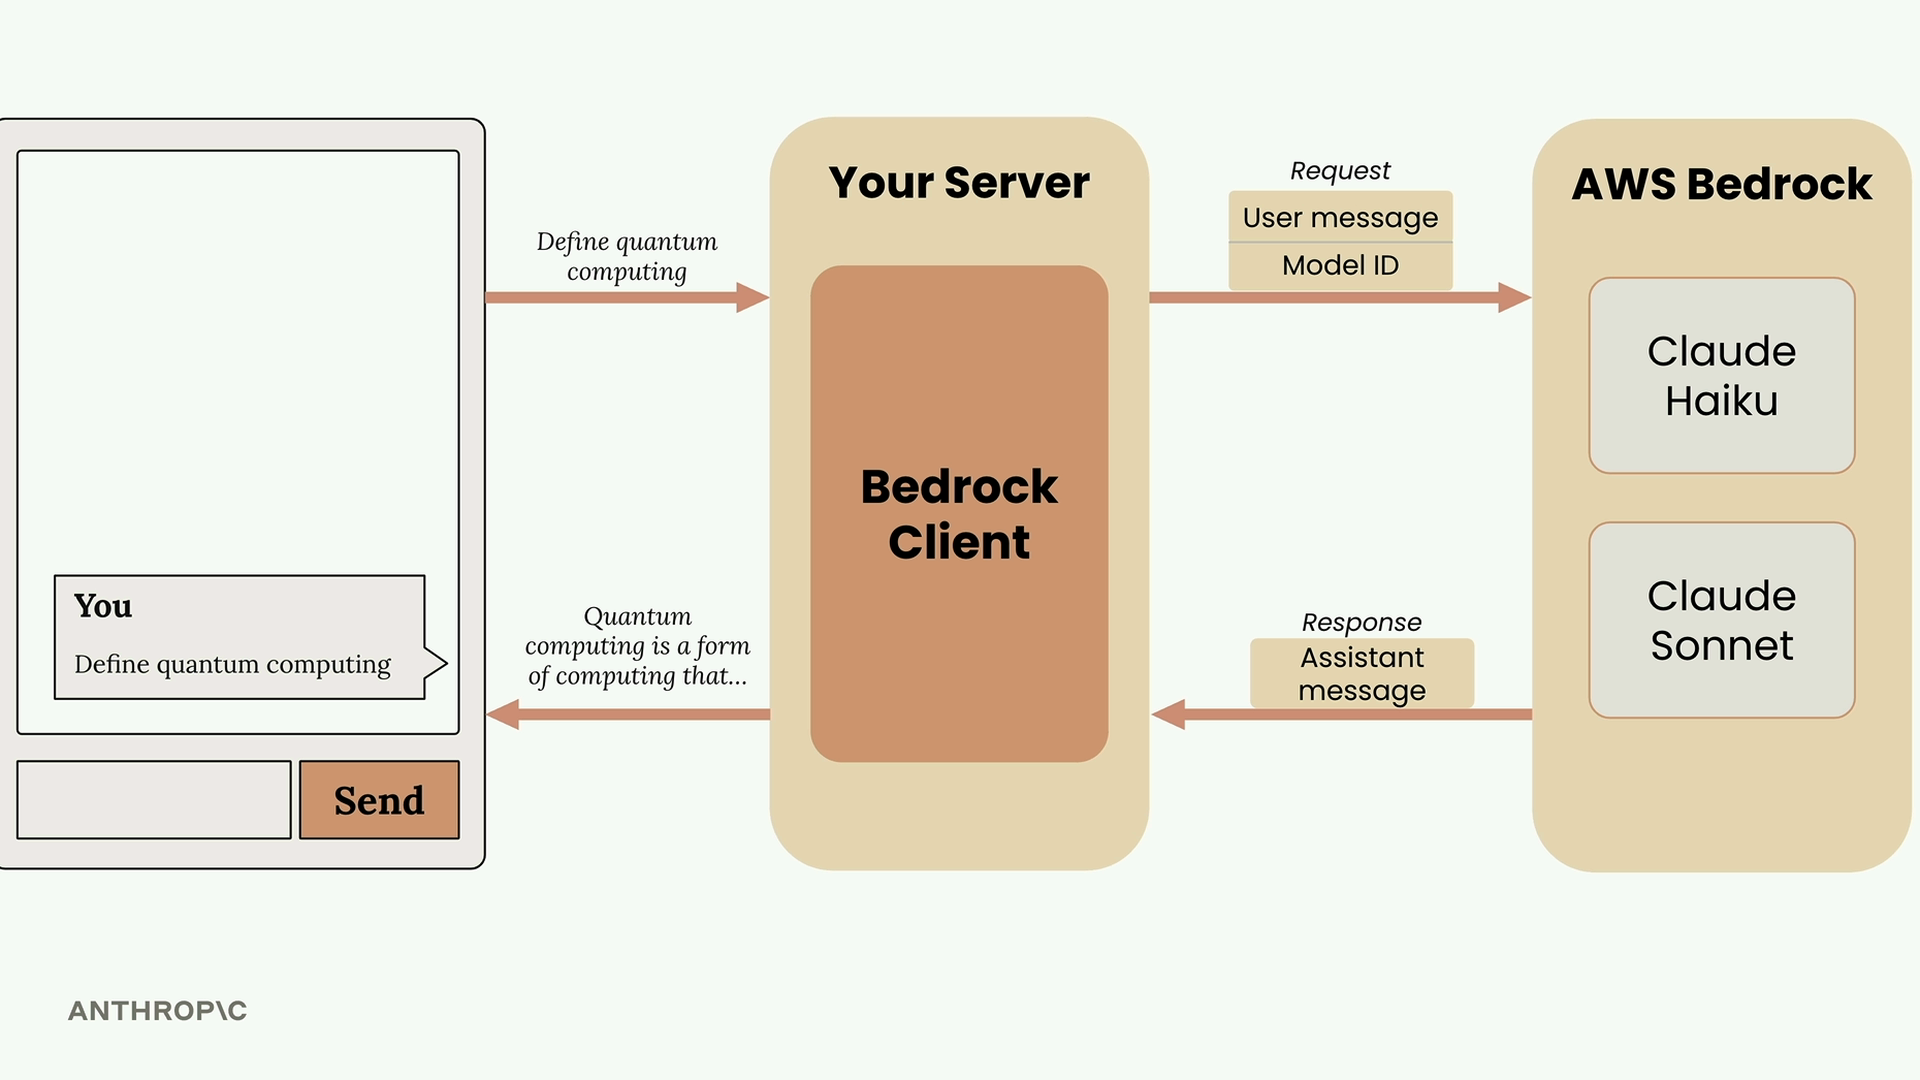
- Der Benutzer übermittelt seine Nachricht über deine Web-Oberfläche
- Dein Server empfängt die Anfrage mit diesem Text
- Dein Server verwendet den Bedrock-Client, um eine Anfrage an AWS Bedrock zu stellen
- Die Anfrage enthält die Benutzernachricht und eine Modell-ID (wie Claude Haiku oder Claude Sonnet)
- Das ausgewählte Modell verarbeitet die Anfrage und generiert Text
- AWS Bedrock sendet eine Assistentennachricht mit der generierten Antwort zurück
- Dein Server leitet diese Antwort an den Browser des Benutzers weiter