Wenn du mit Claude arbeitest, ist das Schreiben eines guten Prompts nur der Anfang. Um zuverlässige KI-Anwendungen zu entwickeln, musst du zwei entscheidende Konzepte verstehen: Prompt-Engineering und Prompt-Evaluierung. Prompt-Engineering gibt dir Techniken an die Hand, um bessere Prompts zu erstellen, während dir Prompt-Evaluierung hilft zu messen, wie gut diese Prompts tatsächlich funktionieren.
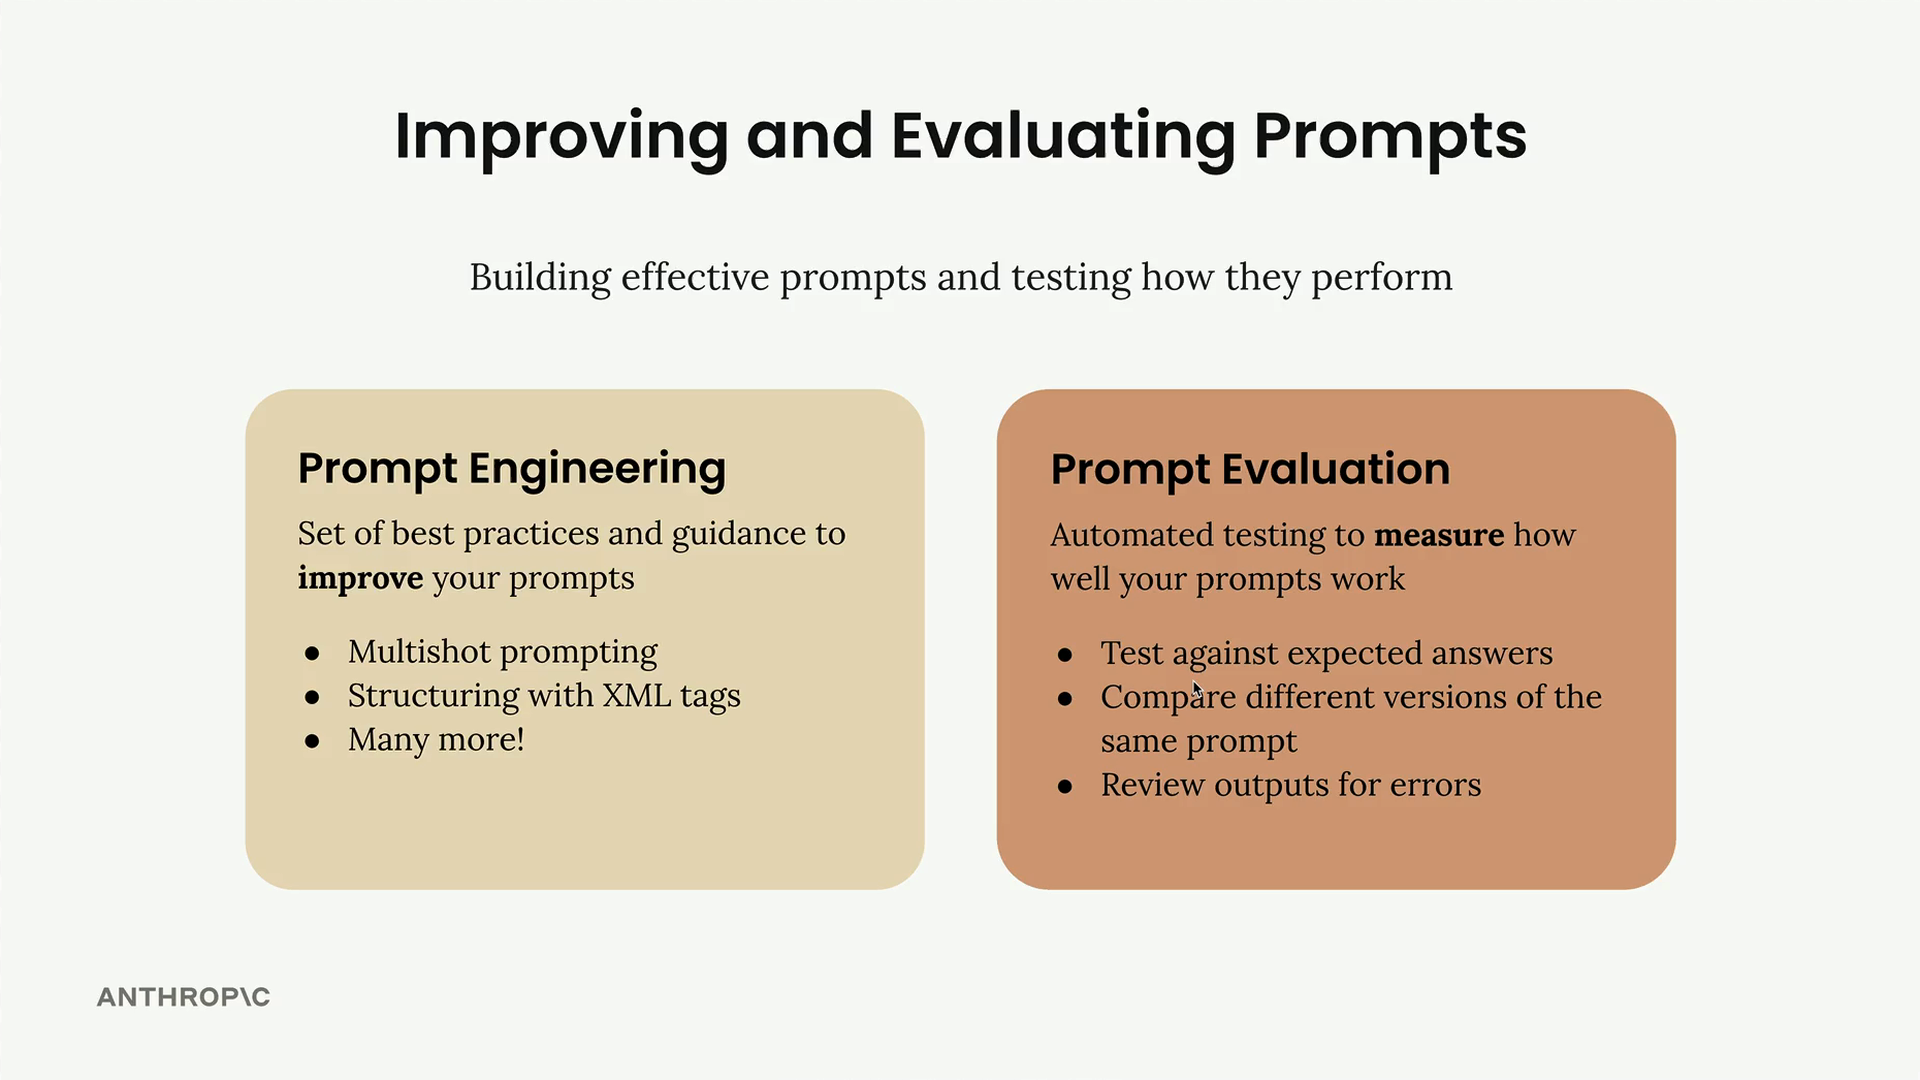
Prompt-Engineering vs. Prompt-Evaluierung
Prompt-Engineering ist dein Werkzeugkasten zum Schreiben und Verbessern von Prompts. Es handelt sich um eine Reihe von Best Practices, die Claude helfen, genau zu verstehen, wonach du fragst und wie du möchtest, dass Claude antwortet. Betrachte es als das Handwerk des Prompt-Schreibens – Techniken wie Multishot-Prompting, Strukturierung mit XML-Tags und viele weitere Ansätze, die wir uns ansehen werden.
Prompt-Evaluierung hingegen dreht sich um Messung. Es handelt sich um automatisiertes Testen, das dir objektive Metriken dazu liefert, ob deine Prompts tatsächlich wirksam sind. Anstatt zu raten, ob dein Prompt gut funktioniert, ermöglicht dir die Evaluierung:
- Gegen erwartete Antworten testen
- Verschiedene Versionen desselben Prompts vergleichen
- Ausgaben auf Fehler überprüfen
Die drei Wege nach dem Schreiben eines Prompts
Sobald du einen Prompt entworfen hast, stehen dir in der Regel drei Optionen für das weitere Vorgehen zur Verfügung:
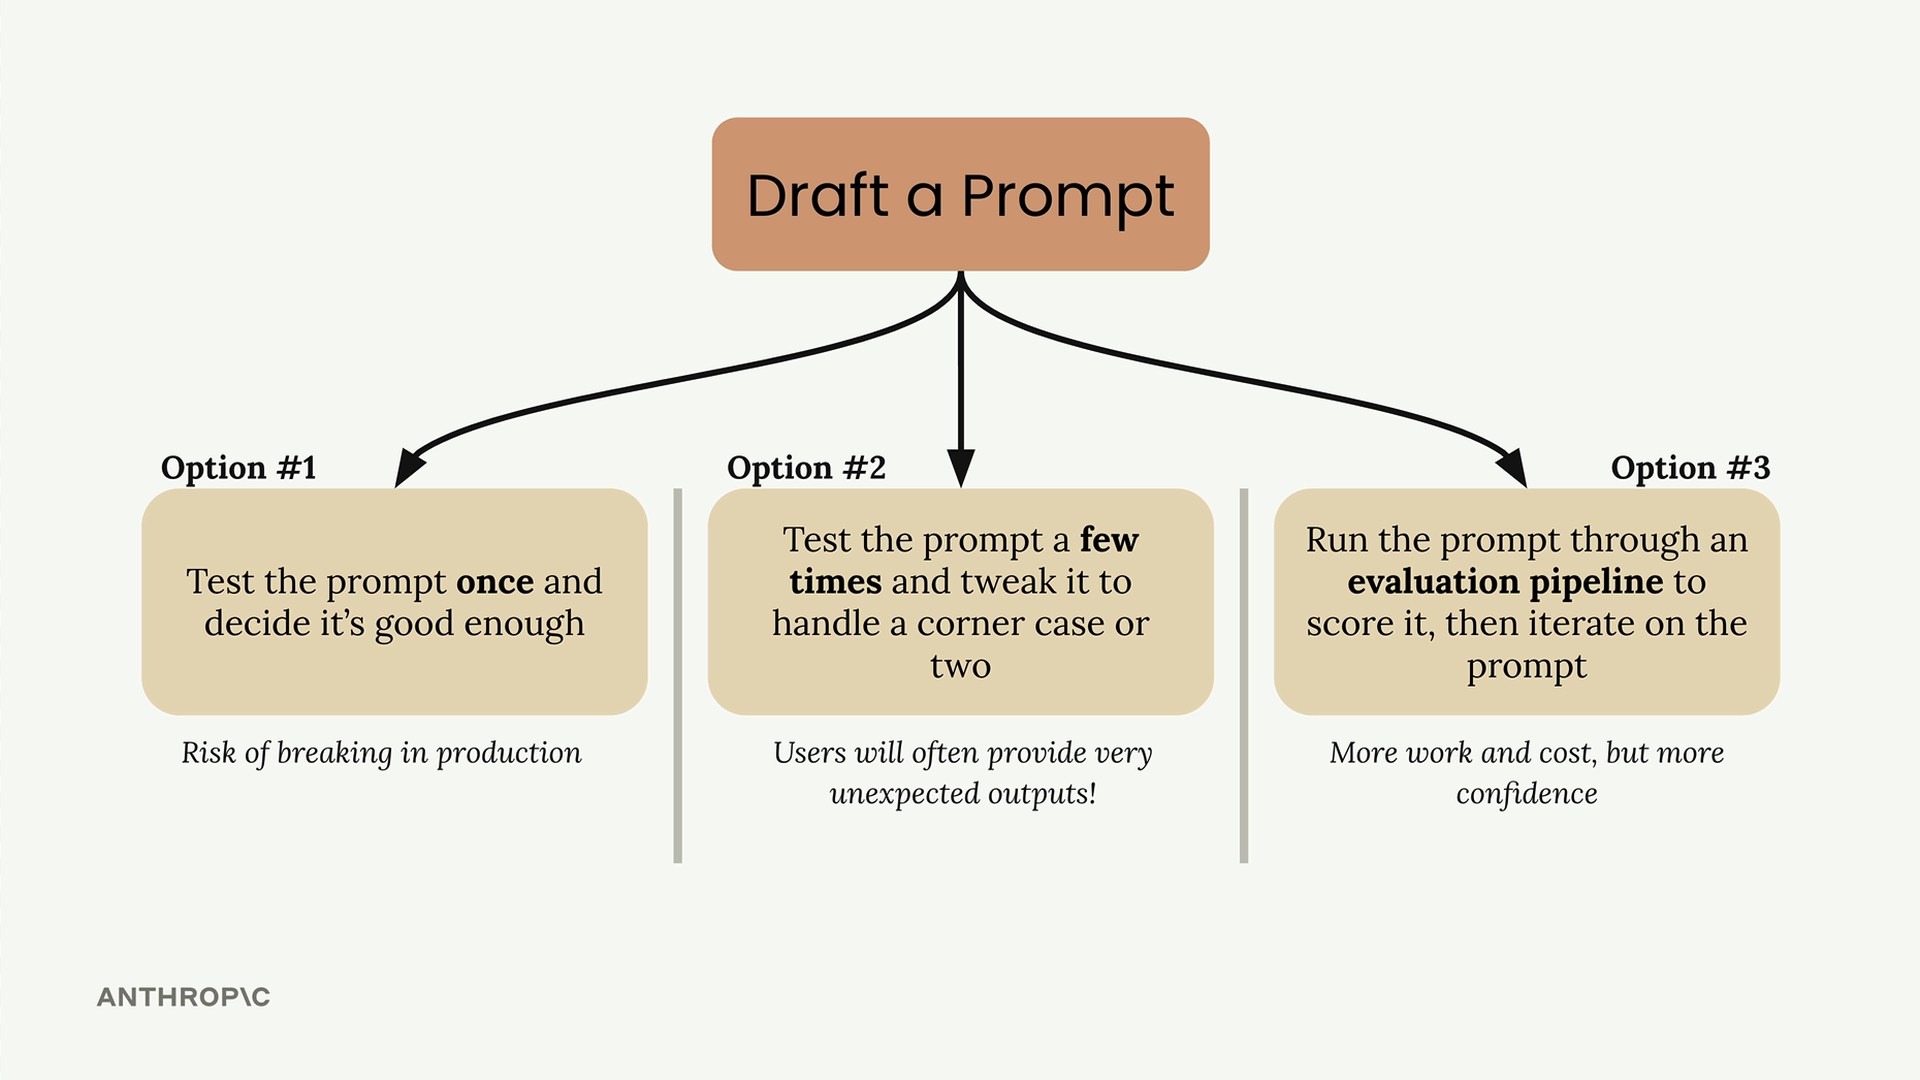
Option 1: Den Prompt einmal testen und entscheiden, dass er gut genug ist. Dies birgt ein erhebliches Risiko, dass er in der Produktion versagt, wenn Nutzer unerwartete Eingaben liefern.
Option 2: Den Prompt einige Male testen und ihn anpassen, um ein oder zwei Randfälle zu behandeln. Das ist zwar besser als Option 1, doch dieser Ansatz lässt dich weiterhin verwundbar, da Nutzer oft sehr unerwartete Ausgaben liefern, die du nicht bedacht hast.
Option 3: Den Prompt durch eine Evaluierungspipeline laufen lassen, um ihn zu bewerten, und dann den Prompt basierend auf objektiven Daten iterieren. Das erfordert im Vorfeld mehr Arbeit und Kosten, gibt dir aber deutlich mehr Vertrauen in die Zuverlässigkeit deines Prompts.
Warum die meisten Engineers in Testfallen tappen
Die Optionen 1 und 2 sind Fallen, in die alle Engineers tappen, mich selbst eingeschlossen. Es ist natürlich, einen Prompt für eine ernsthafte Anwendung zu schreiben und ihn nicht gründlich genug zu testen. Wir neigen dazu, mit Eingaben zu testen, die uns offensichtlich erscheinen, aber echte Nutzer werden mit deinen Prompts auf Weisen interagieren, die du nie vorhergesehen hast.
Die Lösung besteht darin, Option 3 zu nutzen: systematische Evaluierung. Indem du deine Prompts durch geeignete Evaluierungspipelines laufen lässt, erhältst du objektive Bewertungen, die dir zeigen, wie gut dein Prompt über ein breites Spektrum von Szenarien hinweg abschneidet. Dieser datengetriebene Ansatz lässt dich selbstbewusst iterieren und Probleme erkennen, bevor sie die Produktion erreichen.
Wenn du die Evaluierung zuerst verstehst, erhältst du die Grundlage, um Verbesserungen zu messen, während du Prompt-Engineering-Techniken anwendest. Sobald du die Wirksamkeit eines Prompts zuverlässig messen kannst, kannst du mit verschiedenen Ansätzen experimentieren und definitiv wissen, welche besser funktionieren.