Prompt-Caching ist eine Funktion, die Claudes Antworten beschleunigt und die Kosten der Textgenerierung senkt, indem sie rechnerische Arbeit aus früheren Anfragen wiederverwendet. Um zu verstehen, wie das funktioniert, schauen wir uns zunächst an, was normalerweise intern bei Claude während einer typischen Anfrage passiert.
Wie Claude Anfragen normalerweise verarbeitet
Wenn du Claude eine Nachricht sendest, passiert im Hintergrund eine Menge, bevor du eine Antwort zurückbekommst. Claude beginnt nicht einfach sofort damit, Text zu generieren – zuerst leistet es umfangreiche Arbeit an deiner Eingabenachricht.
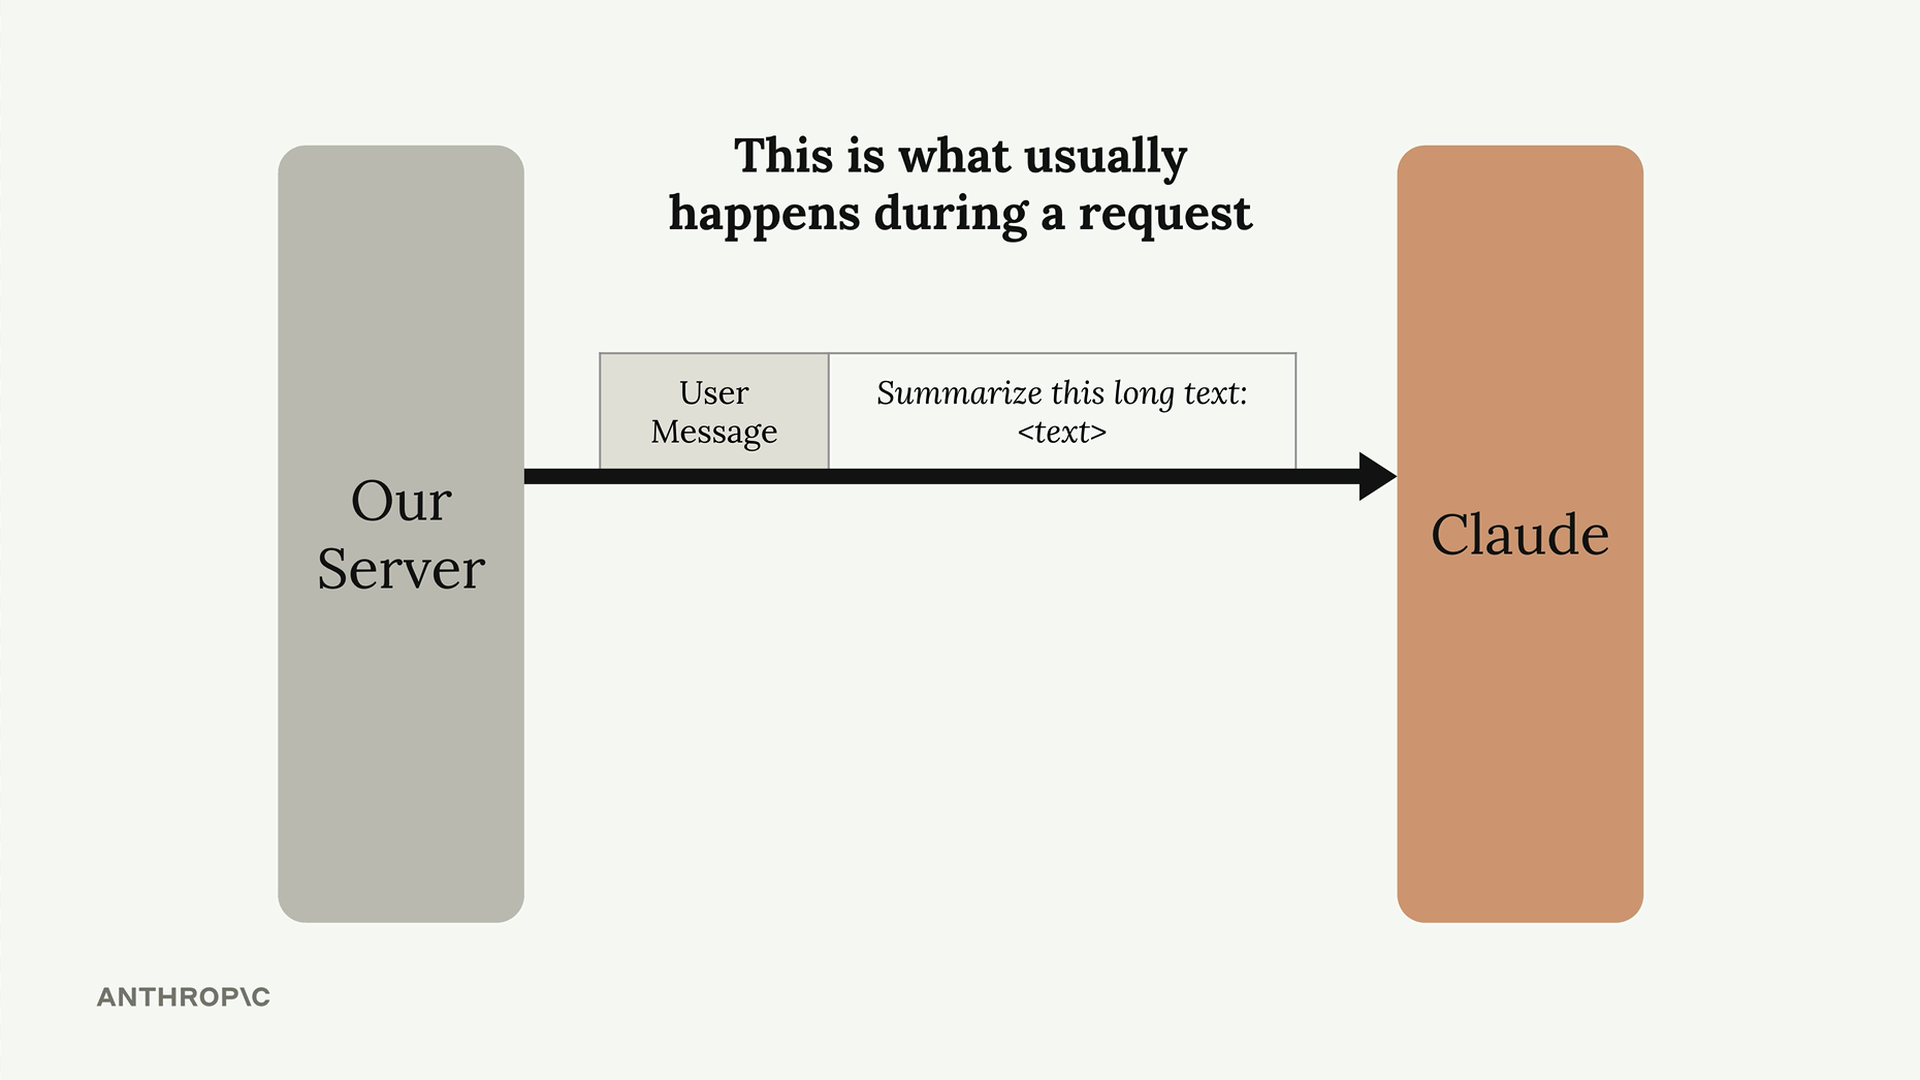
So geht Claude mit deiner Nachricht um:
- Den Prompt tokenisieren
- Embeddings für jedes Token erstellen
- Kontext basierend auf umgebendem Text hinzufügen
- Ausgabetext generieren
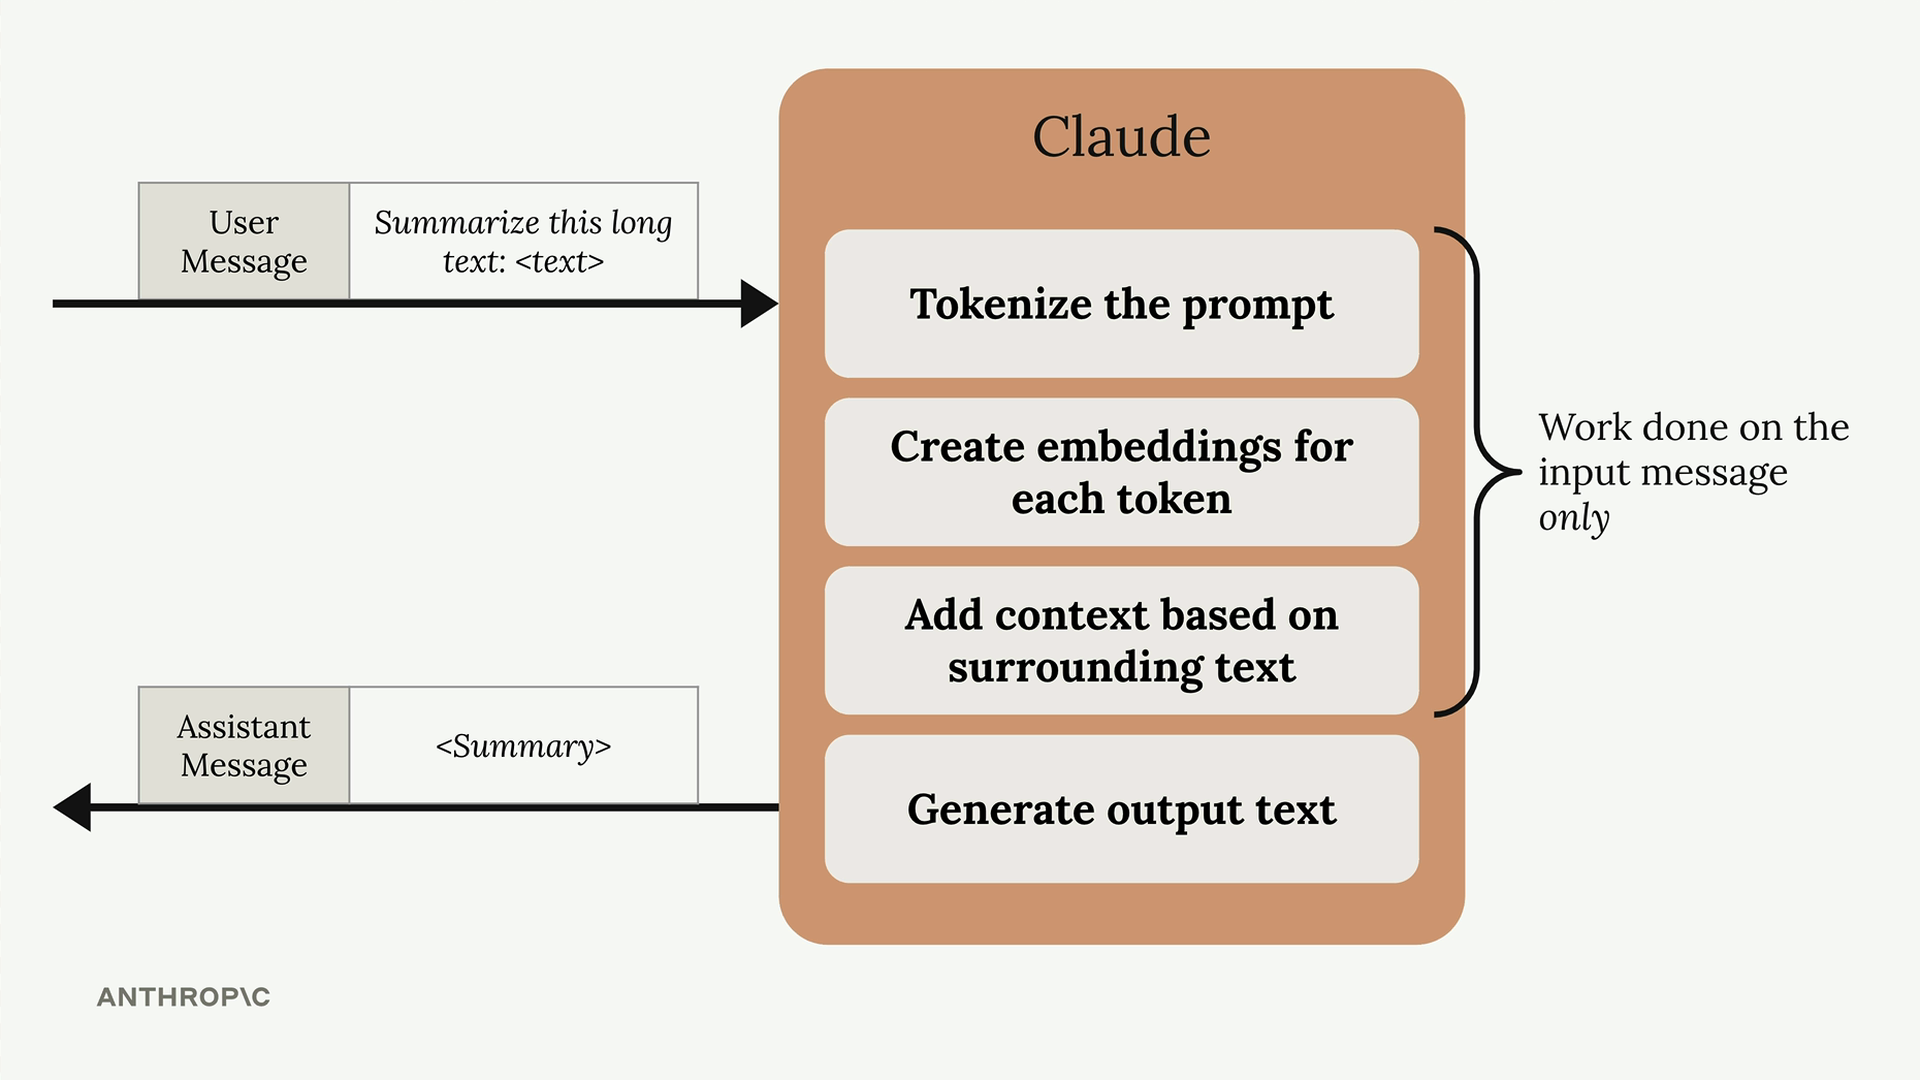
Diese gesamte Vorverarbeitung erfolgt, bevor Claude eine tatsächliche Antwort generiert. Sobald Claude die Verarbeitung deiner Anfrage abgeschlossen und die Antwort zurückgesendet hat, verwirft es die gesamte rechnerische Arbeit, die es gerade geleistet hat.
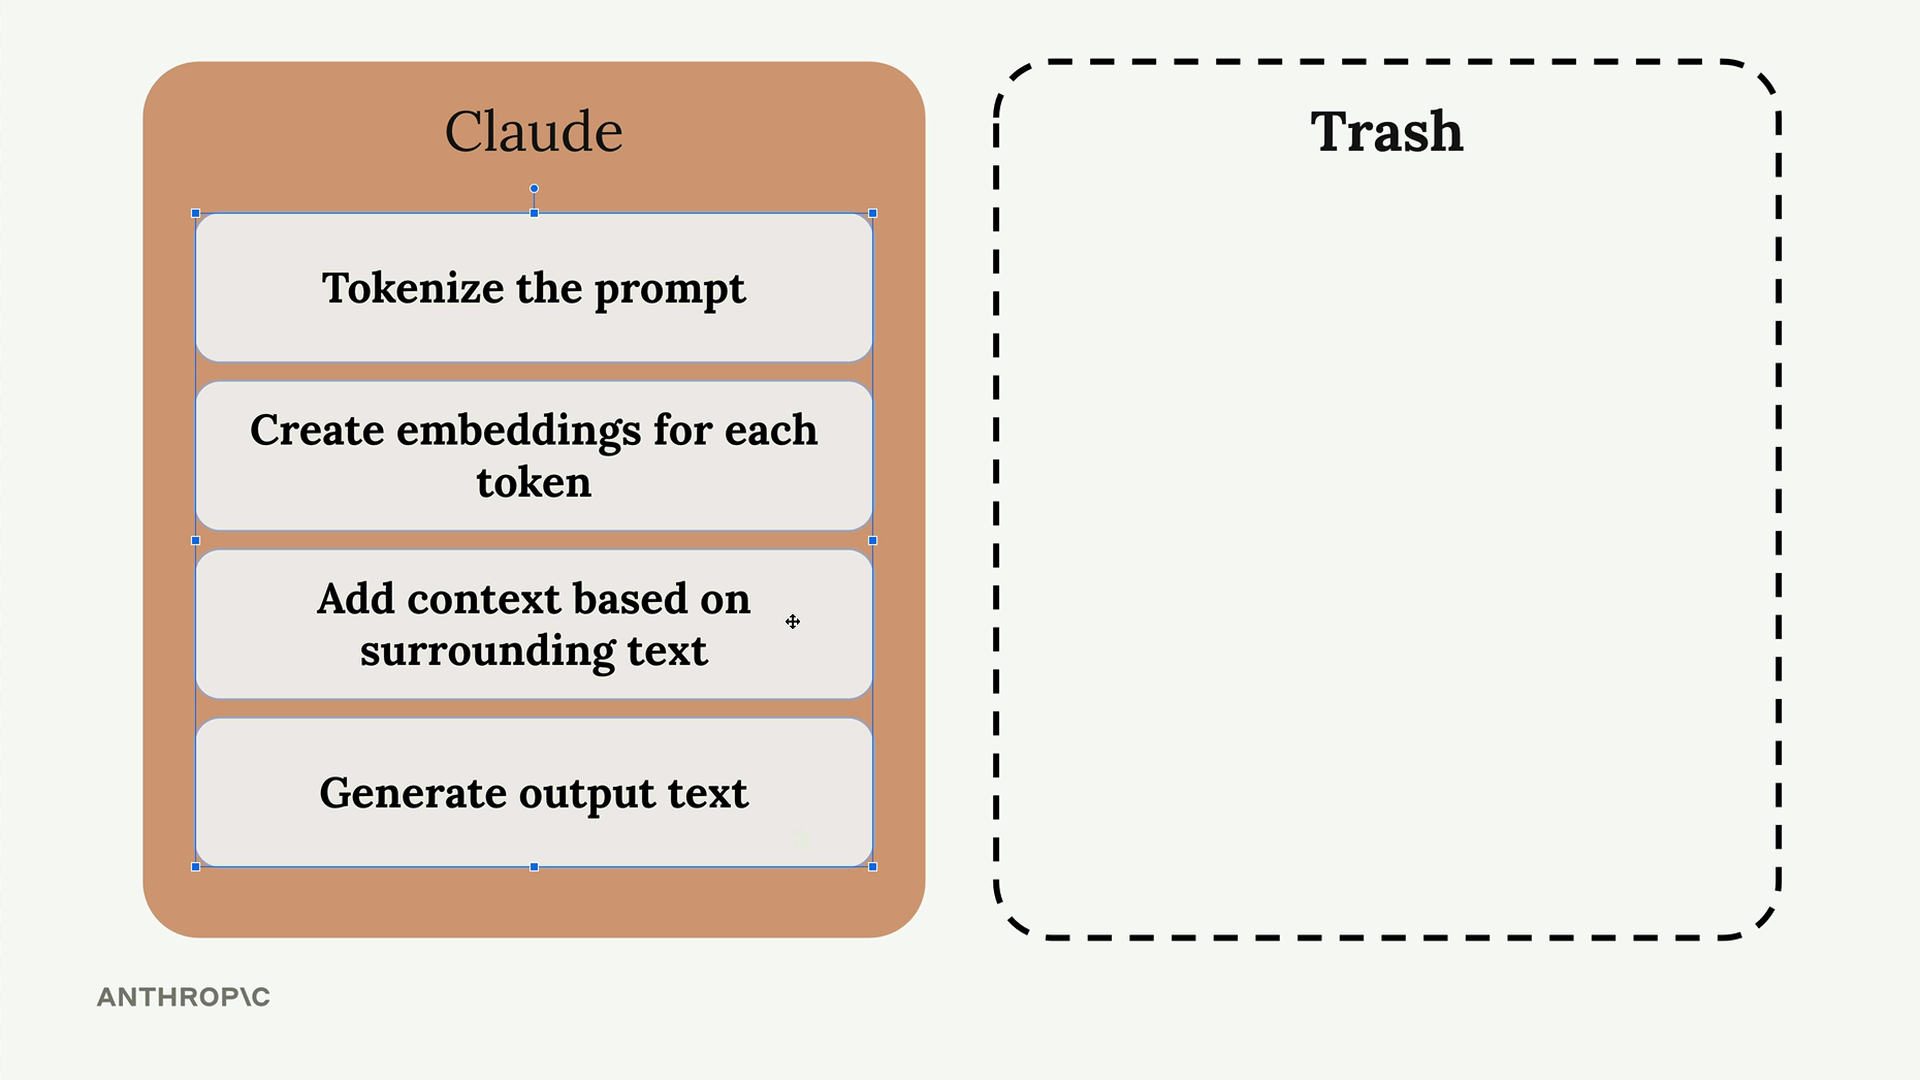
Das Problem beim Verwerfen von Arbeit
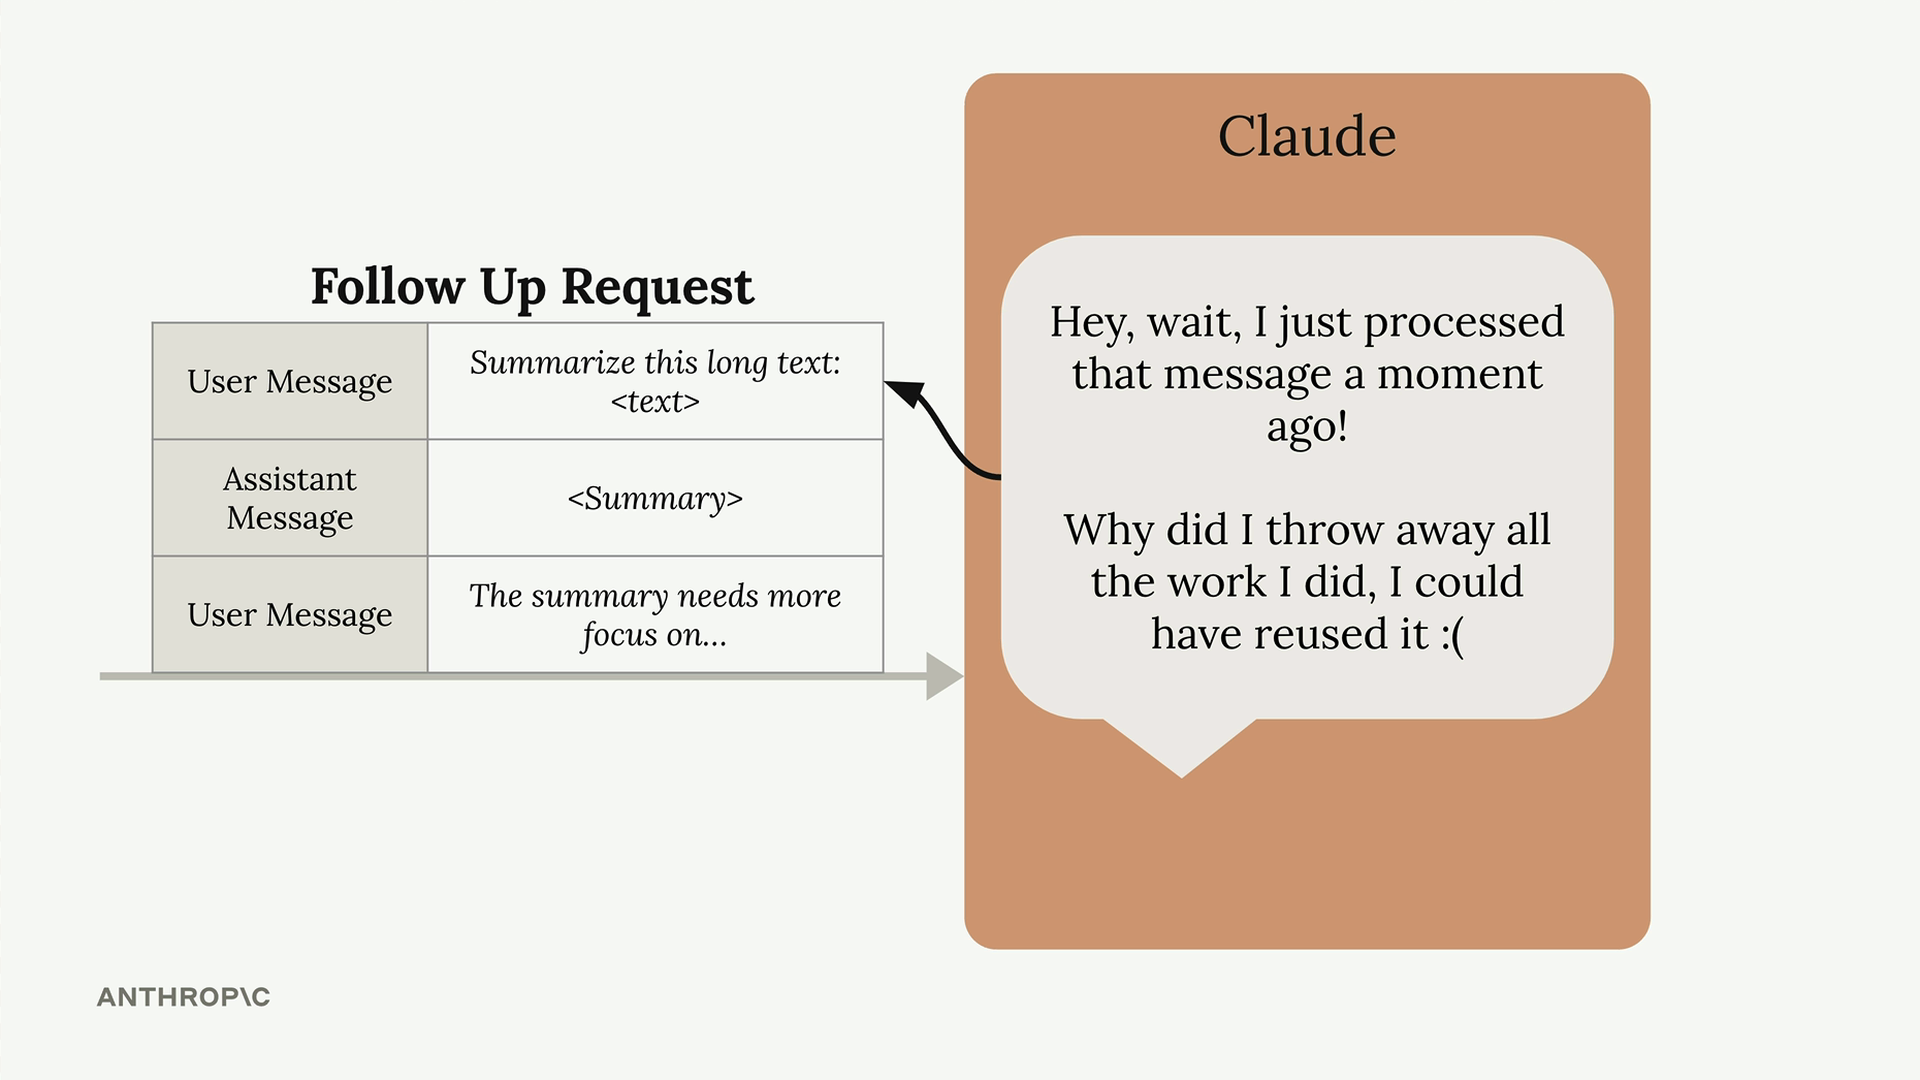
Dies führt zu einer Ineffizienz, wenn du Gespräche mit Claude führst. Nehmen wir an, du stellst eine Folgeanfrage, die dieselbe Nachricht von vorhin enthält, plus Claudes vorherige Antwort, plus eine neue Nachricht, um das Gespräch fortzusetzen.
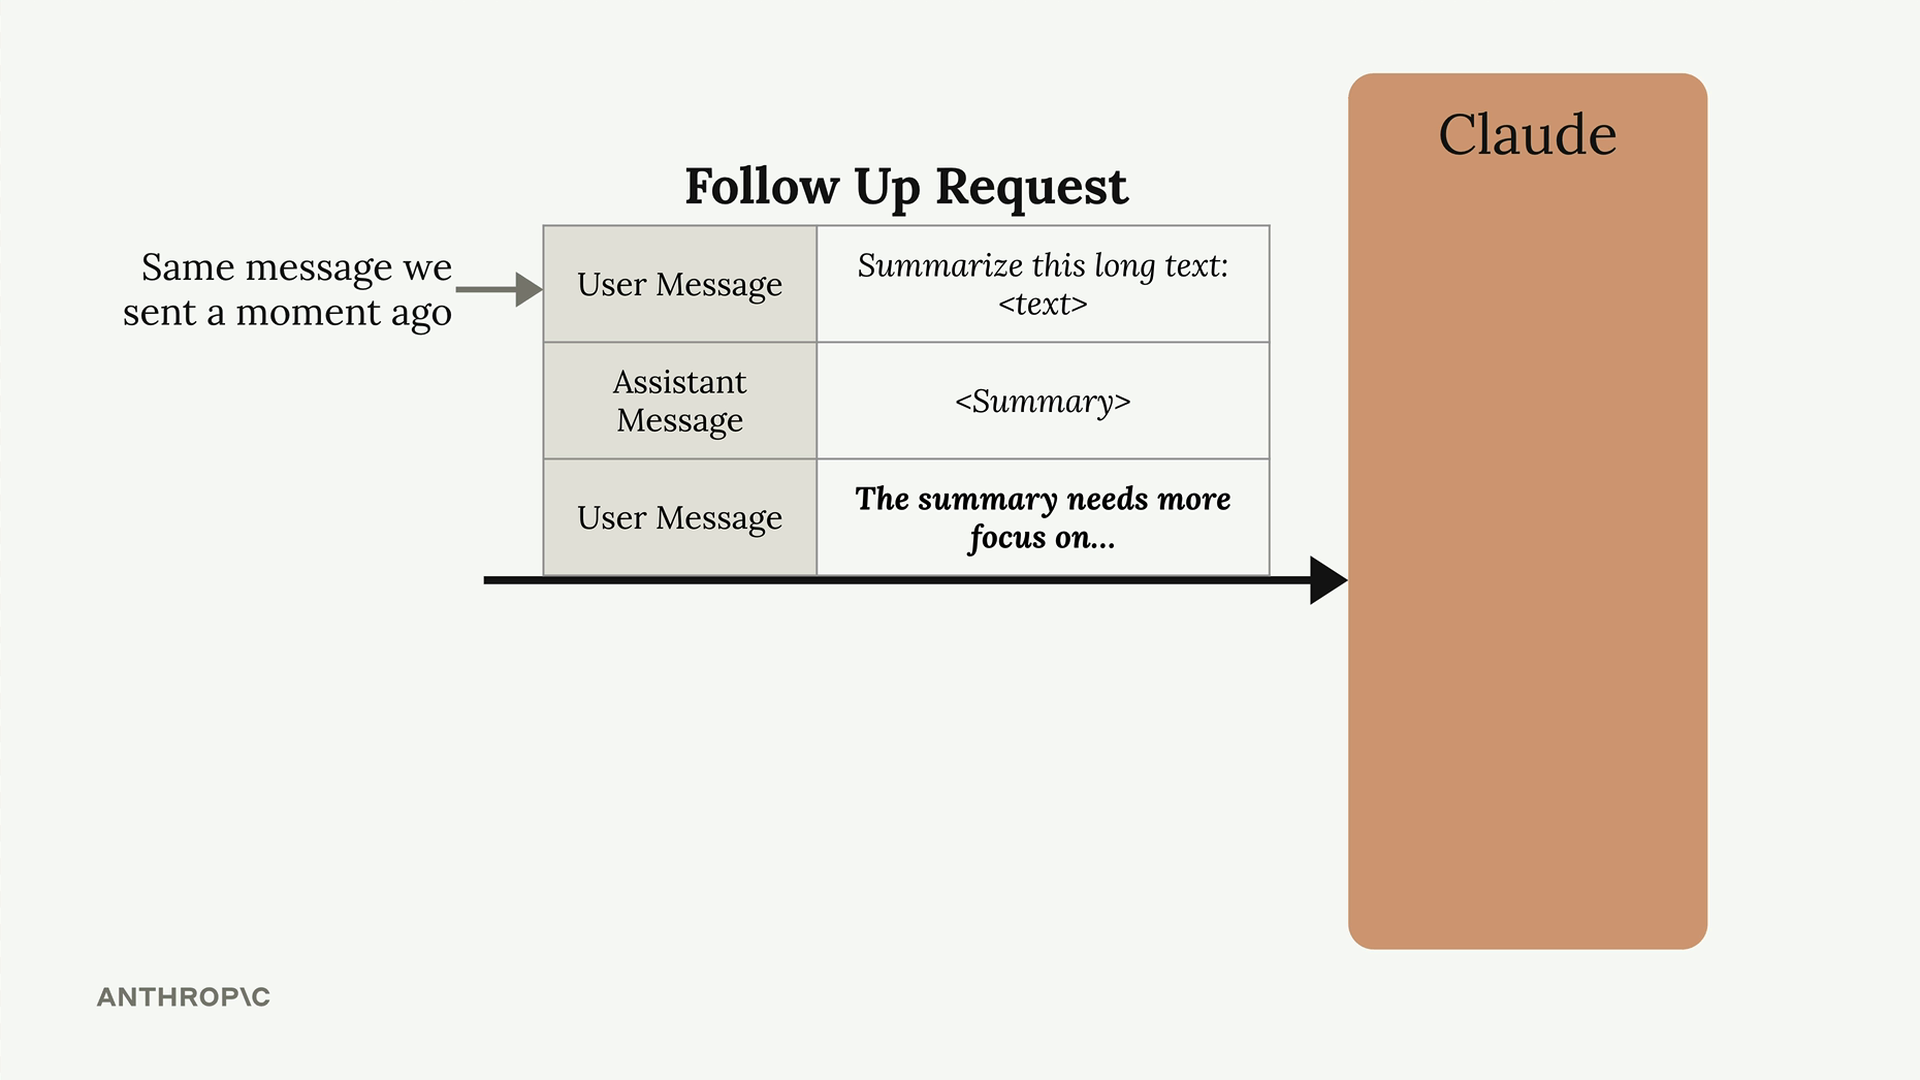
Wenn Claude die ursprüngliche Nachricht erneut sieht, muss es dieselbe rechnerische Arbeit wiederholen, die es erst kurz zuvor verworfen hat. Claude denkt im Grunde: „Ich habe diese exakte Nachricht gerade verarbeitet und diese ganze Arbeit geleistet, und dann weggeworfen. Jetzt muss ich das alles noch einmal tun.“
Wie Prompt-Caching dieses Problem löst
Prompt-Caching begegnet dieser Ineffizienz, indem es die rechnerische Arbeit speichert, statt sie zu verwerfen. So funktioniert es:
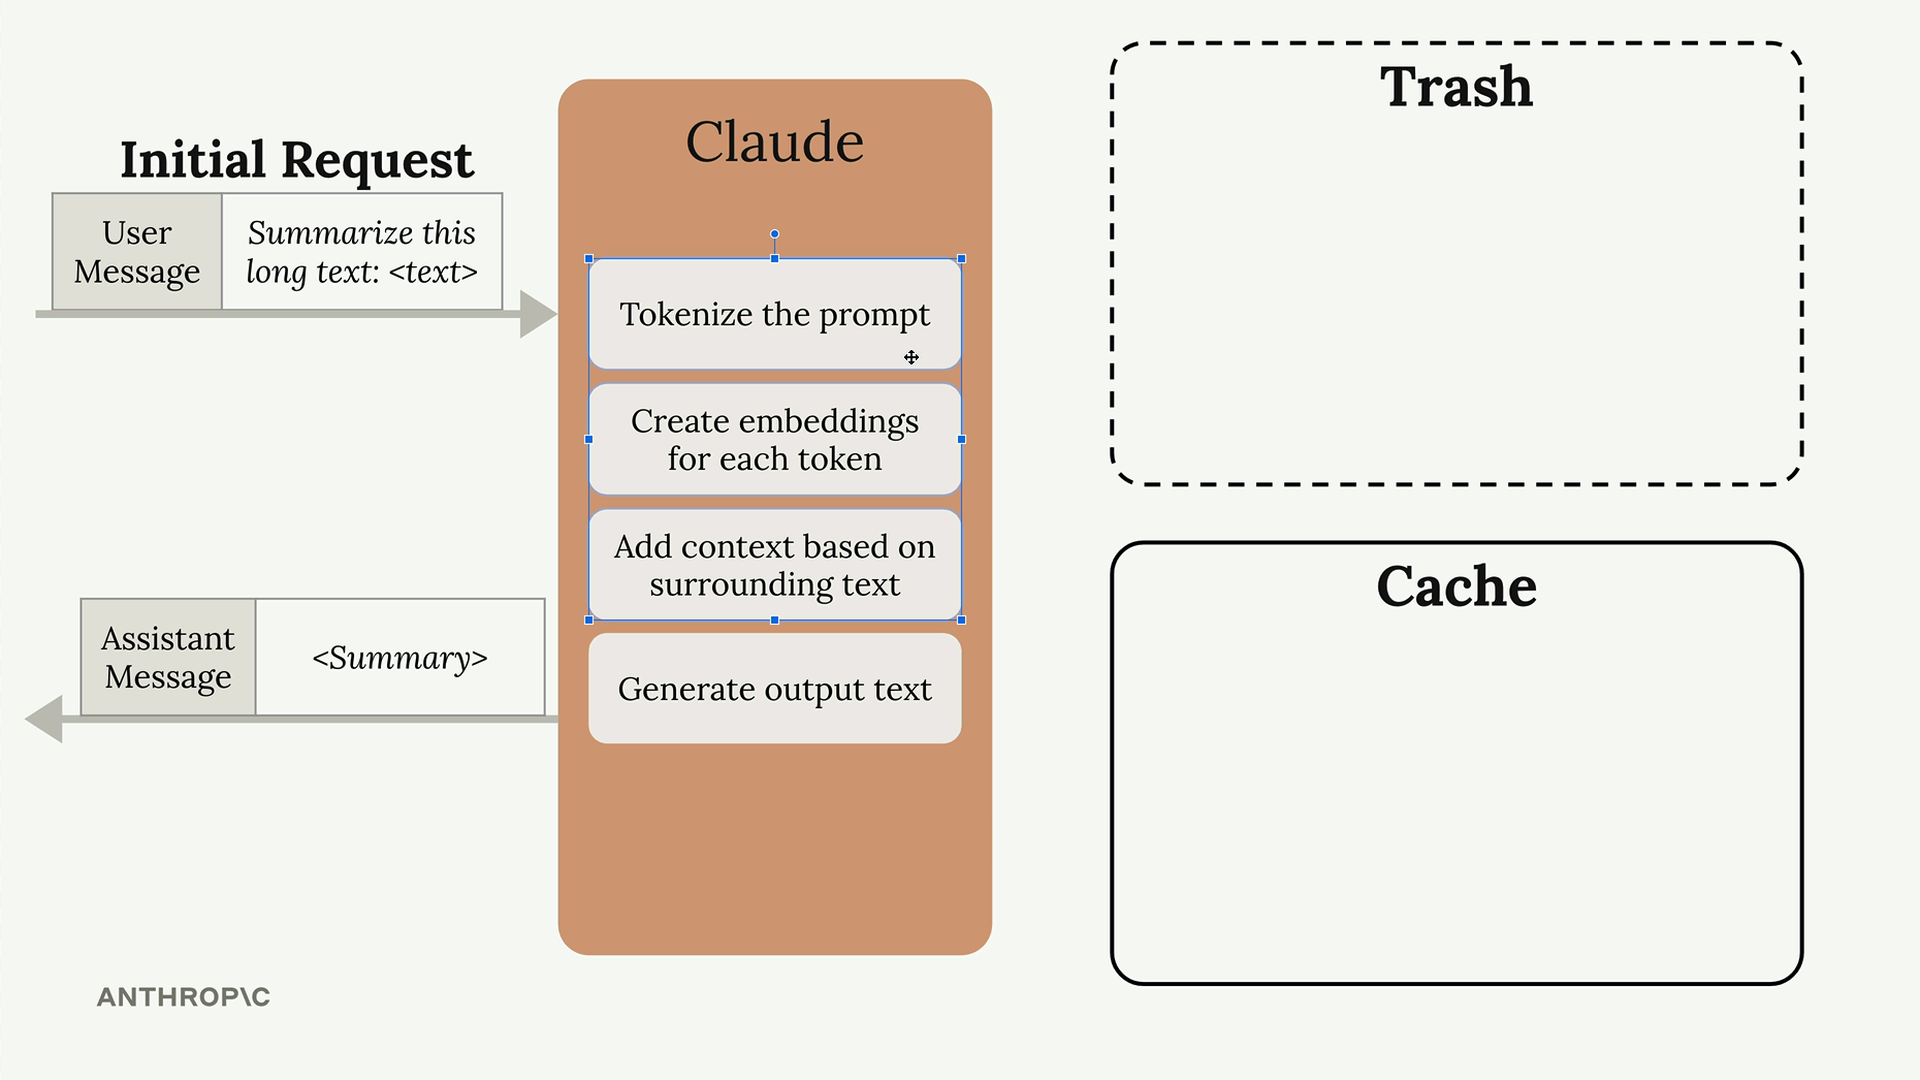
Wenn Claude deine erste Anfrage verarbeitet, wird die gesamte Vorverarbeitungsarbeit nicht verworfen, sondern in einem Cache gespeichert. Der Cache funktioniert wie eine Nachschlagetabelle, die bestimmte Eingabenachrichten den entsprechenden Berechnungsergebnissen zuordnet.
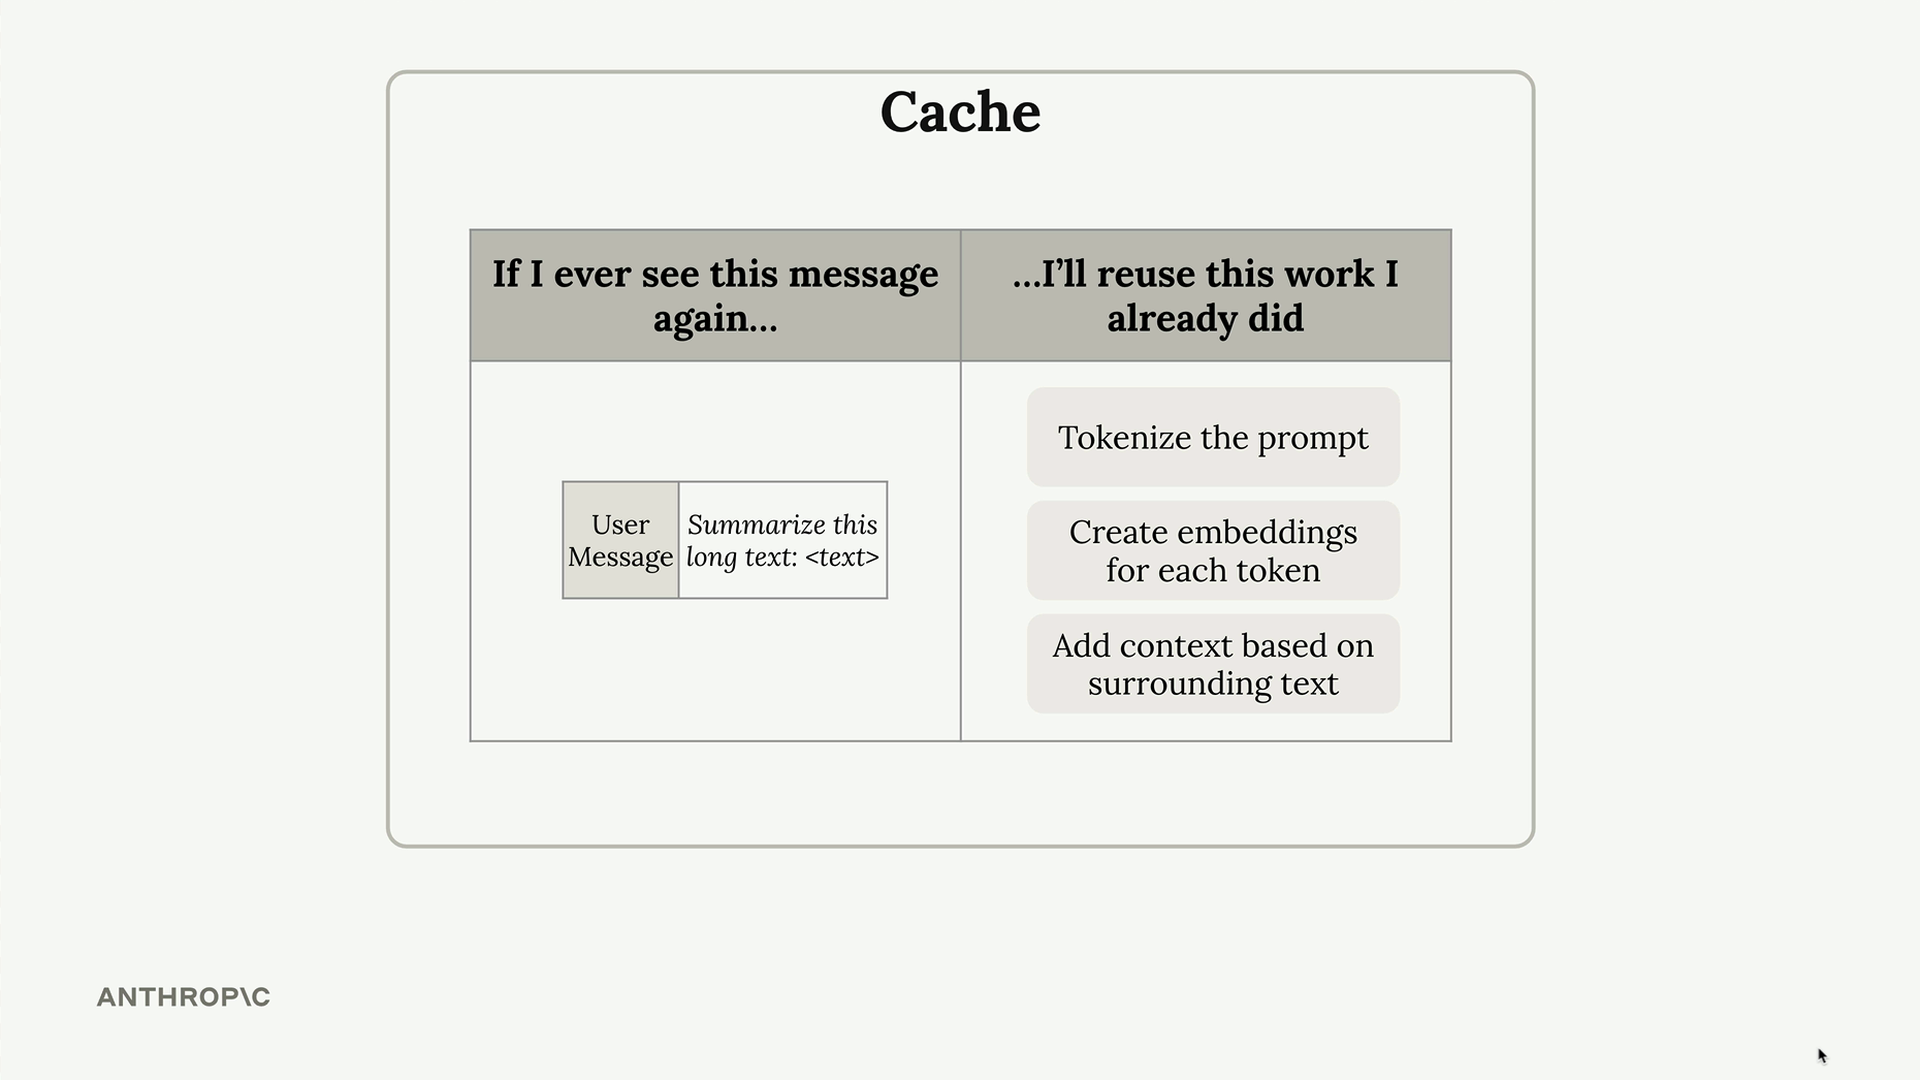
Wenn du eine Folgeanfrage stellst, die denselben Inhalt enthält, kann Claude seinen Cache prüfen und die vorherige Arbeit wiederverwenden, statt von vorne zu beginnen.
Wichtige Vorteile und Einschränkungen
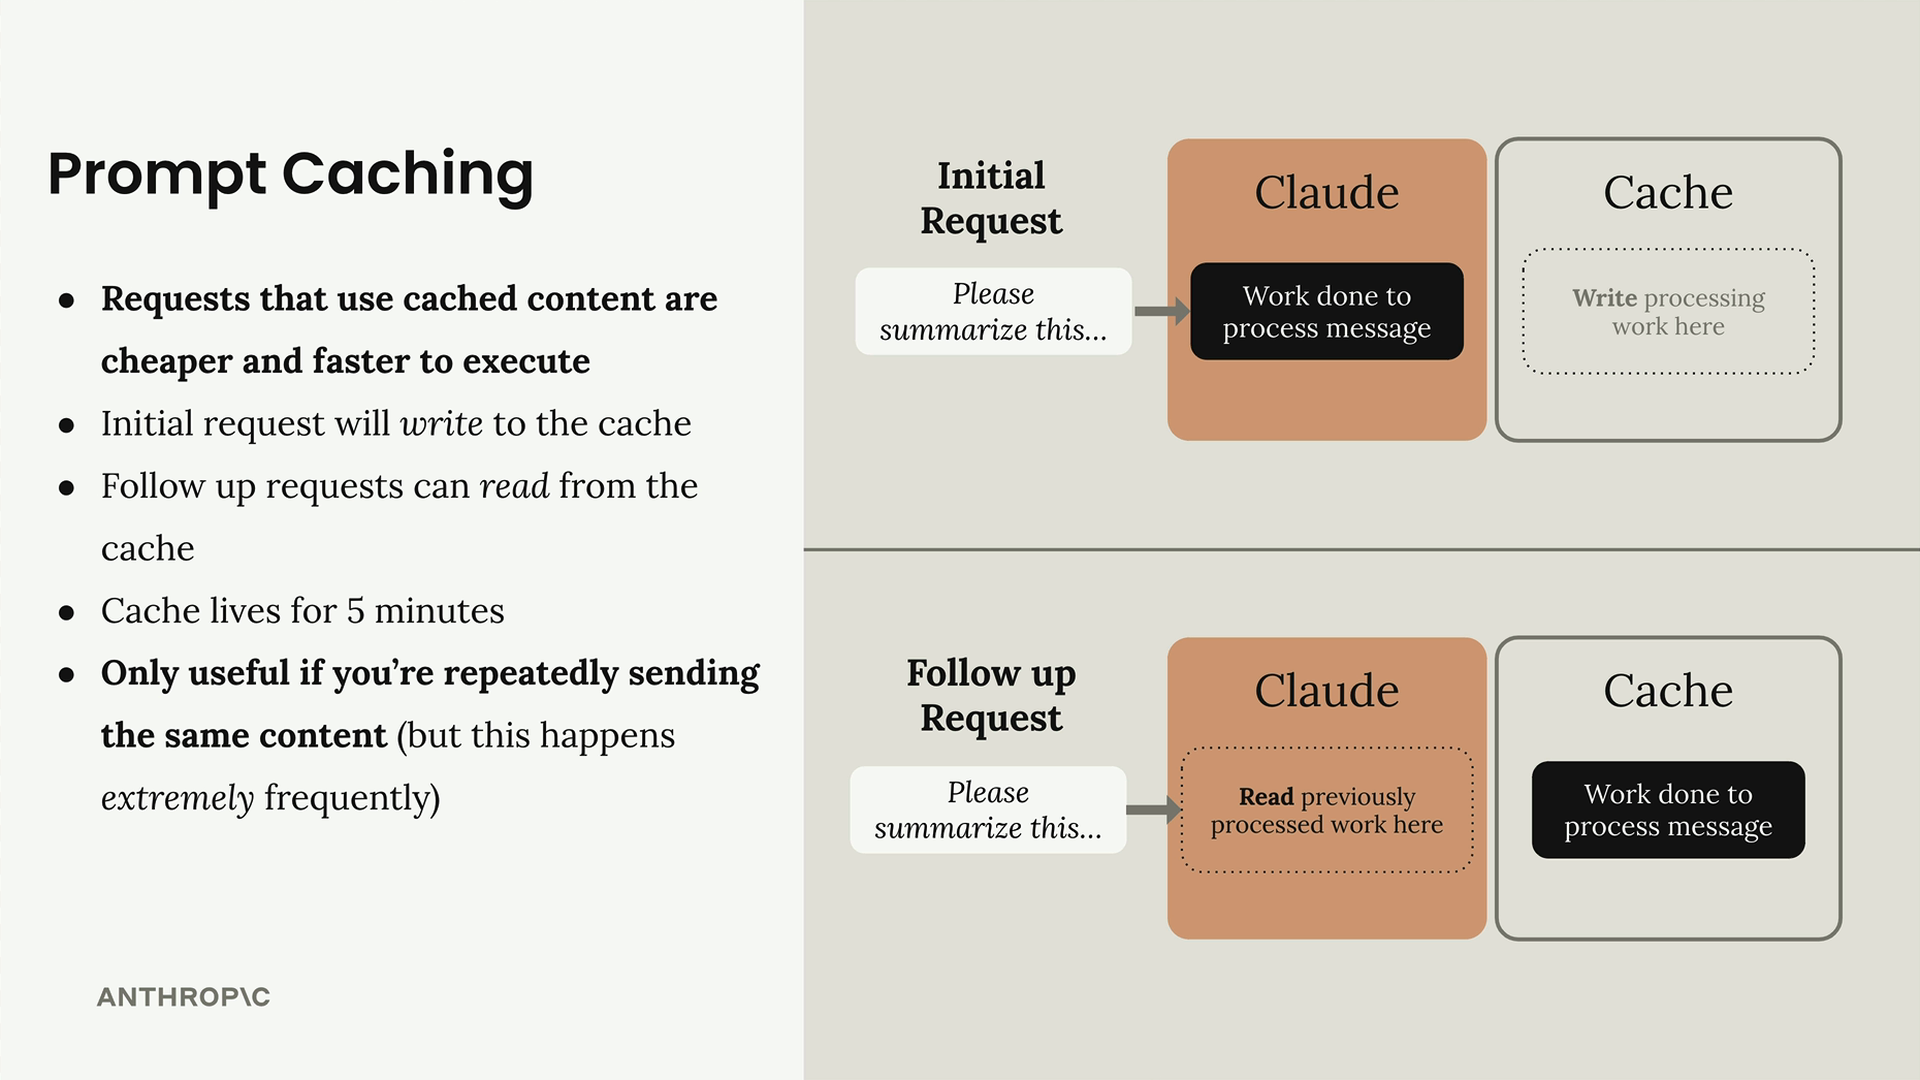
Prompt-Caching bietet mehrere Vorteile:
- Anfragen, die zwischengespeicherte Inhalte nutzen, sind günstiger und schneller auszuführen
- Die erste Anfrage schreibt in den Cache
- Folgeanfragen können aus dem Cache lesen
- Der Cache besteht 5 Minuten lang
- Nur nützlich, wenn du wiederholt denselben Inhalt sendest (was aber extrem häufig vorkommt)
Der Cache hat eine Lebensdauer von 5 Minuten, daher ist er am nützlichsten für Gespräche oder Workflows, bei denen du innerhalb eines kurzen Zeitraums mehrere Anfragen mit überlappendem Inhalt stellst. Dieses Muster ist in realen Anwendungen tatsächlich sehr verbreitet – denk an Chatbots, Dokumentenanalyse-Tools oder jedes System, das den Gesprächskontext beibehält.
Prompt-Caching ist besonders wertvoll, weil viele KI-Anwendungen wiederholt denselben Inhalt senden. Ob System-Prompts, Gesprächsverlauf oder große analysierte Dokumente – derselbe Text taucht oft über mehrere Anfragen innerhalb einer Sitzung hinweg auf.