Beim Erstellen von Chat-Oberflächen mit KI-Modellen erwarten Nutzer, dass Antworten sofort erscheinen, anstatt 10-30 Sekunden auf eine vollständige Antwort zu warten. Die Funktion converse_stream löst dieses Problem, indem sie Text streamt, während er generiert wird, was ein deutlich besseres Nutzererlebnis schafft.
Wie Streaming funktioniert
Anstatt darauf zu warten, dass die gesamte Antwort generiert wird, sendet Streaming Textstücke zurück, sobald sie verfügbar sind. So verändert sich der Ablauf:
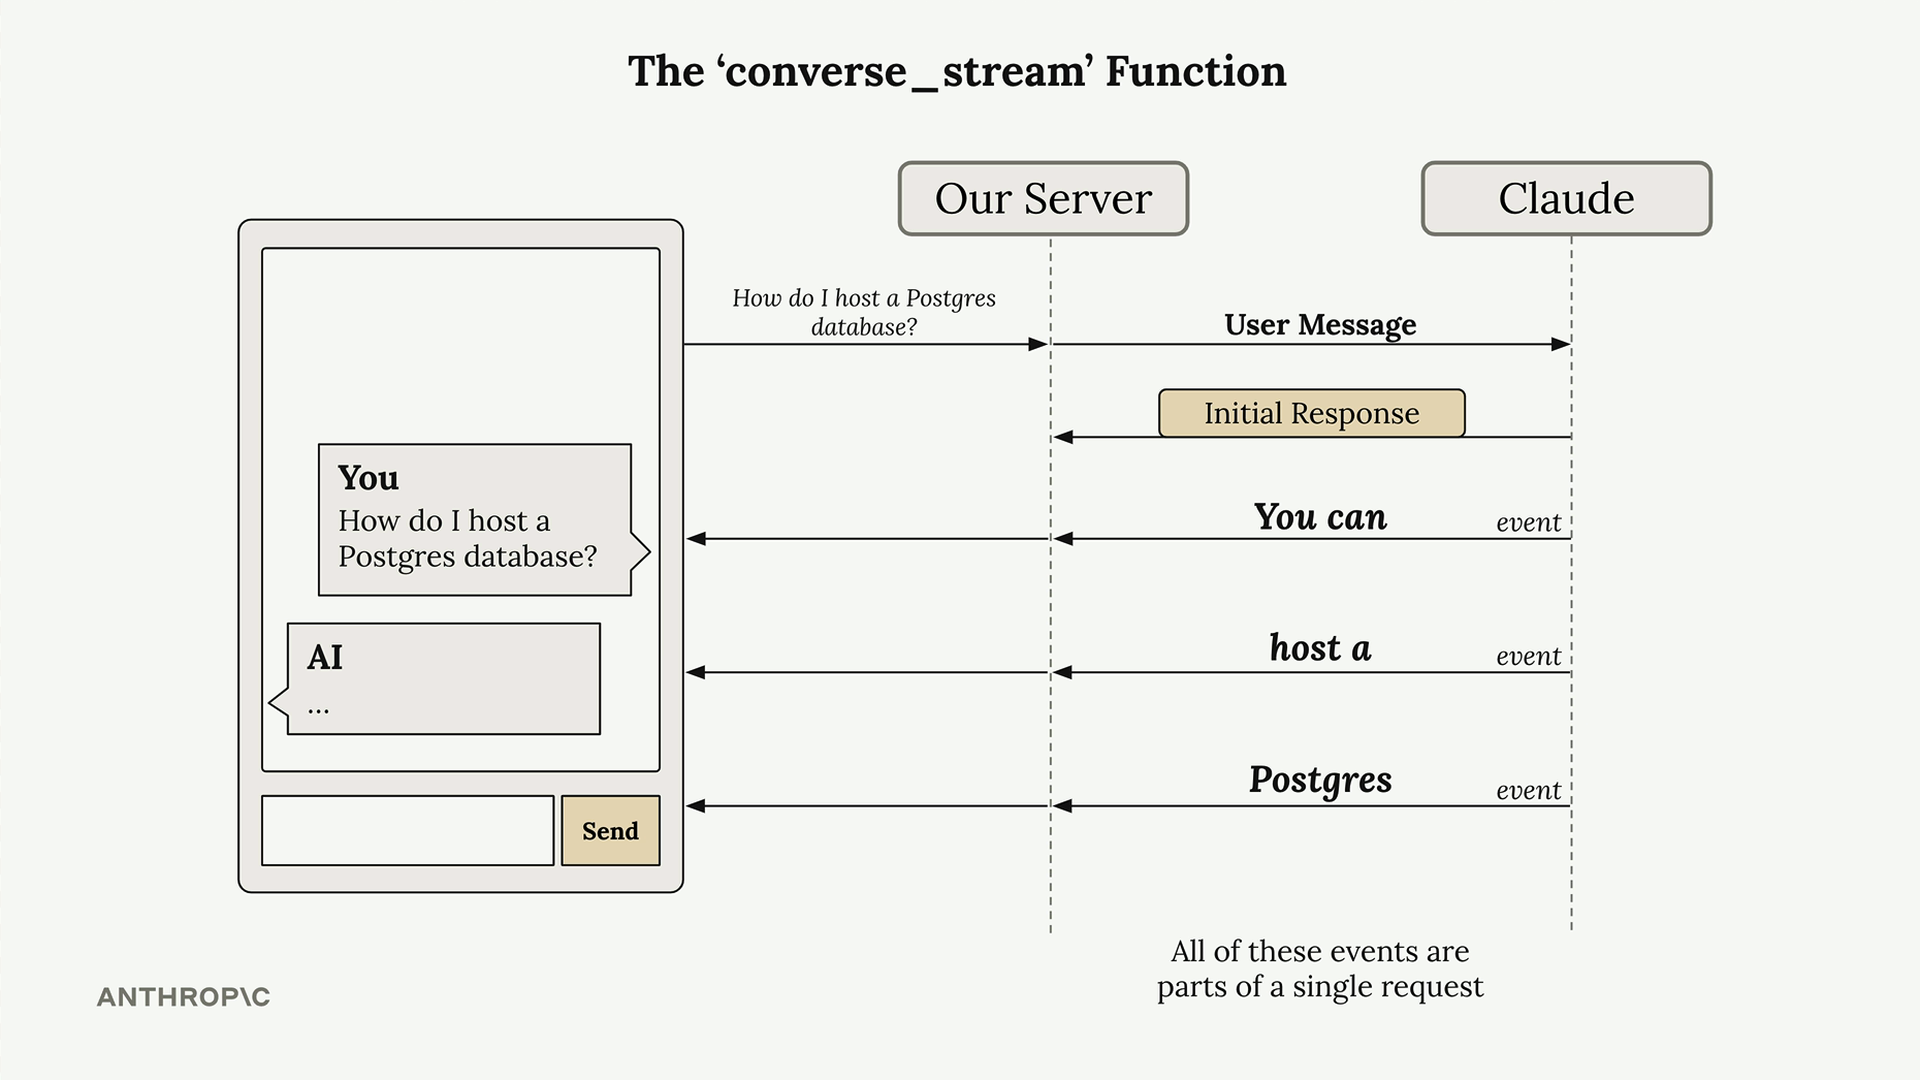
Wenn du converse_stream aufrufst, erhältst du sofort eine erste Antwort zurück, die ein stream-Objekt enthält. Dieser Stream ist ein Generator, der Events liefert, während das Modell Text generiert. Jedes Event enthält einen kleinen Ausschnitt der Gesamtantwort.
Grundlegende Implementierung
So verwendest du converse_stream in deinem Code:
messages = []
add_user_message(messages, "Write a 1 sentence description of a fake database")
response = client.converse_stream(messages=messages, modelId=model_id)

for event in response["stream"]:
    print(event)
Dies gibt alle verschiedenen Events aus, sobald sie eintreffen. Du siehst, wie die Antwort in Stücken ankommt, anstatt alles auf einmal.
Stream-Events verstehen
Der Stream liefert mehrere Arten von Events, die jeweils einem anderen Zweck dienen:
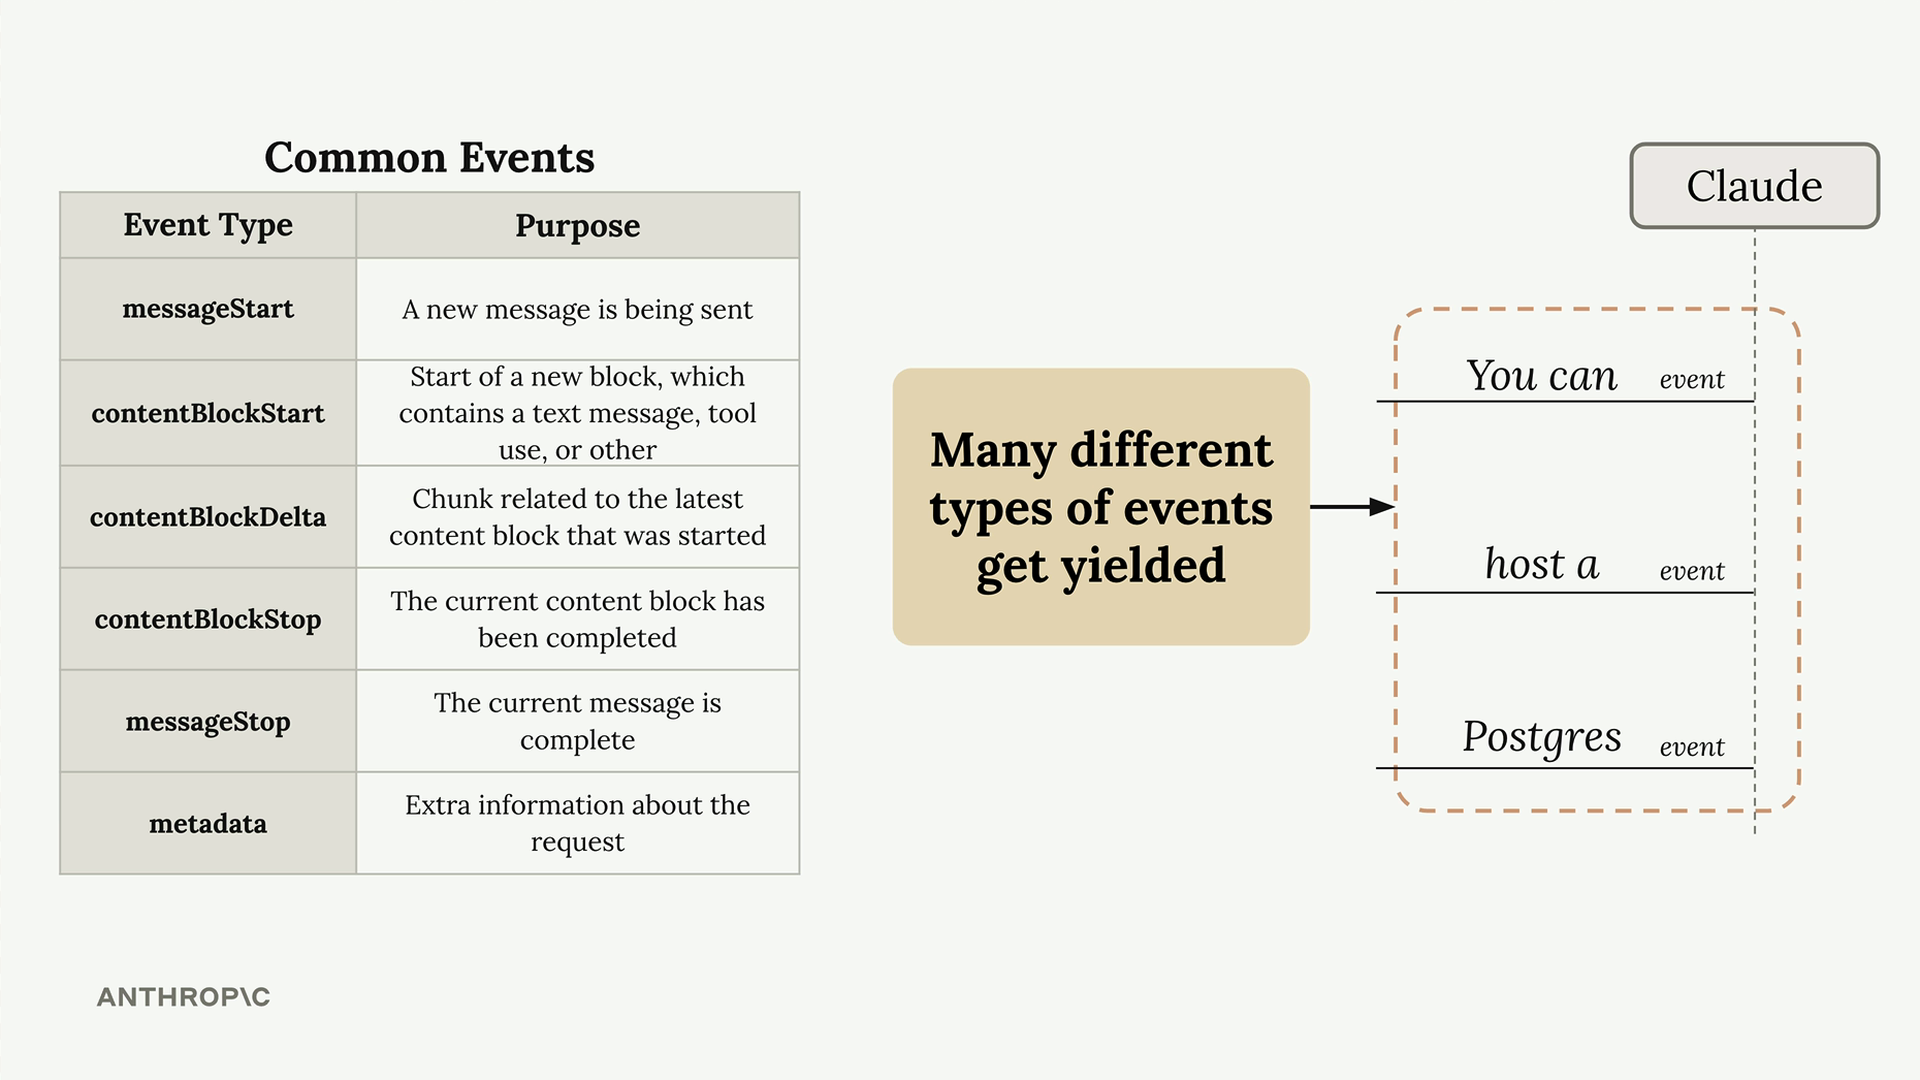
Für die grundlegende Textgenerierung musst du dich nur um contentBlockDelta-Events kümmern. Diese enthalten die tatsächlich generierten Textstücke, die du den Nutzern anzeigen möchtest.
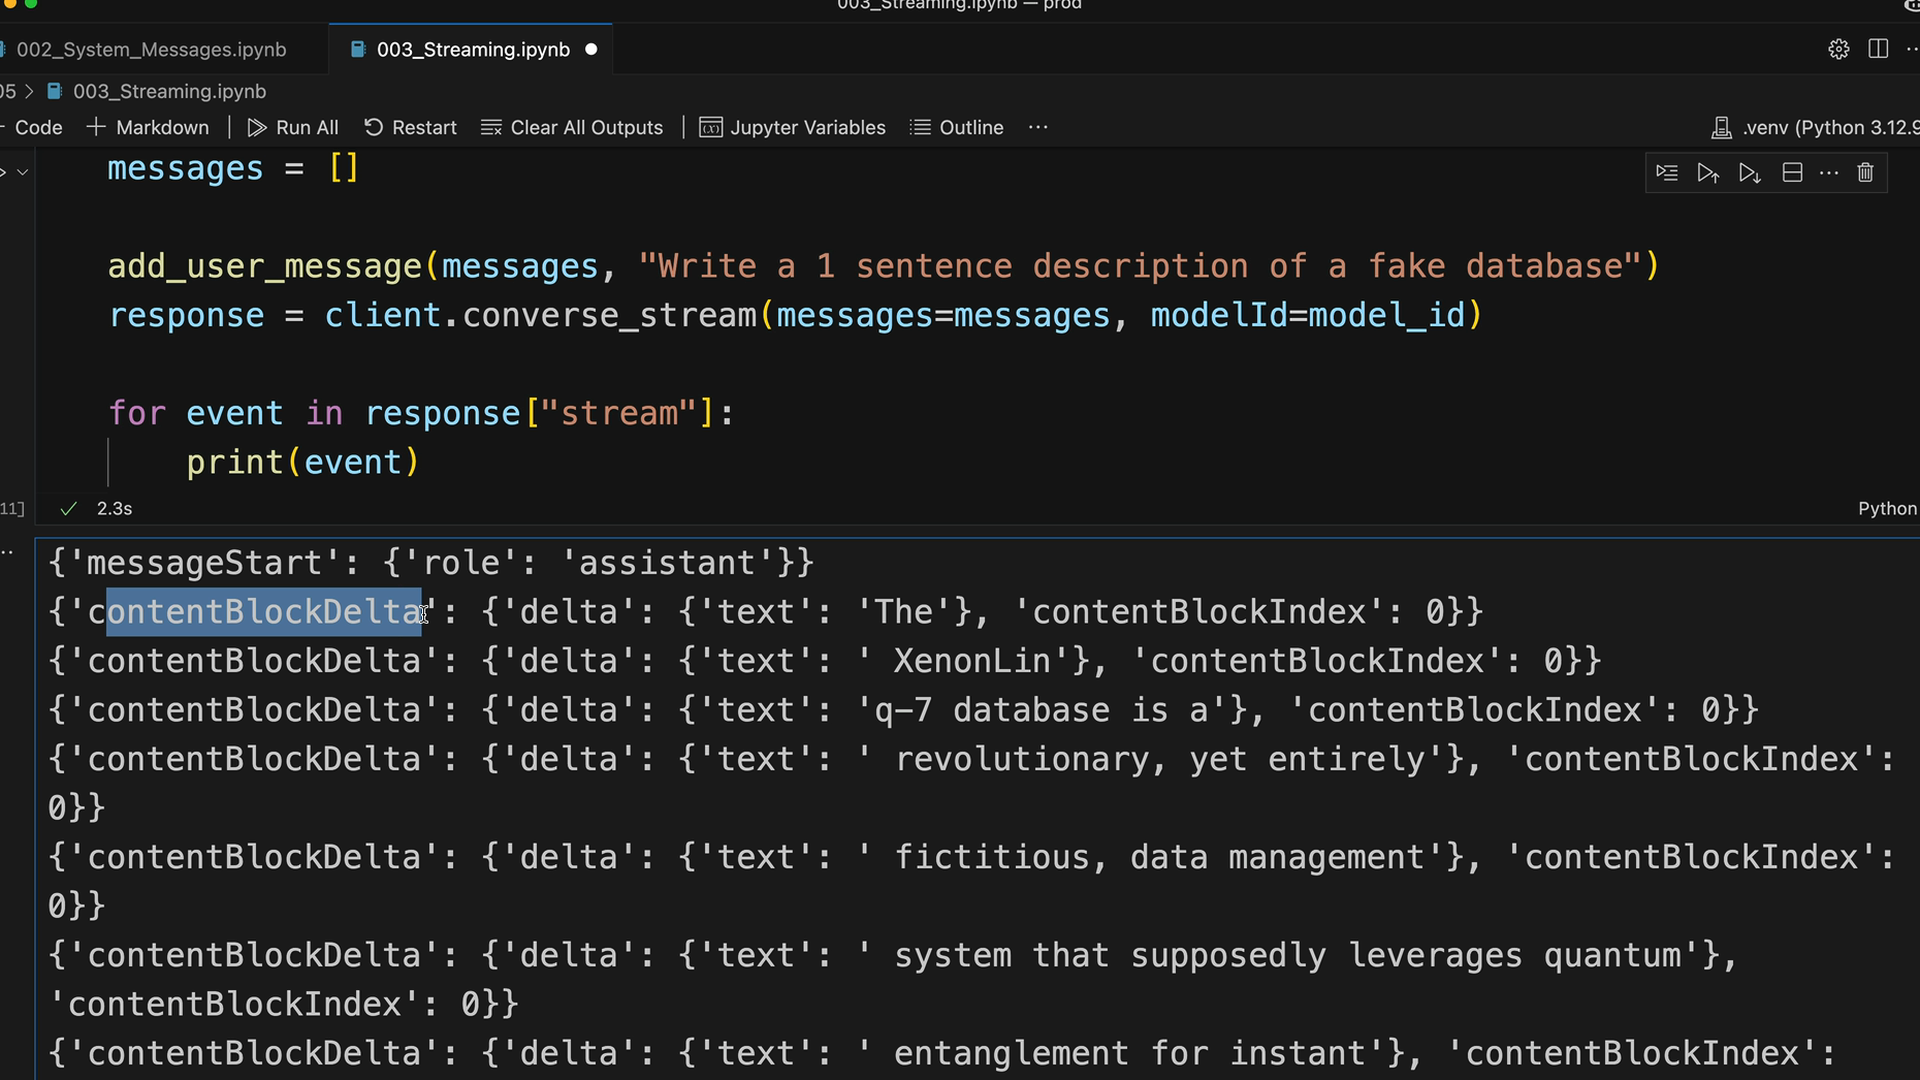
Die Events treffen immer in einer vorhersagbaren Reihenfolge ein: messageStart, mehrere contentBlockDelta-Events mit deinem Text, dann contentBlockStop, messageStop und schließlich metadata.
Den Text extrahieren
Um nur den generierten Text aus jedem Chunk zu erhalten, filterst du nach contentBlockDelta-Events und extrahierst den Text:
text = ""
for event in response["stream"]:
    if "contentBlockDelta" in event:
        chunk = event["contentBlockDelta"]["delta"]["text"]
        print(chunk, end="")
        text += chunk

print("\n\nTotal Message:\n" + text)
Der Parameter end="" entfernt den automatischen Zeilenumbruch, den die print-Funktion von Python hinzufügt, wodurch der gestreamte Text natürlicher erscheint.
Praktische Anwendungen
In einer echten Anwendung würdest du, anstatt jeden Chunk auszugeben, typischerweise:
- Jeden Chunk über WebSockets oder Server-Sent Events an dein Frontend senden
- Die Benutzeroberfläche aktualisieren, um die wachsende Antwort in Echtzeit anzuzeigen
- Die vollständige Nachricht speichern, sobald das Streaming abgeschlossen ist
- Eventuelle Fehler behandeln, die während des Streamings auftreten können
Dieser Streaming-Ansatz verwandelt das Nutzererlebnis von „Absenden und Warten“ in „Absenden und Zusehen, wie die Antwort erscheint“, wodurch sich deine KI-gestützten Anwendungen viel reaktionsschneller und ansprechender anfühlen.