Codebasierte Bewertung fügt deinen Prompt-Evaluierungen eine zusätzliche Validierungsebene hinzu, indem geprüft wird, ob die Ausgabe des Modells das richtige Format einhält und über eine gültige Syntax verfügt. Dies ist besonders nützlich, wenn du Modelle bittest, Code, JSON oder reguläre Ausdrücke zu generieren.
So funktioniert die codebasierte Bewertung
Der Code-Grader bewertet zwei Hauptkriterien:
- Formateinhaltung – Enthält die Ausgabe ausschließlich das angeforderte Format (Python, JSON oder Regex) ohne Erklärungen?
- Gültige Syntax – Lässt sich die Ausgabe tatsächlich erfolgreich parsen oder kompilieren?
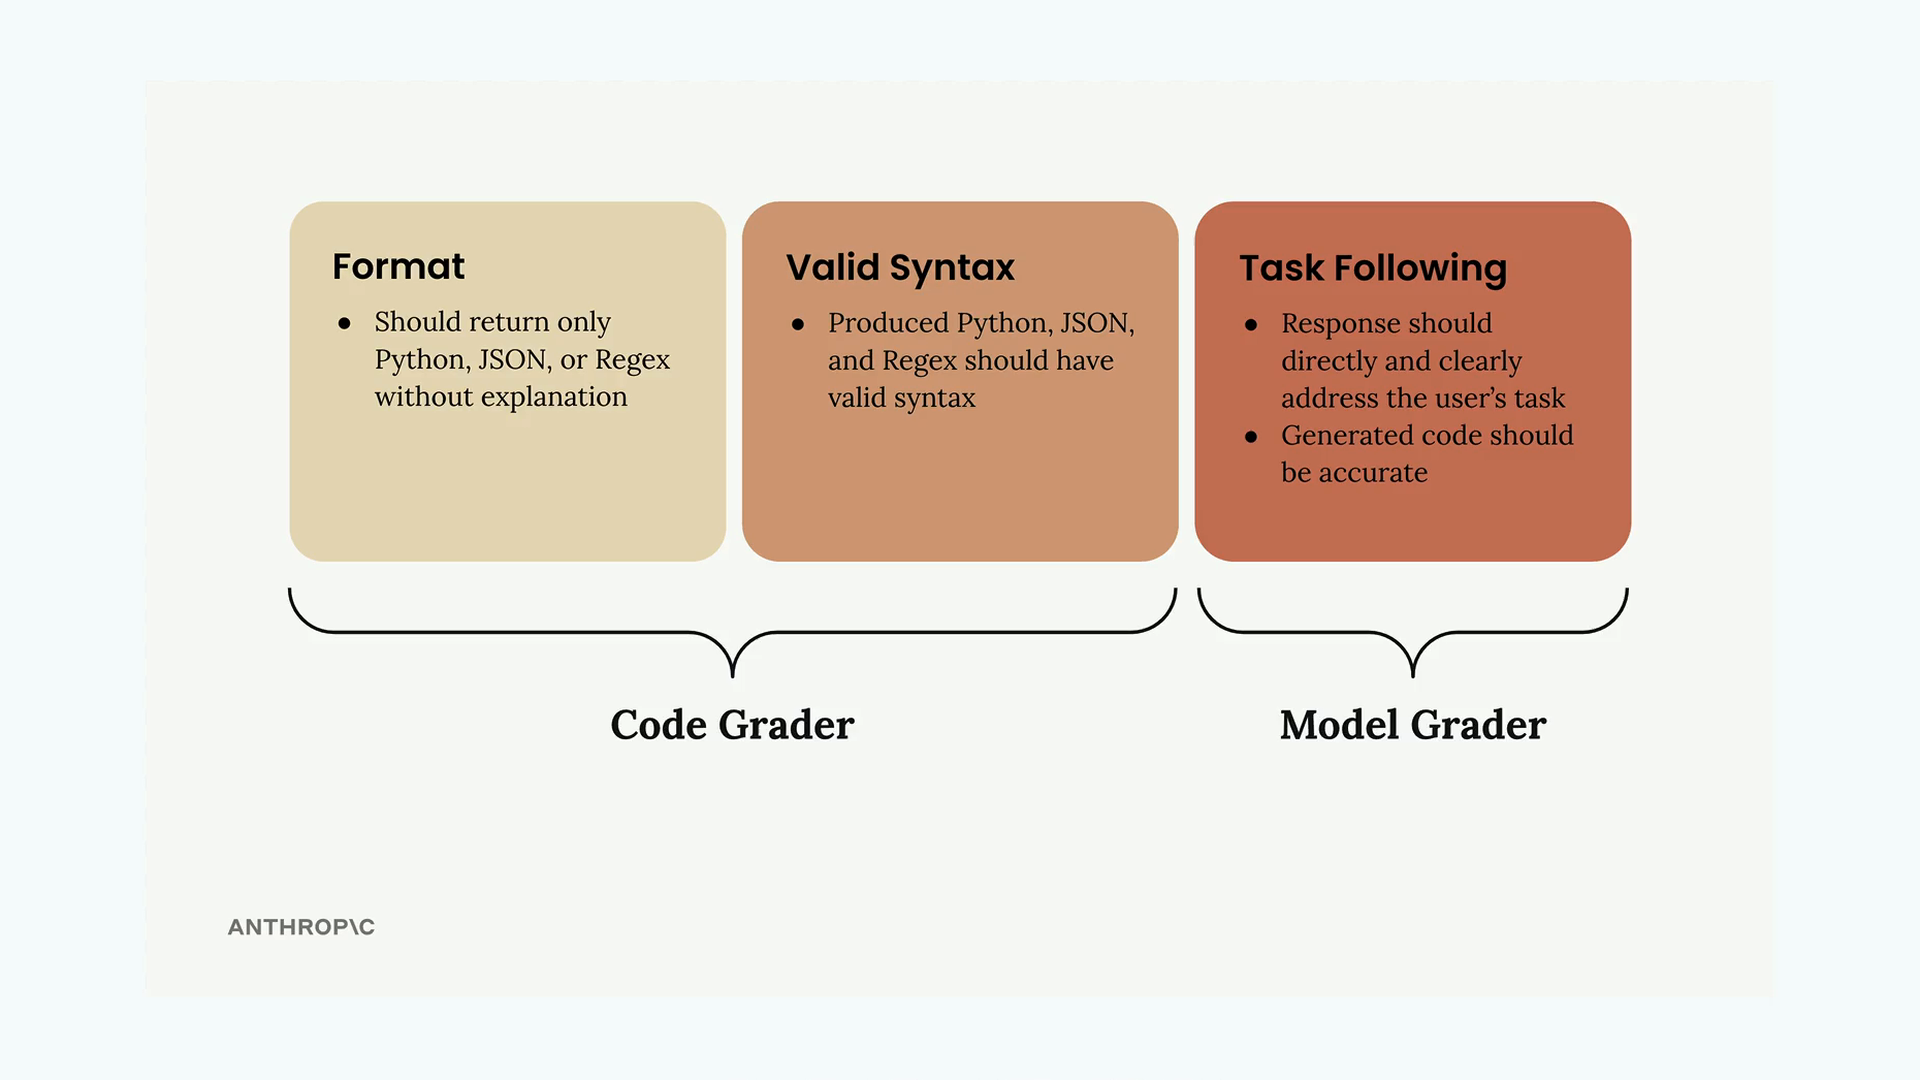
Das System verwendet für jeden Formattyp separate Validierungsfunktionen. Wenn der Code erfolgreich geparst wird, erhält er die Höchstpunktzahl von 10. Wenn das Parsen mit einem Fehler fehlschlägt, erhält er die Punktzahl 0.
Einrichten der Validierungsfunktionen
Du benötigst drei Hilfsfunktionen, um unterschiedliche Ausgabetypen zu validieren:
import ast
import json
import re

def validate_json(text):
    try:
        json.loads(text.strip())
        return 10
    except json.JSONDecodeError:
        return 0

def validate_python(text):
    try:
        ast.parse(text.strip())
        return 10
    except SyntaxError:
        return 0

def validate_regex(text):
    try:
        re.compile(text.strip())
        return 10
    except re.error:
        return 0
Diese Funktionen nutzen die integrierten Parsing-Fähigkeiten von Python, um die Syntaxgültigkeit zu prüfen. Die Funktion json.loads() validiert JSON, ast.parse() erstellt einen abstrakten Python-Syntaxbaum, und re.compile() validiert reguläre Ausdrücke.
Hinzufügen von Formatinformationen zu Testfällen
Dein Testdatensatz muss für jede Aufgabe das erwartete Ausgabeformat angeben. Aktualisiere deinen Prompt zur Datensatzgenerierung, sodass er ein Formatfeld enthält:
{
    "task": "Description of task",
    "format": "python"
}
Das Formatfeld sollte je nach Art der Ausgabe, die du von dieser Aufgabe erwartest, „json“, „python“ oder „regex“ enthalten.
Verbessern deines Prompts
Um bessere Ergebnisse vom Code-Grader zu erhalten, gestalte deine Prompt-Anweisungen spezifischer:
* Respond only with Python, JSON, or a plain Regex
* Do not add any comments or commentary or explanationDu kannst außerdem eine vorausgefüllte Assistant-Nachricht mit Codeblöcken und Stoppsequenzen verwenden, um eine saubere Formatierung der Ausgabe sicherzustellen.
Kombinieren der Punktzahlen
Wähle zunächst den Validator aus, der zu jedem Testfall passt:
def grade_syntax(output, test_case):
    if test_case["format"] == "json":
        return validate_json(output)
    if test_case["format"] == "python":
        return validate_python(output)
    return validate_regex(output)
Der letzte Schritt besteht darin, die Punktzahl deines Modell-Graders mit der Punktzahl des Syntax-Graders zusammenzuführen. Ein einfacher Ansatz besteht darin, innerhalb von run_test_case den Durchschnitt beider Punktzahlen zu bilden:
model_grade = grade_by_model(test_case, output)
model_score = model_grade["score"]
syntax_score = grade_syntax(output, test_case)

score = (model_score + syntax_score) / 2
Dadurch erhalten sowohl die inhaltliche Qualität (vom Modell-Grader) als auch die technische Korrektheit (vom Code-Grader) das gleiche Gewicht. Du kannst diese Gewichtung anpassen, je nachdem, was für deinen speziellen Anwendungsfall wichtiger ist.
Interpretieren der Ergebnisse
Sobald du deine Evaluierung ausführst, erhältst du eine kombinierte Punktzahl, die sowohl die semantische Qualität als auch die technische Korrektheit des generierten Codes widerspiegelt. Denke daran, dass eine einzelne Punktzahl für sich genommen nicht viel aussagt – der eigentliche Wert ergibt sich aus dem Vergleich der Punktzahlen, während du dein Prompt-Design iterierst.
Nutze diese Ausgangspunktzahl, um Prompt-Verbesserungen zu testen und zu sehen, ob deine Änderungen tatsächlich zu einer besseren, zuverlässigeren Codegenerierung führen.