Maintenant que nous avons couvert les bases du RAG, du découpage de texte en segments et des embeddings, parcourons étape par étape le pipeline RAG complet. Cet exemple détaillé vous montrera exactement comment toutes les pièces s'assemblent dans une implémentation réelle.
Étape 1 : découper votre texte source
D'abord, nous prenons notre document source et le divisons en segments gérables. Pour cet exemple, nous utiliserons deux sections de texte simples :
- Section 1 : Recherche médicale - « Cette année a connu des avancées significatives dans notre compréhension du XDR-47, un « bug » que nous n'avions jamais vu auparavant. »
- Section 2 : Ingénierie logicielle - « Cette division a consacré des efforts considérables à l'étude de divers vecteurs d'infection dans nos systèmes distribués »
Étape 2 : générer les embeddings
Ensuite, nous convertissons chaque segment de texte en embeddings numériques. Pour rendre ce concept clair, imaginons que nous disposons d'un modèle d'embedding parfait qui renvoie toujours exactement deux nombres, et que nous savons ce que représente chaque nombre :
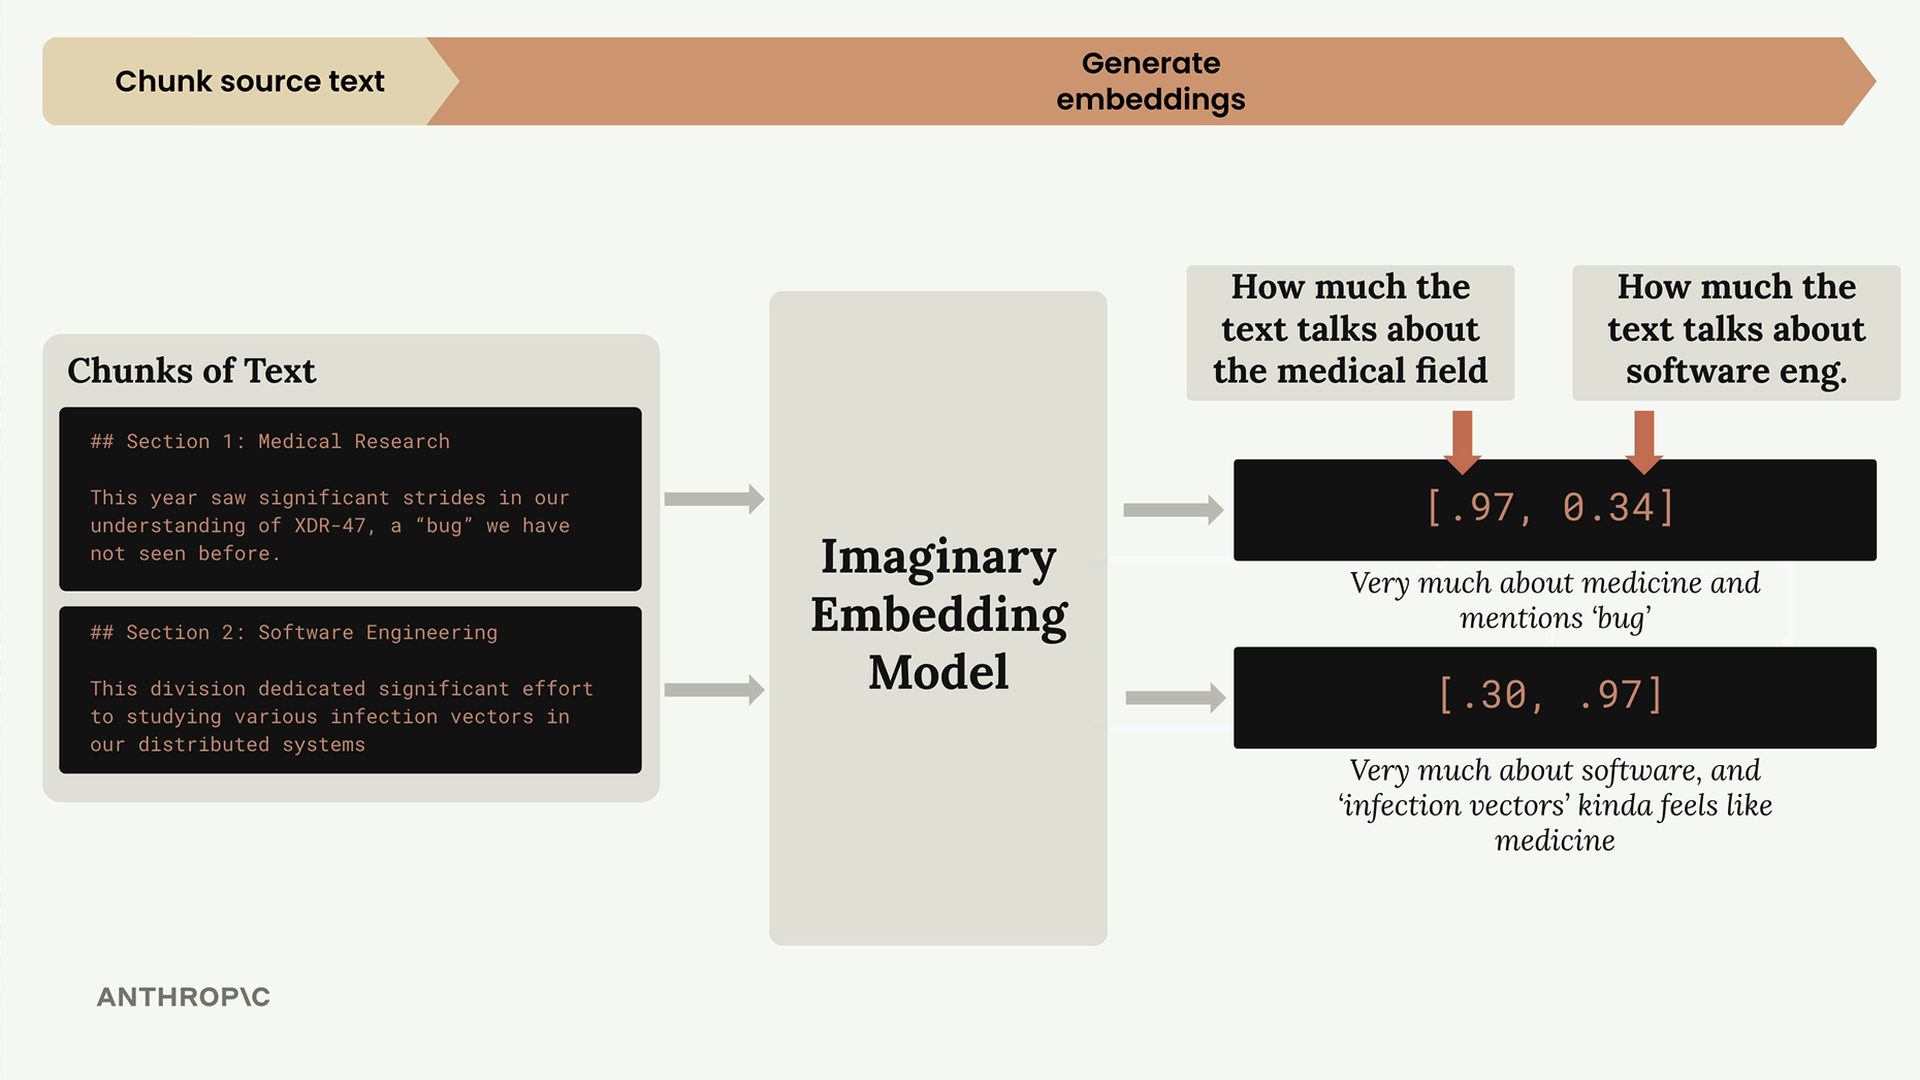
Dans notre modèle imaginaire :
- Premier nombre : à quel point le texte parle du domaine médical
- Deuxième nombre : à quel point le texte parle d'ingénierie logicielle
Ainsi, notre section de recherche médicale obtient un embedding de [0.97, 0.34] - très médical, quelque peu lié au logiciel en raison du mot « bug ». La section d'ingénierie logicielle obtient [0.30, 0.97] - très axée sur le logiciel, mais « vecteurs d'infection » a des connotations médicales.
Normalisation
Avant de stocker ces embeddings, ils passent par un processus de normalisation qui met à l'échelle chaque vecteur pour qu'il ait une magnitude de 1,0. Ceci est généralement géré automatiquement par votre API d'embedding, mais il est important de comprendre que cela se produit.
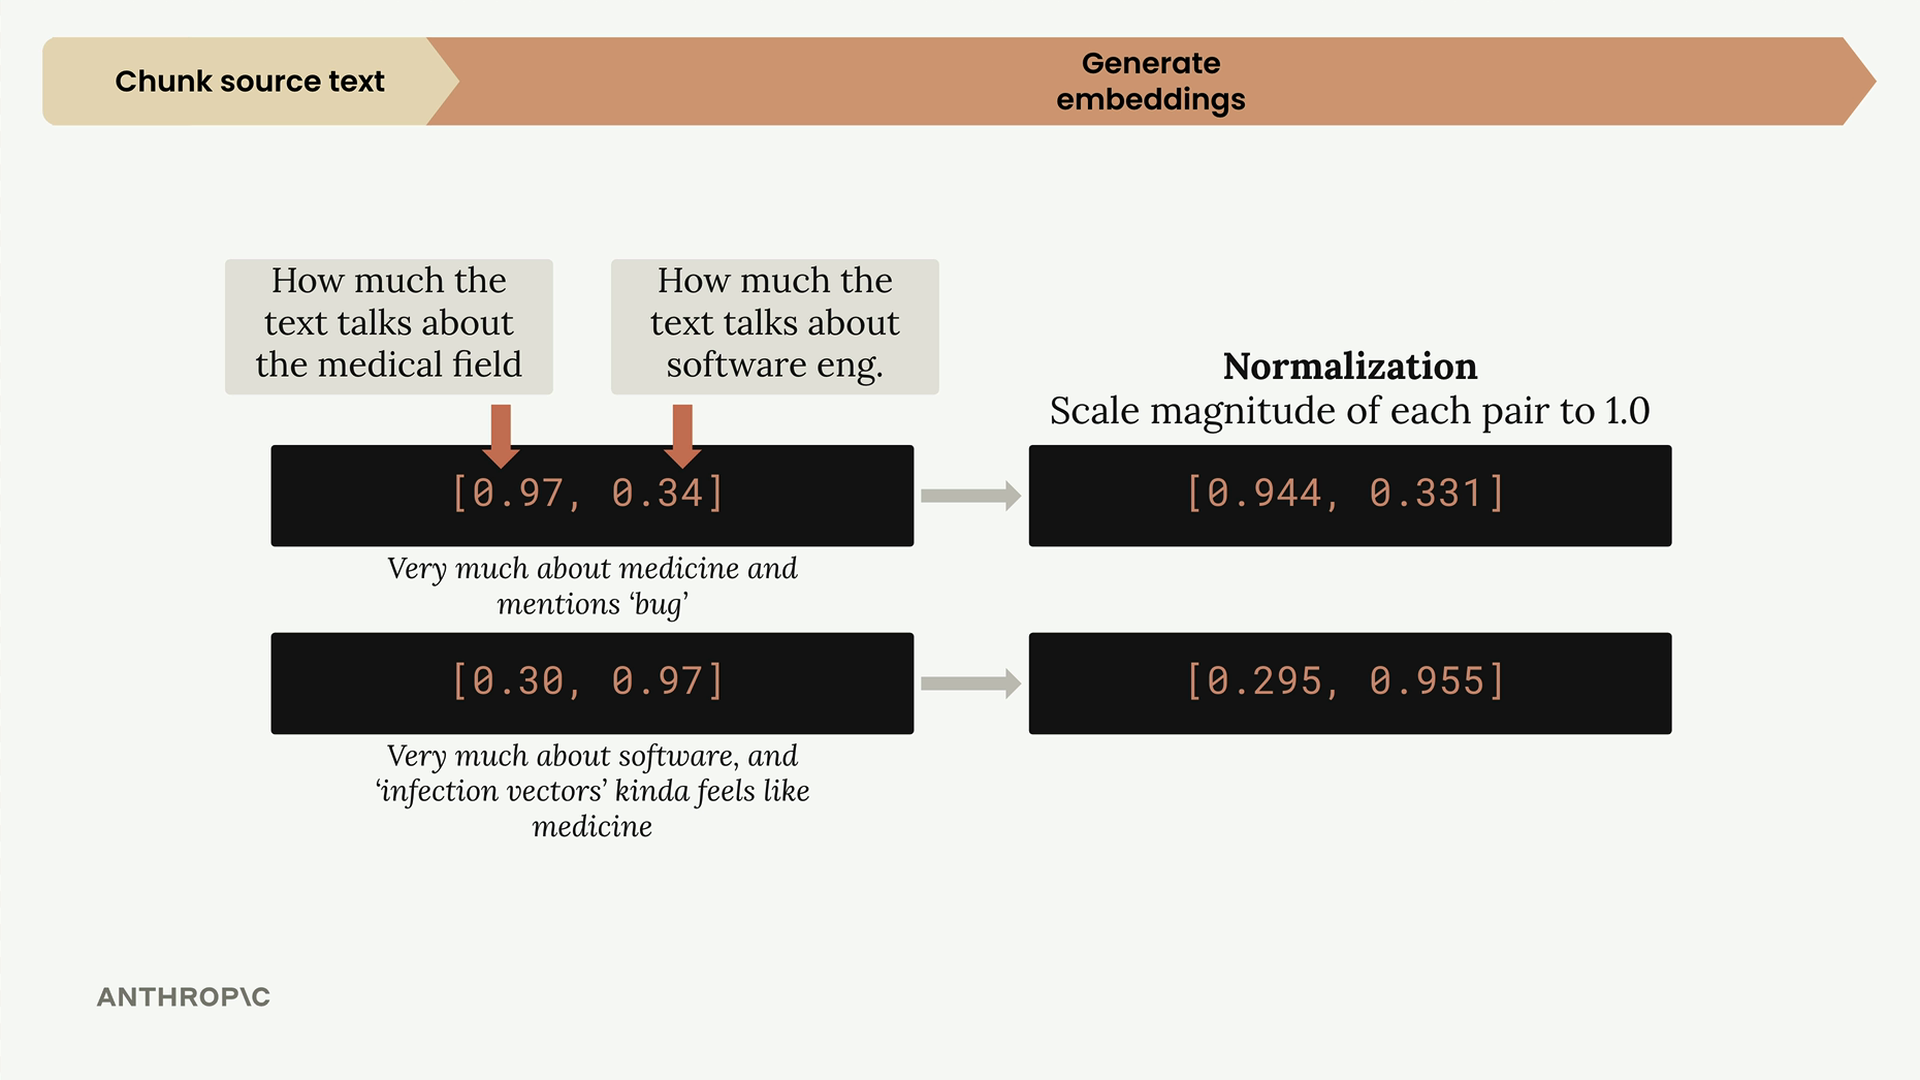
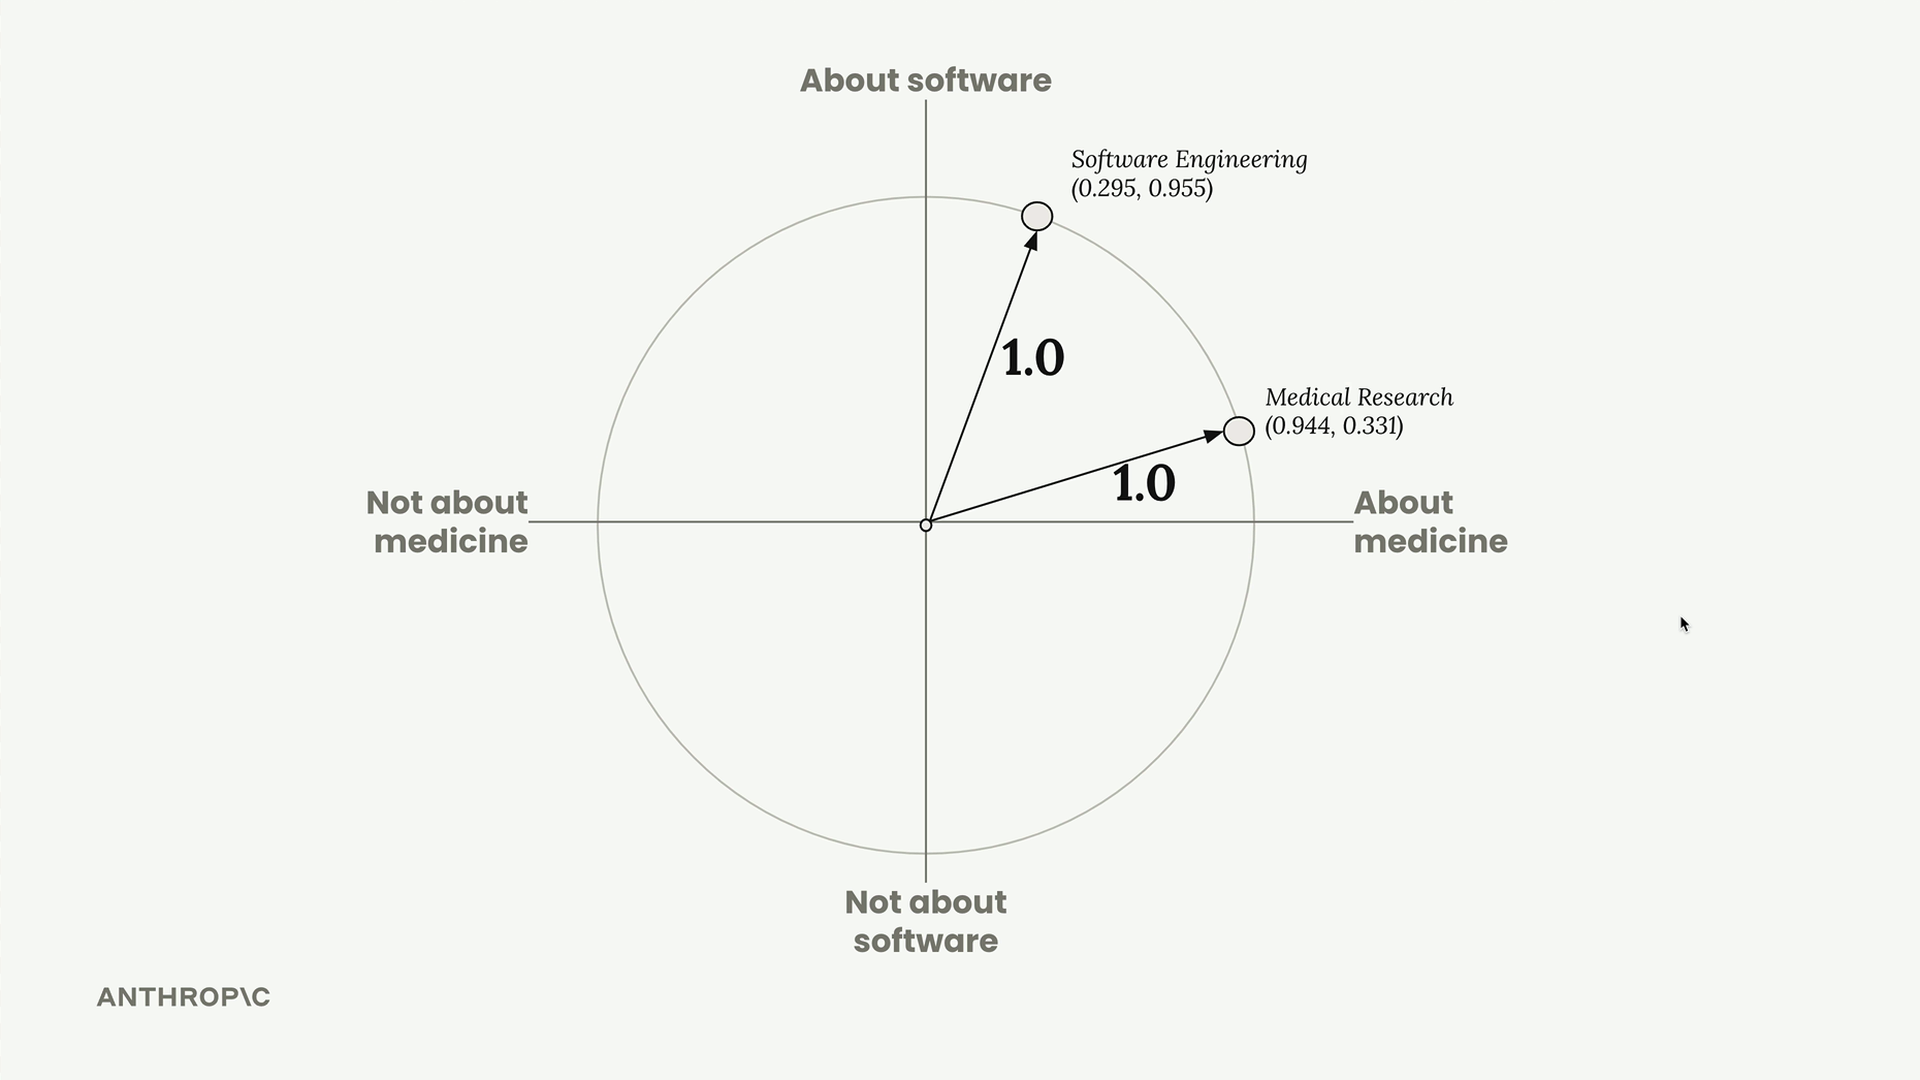
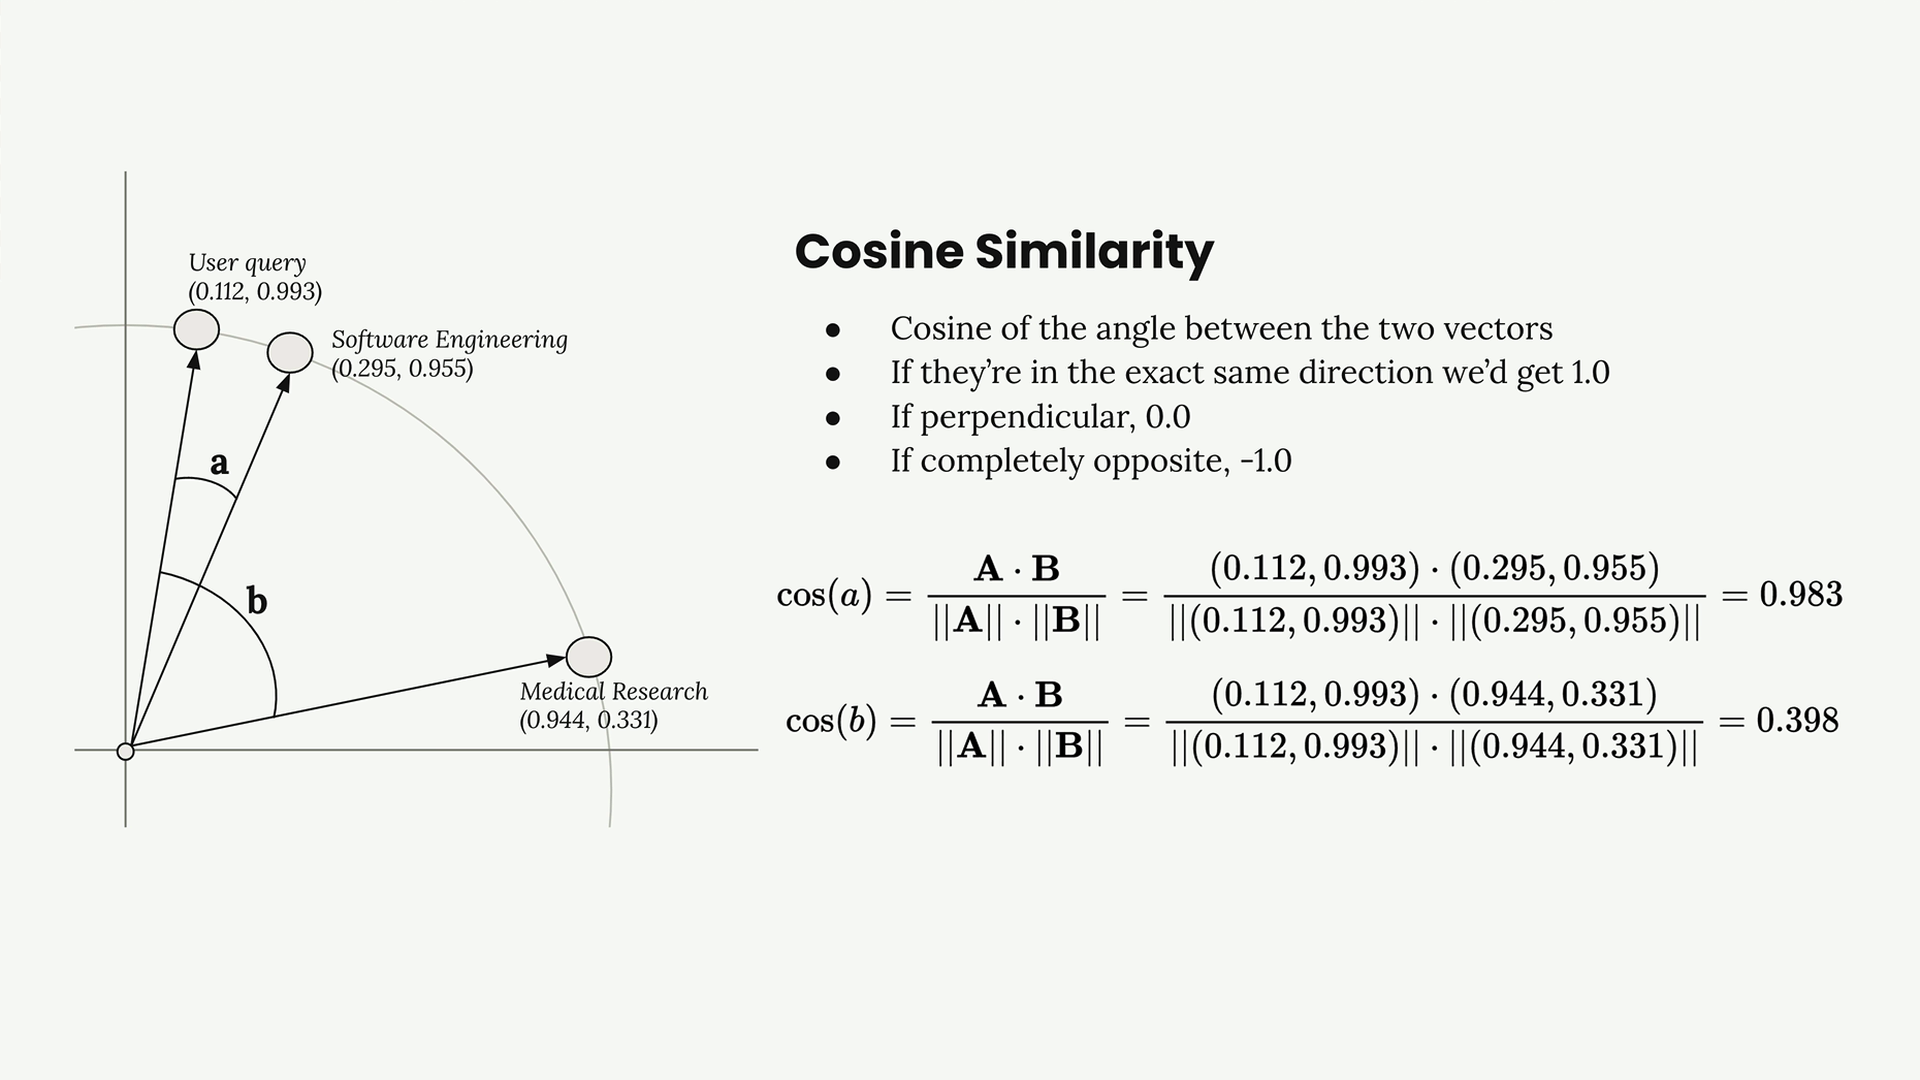
Après normalisation, nos embeddings deviennent [0.944, 0.331] et [0.295, 0.955]. Nous pouvons les visualiser sur un cercle unitaire où chaque point se situe exactement sur le bord du cercle.
Étape 3 : stocker dans une base de données vectorielle
Les embeddings normalisés sont stockés dans une base de données vectorielle - une base de données spécialisée optimisée pour stocker, comparer et rechercher parmi de longues listes de nombres comme nos embeddings.
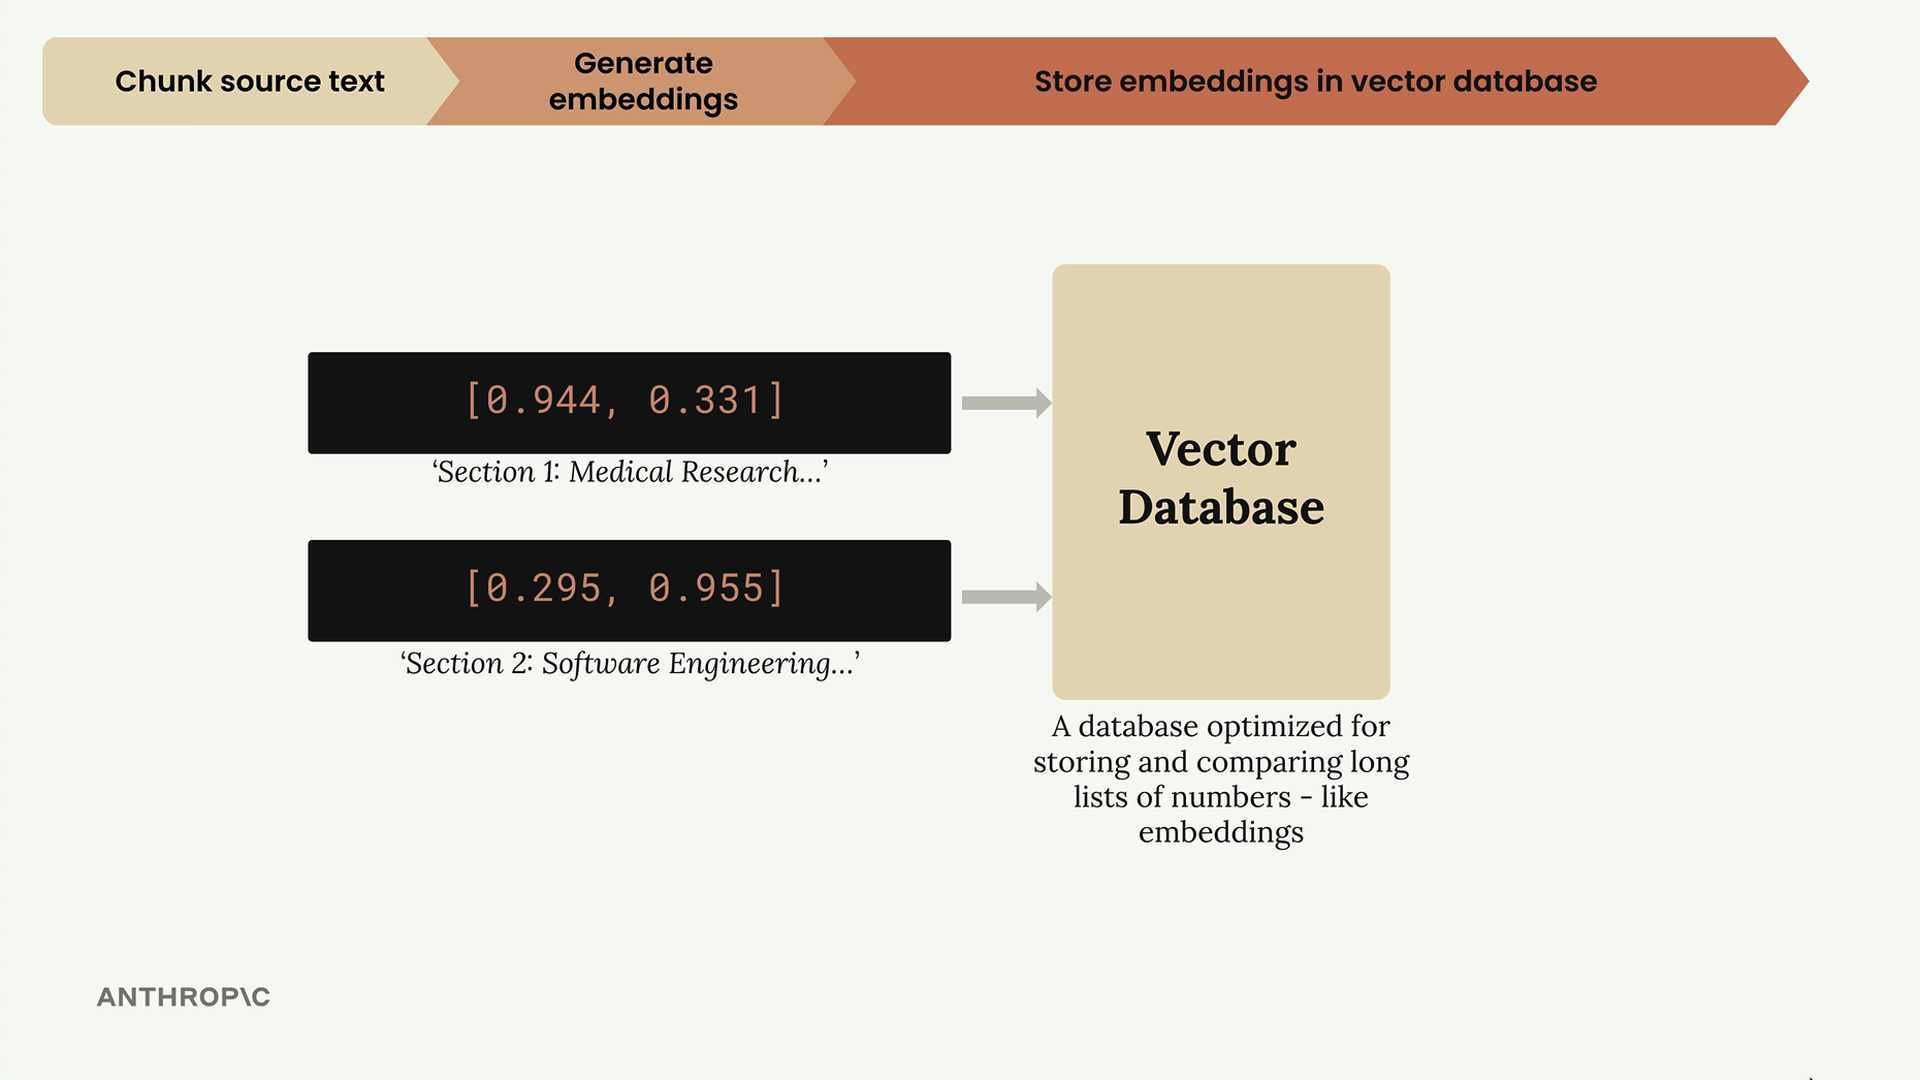
À ce stade, nous marquons une pause. Tout le travail effectué jusqu'à présent est du prétraitement qui se produit à l'avance. Maintenant, nous attendons qu'un utilisateur soumette une requête.
Étape 4 : traiter la requête de l'utilisateur
Lorsqu'un utilisateur pose une question comme « Je suis curieux à propos de l'entreprise. En particulier, qu'a fait le service d'ingénierie logicielle cette année ? », nous faisons passer sa requête par le même modèle d'embedding.
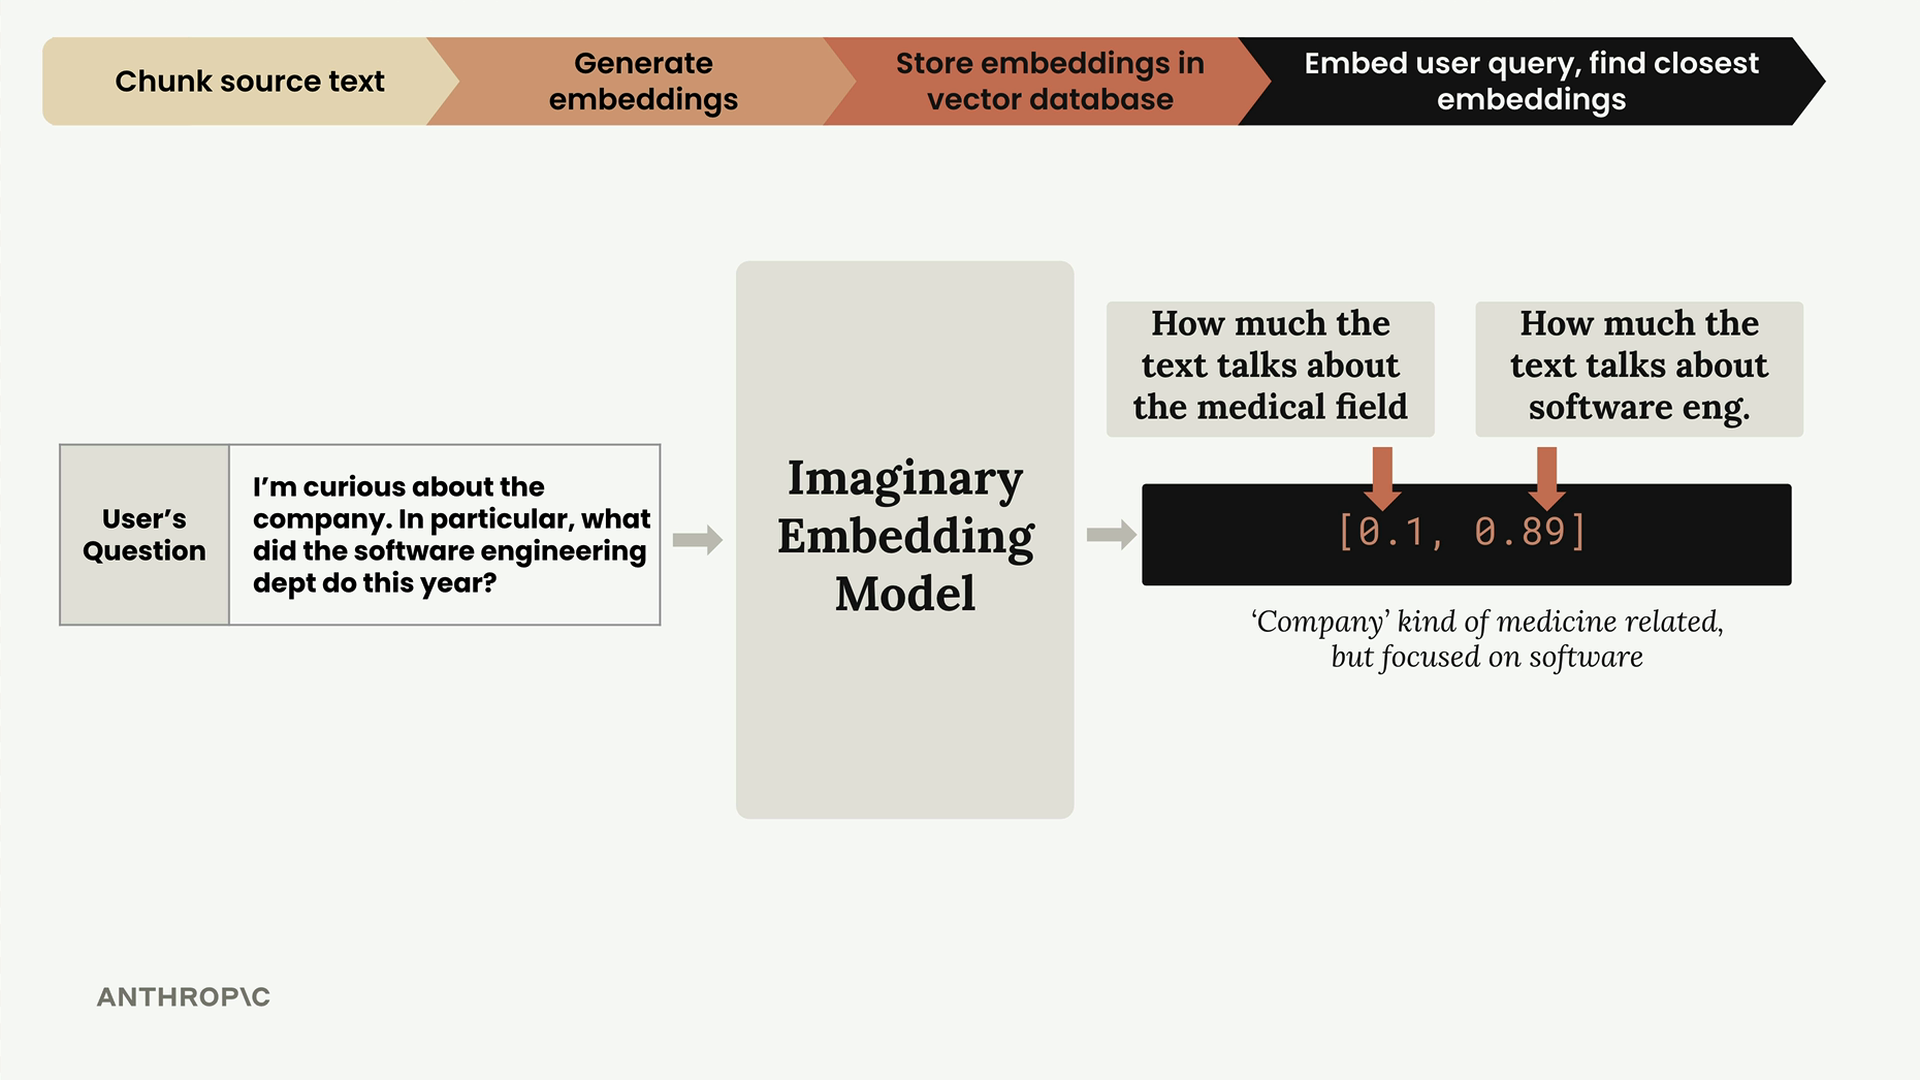
Cette requête est intégrée sous la forme [0.1, 0.89] - score médical faible, score d'ingénierie logicielle élevé. Après normalisation, elle devient [0.112, 0.993].
Étape 5 : trouver des embeddings similaires
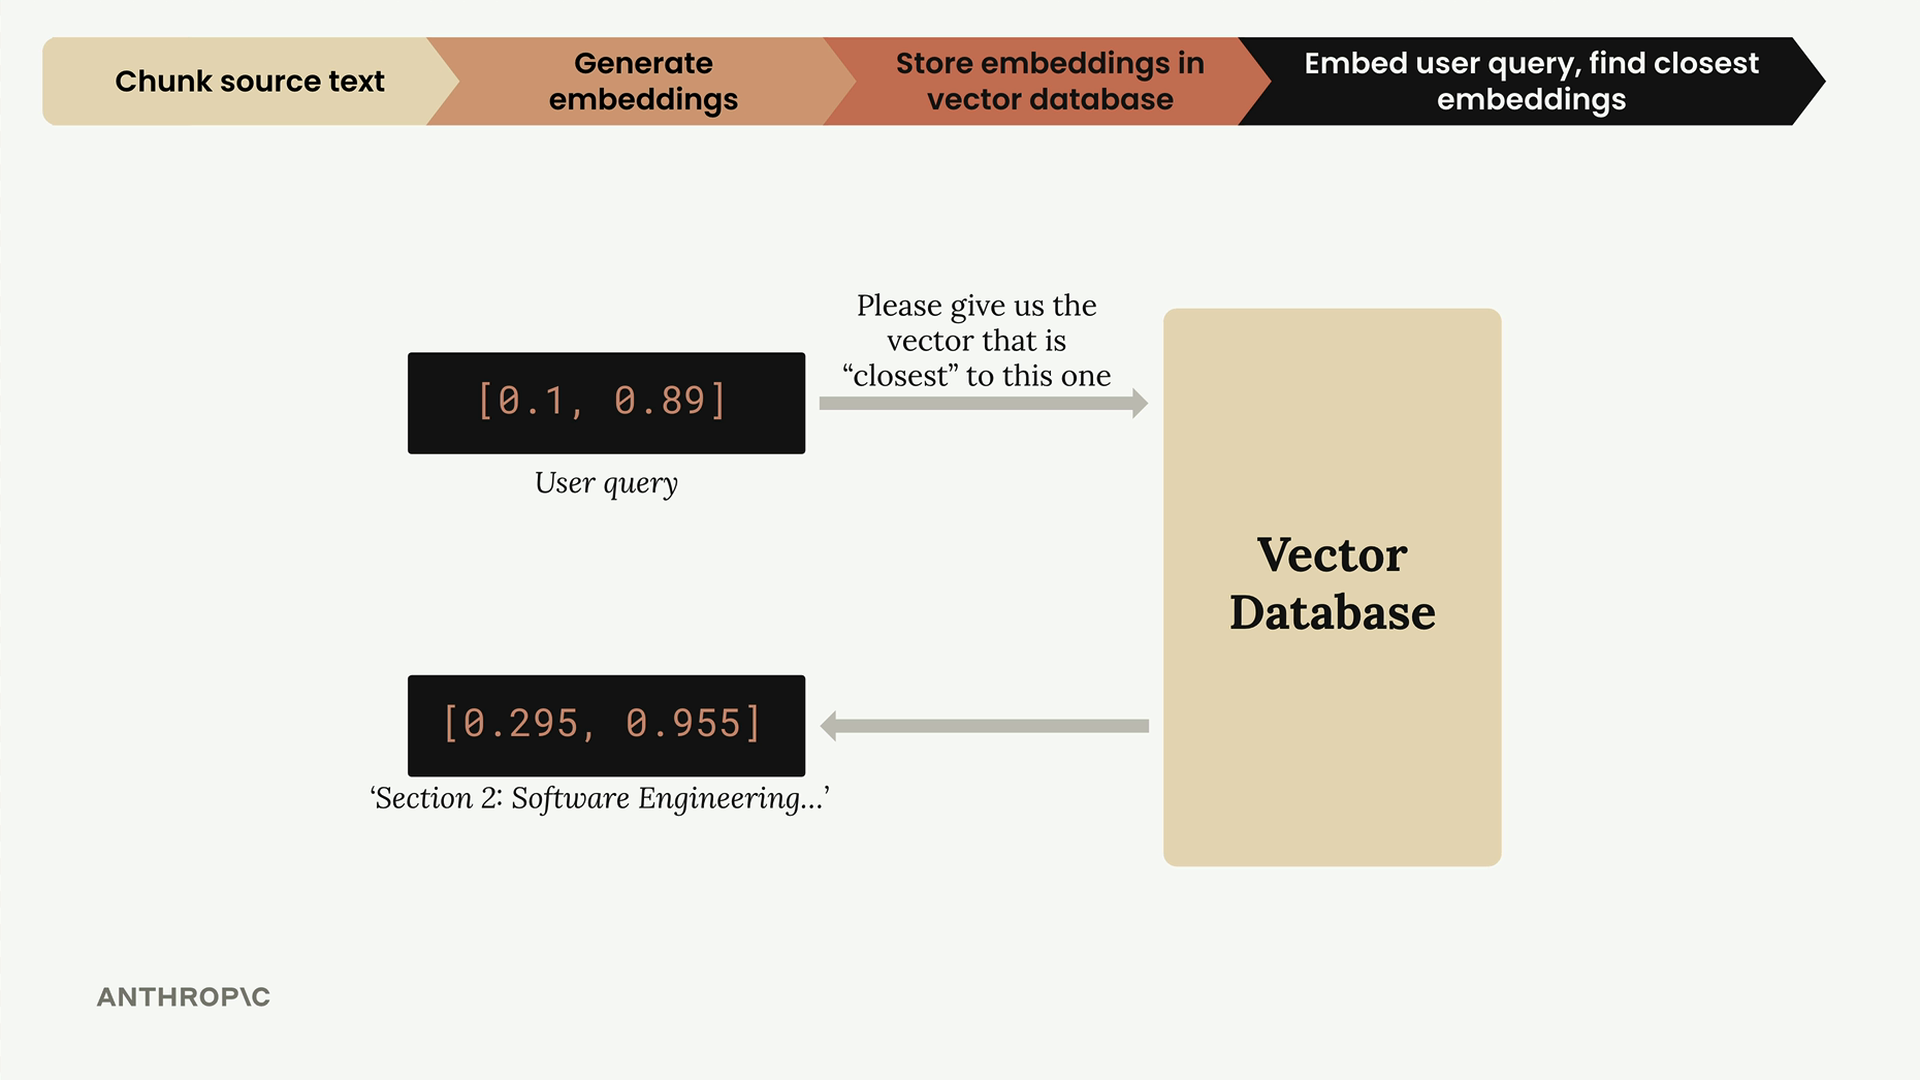
Maintenant, nous demandons à la base de données vectorielle : « Trouve l'embedding stocké le plus proche de cet embedding de requête utilisateur. » La base de données renvoie la section d'ingénierie logicielle car c'est la plus similaire.
Comment fonctionne la similarité : la similarité cosinus
La base de données vectorielle utilise la similarité cosinus pour déterminer quels embeddings sont les plus similaires. Cette mesure correspond au cosinus de l'angle entre deux vecteurs.
Points clés à propos de la similarité cosinus :
- Les résultats vont de -1 à 1
- Des valeurs proches de 1 signifient une forte similarité
- Des valeurs proches de 0 signifient une perpendicularité (absence de lien)
- Des valeurs proches de -1 signifient une opposition complète
Le calcul utilise la formule du produit scalaire : cos(a) = (A · B) / (||A|| · ||B||)
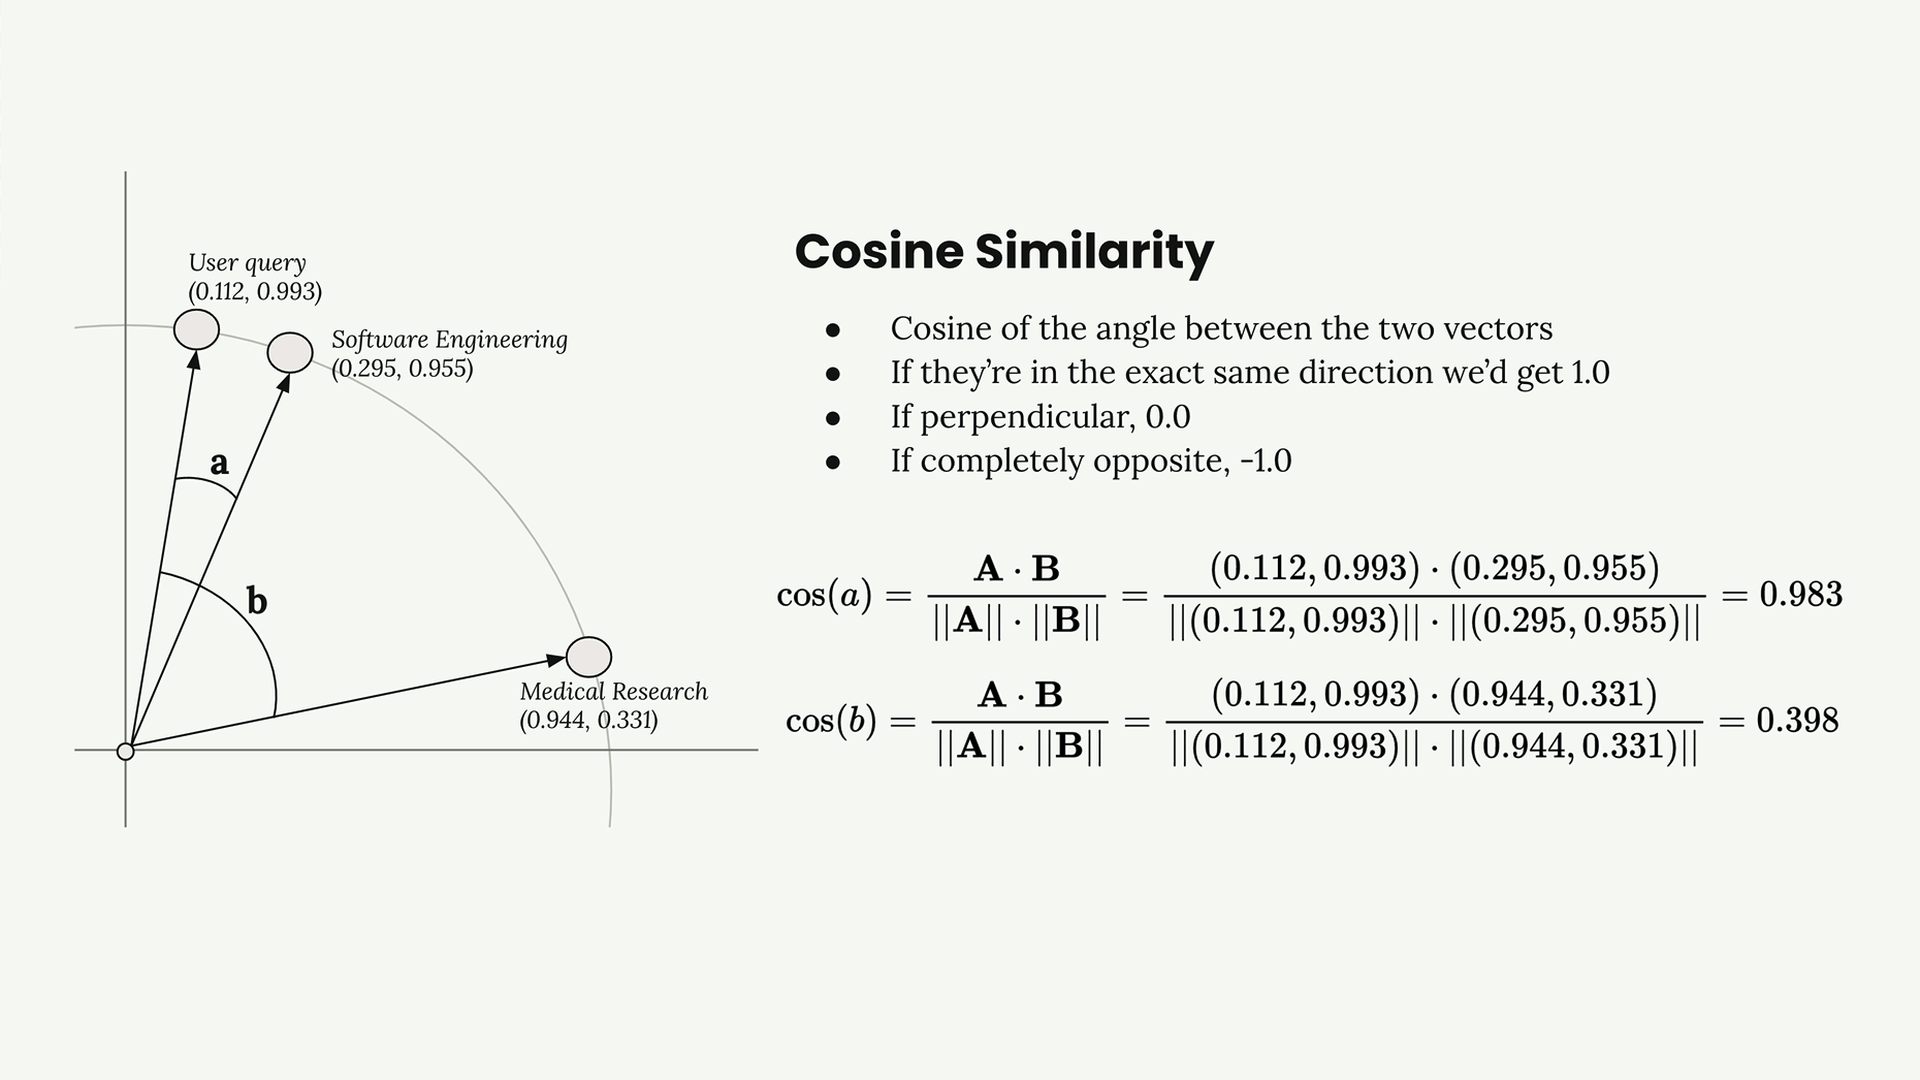
Dans notre exemple, la requête de l'utilisateur a une similarité cosinus de 0,983 avec le segment d'ingénierie logicielle et seulement 0,398 avec le segment de recherche médicale. Le segment d'ingénierie logicielle est clairement la meilleure correspondance.
Distance cosinus
Vous rencontrerez souvent la « distance cosinus » dans la documentation des bases de données vectorielles. Il s'agit simplement de 1 - similarité cosinus, ce qui nous donne un nombre plus facile à interpréter où :
- Des valeurs proches de 0 signifient une forte similarité
- Des valeurs plus élevées signifient une similarité moindre
Étape 6 : construire la requête finale
Enfin, nous prenons la question de l'utilisateur et le segment de texte le plus pertinent que nous avons trouvé, puis nous les combinons en une requête pour Claude :
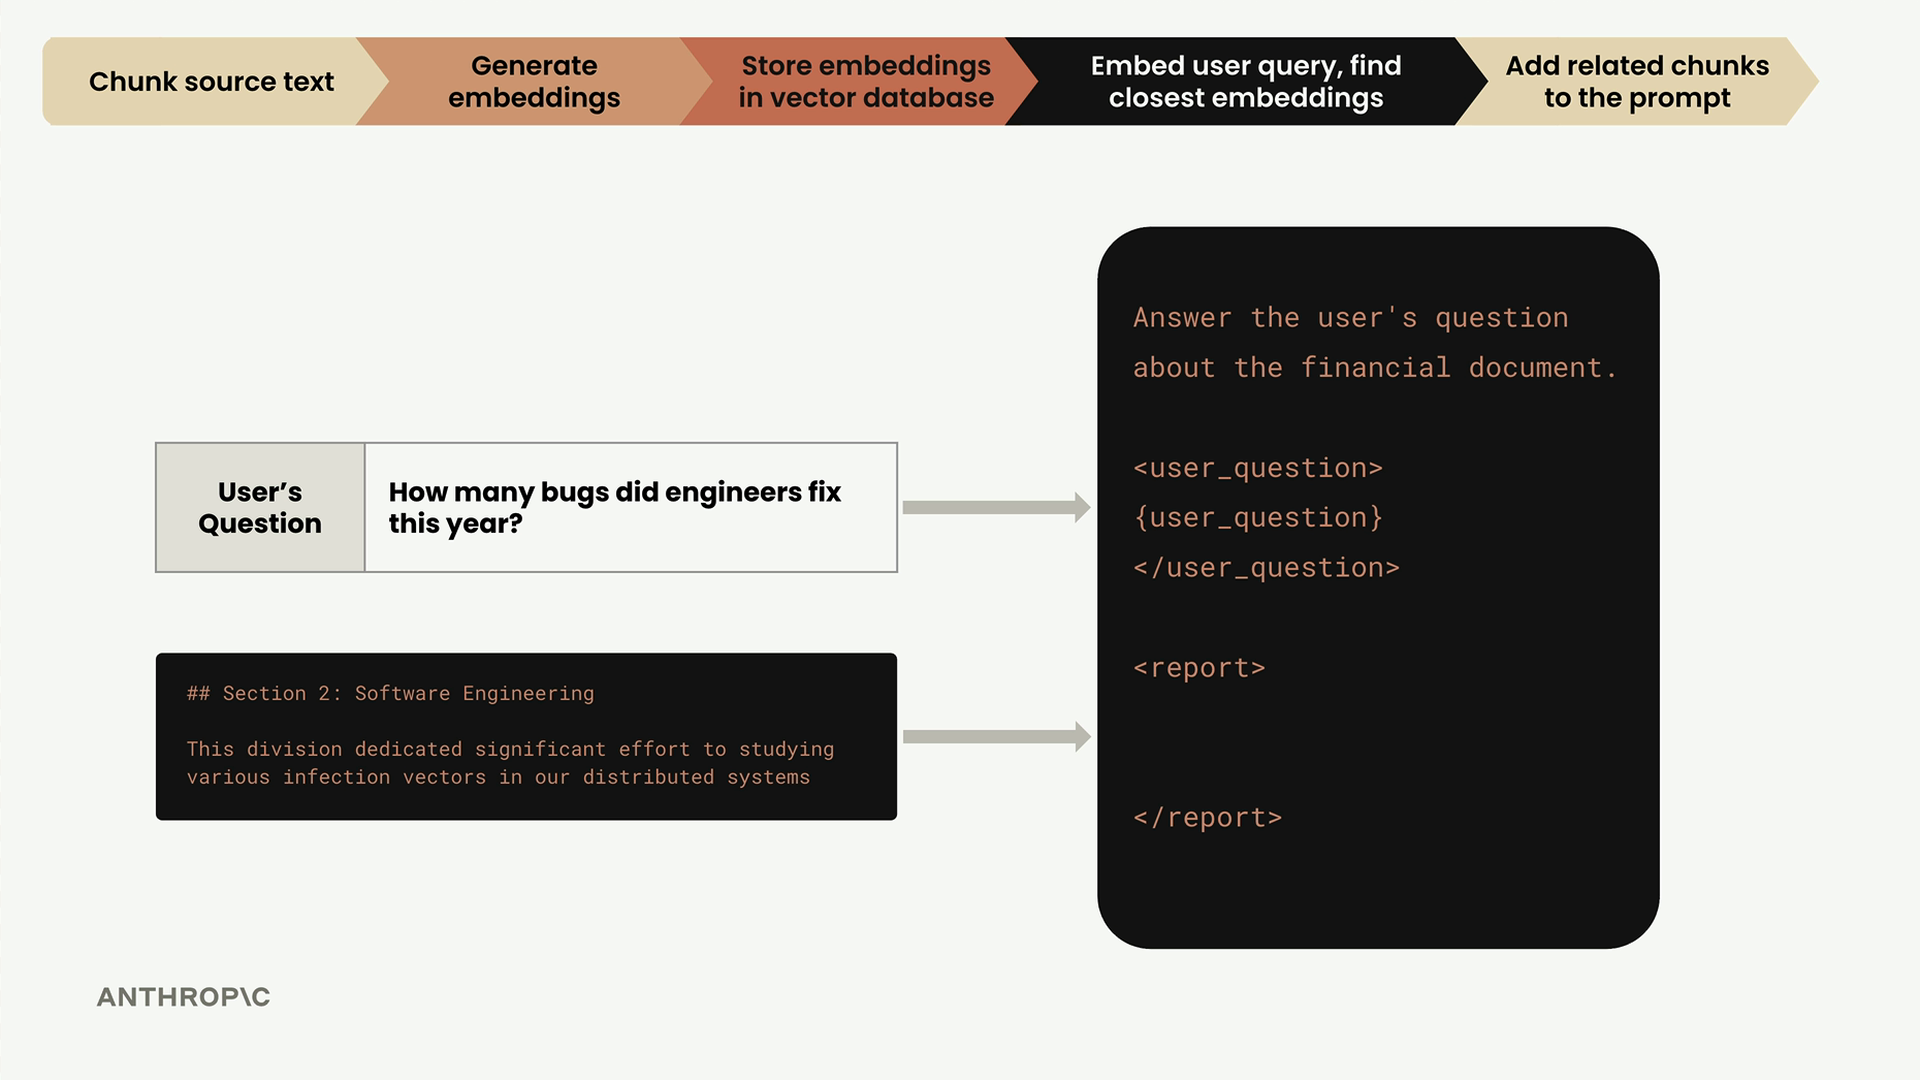
La requête inclut à la fois la question de l'utilisateur et le contexte pertinent issu de notre document, permettant à Claude de fournir une réponse informée basée sur les informations spécifiques de notre base de connaissances.
Le flux complet
Voilà l'ensemble du pipeline RAG, du début à la fin :
- Découper les documents source en segments
- Générer des embeddings pour chaque segment
- Stocker les embeddings dans une base de données vectorielle
- Lorsqu'un utilisateur pose une question, intégrer sa requête
- Trouver les embeddings stockés les plus similaires à l'aide de la similarité cosinus
- Ajouter les segments pertinents à une requête accompagnée de la question de l'utilisateur
- Envoyer la requête enrichie à Claude pour obtenir une réponse
Comprendre ce processus et les mathématiques qui le sous-tendent vous aidera à travailler efficacement avec les bases de données vectorielles et à déboguer les problèmes lorsque votre système RAG ne renvoie pas les résultats attendus.