La génération augmentée par récupération (Retrieval Augmented Generation, ou RAG) est une technique qui vous aide à travailler avec de grands documents en les décomposant en petits fragments et en ne transmettant à Claude que les fragments les plus pertinents pour chaque question. Plutôt que de submerger le modèle avec un rapport financier entier de 800 pages, le RAG vous permet d'extraire uniquement les sections pertinentes pour répondre à des requêtes spécifiques.
Le problème des grands documents
Lorsque vous disposez d'un document volumineux et souhaitez poser à Claude des questions spécifiques à ce sujet, vous êtes confronté à un défi fondamental : comment transmettre à Claude les bonnes informations sans atteindre de limites ni dégrader les performances ?
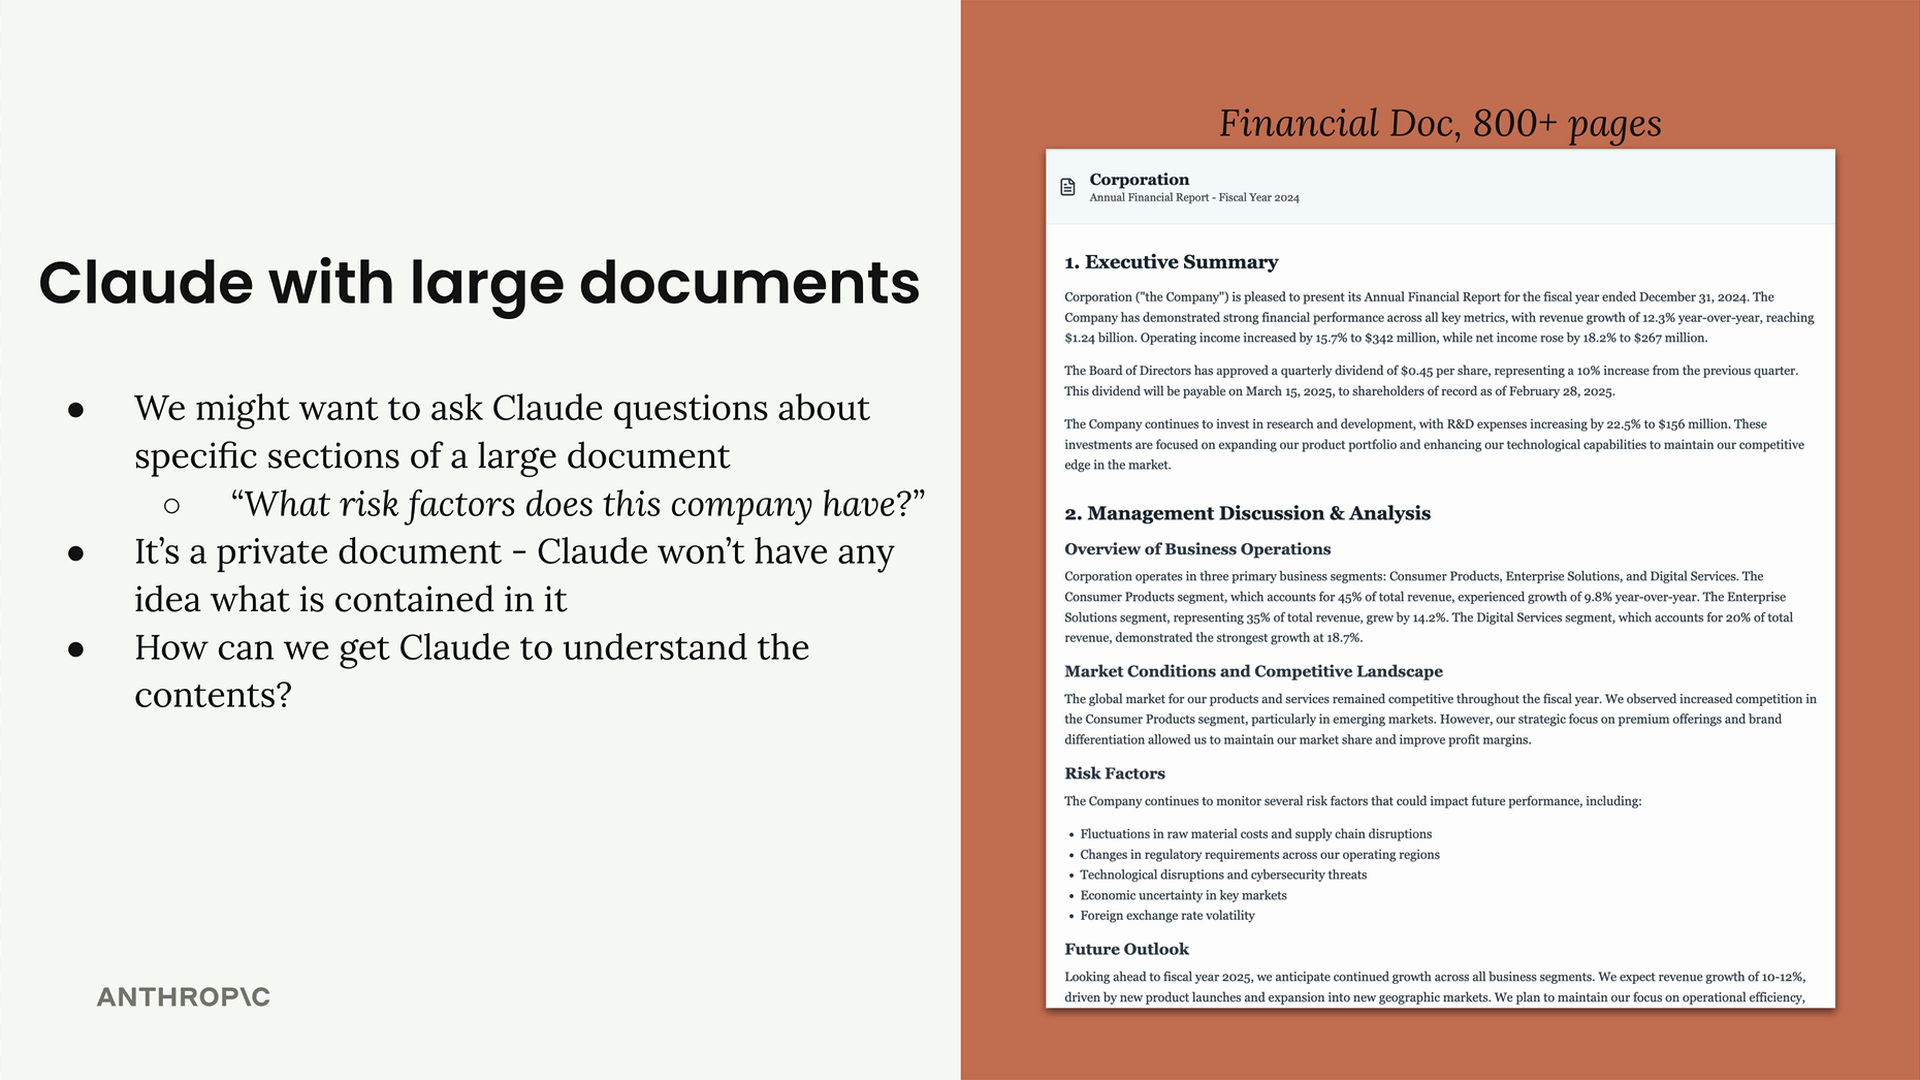
Imaginons que vous posiez la question « Quels sont les facteurs de risque de cette entreprise ? » à propos d'un long document financier. Le document contient la réponse, mais Claude a besoin d'accéder au contenu pertinent pour vous aider.
Option 1 : tout inclure dans la requête
L'approche la plus simple consiste à extraire tout le texte du document et à le faire tenir dans une seule requête :
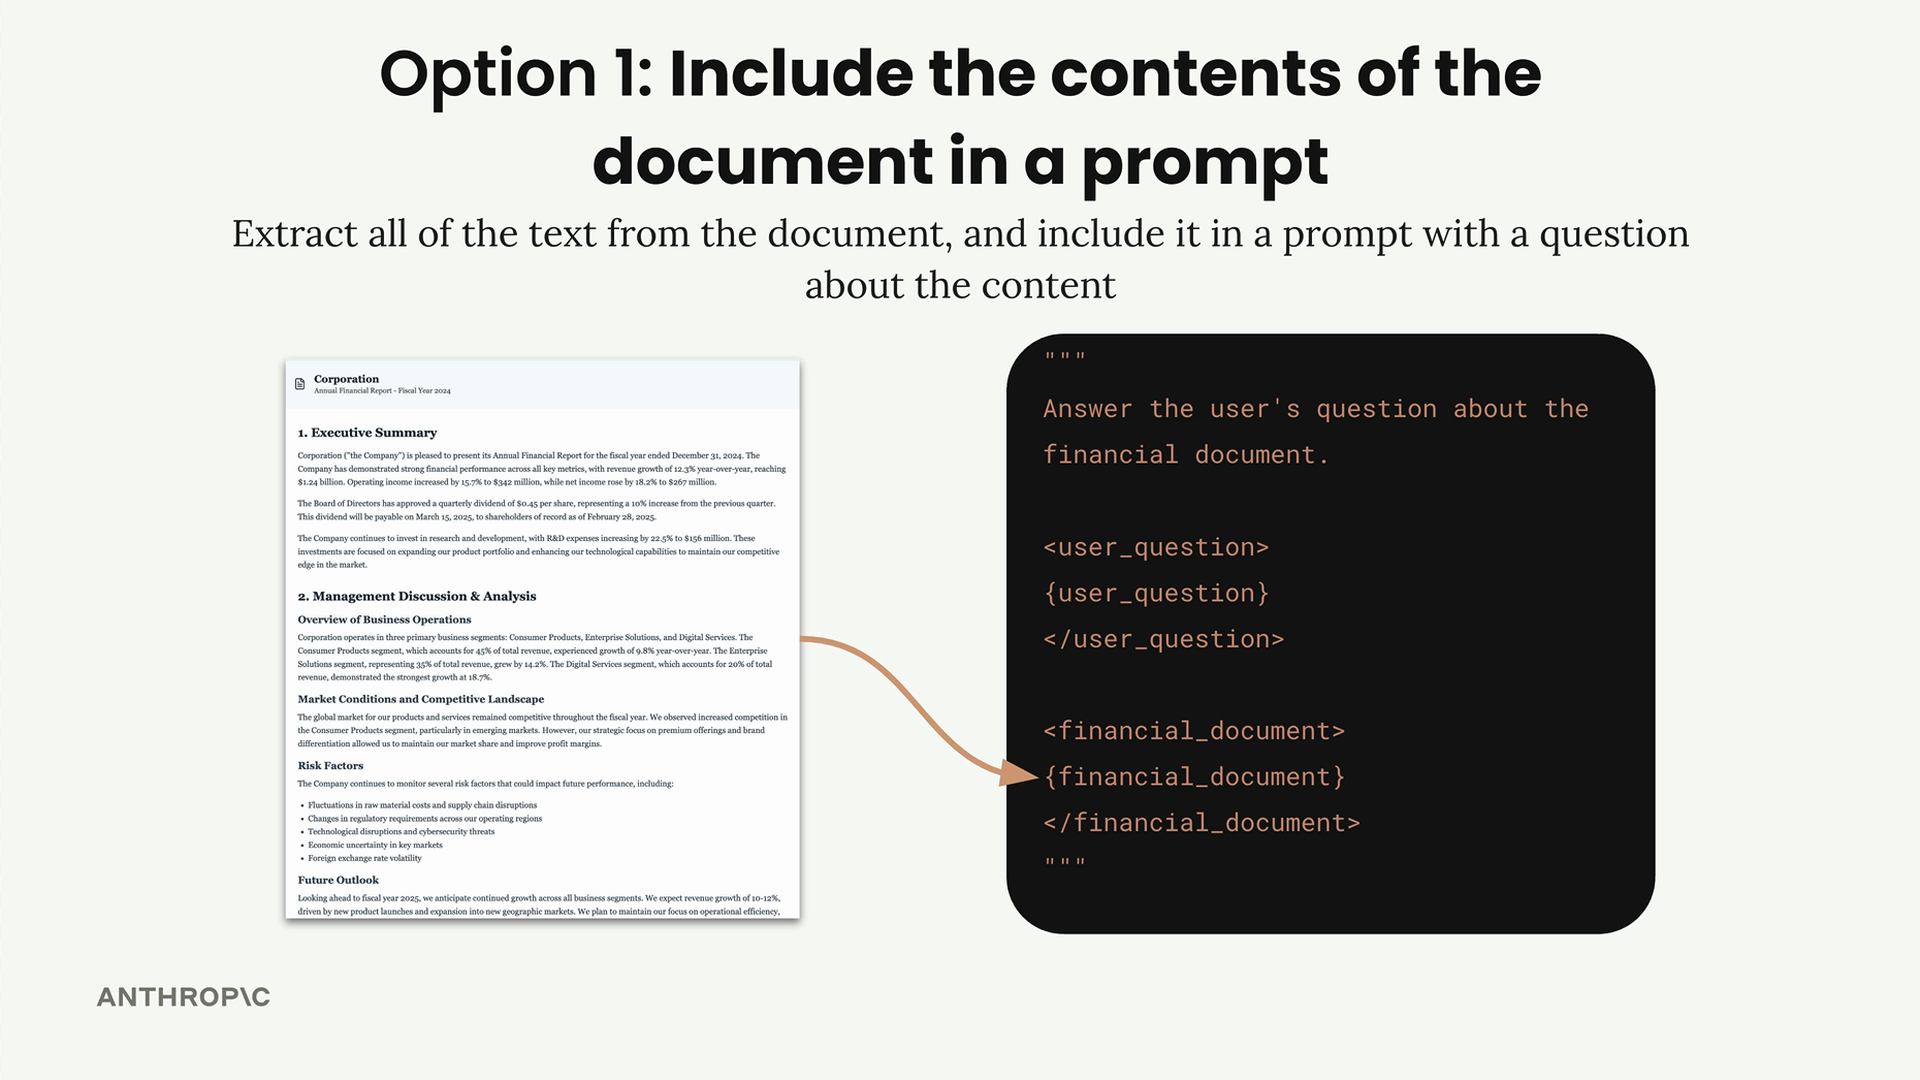
Cette méthode présente de sérieuses limites :
- Des limites strictes de jetons font que les documents très longs ne tiennent tout simplement pas
- Claude devient moins efficace avec des requêtes extrêmement longues
- Des requêtes plus volumineuses coûtent plus cher et prennent plus de temps à traiter
- Les performances se dégradent lorsqu'il y a trop d'informations à passer en revue
Option 2 : découper les documents en fragments
Le RAG adopte une approche plus intelligente en prétraitant les documents pour en faire des fragments exploitables, puis en ne récupérant que les fragments pertinents pour chaque question.
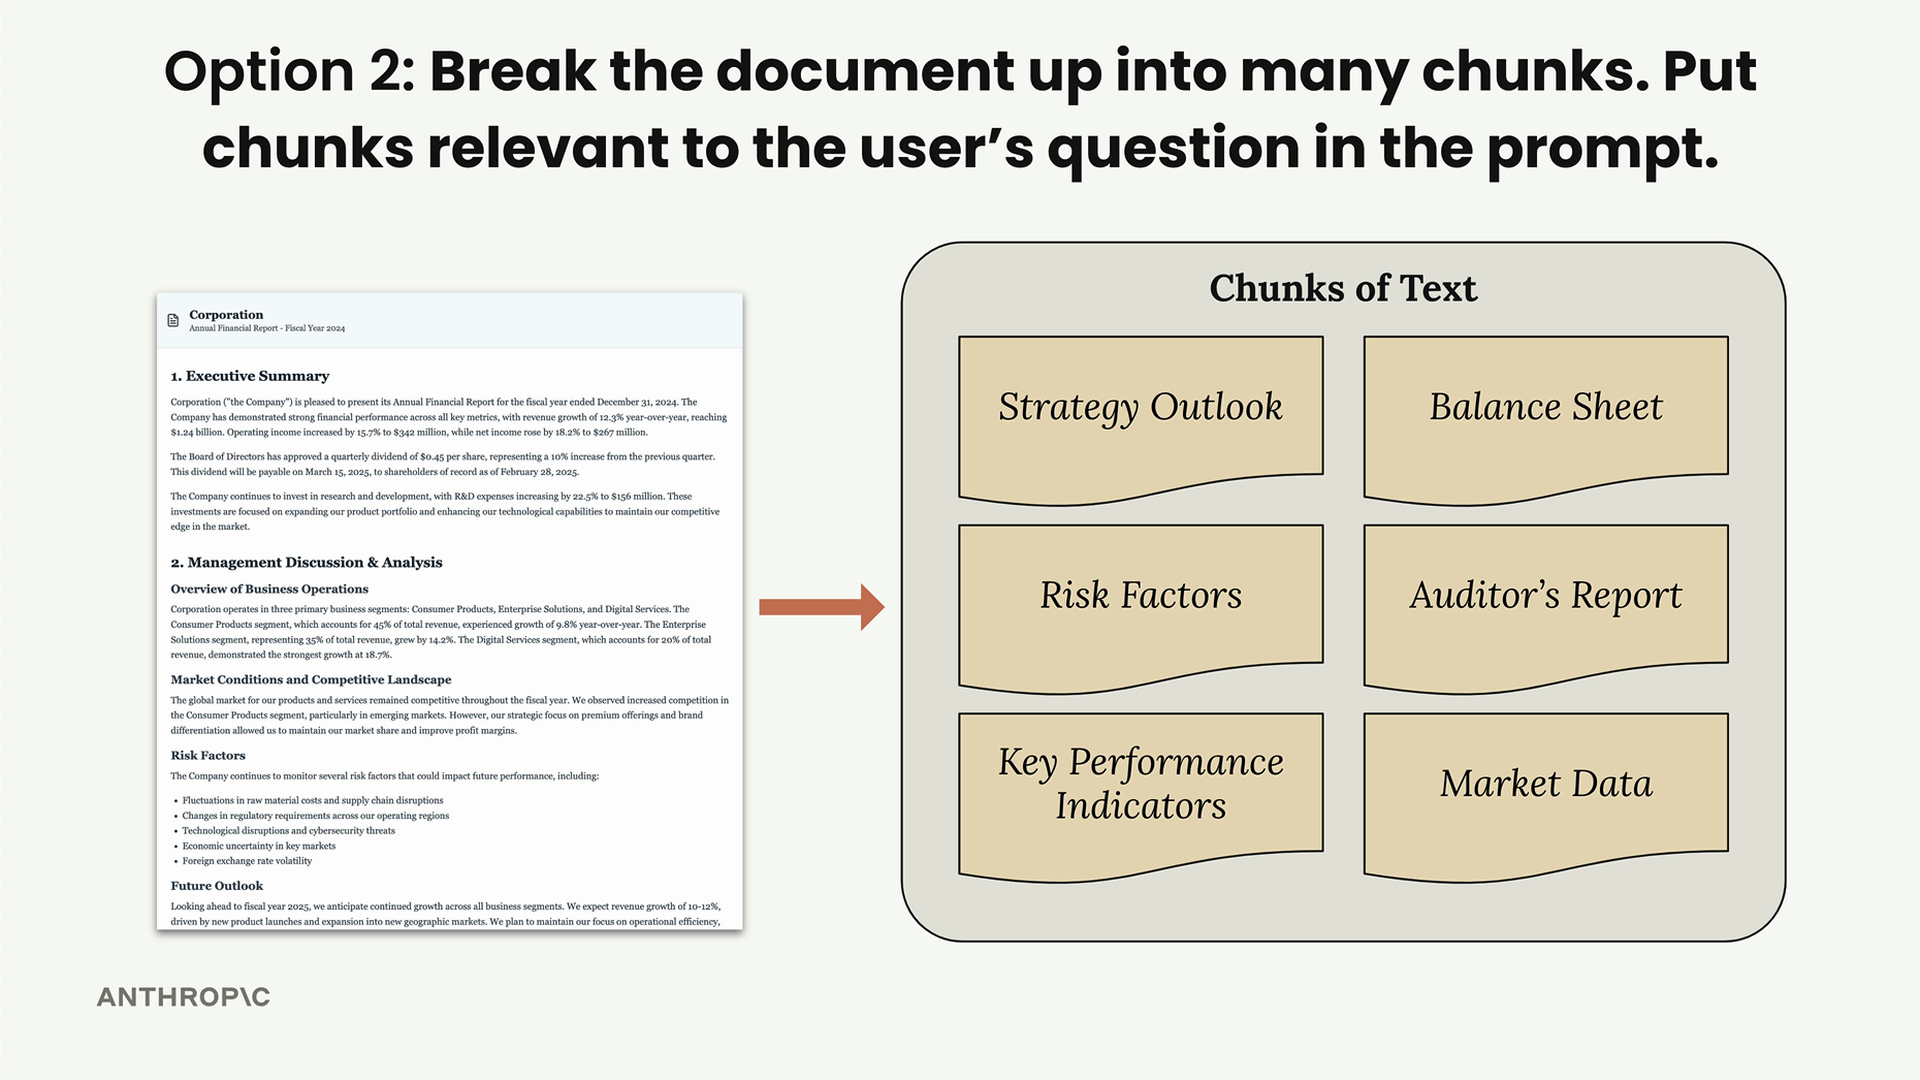
Voici comment cela fonctionne :
- Diviser le document en fragments plus petits (Perspectives stratégiques, Facteurs de risque, Bilan, etc.)
- Lorsqu'un utilisateur pose une question, analyser ce qu'il recherche
- Identifier les fragments les plus pertinents par rapport à sa question
- N'inclure que ces fragments pertinents dans la requête envoyée à Claude
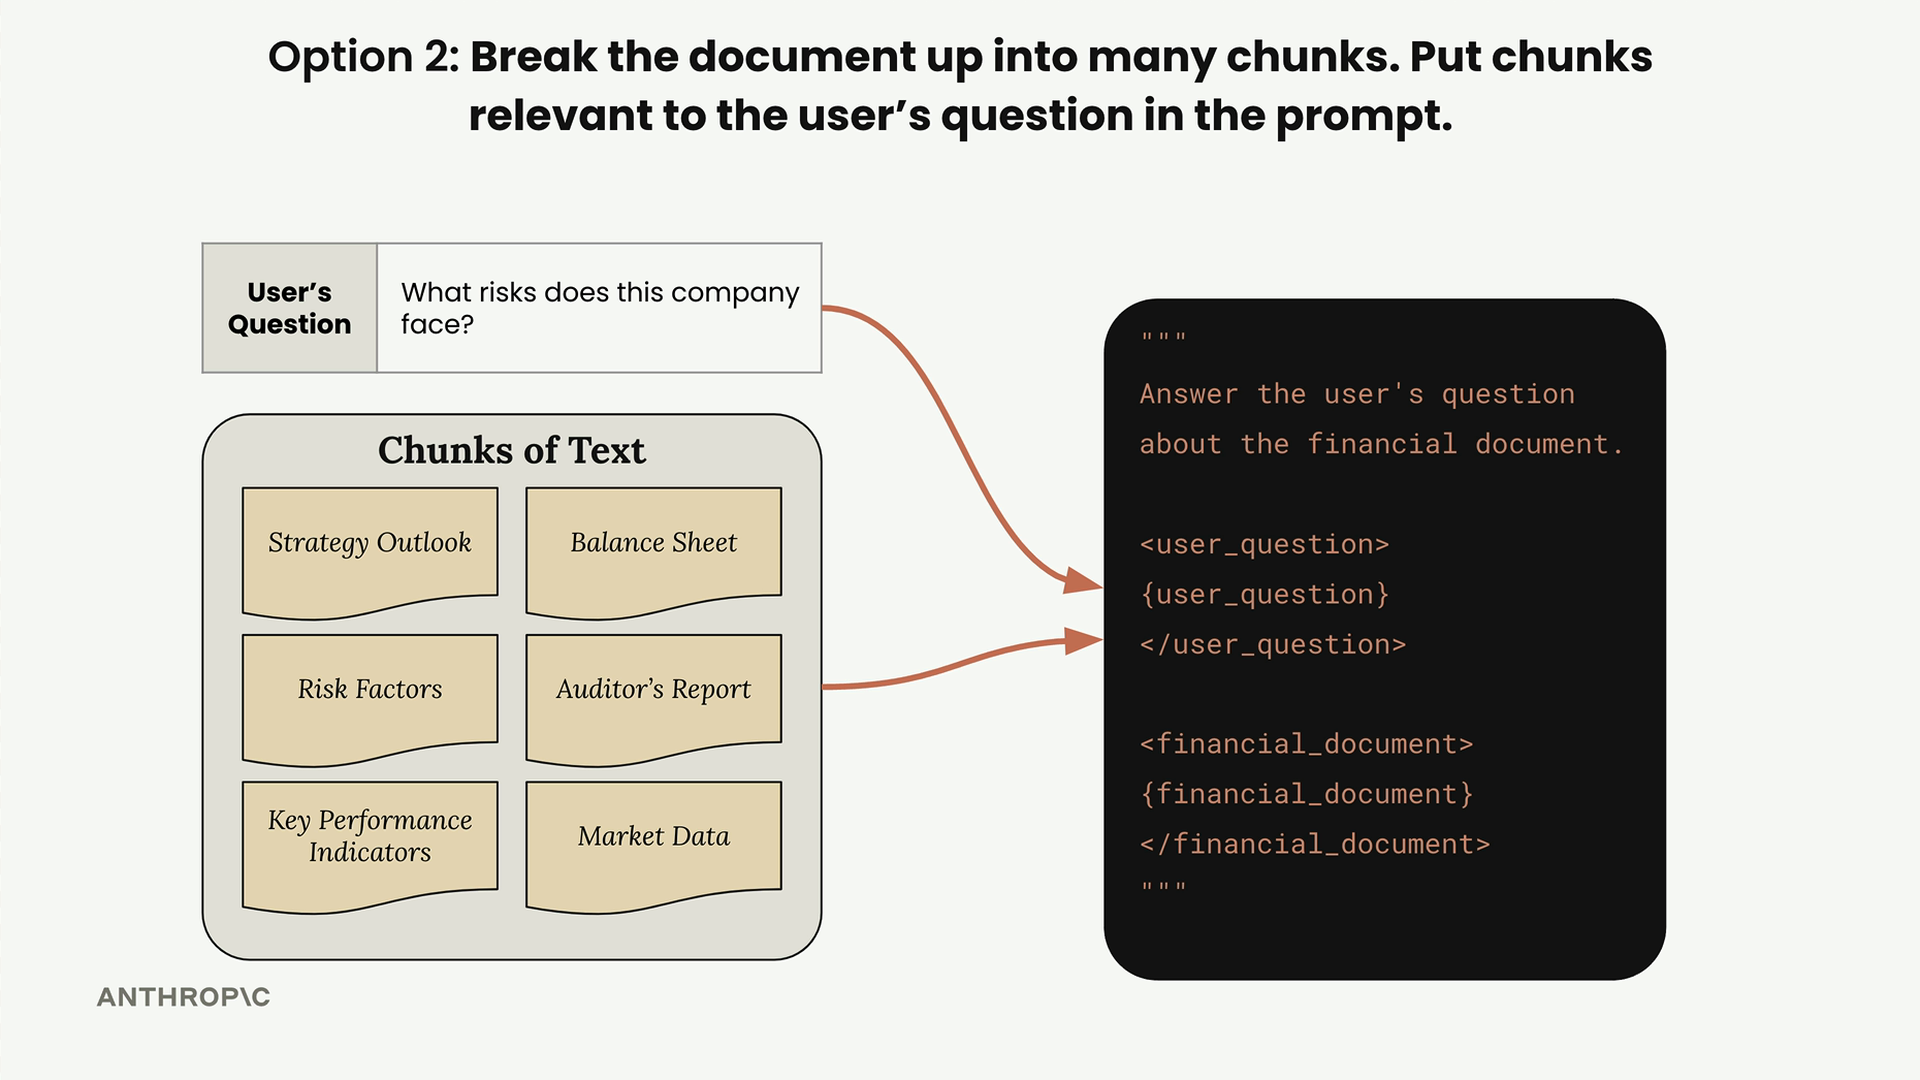
Pour une question concernant les risques de l'entreprise, le système identifierait et récupérerait le fragment « Facteurs de risque », offrant à Claude un contexte ciblé et pertinent plutôt que le document entier.
Avantages du RAG
- Claude peut se concentrer uniquement sur le contenu le plus pertinent
- S'adapte à de très grands documents et à plusieurs documents
- Fonctionne sur des ensembles de documents, pas seulement sur des fichiers uniques
- Des requêtes plus petites signifient un traitement plus rapide et des coûts moindres
Difficultés liées au RAG
Le RAG introduit une complexité que vous devez gérer :
- Nécessite une étape de prétraitement pour découper les documents en fragments
- Nécessite un mécanisme de recherche pour trouver les fragments pertinents
- Les fragments récupérés peuvent ne pas contenir tout le contexte nécessaire
- De nombreuses façons différentes de découper le texte en fragments - quelle approche fonctionne le mieux ?
Vous pouvez découper les documents en portions égales, par en-têtes et sections, par signification sémantique, ou selon d'autres stratégies. Chaque approche comporte des compromis que vous devrez évaluer pour votre cas d'usage spécifique.
Quand utiliser le RAG
Le RAG est particulièrement utile lorsque vous travaillez avec de grands documents ou des ensembles de documents, dans lesquels les utilisateurs posent des questions spécifiques qui ne nécessitent qu'une partie du contenu. La complexité du prétraitement est rentable lorsque vous devez passer à une échelle supérieure à ce qui tient dans une seule requête, lorsque vous souhaitez des réponses plus rapides, ou lorsque vous gérez des coûts sur un grand nombre de requêtes.
L'essentiel est d'analyser si la charge technique liée à la mise en œuvre du découpage, de la recherche et de la récupération est justifiée pour votre application particulière. Parfois, l'approche simple consistant à « tout déverser dans une requête » fonctionne bien - d'autres fois, le RAG devient essentiel pour rendre votre système pratique et performant.