L'approche de recherche hybride que nous avons mise en place fonctionne bien, mais il subsiste encore quelques aspérités. Lorsque vous recherchez des termes spécifiques ou utilisez des abréviations, les résultats peuvent ne pas être parfaitement ordonnés. Par exemple, la question « Qu'a fait l'équipe d'ingénierie avec INC-2023-Q4-011 ? » pourrait renvoyer en premier la section cybersécurité, alors même que la section ingénierie logicielle est plus pertinente pour cette requête spécifique.
Réorganisation fondée sur un LLM
La réorganisation ajoute une étape de post-traitement supplémentaire après la fusion des résultats de votre index vectoriel et de votre index BM25. Le concept est simple : prendre vos résultats de recherche et demander à Claude de les réorganiser en fonction de leur pertinence par rapport à la question de l'utilisateur.
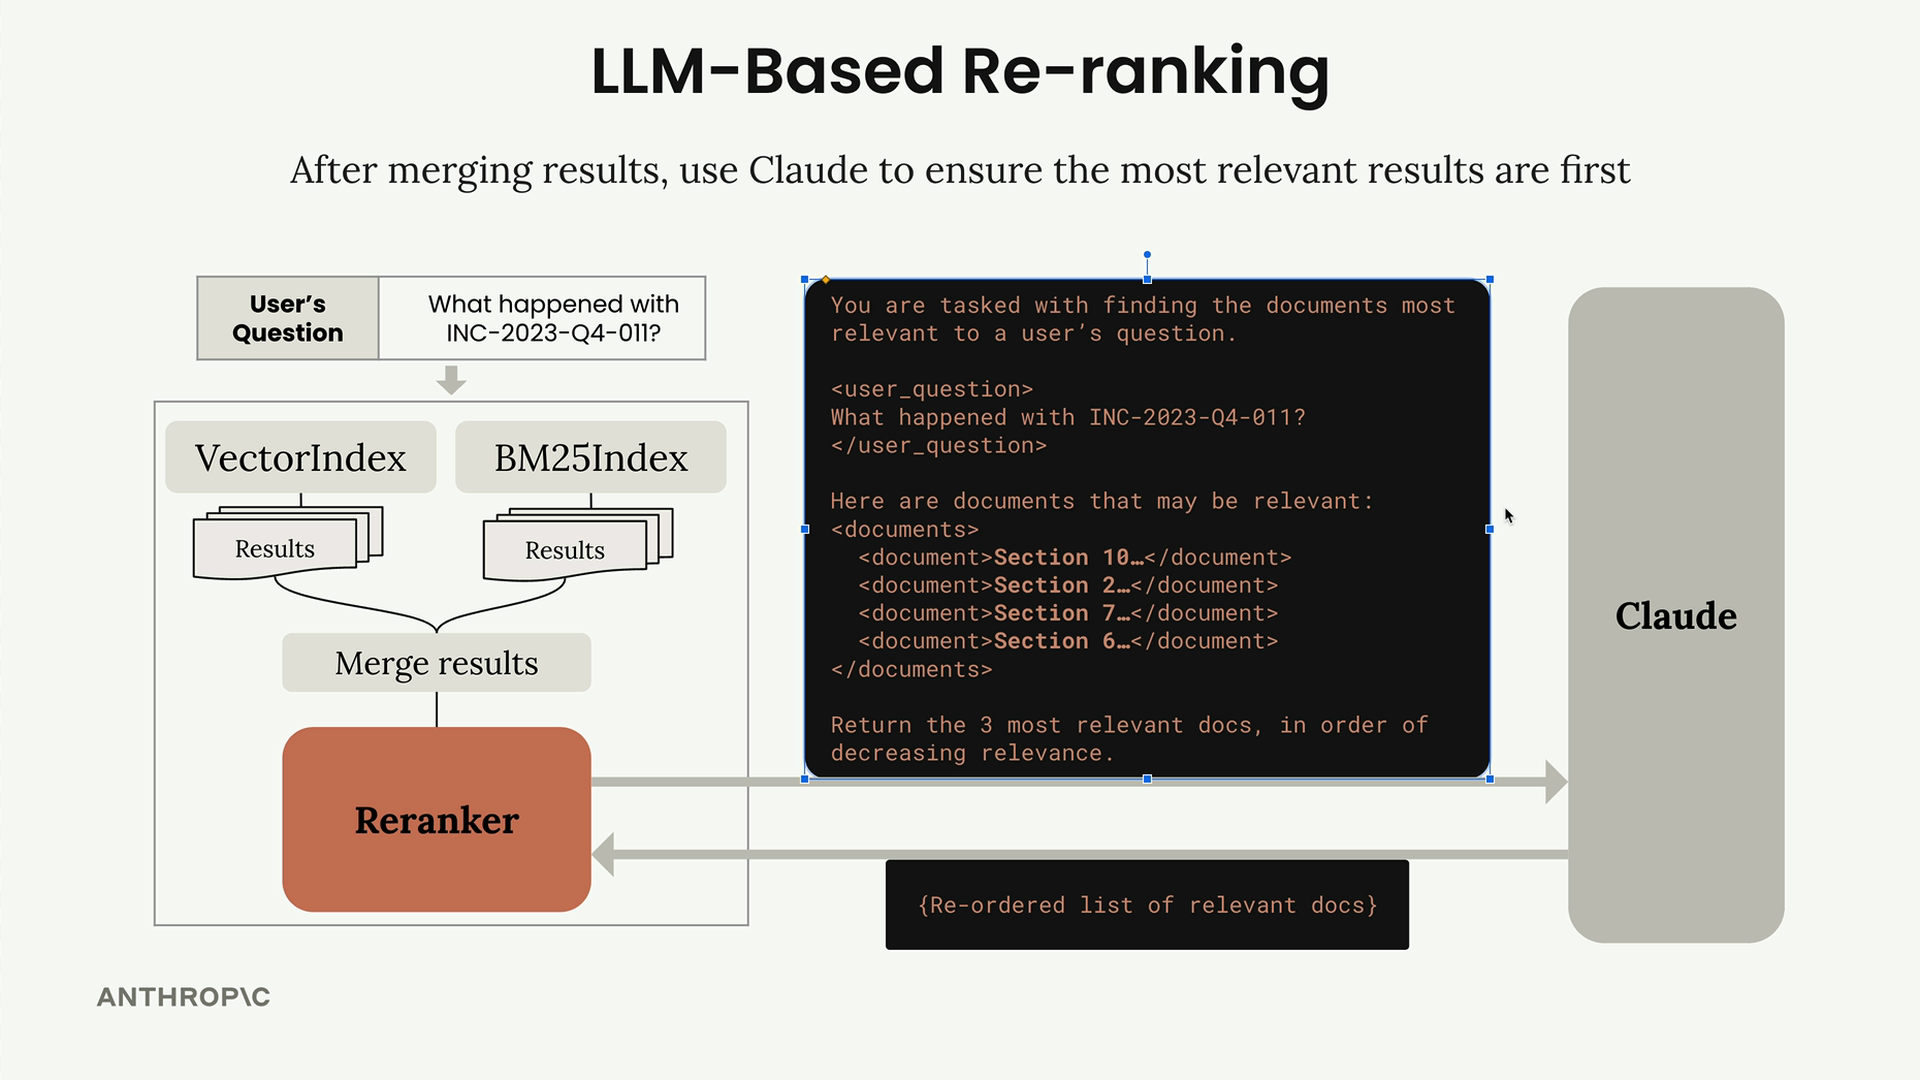
Voici comment se déroule le processus :
- Exécutez votre recherche hybride (vectorielle + BM25) comme d'habitude
- Fusionnez les résultats comme précédemment
- Transmettez les résultats fusionnés à une fonction de réorganisation
- Le réorganiseur envoie l'ensemble à Claude avec une requête spécifique
- Claude renvoie une liste réordonnée des documents les plus pertinents
Invites système
La requête de réorganisation est conçue pour être claire et précise. Vous fournissez à Claude la question de l'utilisateur ainsi que tous les documents qui semblent pertinents, puis vous lui demandez une tâche simple : renvoyer les documents les plus pertinents par ordre décroissant de pertinence.
Une structure de requête typique ressemble à ceci :
You are tasked with finding the documents most relevant to a user's question.

<user_question>
What happened with INC-2023-Q4-011?
</user_question>

Here are documents that may be relevant:
<documents>
<document>Section 10...</document>
<document>Section 2...</document>
<document>Section 7...</document>
<document>Section 6...</document>
</documents>

Return the 3 most relevant docs, in order of decreasing relevance.Considérations relatives à l'efficacité
Demander à Claude de renvoyer des extraits de texte complets serait inefficace : vous devriez attendre que Claude recopie de grandes quantités de texte. Attribuez plutôt à chaque extrait de texte un identifiant unique à l'avance. Demandez ensuite à Claude de renvoyer uniquement ces identifiants dans le bon ordre.
Cette approche est beaucoup plus rapide, car Claude n'a besoin de renvoyer qu'une simple liste comme ["1p5g", "51n3", "ab83"] au lieu de recopier des sections de documents entières.
Implémentation
La fonction de réorganisation est appelée automatiquement par votre récupérateur après la recherche hybride initiale. Voici la structure de base :
def reranker_fn(docs, query_text, k):
    # Mettre en forme les documents avec leurs ID
    joined_docs = "\n".join([
        f"<document><document_id>{doc['id']}</document_id>"
        f"<document_content>{doc['content']}</document_content></document>"
        for doc in docs
    ])

    # Créer la requête avec la question de l'utilisateur et les documents
    prompt = f"""You are about to be given a set of documents...
    {query_text}
    {joined_docs}
    """

    # Récupérer la réponse de Claude et analyser les ID des documents
    result = chat(messages, stop_sequences=["```"])
    return json.loads(result["text"])["document_ids"]
Résultats
Lorsque vous testez le réorganiseur avec des requêtes telles que « Qu'a fait l'équipe d'ingénierie avec INC-2023-Q4-011 ? », vous devriez voir apparaître des résultats plus pertinents en haut de la liste. Claude comprend le contexte et peut identifier qu'une requête portant sur l'équipe d'ingénierie devrait privilégier la section ingénierie logicielle plutôt que d'autres sections qui ne font que mentionner l'incident.
Le compromis est clair : la réorganisation augmente la latence, car vous devez attendre la réponse de Claude, mais elle améliore considérablement la précision de la recherche en exploitant la compréhension du contexte et de la pertinence de Claude.