Effectuer votre première requête API vers AWS Bedrock nécessite trois composants essentiels : un client Bedrock Runtime pour se connecter au service, un Model ID pour spécifier quel modèle vous souhaitez exécuter, et un message utilisateur contenant le texte que vous souhaitez transmettre au modèle.
Configuration du client Bedrock
Le client signe chaque requête avec vos identifiants AWS, configurez-les donc avant de commencer. Installez l'AWS CLI, puis configurez vos identifiants avec aws configure ou une autre option proposée dans le guide AWS sur les identifiants CLI(s’ouvre dans un nouvel onglet). Sans identifiants, votre première requête s'arrête avec NoCredentialsError.
Installez boto3 avec pip install boto3. Créez ensuite un client pour vous connecter au service Bedrock runtime :
import boto3

client = boto3.client("bedrock-runtime", region_name="us-west-2")
Comprendre les Model IDs et la disponibilité régionale
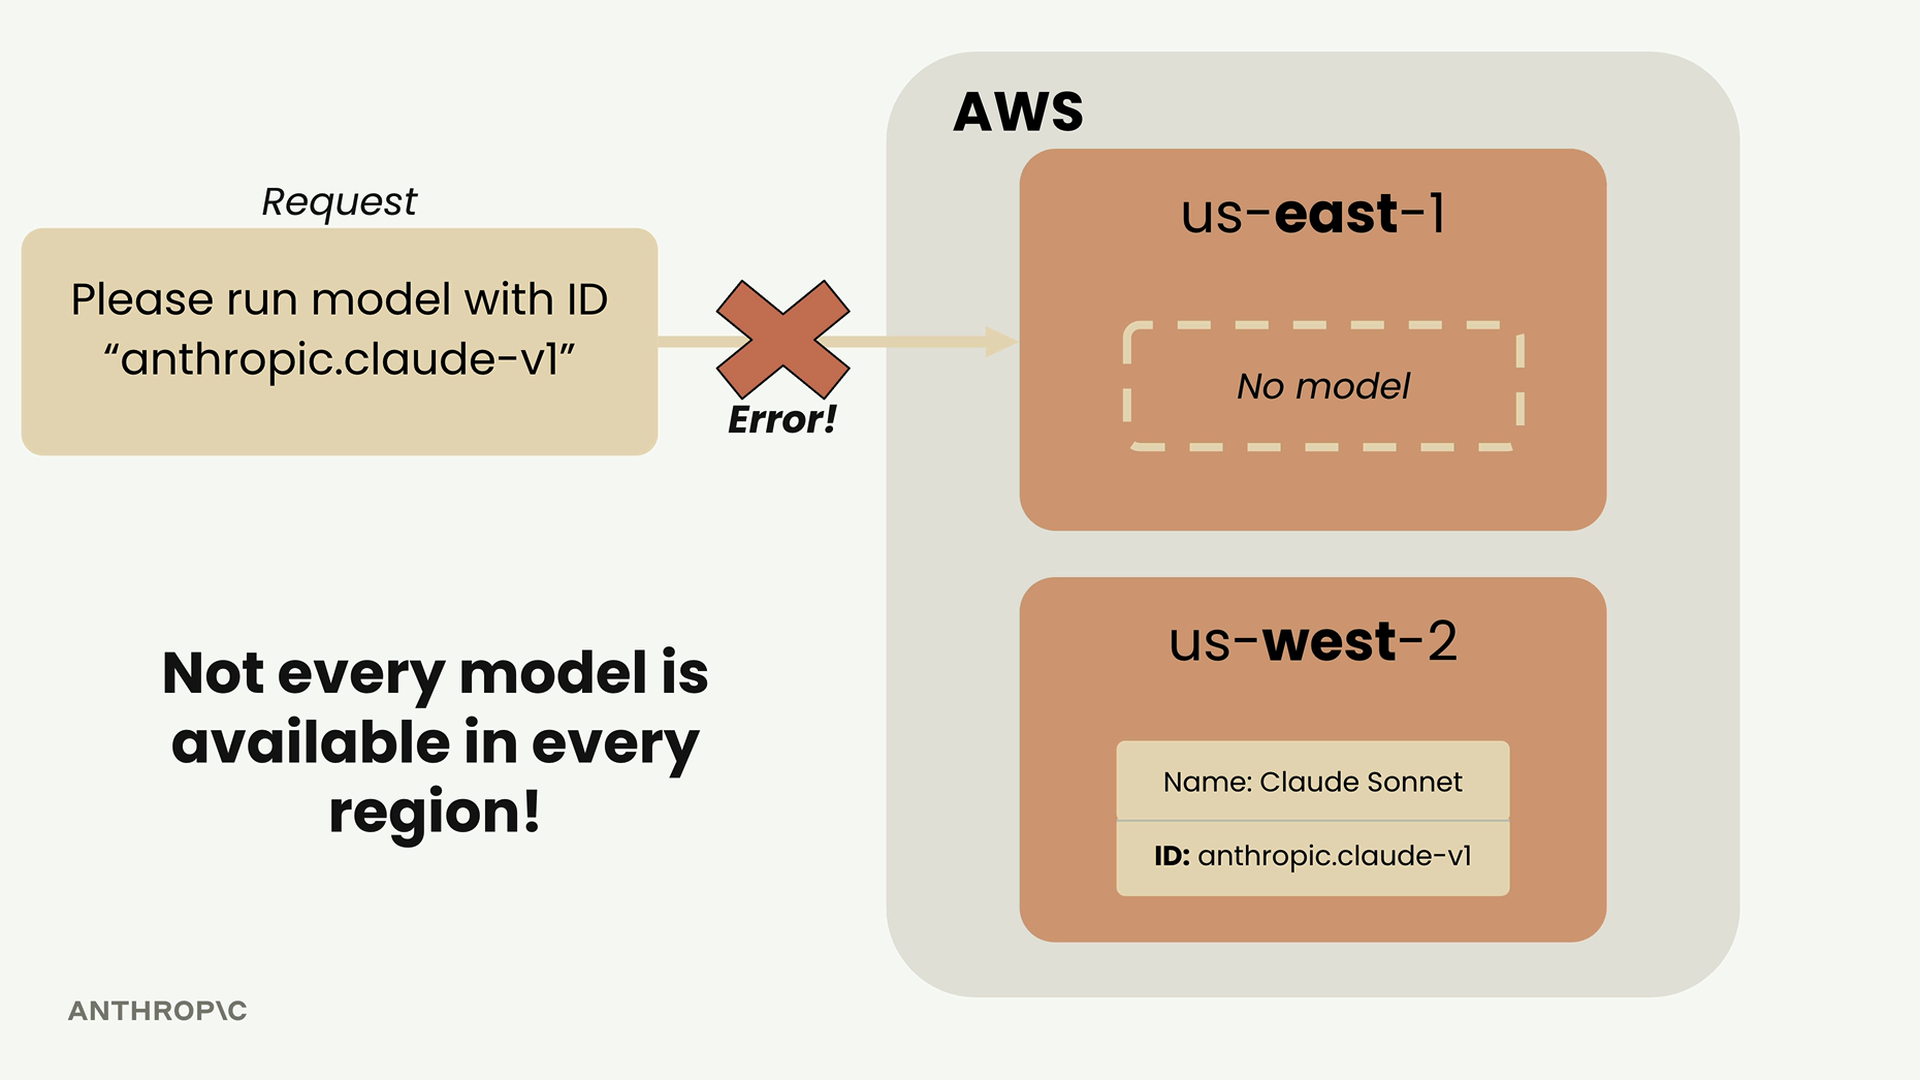
C'est là que les choses se compliquent. Tous les modèles ne sont pas disponibles dans toutes les régions AWS. Si vous essayez d'exécuter un modèle qui n'existe pas dans la région choisie, vous obtiendrez un message d'erreur cryptique indiquant que le modèle n'existe pas.
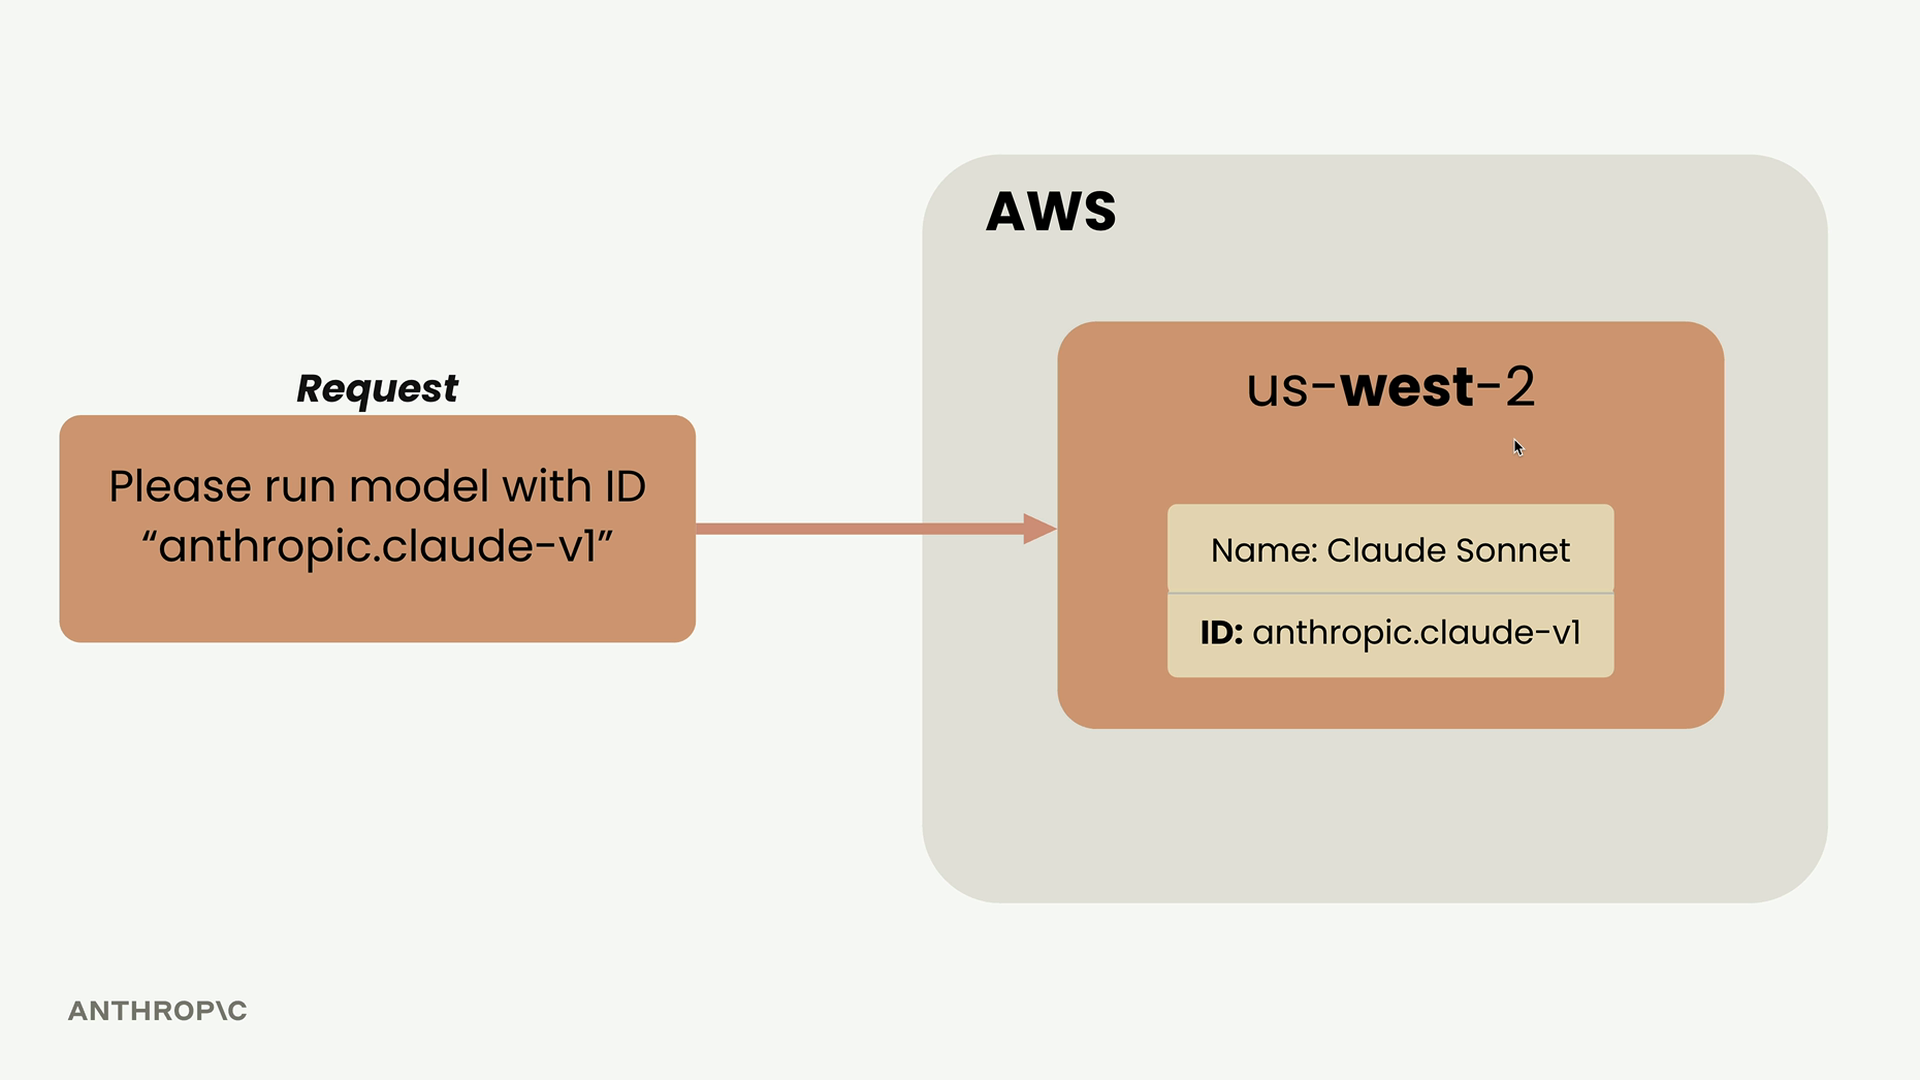
Par exemple, si Claude Sonnet est disponible dans us-west-2 mais que vous effectuez des requêtes depuis us-east-1, votre requête échouera.
Utilisation des profils d'inférence
Les profils d'inférence résolvent le problème de disponibilité régionale en acheminant automatiquement vos requêtes vers une région où le modèle choisi est réellement hébergé.
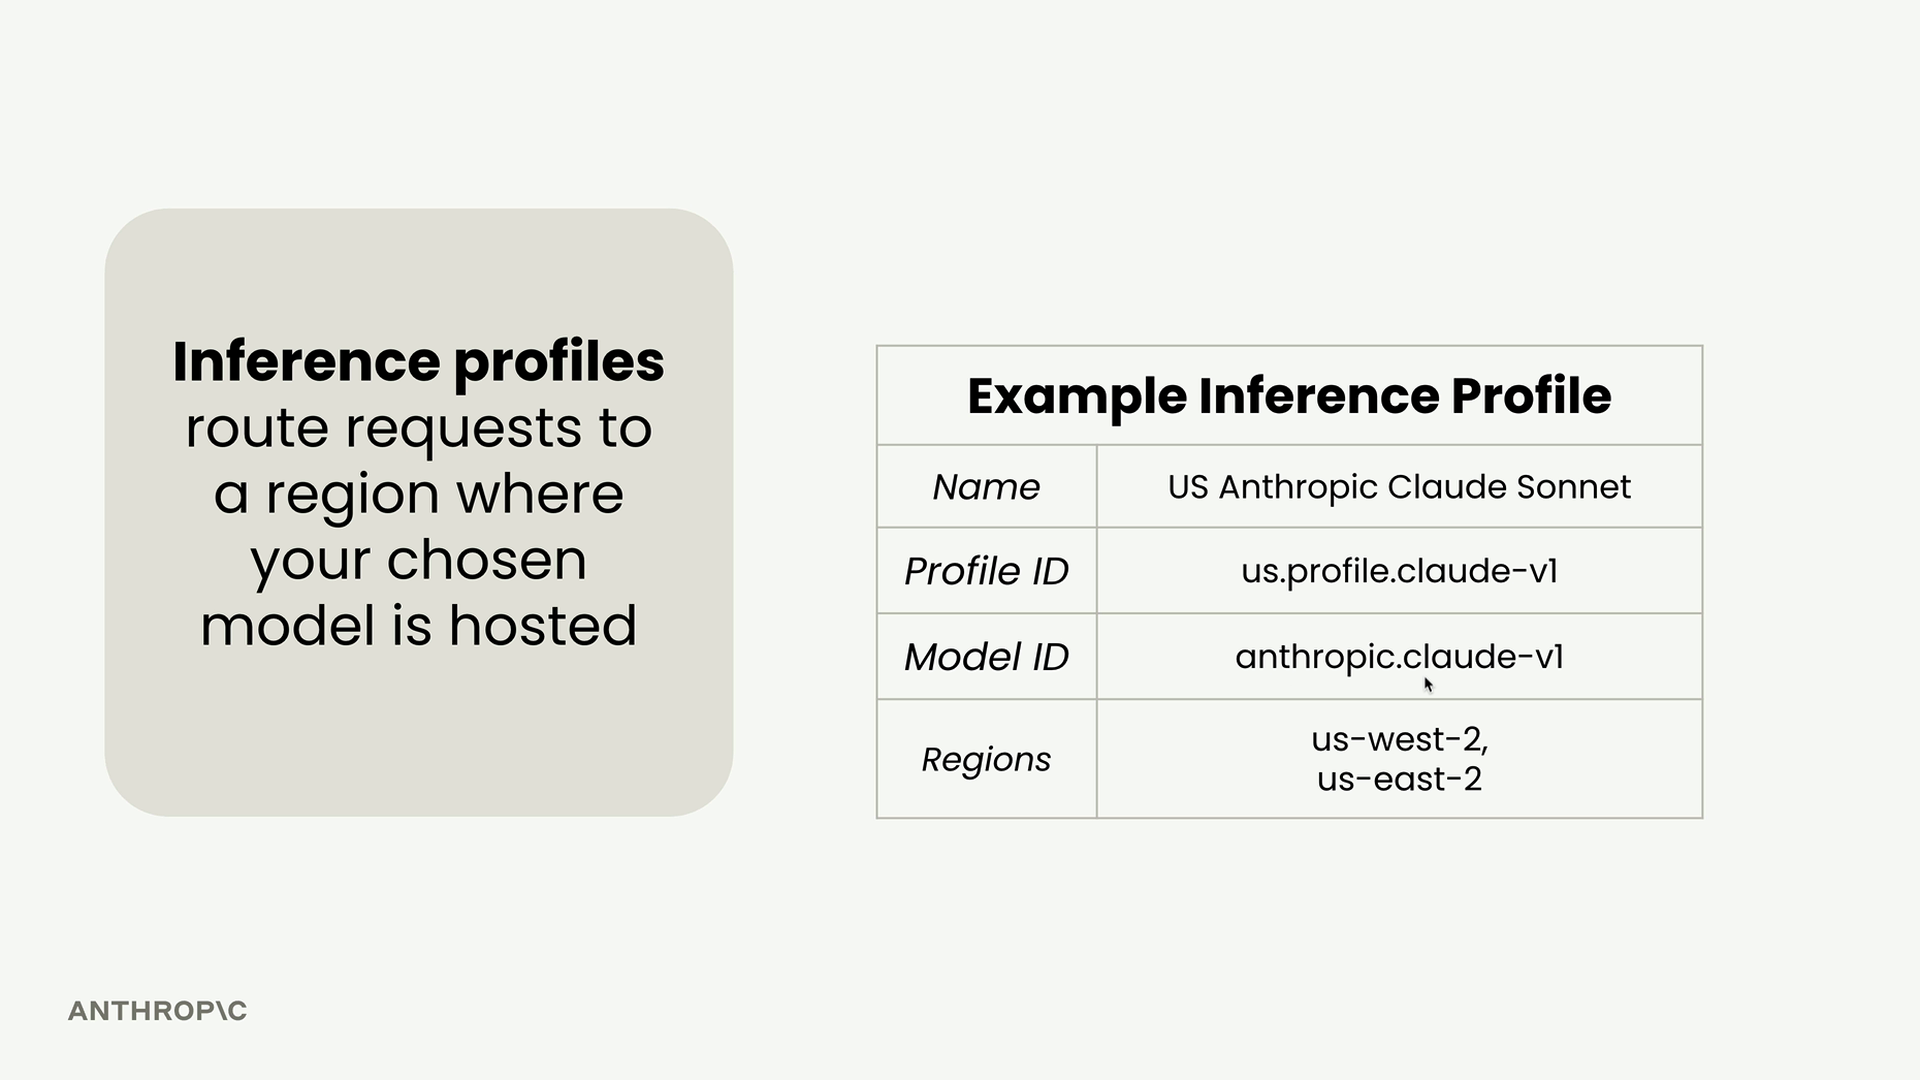
Plutôt que de suivre quels modèles se trouvent dans quelles régions, vous pouvez utiliser un profil d'inférence qui sait que le modèle est disponible dans plusieurs régions, comme us-west-2 et us-east-2.
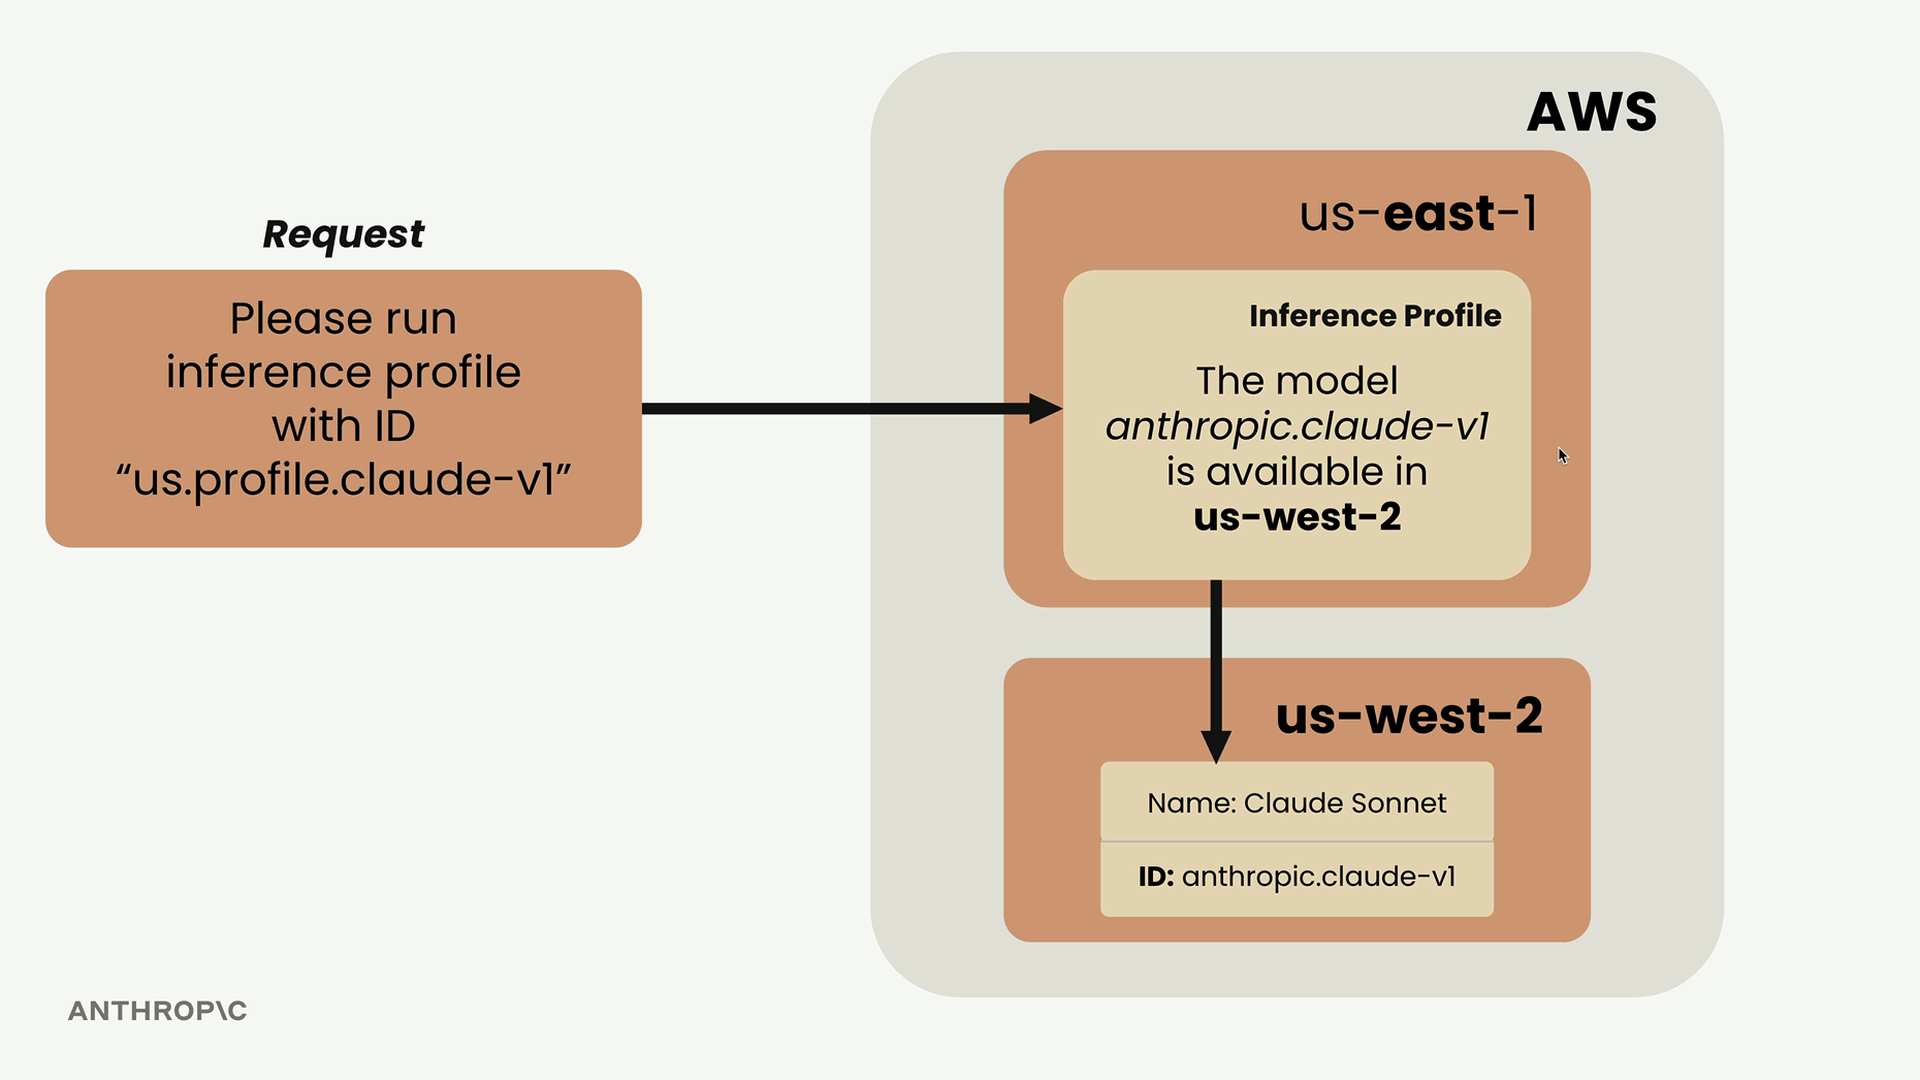
Lorsque vous effectuez une requête à l'aide d'un profil d'inférence, AWS l'achemine automatiquement vers la région correcte où votre modèle existe, même si vous vous connectez depuis une région différente.
Pour trouver les profils d'inférence ID, rendez-vous sur la console AWS Bedrock et consultez la section « Cross-region inference » plutôt que d'utiliser le Model ID de la page principale du catalogue de modèles.
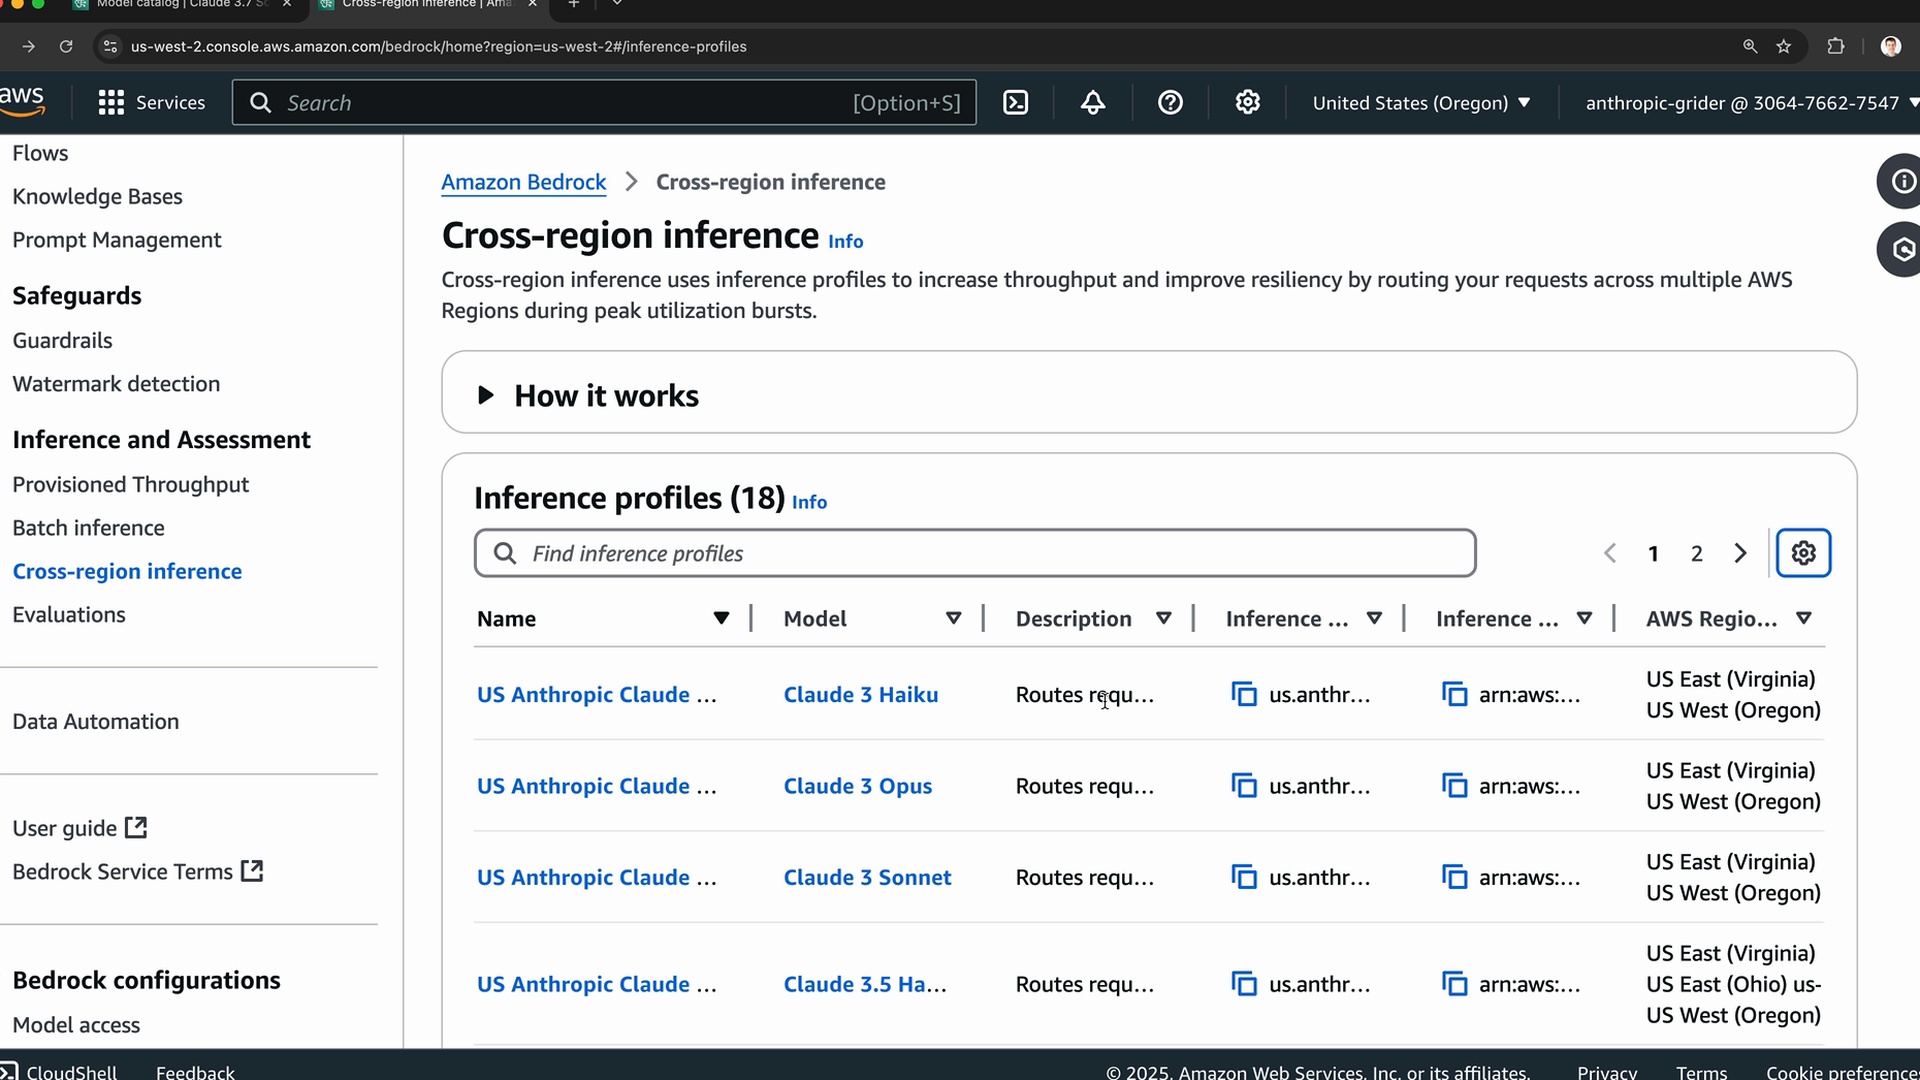
Copiez l'ID du profil d'inférence pour le modèle choisi. Les exemples de ce cours utilisent Claude Haiku 4.5, dont l'ID du profil d'inférence est us.anthropic.claude-haiku-4-5-20251001-v1:0 :
model_id = "us.anthropic.claude-haiku-4-5-20251001-v1:0"Création de messages utilisateur
Les messages utilisateur ont une structure spécifique qui peut sembler excessivement complexe au premier abord, mais il y a une bonne raison à cela :
user_message = {
    "role": "user",
    "content": [
        {"text": "What's 1+1?"}
    ]
}
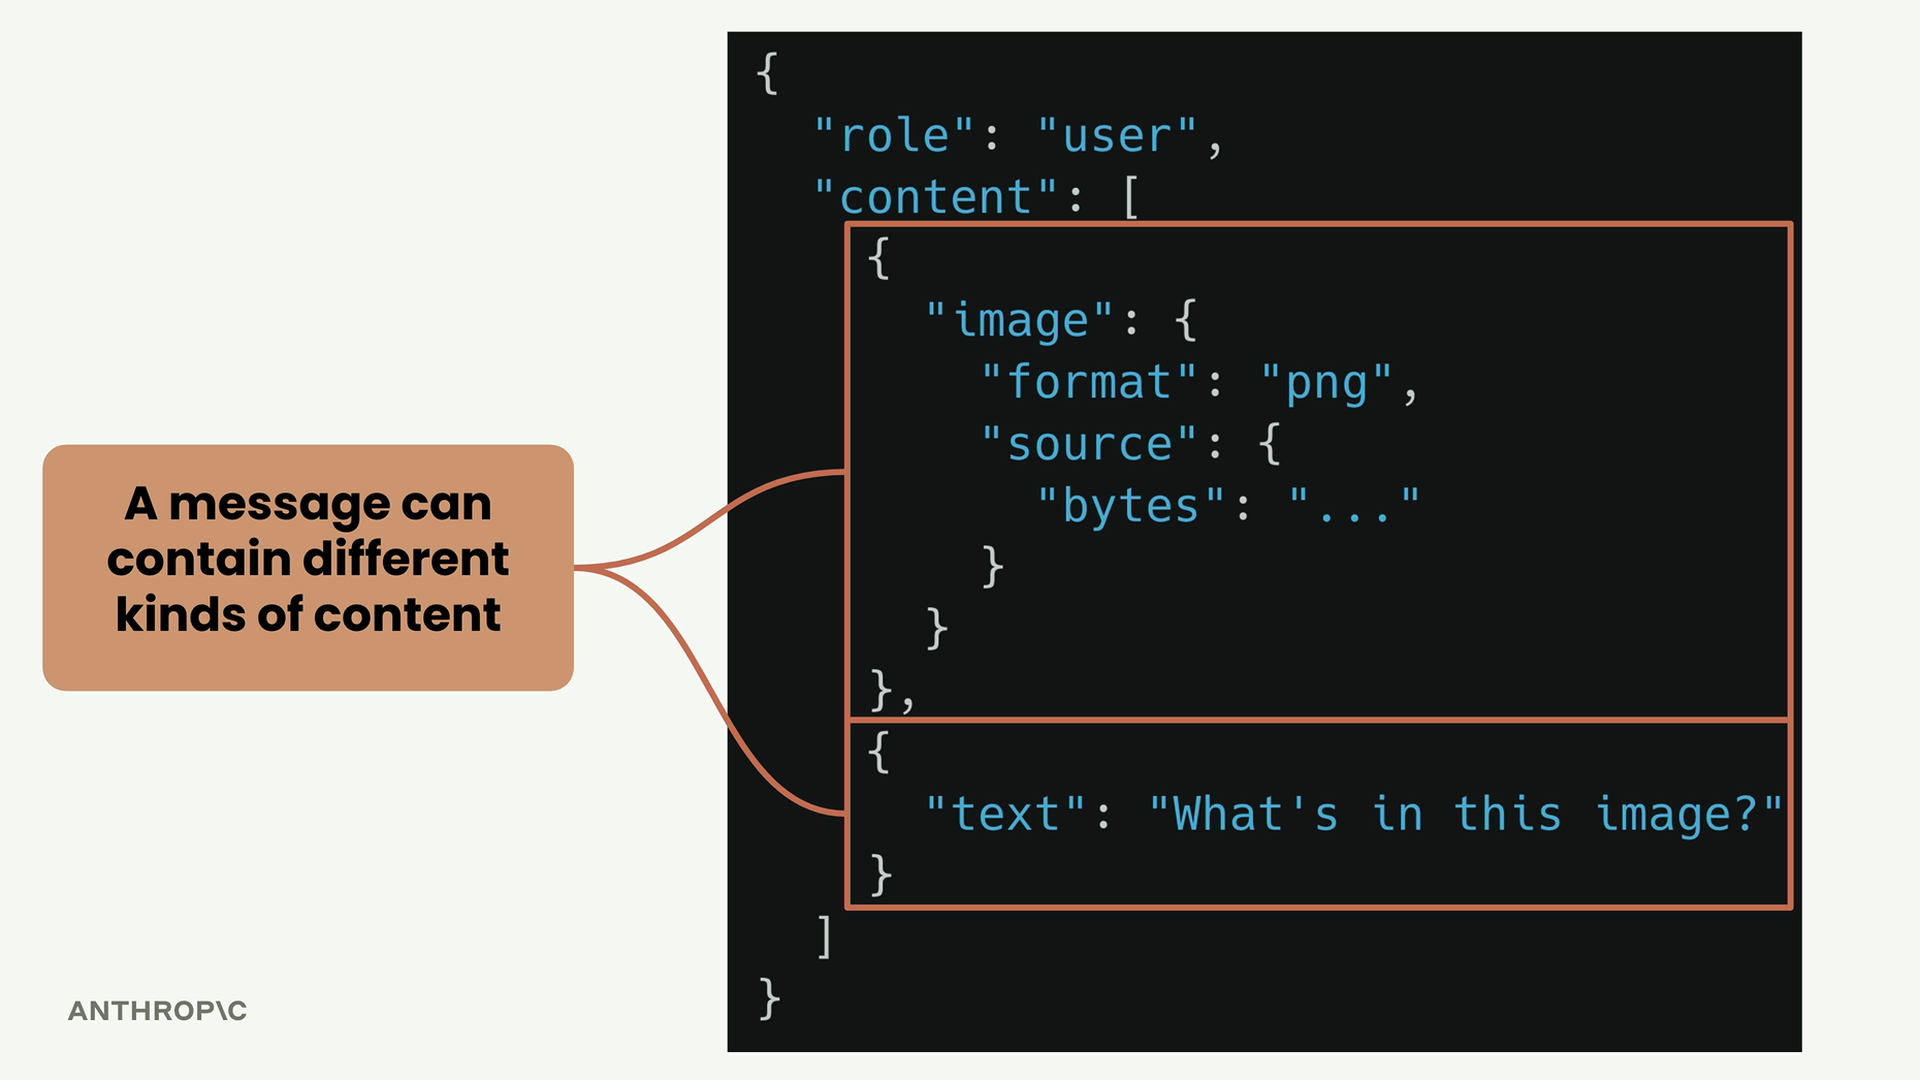
Le contenu est une liste car un même message peut contenir différents types de contenu : texte, images, ou d'autres types de médias. Cette structure vous permet d'envoyer des requêtes multimodales.
Effectuer la requête
Vous pouvez maintenant effectuer votre appel API en utilisant la méthode converse :
response = client.converse(
    modelId=model_id,
    messages=[user_message]
)
La réponse contient beaucoup de métadonnées, mais pour obtenir uniquement le texte généré, vous devez parcourir la structure de la réponse :
response["output"]["message"]["content"][0]["text"]Comprendre les types de messages
Il existe deux principaux types de messages avec lesquels vous allez travailler :
- Messages utilisateur - Le contenu que vous souhaitez transmettre au modèle (role : "user")
- Messages assistant - Le contenu produit par le modèle (role : "assistant")
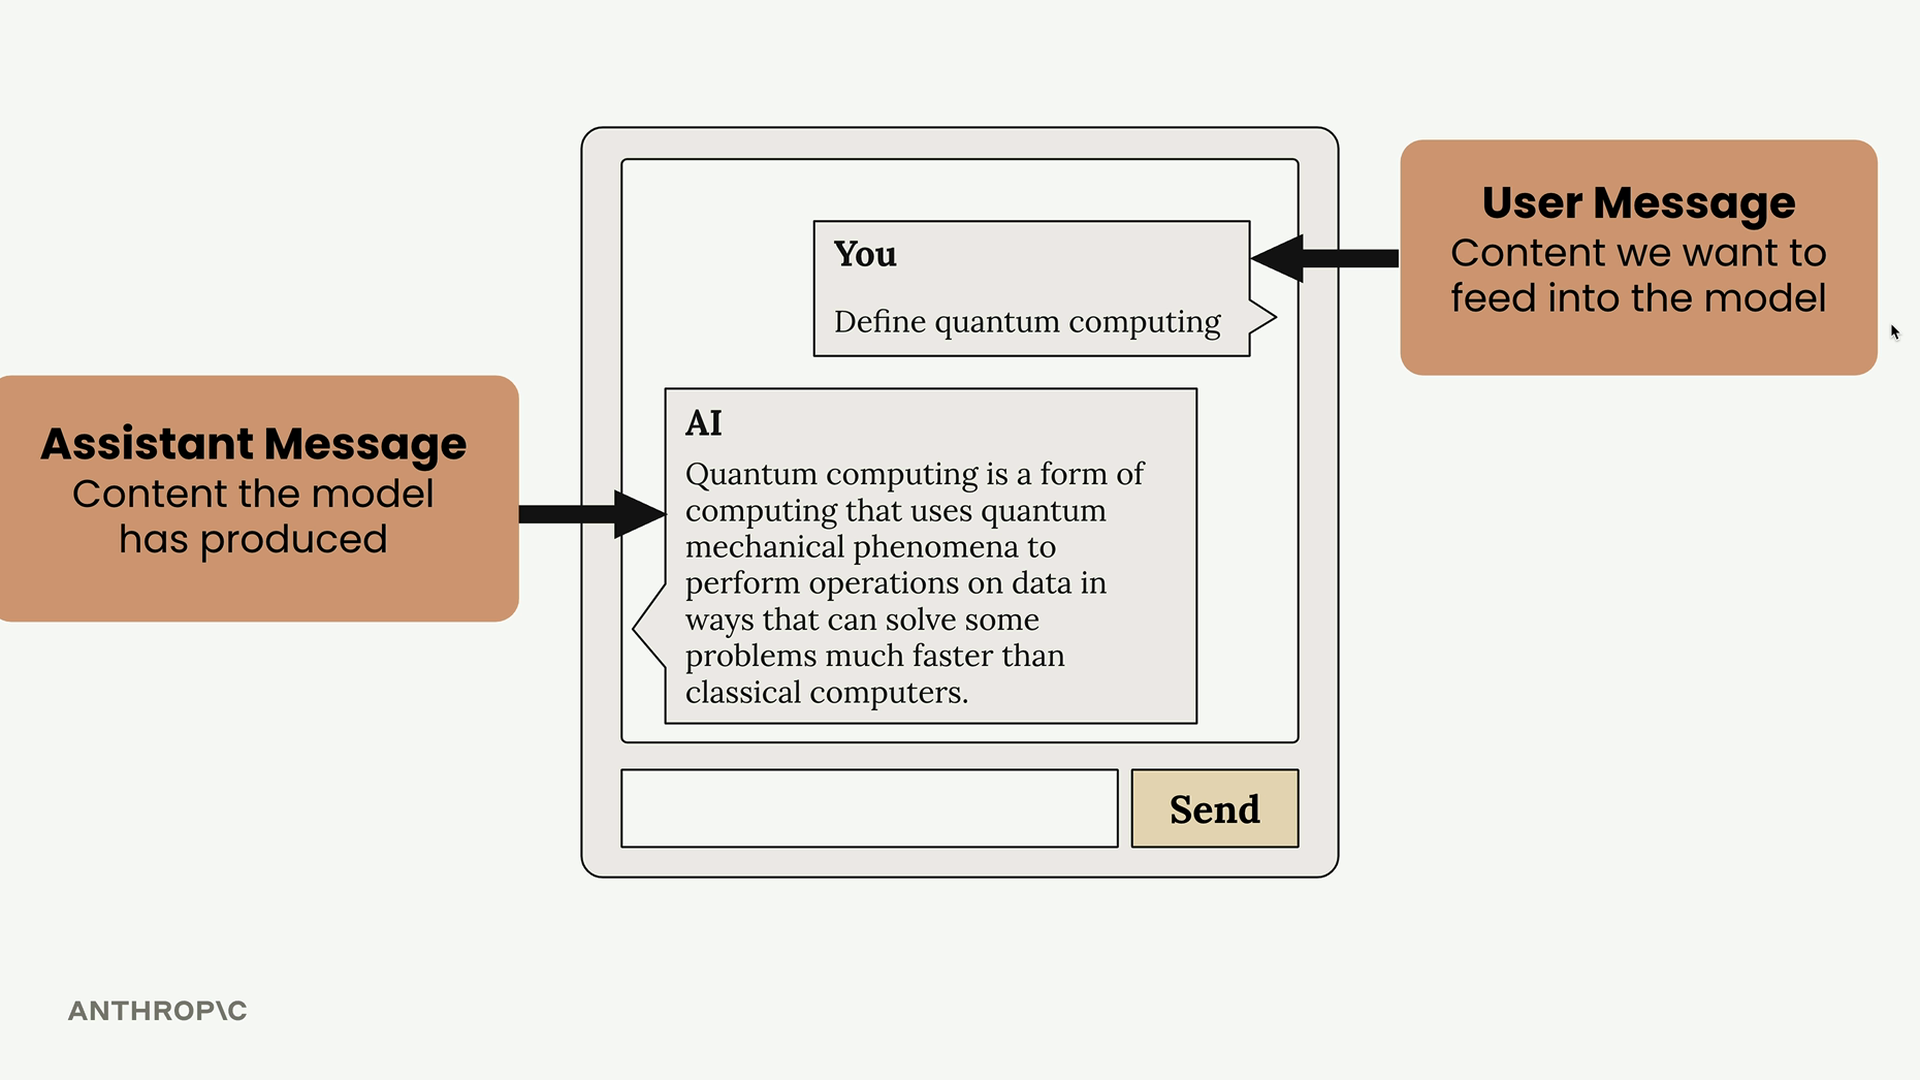
Les deux types de messages suivent la même structure, avec un role et une liste de contenu. Cette cohérence facilite la construction de conversations en alternant entre messages utilisateur et messages assistant.
Le message assistant que vous recevez de Bedrock suit exactement le même format que votre message utilisateur, simplement avec un role différent. Cette structure normalisée permet d'enchaîner facilement plusieurs requêtes pour des conversations plus longues.