Cette démonstration présente l'implémentation complète du RAG (Retrieval-Augmented Generation, génération augmentée par récupération) à l'aide d'un exemple pratique. Nous allons créer une base de données vectorielle à partir de zéro et exécuter les cinq étapes du flux de travail RAG en utilisant un exemple de document de rapport.
Configuration de la base de données vectorielle
L'implémentation utilise une classe personnalisée VectorIndex qui gère le stockage des embeddings et l'exécution de recherches par similarité. Cette classe fournit les fonctionnalités essentielles dont nous avons besoin pour nos opérations de base de données vectorielle.
L'implémentation RAG en cinq étapes
Étape 1 : Découper le texte par section
Tout d'abord, nous chargeons et découpons notre document source en utilisant la même approche de découpage basée sur les sections que précédemment :
with open("./report.md", "r") as f:
    text = f.read()

chunks = chunk_by_section(text)
Cela divise notre rapport en sections logiques qui peuvent être traitées indépendamment.
Étape 2 : Générer les embeddings pour chaque extrait
Ensuite, nous créons des embeddings pour chaque extrait à l'aide d'une compréhension de liste :
embeddings = [generate_embedding(chunk) for chunk in chunks]Cette étape implique plusieurs appels API, elle prend donc un certain temps à s'exécuter. Chaque extrait est converti en une représentation vectorielle numérique.
Étape 3 : Stocker les embeddings dans la base de données vectorielle
Nous créons maintenant notre base de données vectorielle et la remplissons à la fois avec les embeddings et le texte associé :
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
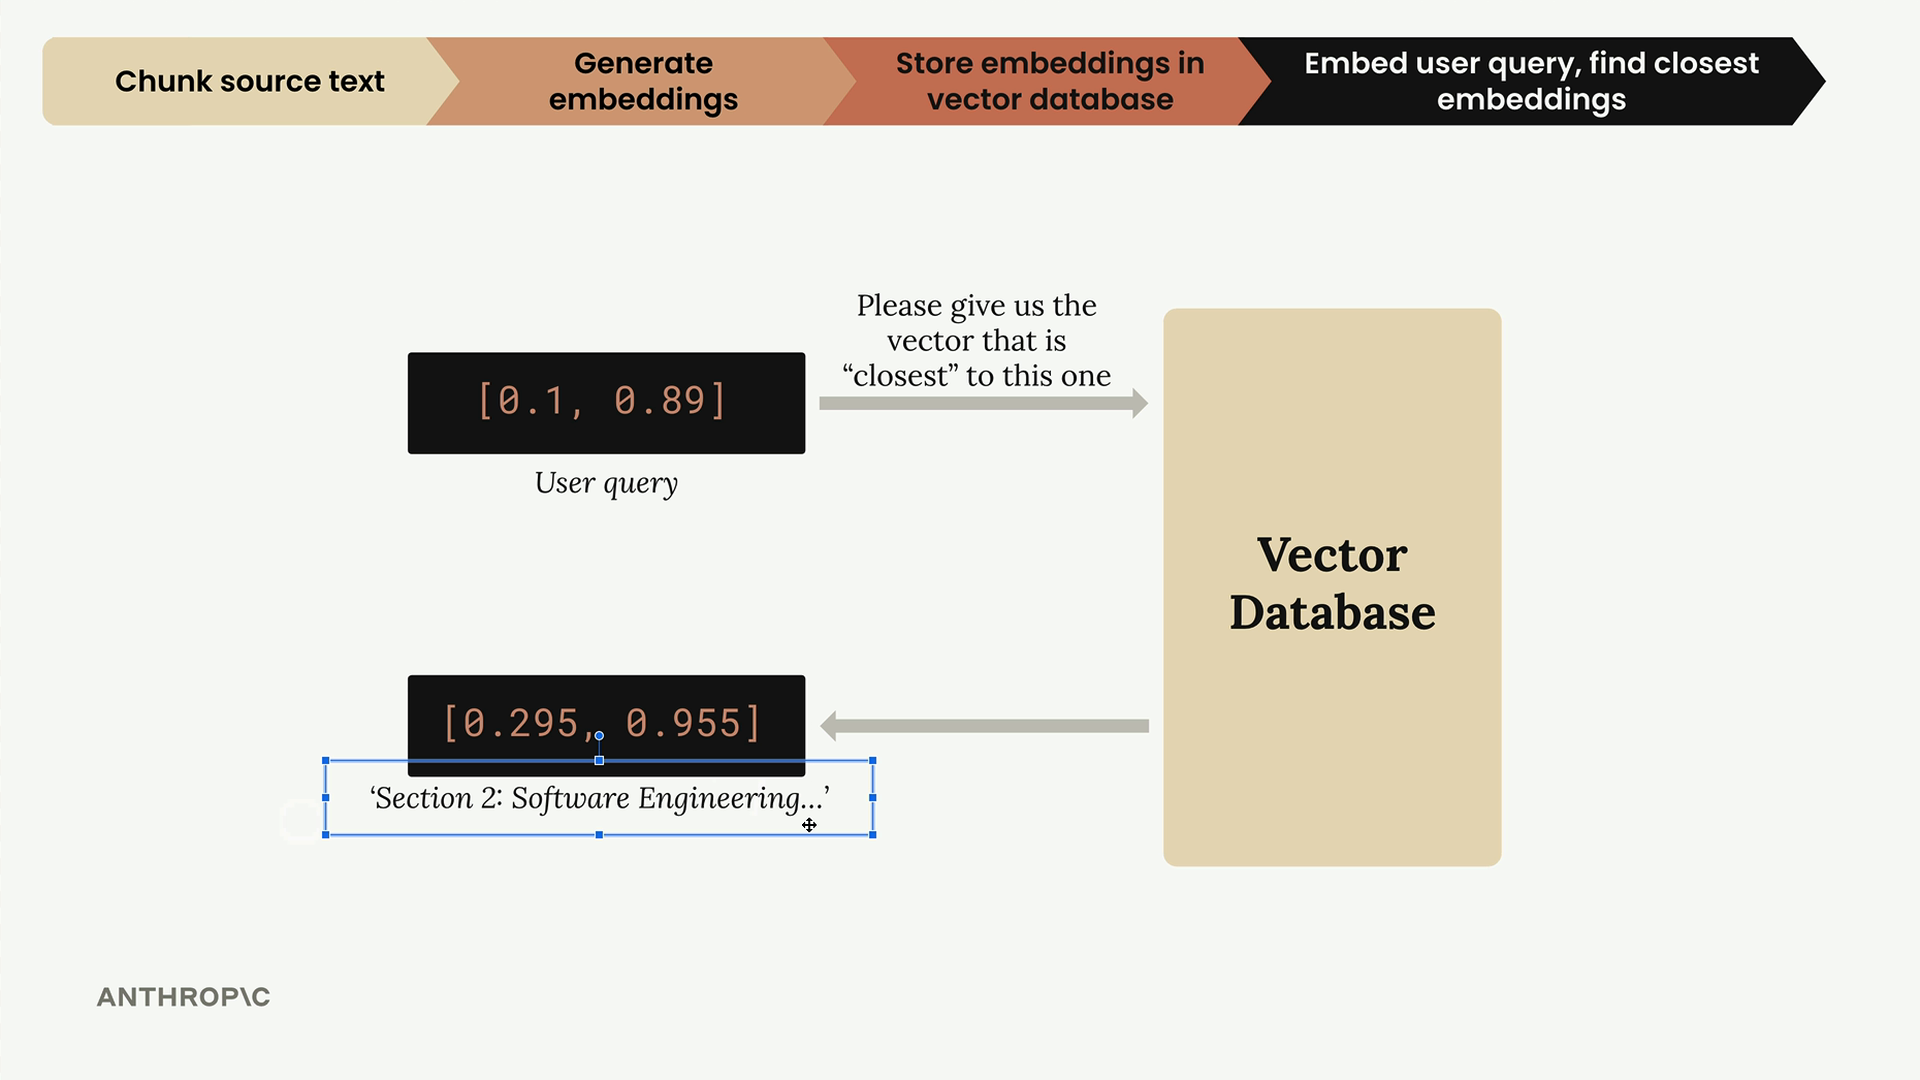
L'idée clé ici est que nous stockons à la fois l'embedding et le texte original. Récupérer simplement une liste de nombres n'est pas utile : nous avons besoin du contenu textuel réel qui correspond à ces embeddings. Ces métadonnées nous permettent par la suite de récupérer des résultats pertinents.
Étape 4 : Générer l'embedding de la requête de l'utilisateur
Lorsqu'un utilisateur pose une question, nous la convertissons dans le même format d'embedding :
user_embedding = generate_embedding("What did the software engineering dept do last year?")Cela crée une représentation vectorielle de la question de l'utilisateur qui peut être comparée à nos embeddings stockés.
Étape 5 : Rechercher et récupérer les extraits pertinents
Enfin, nous effectuons une recherche dans notre base de données vectorielle pour trouver le contenu le plus similaire :
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
Cela renvoie les deux extraits les plus pertinents ainsi que leurs scores de distance cosinus. Des distances plus faibles indiquent une similarité plus élevée.
Comprendre les résultats
La recherche renvoie des résultats classés par pertinence. Dans notre exemple, la section sur l'ingénierie logicielle présentait la distance la plus faible (0,71), ce qui en fait la correspondance la plus pertinente. La section sur la méthodologie arrive en deuxième position avec une distance de 0,72.
La métrique de distance vous aide à comprendre le niveau de confiance du système quant à la pertinence de chaque résultat. Des distances plus proches signifient de meilleures correspondances avec la requête de l'utilisateur.
Pourquoi stocker le texte avec les embeddings
Une décision de conception cruciale consiste à stocker le texte original aux côtés de chaque embedding. Sans cela, vous n'obtiendriez que des tableaux de nombres, ce qui n'est pas utile pour générer des réponses. En incluant le texte source, vous pouvez immédiatement utiliser les extraits récupérés pour fournir du contexte à votre modèle de langage.
Cela achève le flux de travail RAG de base, même s'il existe des optimisations et des améliorations supplémentaires qui peuvent renforcer les performances dans des scénarios réels.