La création d'un flux de travail personnalisé d'évaluation de requêtes commence par la définition d'un objectif clair et la génération de données de test. Dans ce cas, nous créons une requête qui aide les utilisateurs à écrire du code spécifique à AWS - soit des fonctions Python, des configurations JSON, ou des expressions régulières - sans explications ni mise en forme supplémentaires.
Définir l'objectif
La requête doit prendre la description d'une tâche par un utilisateur et renvoyer l'un des trois types de sortie suivants :
- Code Python
- Configuration JSON
- Expressions régulières
L'exigence principale est que les réponses ne contiennent que le code demandé, sans en-têtes, pieds de page ni explications.
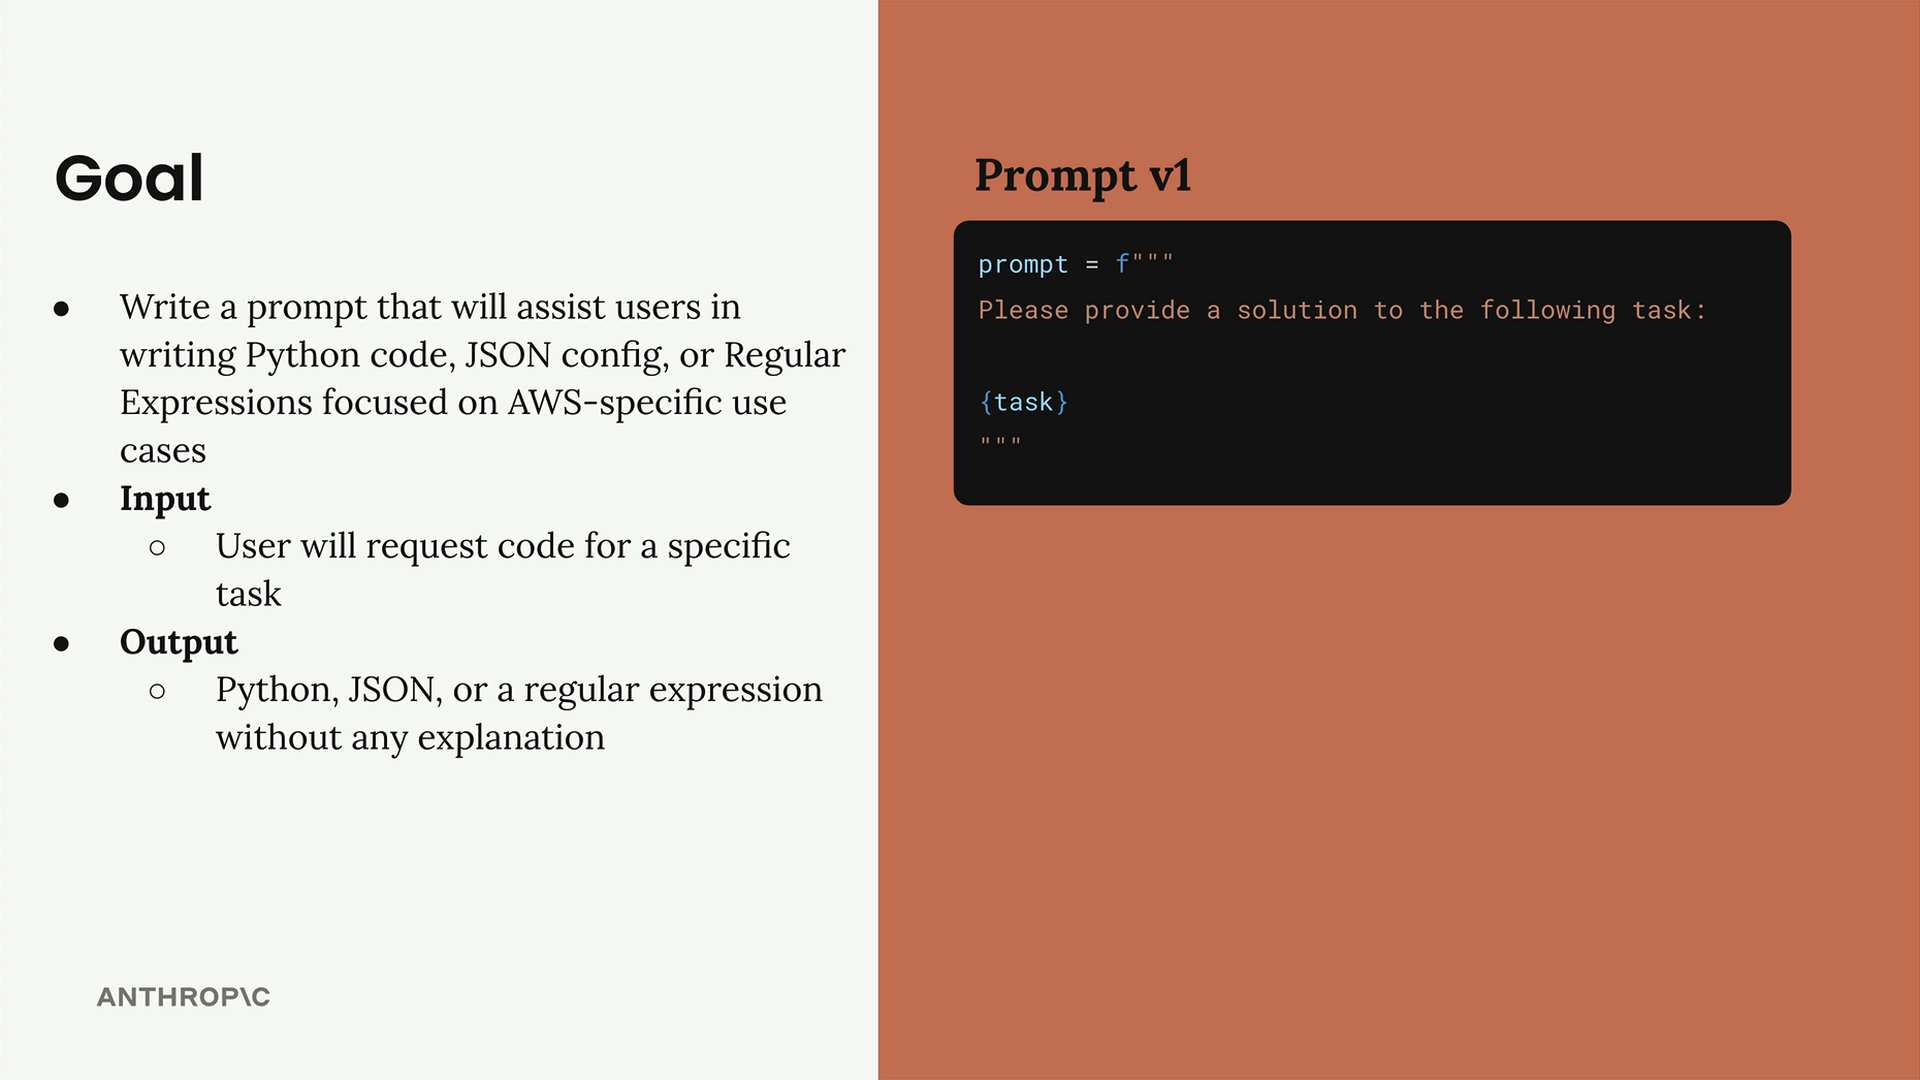
Commencer par une première version simple permet de garder les choses maîtrisables. Le modèle de requête initial est direct : « Please provide a solution to the following task: {task} »
Créer des ensembles de données d'évaluation
Un ensemble de données d'évaluation contient des exemples d'entrées que vous allez injecter dans votre requête. Chaque cas de test est combiné avec votre requête et envoyé à Claude, ce qui vous permet de voir comment la requête se comporte dans différents scénarios.
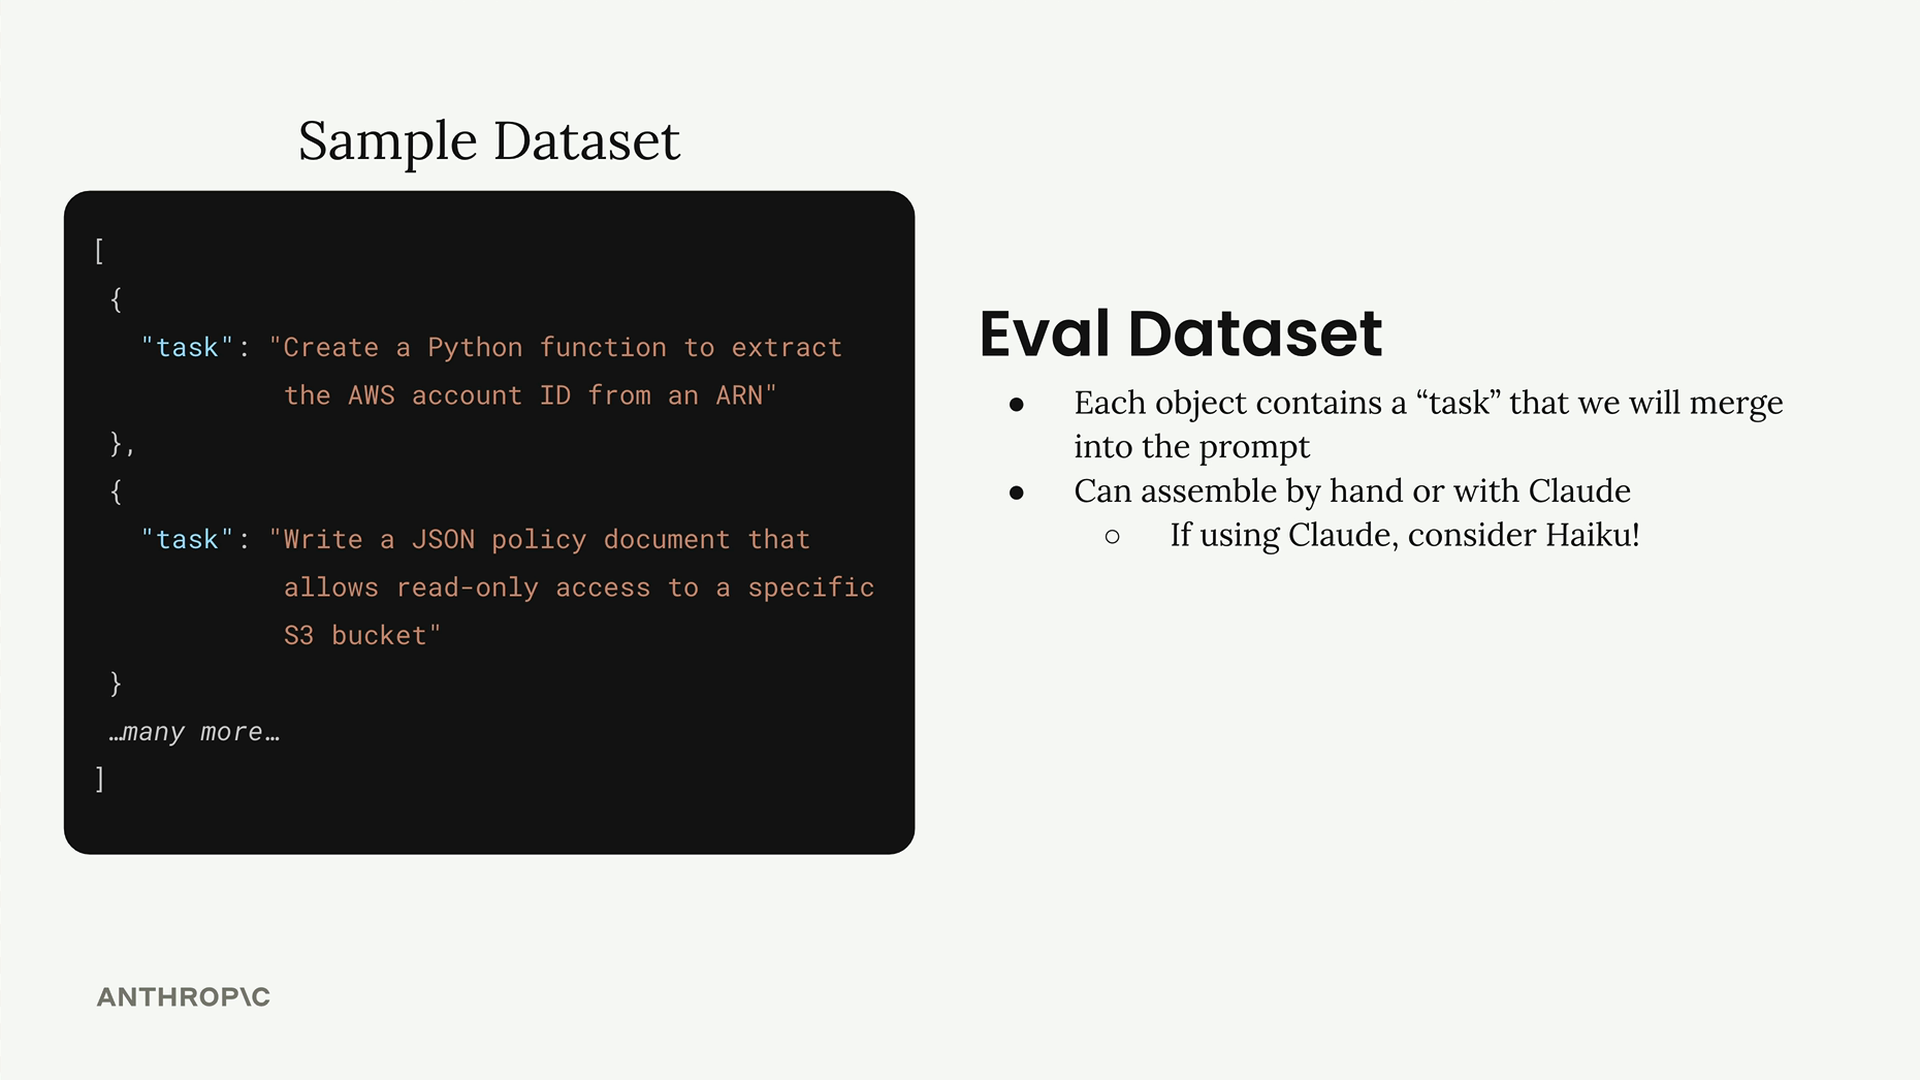
Vous pouvez créer des ensembles de données de deux façons :
- Rédiger manuellement les cas de test
- Les générer automatiquement à l'aide de Claude
Pour la génération automatique, utiliser un modèle plus rapide comme Haiku est judicieux puisque vous générez plusieurs cas de test.
Générer des données de test avec du code
La fonction de génération d'ensembles de données utilise Claude pour créer des scénarios de test réalistes. Voici la structure de base :
def generate_dataset():
    prompt = """
    Generate 3 AWS-related tasks that require Python, JSON, or Regex solutions.

    Focus on tasks that can be solved by writing a single Python function,
    a single JSON object, or tasks that do not require writing much code.

    Example output:
    [
        {
            "task": "Description of task"
        },
        ...additional
    ]

    Please generate 3 objects.
    """

    messages = []
    add_user_message(messages, prompt)
    add_assistant_message(messages, "```json")
    text = chat(messages, stop_sequences=["```"])
    return json.loads(text)
Cette approche utilise la technique du message assistant pré-rempli associée à des séquences d'arrêt pour extraire des réponses JSON propres. Le message assistant commence par ```json et s'arrête à la fermeture ```, garantissant que vous obtenez des données correctement formatées.
Enregistrer votre ensemble de données
Une fois généré, enregistrez l'ensemble de données afin d'éviter de devoir le régénérer constamment :
dataset = generate_dataset()
with open("dataset.json", "w") as f:
    json.dump(dataset, f, indent=2)
L'ensemble de données généré crée des tâches AWS réalistes, comme l'extraction d'identifiants de compte à partir d'ARN, la rédaction de schémas JSON pour des configurations EC2, et la création de modèles regex pour des noms de buckets S3. Si trois cas de test suffisent pour un développement initial, une évaluation en production nécessiterait beaucoup plus d'exemples, avec une plus grande variété.
Cette base vous offre un processus reproductible pour créer des ensembles de données d'évaluation adaptés à votre cas d'usage spécifique, ouvrant la voie aux étapes suivantes : exécuter des évaluations et mesurer la performance des requêtes.