L'évaluation basée sur le code ajoute une couche de validation supplémentaire à vos évaluations de requêtes en vérifiant si le résultat du modèle respecte le format correct et possède une syntaxe valide. Cela est particulièrement utile lorsque vous demandez aux modèles de générer du code, du JSON ou des expressions régulières.
Comment fonctionne l'évaluation par code
L'évaluateur de code évalue deux critères principaux :
- Conformité au format - Le résultat contient-il uniquement le format demandé (Python, JSON ou regex) sans explications ?
- Syntaxe valide - Le résultat peut-il réellement être analysé ou compilé avec succès ?
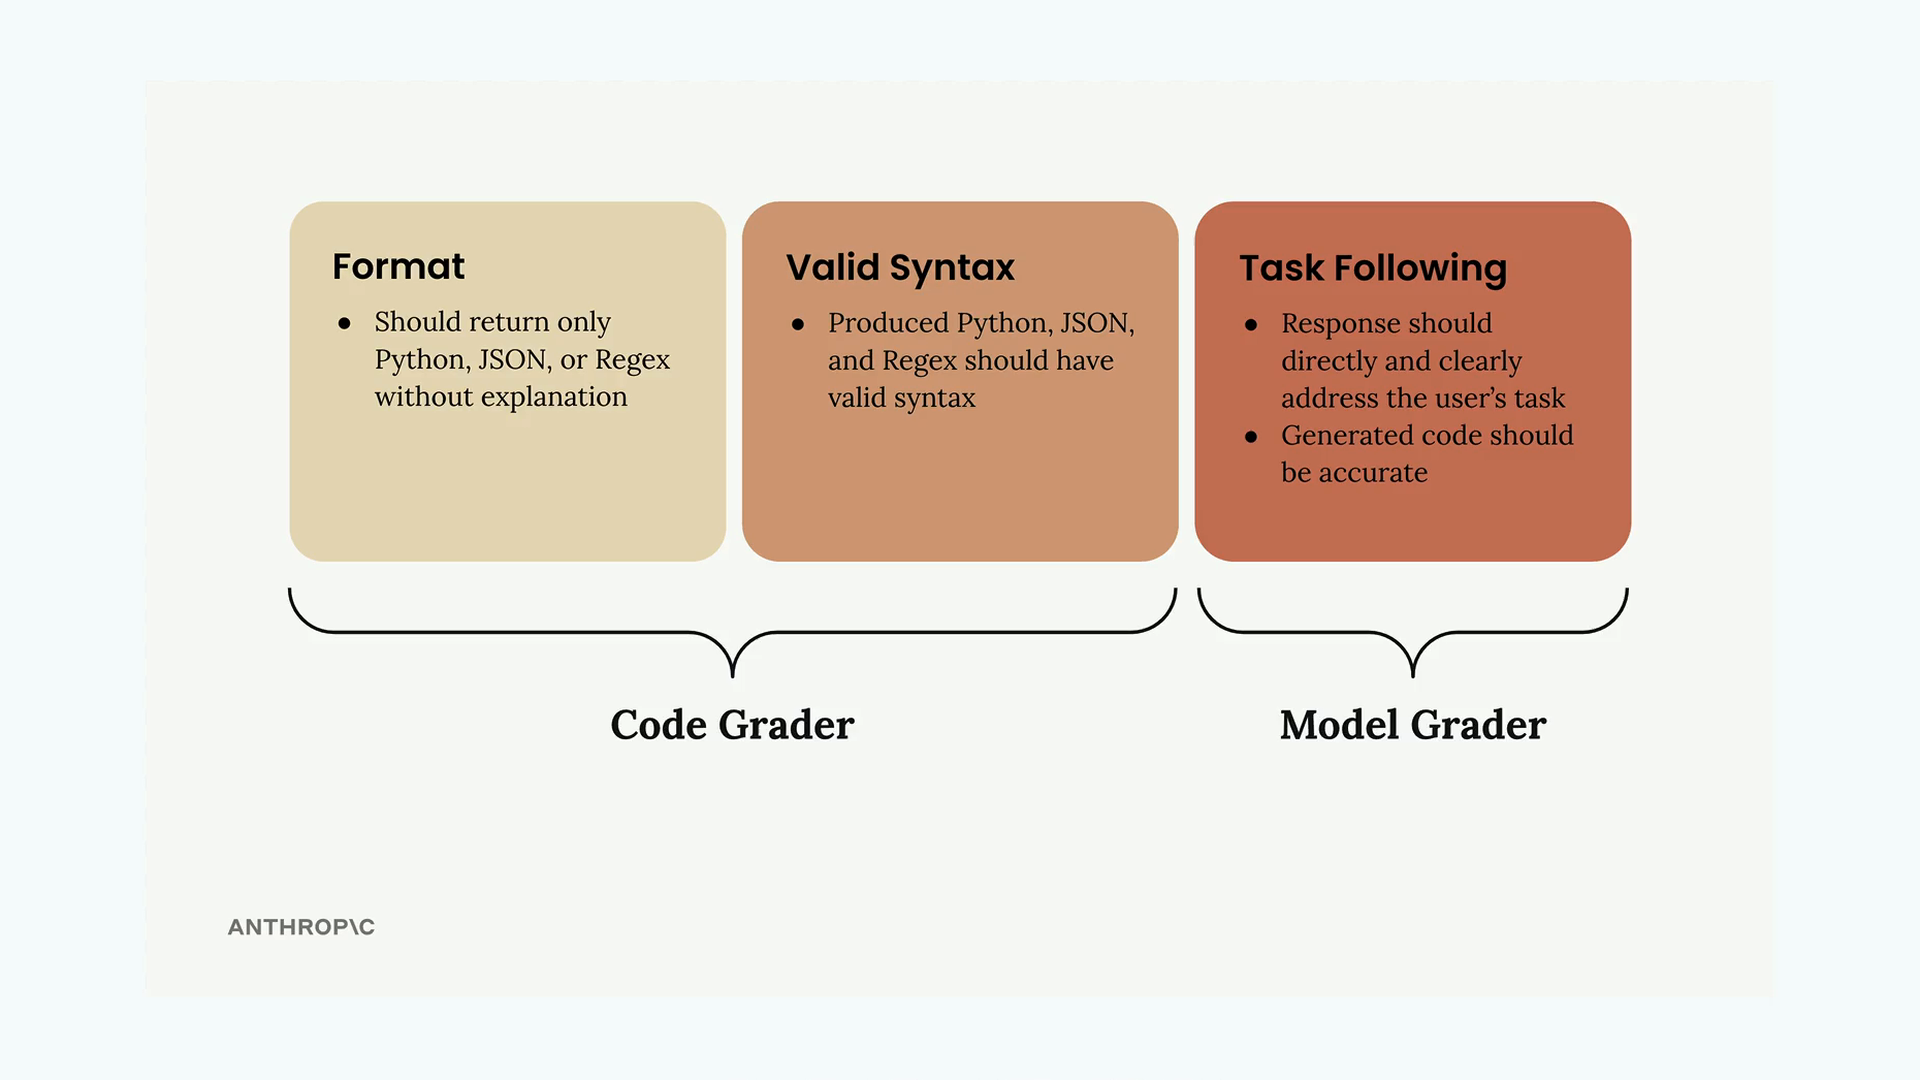
Le système utilise des fonctions de validation distinctes pour chaque type de format. Si le code est analysé avec succès, il obtient un score parfait de 10. Si l'analyse échoue avec une erreur, il obtient un score de 0.
Configuration des fonctions de validation
Vous aurez besoin de trois fonctions utilitaires pour valider différents types de résultats :
import ast
import json
import re

def validate_json(text):
    try:
        json.loads(text.strip())
        return 10
    except json.JSONDecodeError:
        return 0

def validate_python(text):
    try:
        ast.parse(text.strip())
        return 10
    except SyntaxError:
        return 0

def validate_regex(text):
    try:
        re.compile(text.strip())
        return 10
    except re.error:
        return 0
Ces fonctions utilisent les capacités d'analyse intégrées de Python pour vérifier la validité de la syntaxe. La fonction json.loads() valide le JSON, ast.parse() crée un arbre syntaxique abstrait Python, et re.compile() valide les expressions régulières.
Ajout d'informations de format aux cas de test
Votre jeu de données de test doit spécifier le format de sortie attendu pour chaque tâche. Mettez à jour votre requête de génération de jeu de données pour inclure un champ de format :
{
    "task": "Description of task",
    "format": "python"
}
Le champ de format doit contenir « json », « python » ou « regex » selon le type de résultat que vous attendez de cette tâche particulière.
Amélioration de votre requête
Pour obtenir de meilleurs résultats de l'évaluateur de code, rendez les instructions de votre requête plus spécifiques :
* Respond only with Python, JSON, or a plain Regex
* Do not add any comments or commentary or explanationVous pouvez également utiliser un message d'assistant pré-rempli avec des blocs de code et des séquences d'arrêt pour garantir un formatage de sortie propre.
Combinaison des scores
Tout d'abord, choisissez le validateur qui correspond à chaque cas de test :
def grade_syntax(output, test_case):
    if test_case["format"] == "json":
        return validate_json(output)
    if test_case["format"] == "python":
        return validate_python(output)
    return validate_regex(output)
La dernière étape consiste à fusionner le score de l'évaluateur modèle avec le score de l'évaluateur de syntaxe. Une approche simple consiste à prendre la moyenne des deux scores dans run_test_case :
model_grade = grade_by_model(test_case, output)
model_score = model_grade["score"]
syntax_score = grade_syntax(output, test_case)

score = (model_score + syntax_score) / 2
Cela accorde un poids égal à la fois à la qualité du contenu (provenant de l'évaluateur modèle) et à l'exactitude technique (provenant de l'évaluateur de code). Vous pouvez ajuster cette pondération en fonction de ce qui compte le plus pour votre cas d'usage spécifique.
Interprétation des résultats
Une fois que vous avez exécuté votre évaluation, vous obtiendrez un score combiné qui reflète à la fois la qualité sémantique et l'exactitude technique du code généré. Rappelez-vous qu'un score isolé ne vous apprend pas grand-chose - la véritable valeur vient de la comparaison des scores au fur et à mesure que vous itérez sur la conception de votre requête.
Utilisez ce score de référence pour tester les améliorations de requête et voir si vos changements conduisent réellement à une génération de code meilleure et plus fiable.