Chargement
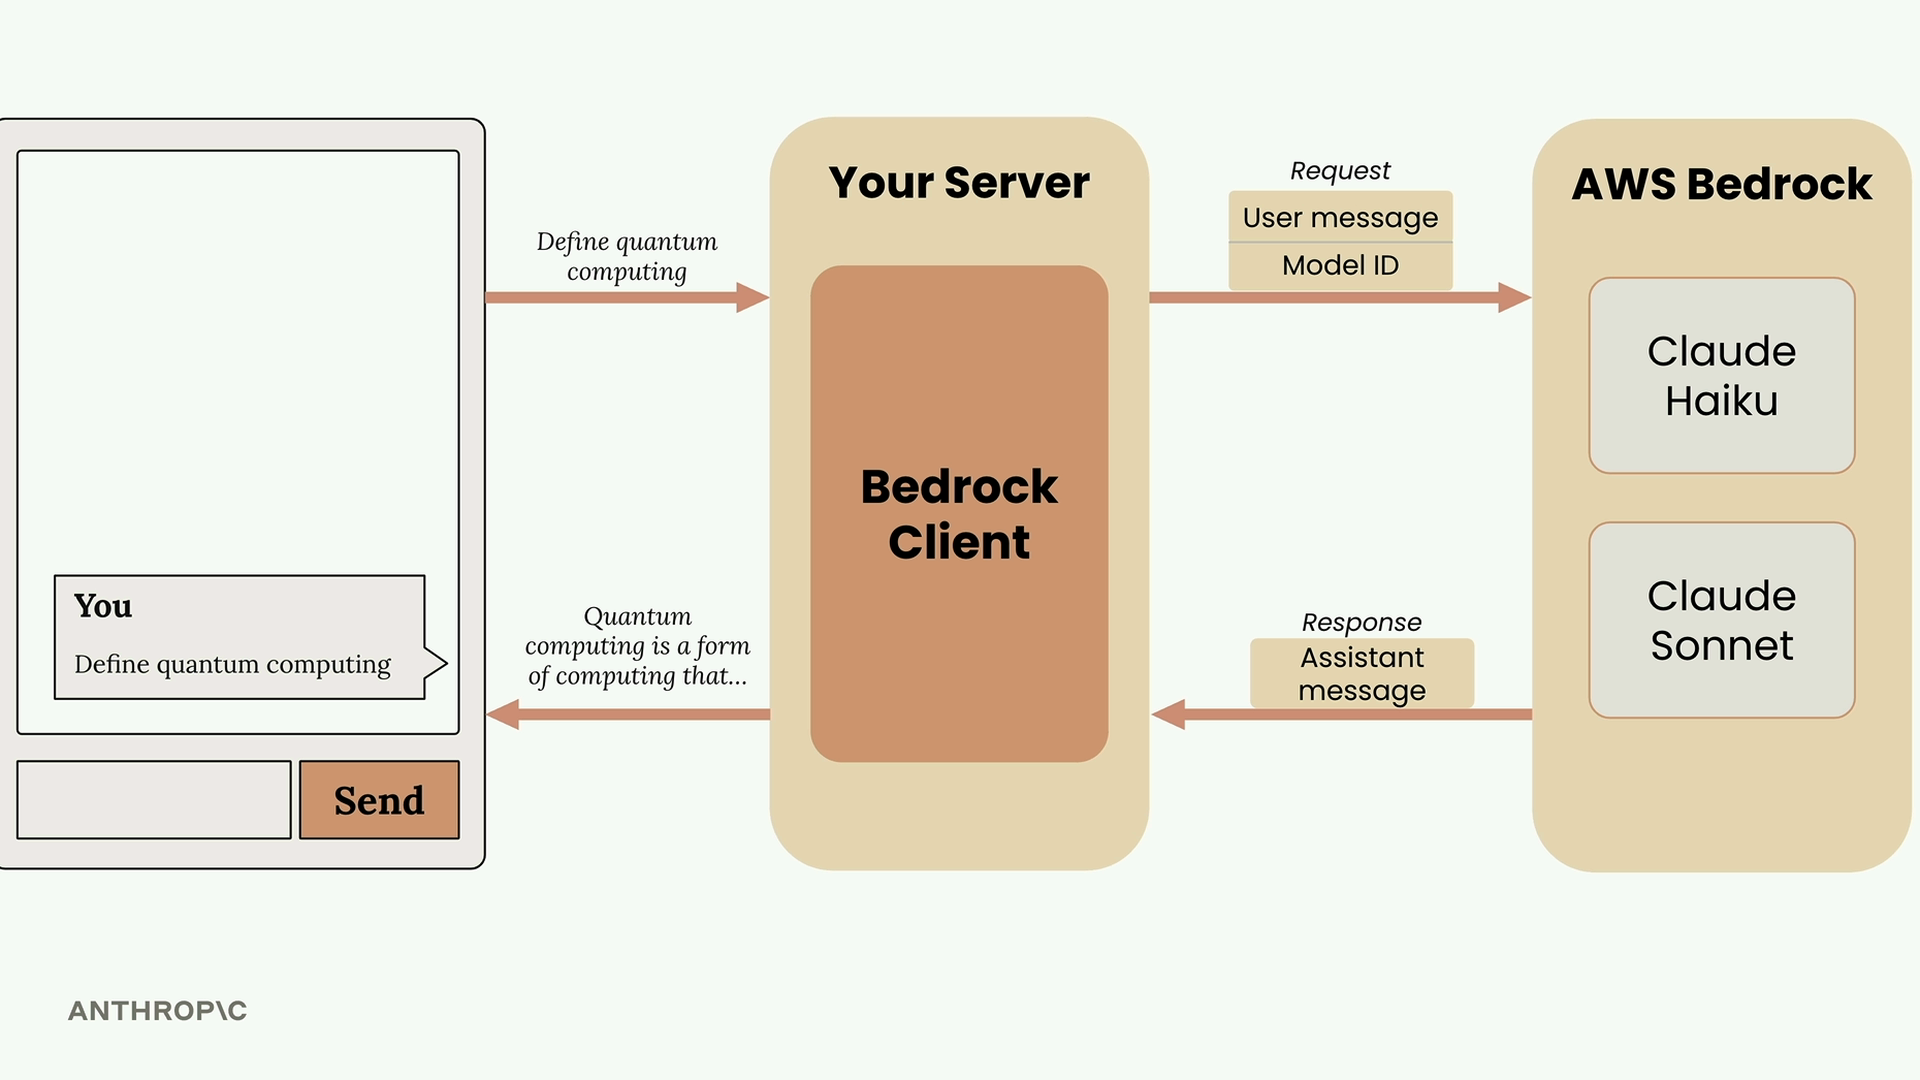
Lorsque vous développez des applications avec des modèles d'IA, vous devez comprendre le flux de données depuis la saisie utilisateur jusqu'à la réponse générée par l'IA. Voyons ensemble comment cela fonctionne avec AWS Bedrock et ce qui se passe en coulisses dans une application de chat classique.
Comment fonctionnent les applications de chat
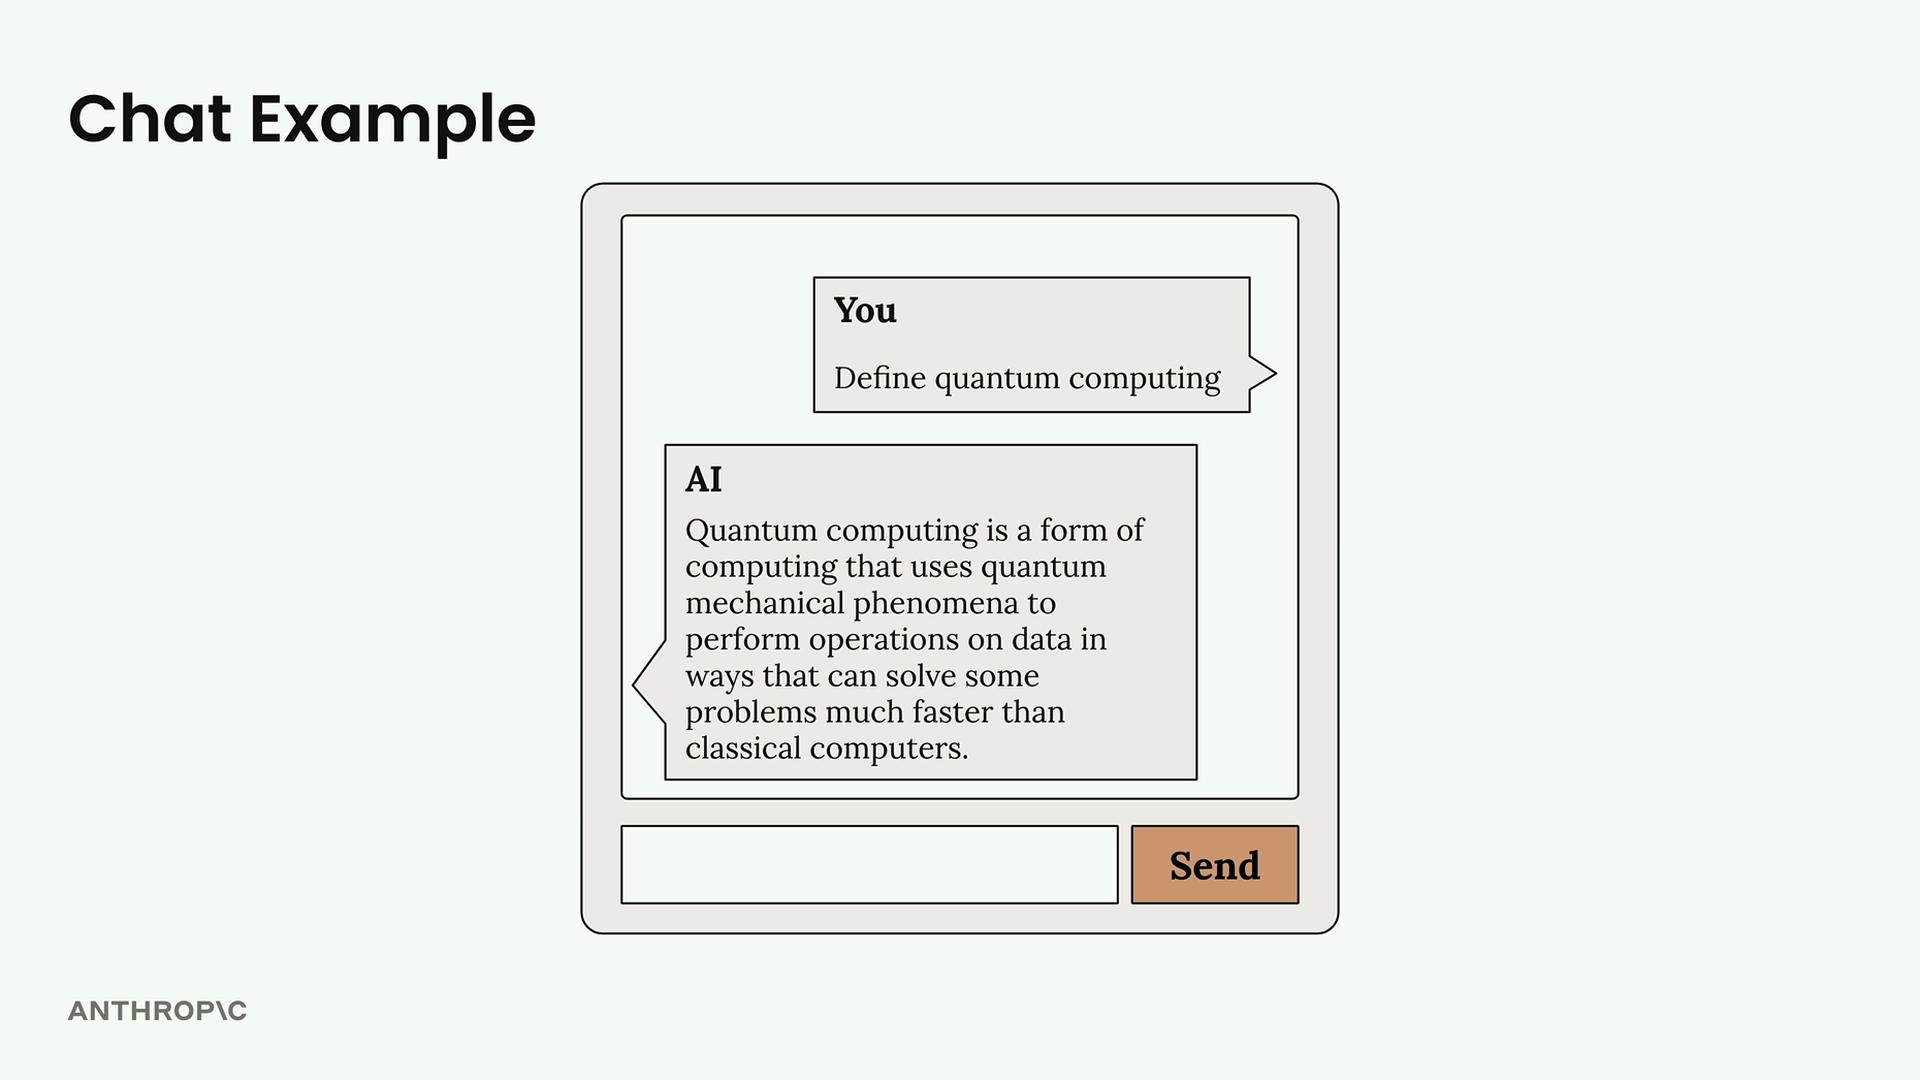
Imaginez que vous développez une application web avec une interface de chat simple. Un utilisateur saisit « Définissez l'informatique quantique » et clique sur envoyer. Voici ce qui se passe réellement :
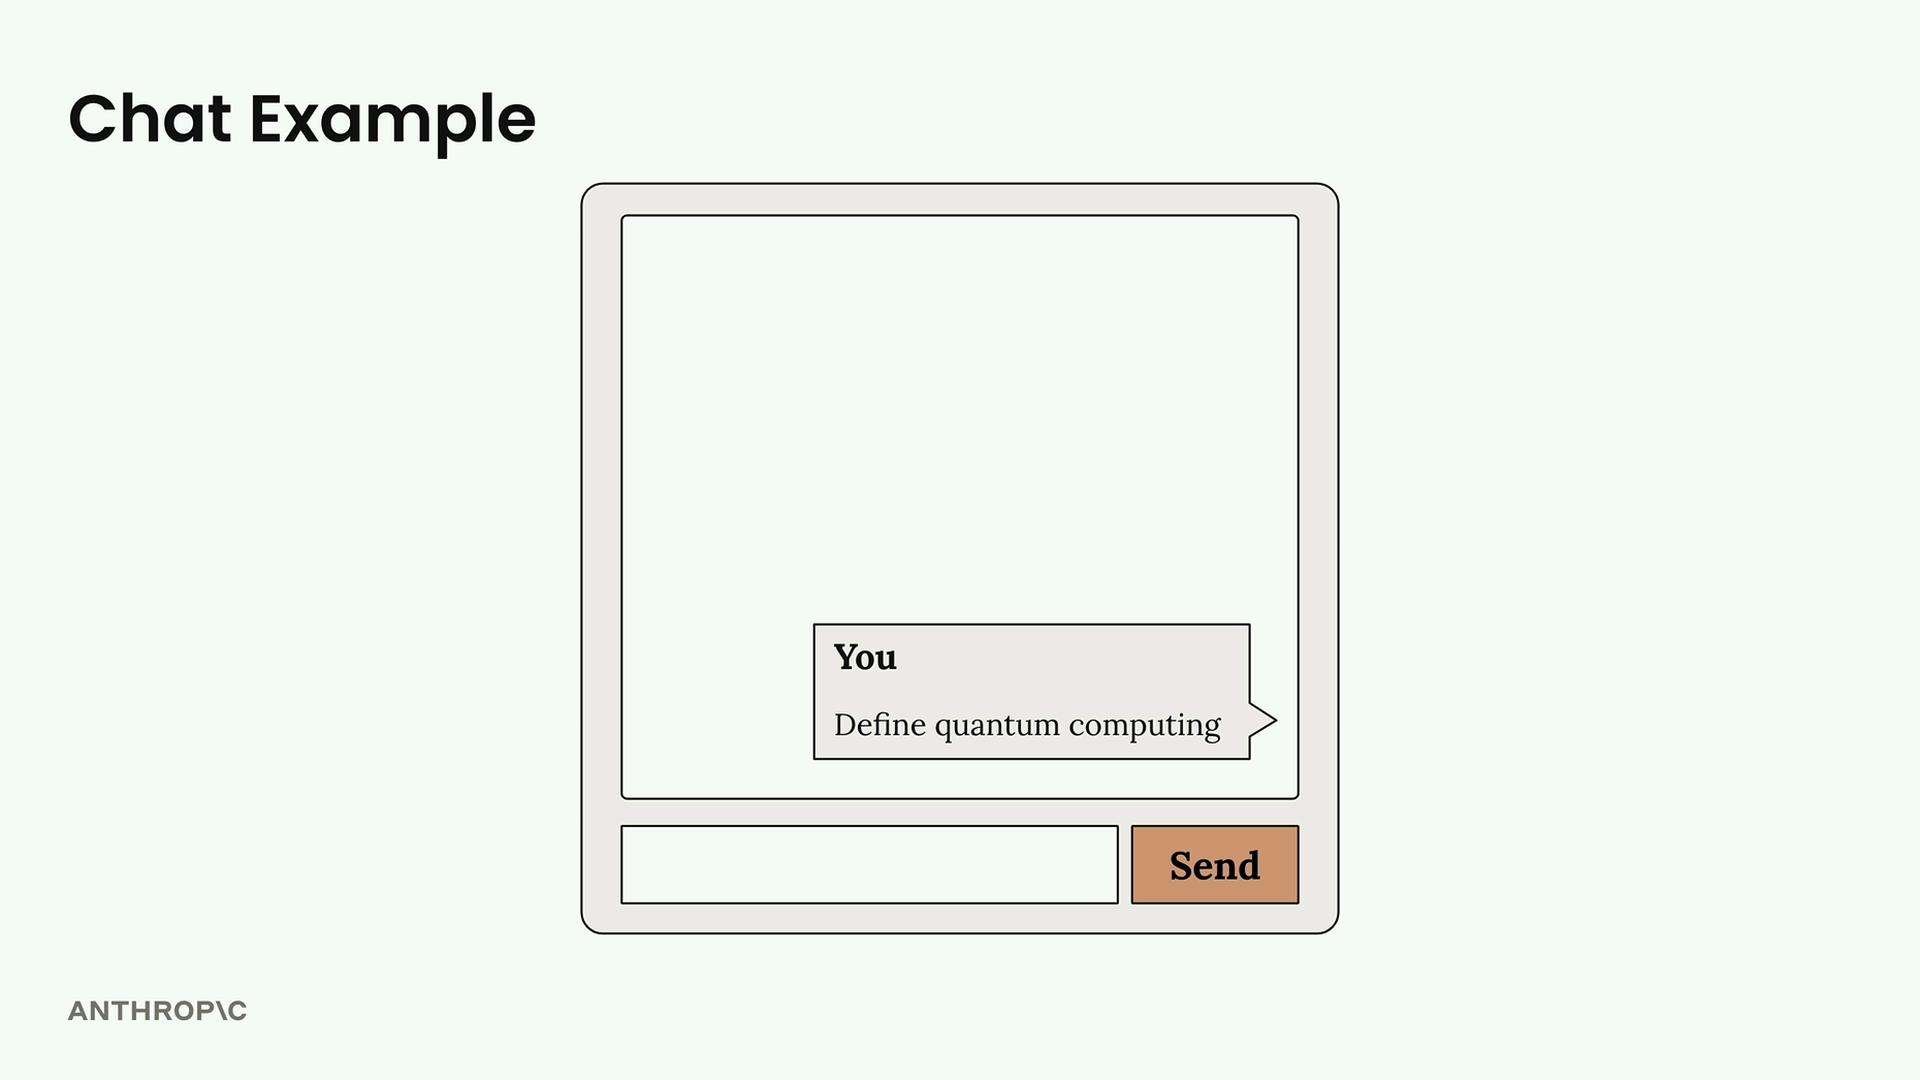
L'utilisateur voit une interface simple, mais tout un système fonctionne en coulisses pour générer cette réponse.
Le flux de la requête
Lorsqu'un utilisateur envoie du texte, voici le parcours que suit ce message :
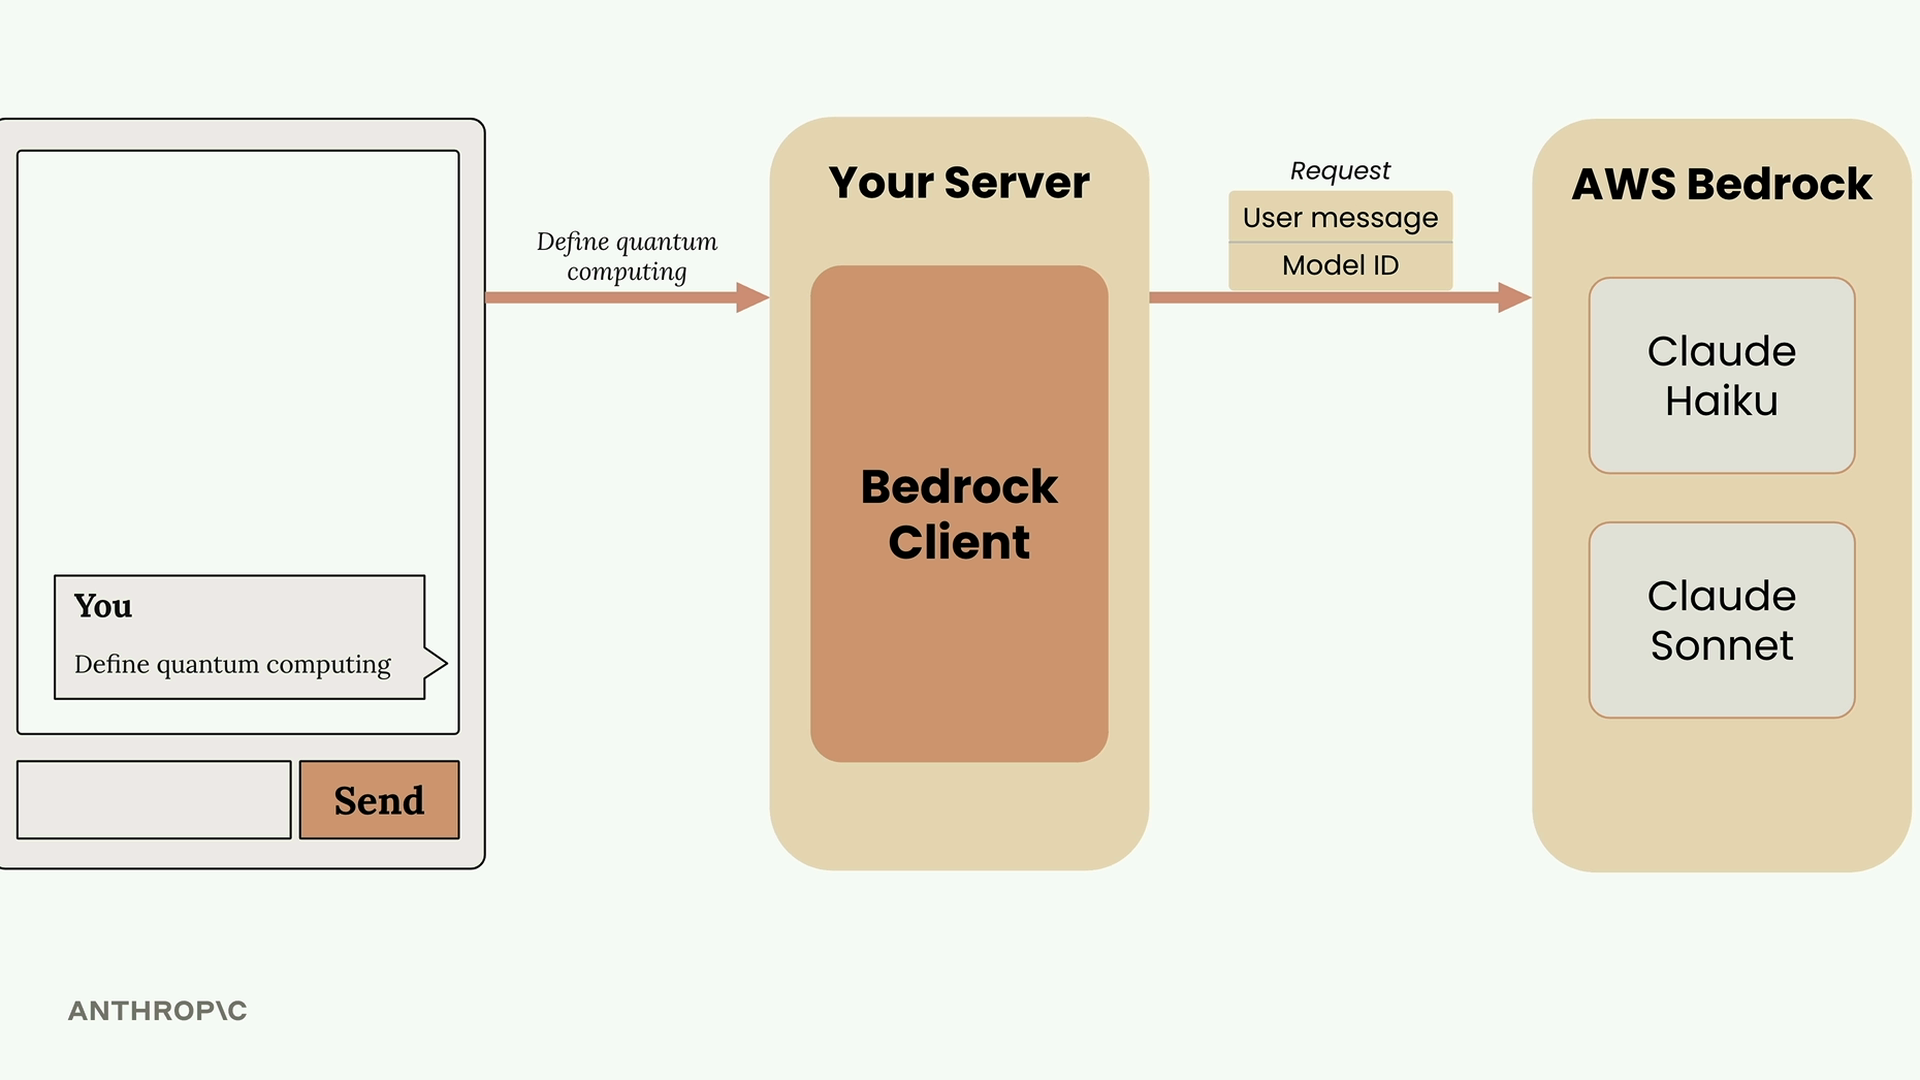
- L'utilisateur envoie son message via votre interface web
- Votre serveur reçoit la requête contenant ce texte
- Votre serveur utilise le client Bedrock pour effectuer une requête vers AWS Bedrock
- La requête inclut le message de l'utilisateur et un identifiant de modèle (comme Claude Haiku ou Claude Sonnet)
- Le modèle choisi traite la requête et génère du texte
- AWS Bedrock renvoie un message d'assistant contenant la réponse générée
- Votre serveur transmet cette réponse au navigateur de l'utilisateur