La réflexion étendue est la fonctionnalité avancée de Claude qui donne au modèle le temps de raisonner sur des problèmes complexes avant de générer une réponse finale. Pensez-y comme au monologue intérieur de Claude : vous pouvez voir comment il aborde votre problème étape par étape.
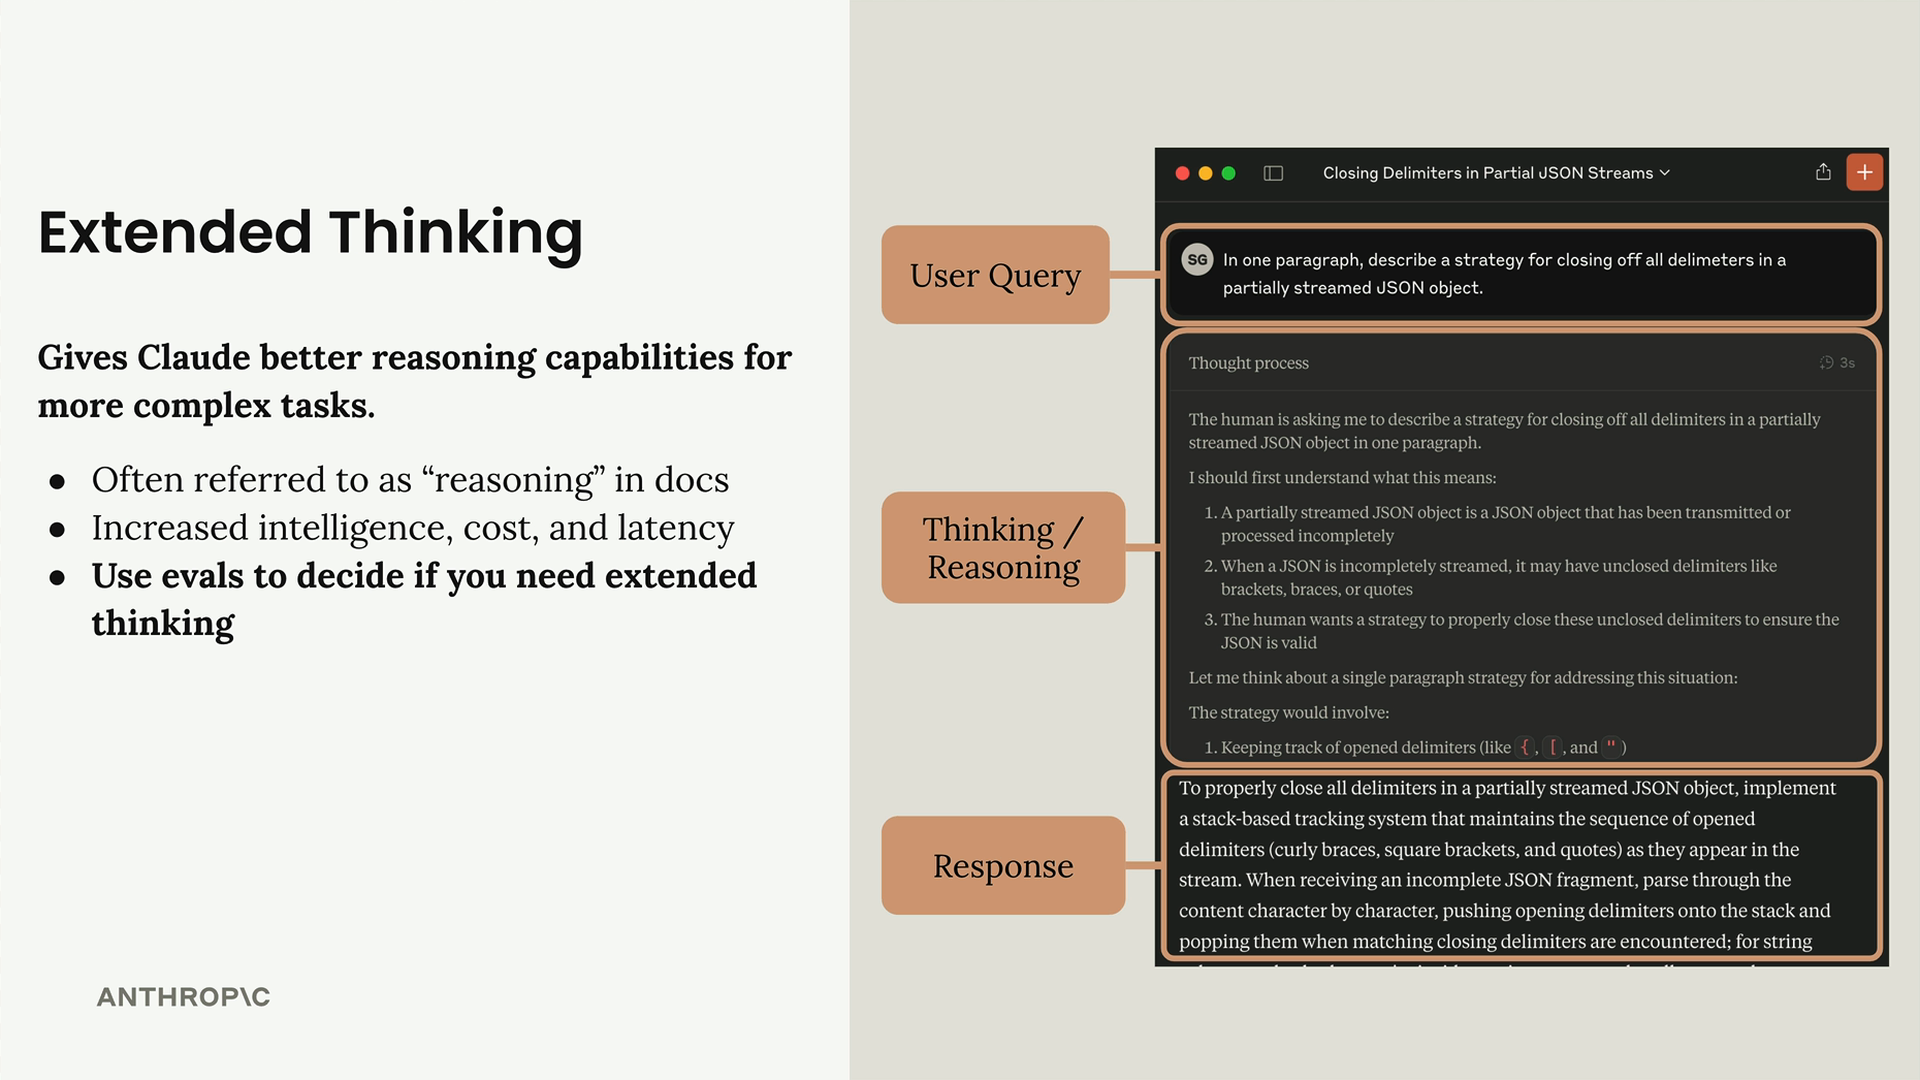
Fonctionnement de la réflexion étendue
Lorsque vous activez la réflexion étendue, la réponse de Claude comprend deux parties au lieu d'une seule :
- Partie contenu de raisonnement - le processus de réflexion interne de Claude
- Partie texte - la réponse finale que vous souhaitiez réellement
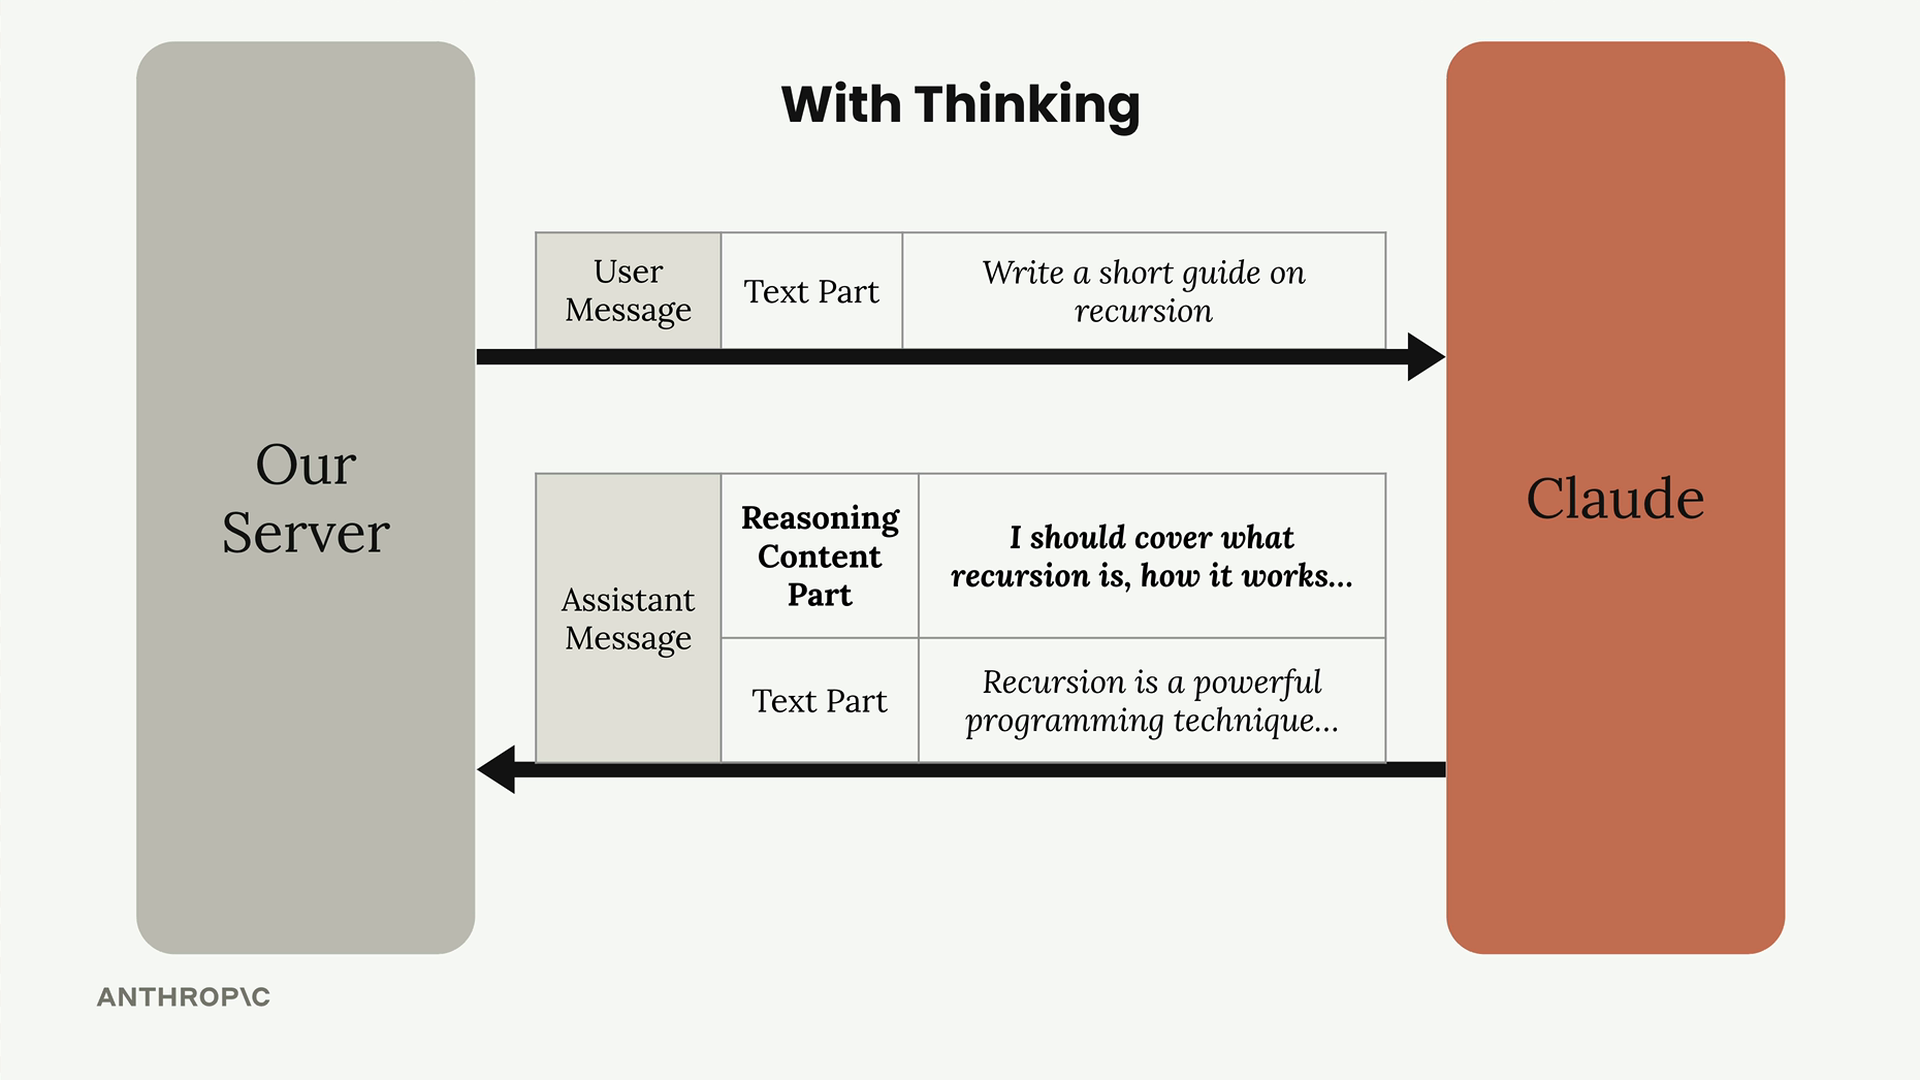
Le contenu de raisonnement vous montre exactement comment Claude décompose votre problème, ce qu'il prend en compte, et comment il parvient à sa réponse finale. Cette transparence peut s'avérer extrêmement précieuse pour comprendre et déboguer des tâches complexes.
Compromis à prendre en compte
La réflexion étendue s'accompagne d'avantages et de coûts clairs :
- Meilleure précision sur les tâches complexes
- Coût plus élevé - vous payez pour tous les jetons de réflexion
- Latence accrue - la réflexion prend du temps
Le point de décision clé est simple : utilisez vos évaluations. Si vous avez déjà optimisé votre requête mais que vous n'obtenez toujours pas la précision dont vous avez besoin, c'est à ce moment-là que la réflexion étendue mérite d'être envisagée.
Le système de signature
Un détail important que vous remarquerez immédiatement est la signature cryptographique associée au contenu de raisonnement :
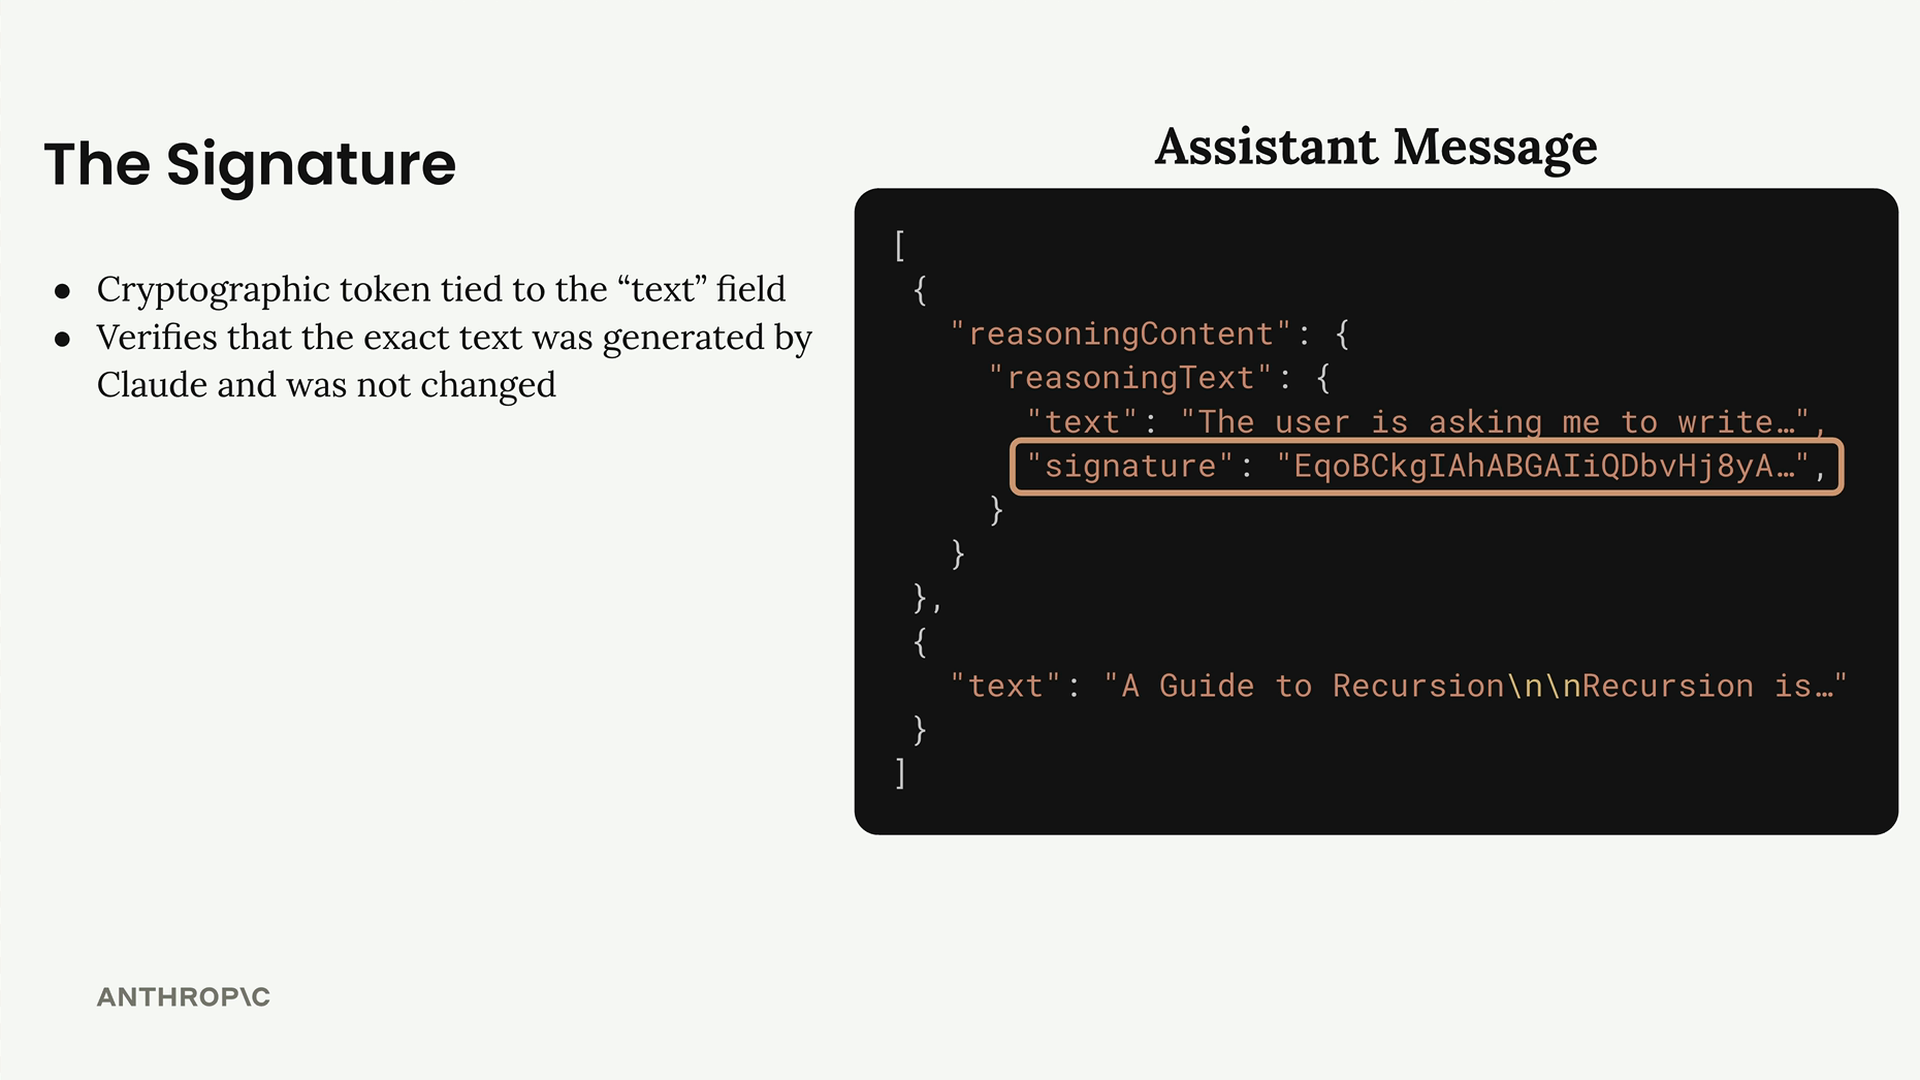
Cette signature garantit que vous ne pouvez pas modifier le texte de réflexion. Si vous souhaitez inclure le raisonnement précédent de Claude dans une conversation de suivi, la signature vérifie que le contenu n'a pas été altéré. Cela évite les problèmes de sécurité potentiels liés à un texte de raisonnement modifié.
Contenu expurgé
Il arrive parfois que la réflexion de Claude soit signalée par les systèmes de sécurité. Dans ce cas, vous recevrez un champ redactedContent au lieu d'un texte de réflexion lisible :
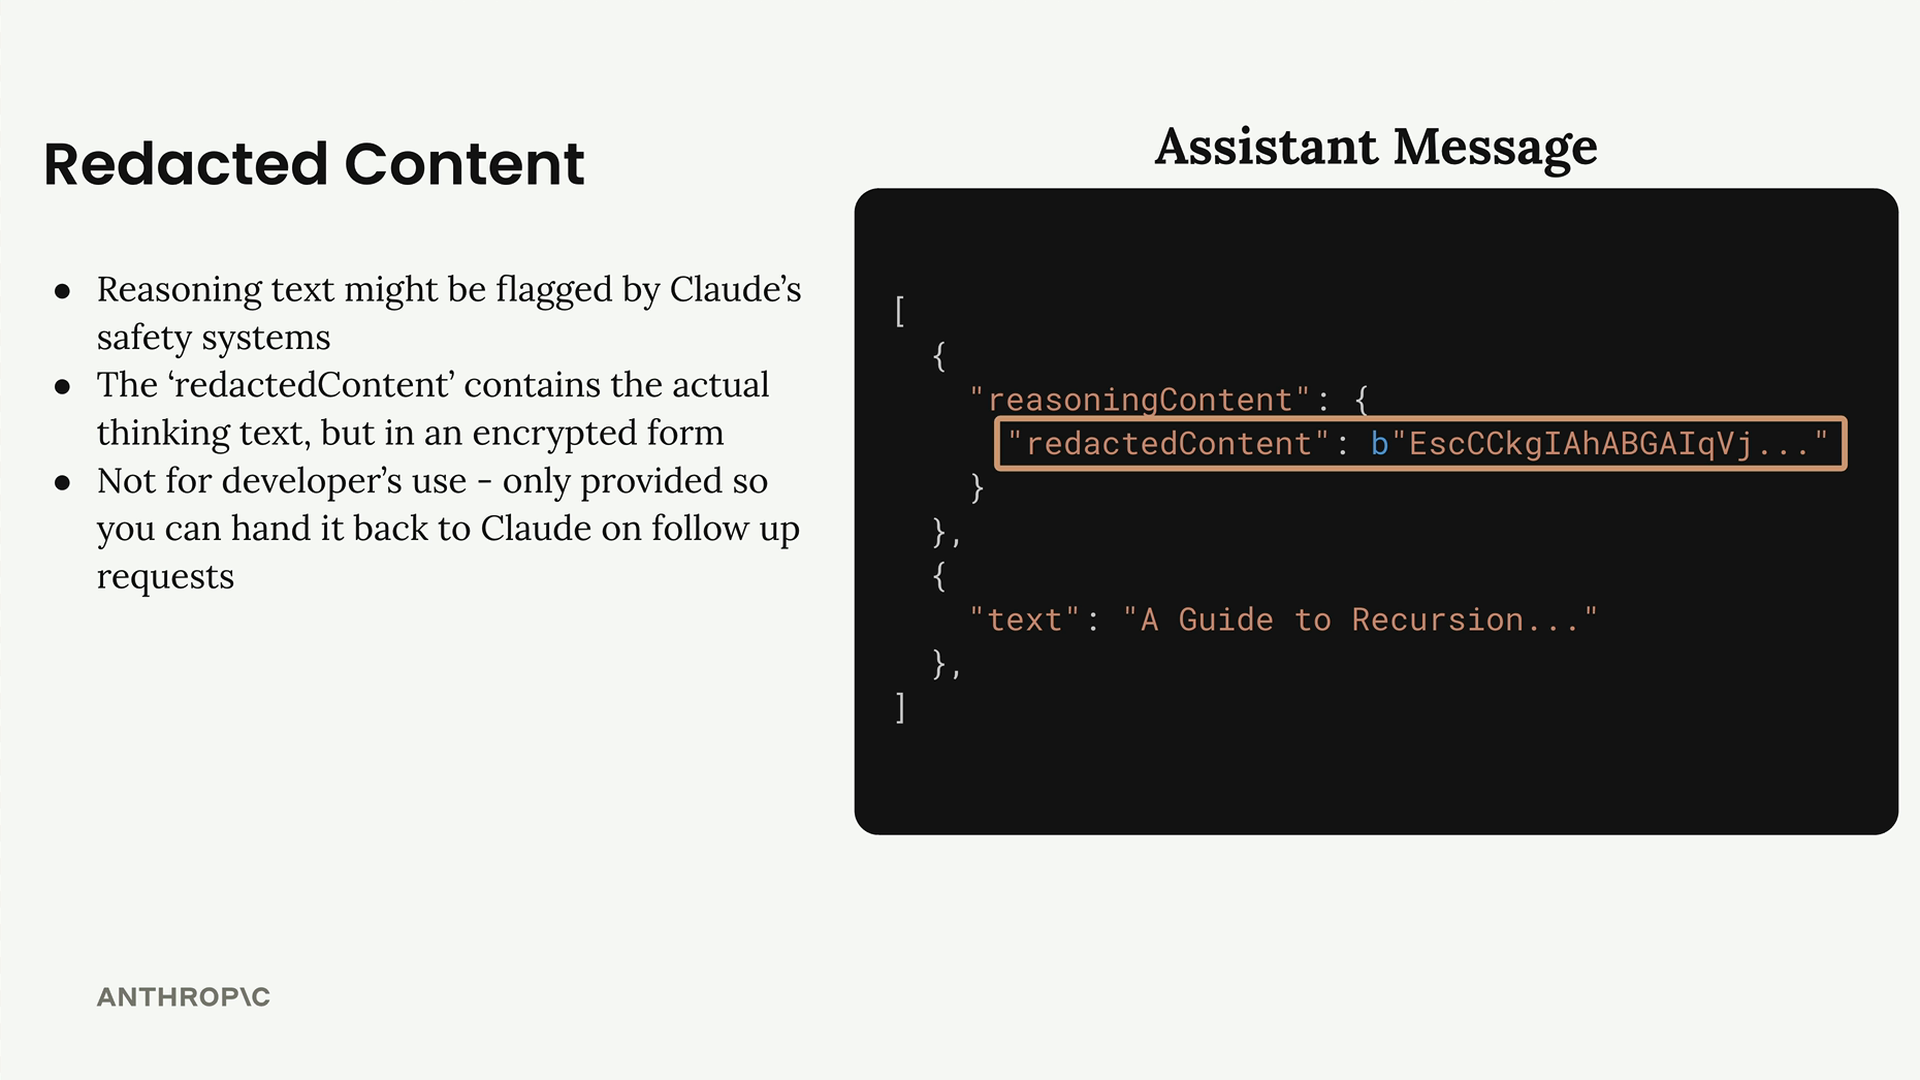
Le contenu expurgé est chiffré mais reste fonctionnel : vous pouvez le renvoyer à Claude lors de conversations futures sans perdre le contexte. Il n'est tout simplement pas lisible pour vous en tant que développeur.
Mise en œuvre
Sur les modèles Claude actuels, tels que Claude Opus 5 et Claude Sonnet 5, la réflexion fonctionne sous forme de réflexion adaptative et est activée par défaut : Claude décide de la quantité de raisonnement nécessaire pour chaque requête, sans budget de jetons à gérer. Ces modèles omettent le texte de raisonnement sauf si vous le demandez explicitement ; définissez donc display sur summarized pour le voir :
additional_model_fields["thinking"] = {
    "type": "adaptive",
    "display": "summarized"
}
Avec la réflexion adaptative activée, les questions simples reviennent souvent rapidement tandis que les questions plus difficiles bénéficient de davantage de temps de réflexion. Pour guider l'intensité de la réflexion de Claude, vous pouvez combiner la réflexion adaptative avec le paramètre effort. Le niveau d'effort agit comme une orientation souple pour l'allocation de réflexion de Claude, et remplace le budget de jetons manuel que vous géreriez autrement.
Si vous avez déjà utilisé la réflexion étendue auparavant, notez que la configuration manuelle est en cours d'abandon progressif : thinking.type: "enabled" avec budget_tokens est déprécié sur Claude Opus 4.6 et Claude Sonnet 4.6, et Claude Opus 4.7 et les modèles ultérieurs, y compris Claude Opus 5 et Claude Sonnet 5, ne le prennent pas en charge et rejettent ces requêtes avec une erreur 400. Utilisez plutôt thinking.type: "adaptive" avec le paramètre effort.
Modèles sans réflexion adaptative
Les modèles Claude 4.5 (Claude Haiku 4.5, Claude Sonnet 4.5 et Claude Opus 4.5) et les modèles antérieurs ne prennent pas en charge la réflexion adaptative. Sur ces modèles, vous activez la réflexion étendue avec un budget de jetons manuel :
additional_model_fields["thinking"] = {
    "type": "enabled",
    "budget_tokens": thinking_budget
}
Le thinking_budget contrôle le nombre de jetons que Claude peut consacrer au raisonnement. Le minimum est de 1 024 jetons, mais vous pourriez avoir besoin de plus pour des problèmes complexes. Comme pour tout le reste avec Claude, utilisez vos évaluations pour trouver le budget adapté à votre cas d'usage.
Voici à quoi ressemble la fonction de chat mise à jour :
def chat(
    messages,
    system=None,
    temperature=1.0,
    stop_sequences=[],
    tools=None,
    tool_choice="auto",
    text_editor=None,
    thinking=False,
    thinking_budget=1024
):
Tester votre implémentation
Lorsque vous développez des applications qui gèrent la réflexion étendue, vous voudrez tester à la fois les scénarios de contenu de raisonnement normal et de contenu expurgé. Il existe en réalité une chaîne de test spéciale qui force Claude à renvoyer du contenu expurgé - utile pour s'assurer que votre code gère correctement les deux cas.
L'enseignement le plus important concernant la réflexion étendue est que la décision de l'utiliser doit toujours reposer sur des données. Exécutez d'abord vos évaluations, optimisez vos requêtes, et ce n'est qu'ensuite que vous devez envisager la réflexion étendue si vous avez besoin de ce surcroît de précision pour des tâches complexes. Cette discipline repose sur une habitude simple : définir à quoi ressemble un bon résultat avant de recourir à davantage de capacité. Lorsque vous connaissez la précision dont votre tâche a besoin, vous pouvez déterminer si la réflexion étendue justifie son coût au lieu de deviner.
Exercice pratique : exécutez vous-même la réflexion adaptative
La réflexion adaptative se comprend le plus facilement en l'observant prendre des décisions. Dans le code où vous avez construit la fonction de chat, activez-la :
additional_model_fields["thinking"] = {
    "type": "adaptive",
    "display": "summarized"
}
Envoyez maintenant deux requêtes via cette même configuration. Posez d'abord une question factuelle rapide dont vous connaissez déjà la réponse. Posez ensuite une question véritablement difficile, comme un problème d'analyse à plusieurs étapes issu de votre propre travail. Si vous travaillez sur un modèle qui ne prend pas en charge la réflexion adaptative, activez la réflexion avec la configuration manuelle budget_tokens de la section précédente et exécutez les deux mêmes requêtes.
Vérifiez ce que la réflexion a fait
Définir l'indicateur prouve uniquement que la requête a été acceptée. Ces vérifications vous indiquent ce que la réflexion a réellement fait :
- Confirmez que la réflexion s'est engagée. Chaque réponse doit désormais contenir deux parties, le contenu de raisonnement et le texte final, au lieu du texte seul. La seule exception est le contenu expurgé, que vous avez vu précédemment : un champ
redactedContentsignifie que la réflexion a eu lieu mais que le texte est chiffré. - Lisez le contenu de raisonnement. Vérifiez qu'il raisonne véritablement sur la question que vous avez posée plutôt que de se contenter de la reformuler. Il s'agit de la même transparence sur laquelle vous vous appuierez ultérieurement pour déboguer des tâches complexes.
- Comparez les deux requêtes. La question simple reviendra généralement rapidement avec peu de raisonnement, tandis que la question difficile en obtiendra nettement plus. Cette différence témoigne de la réflexion adaptative en train de prendre la décision d'allocation à votre place.
- Évaluez le coût. Vous payez pour chaque jeton de réflexion, vérifiez donc si la réponse plus difficile est meilleure que ce que vous obtenez sans réflexion. Vos évaluations en sont les juges, et voir apparaître du texte de raisonnement ne les remplace pas.
Le comportement à retenir de cette leçon : chaque fois que vous activez la réflexion étendue sur une nouvelle tâche, lisez le contenu de raisonnement sur quelques requêtes représentatives et relancez vos évaluations avant de décider de conserver ce réglage.