La mémorisation des requêtes est une fonctionnalité qui accélère les réponses de Claude et réduit le coût de la génération de texte en réutilisant le travail de calcul effectué lors des requêtes précédentes. Pour comprendre comment cela fonctionne, examinons d'abord ce qui se passe normalement à l'intérieur de Claude lors d'une requête typique.
Comment Claude traite normalement les requêtes
Lorsque vous envoyez un message à Claude, de nombreuses opérations se déroulent en coulisses avant que vous ne receviez une réponse. Claude ne se met pas immédiatement à générer du texte : il effectue d'abord un travail approfondi sur votre message d'entrée.
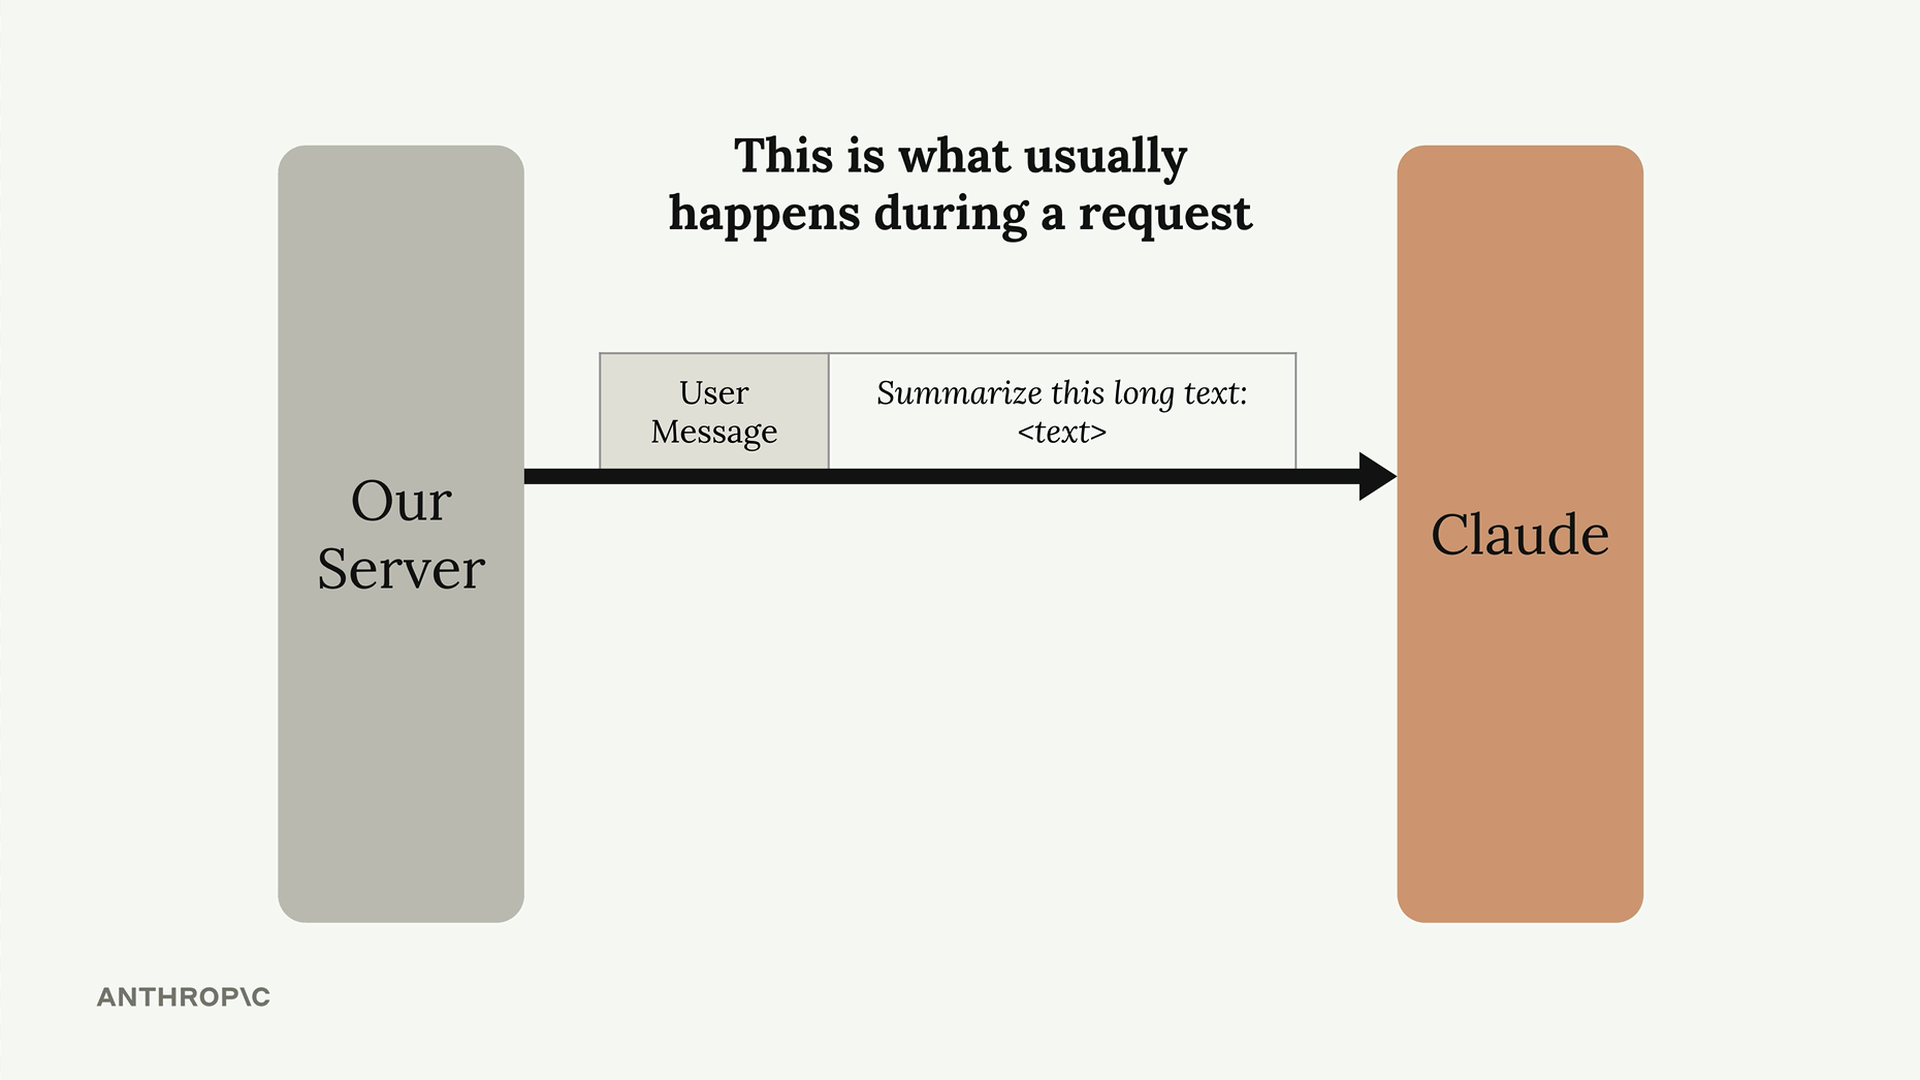
Voici ce que Claude fait avec votre message :
- Segmenter la requête en jetons
- Créer des embeddings pour chaque jeton
- Ajouter du contexte en fonction du texte environnant
- Générer le texte de sortie
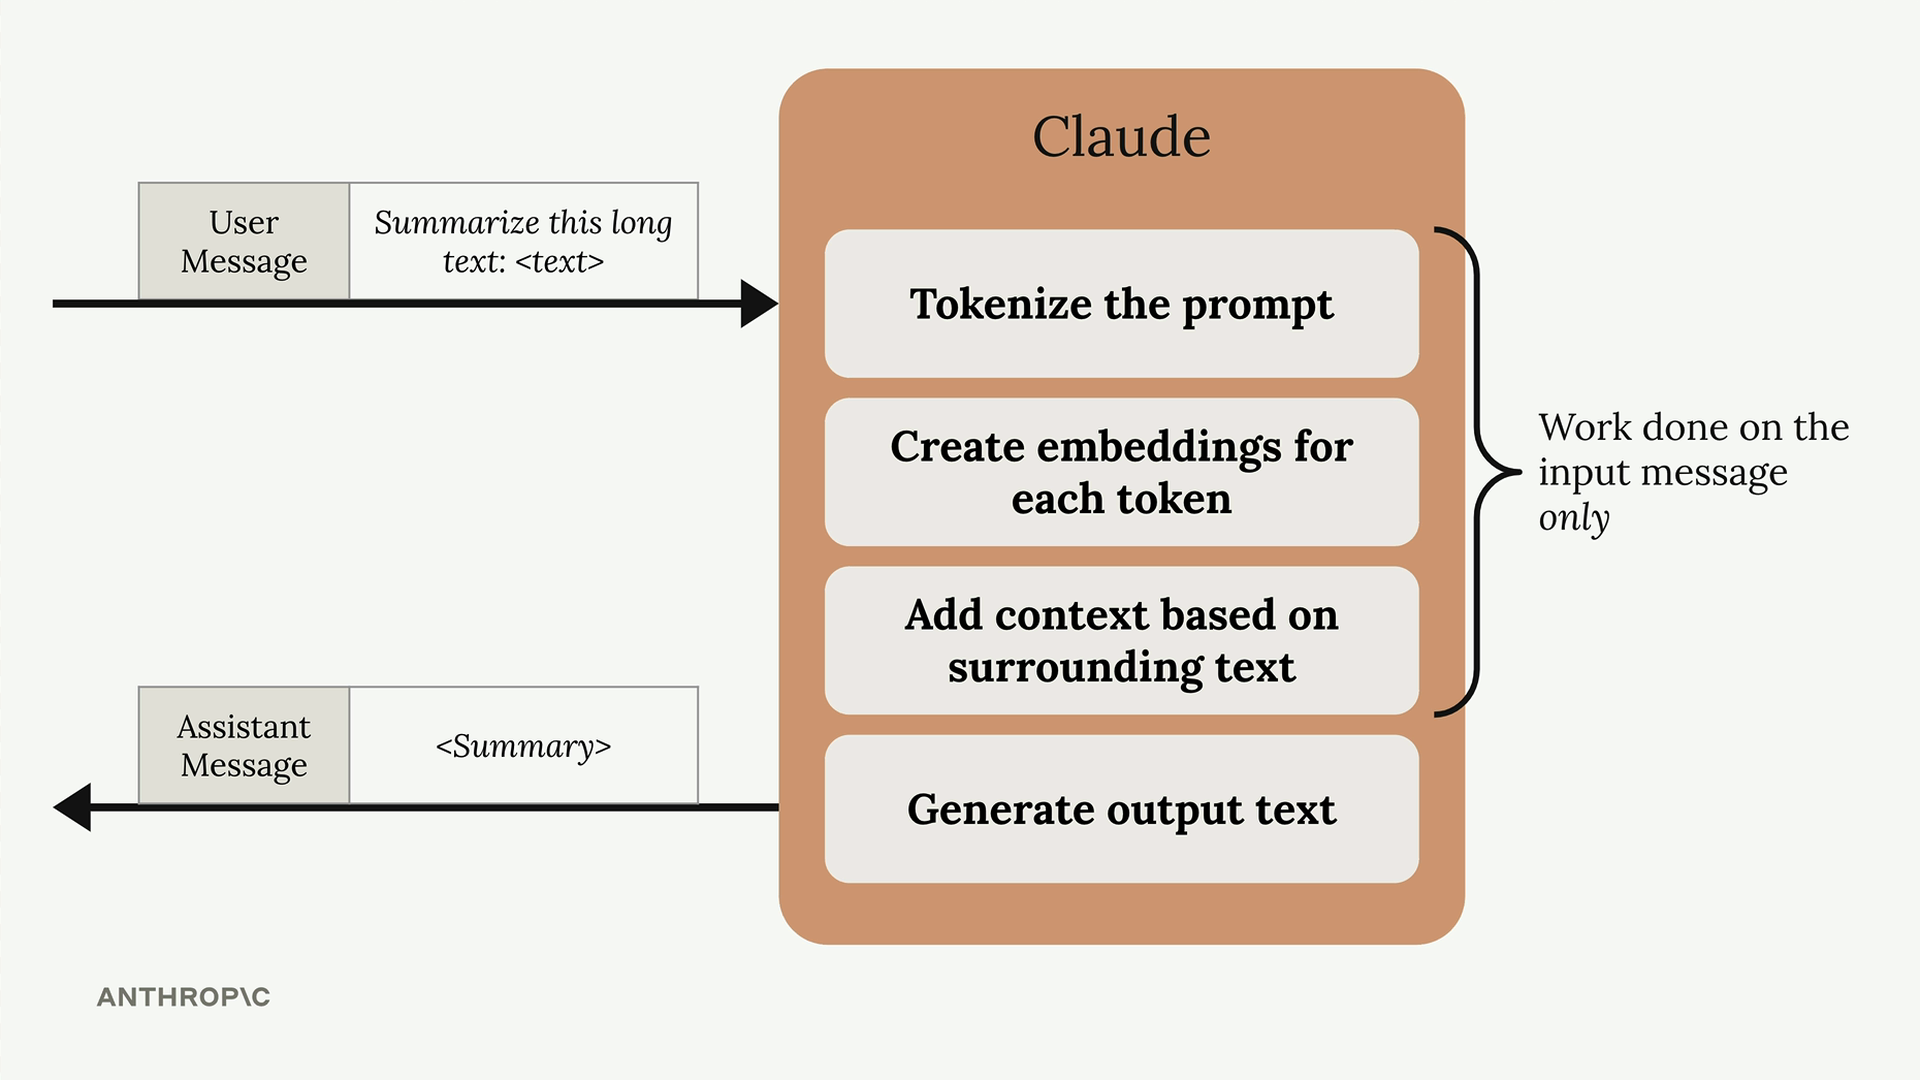
Tout ce travail de prétraitement se déroule avant que Claude ne génère une réponse proprement dite. Une fois que Claude a fini de traiter votre requête et a renvoyé la réponse, il jette tout le travail de calcul qu'il vient d'effectuer.
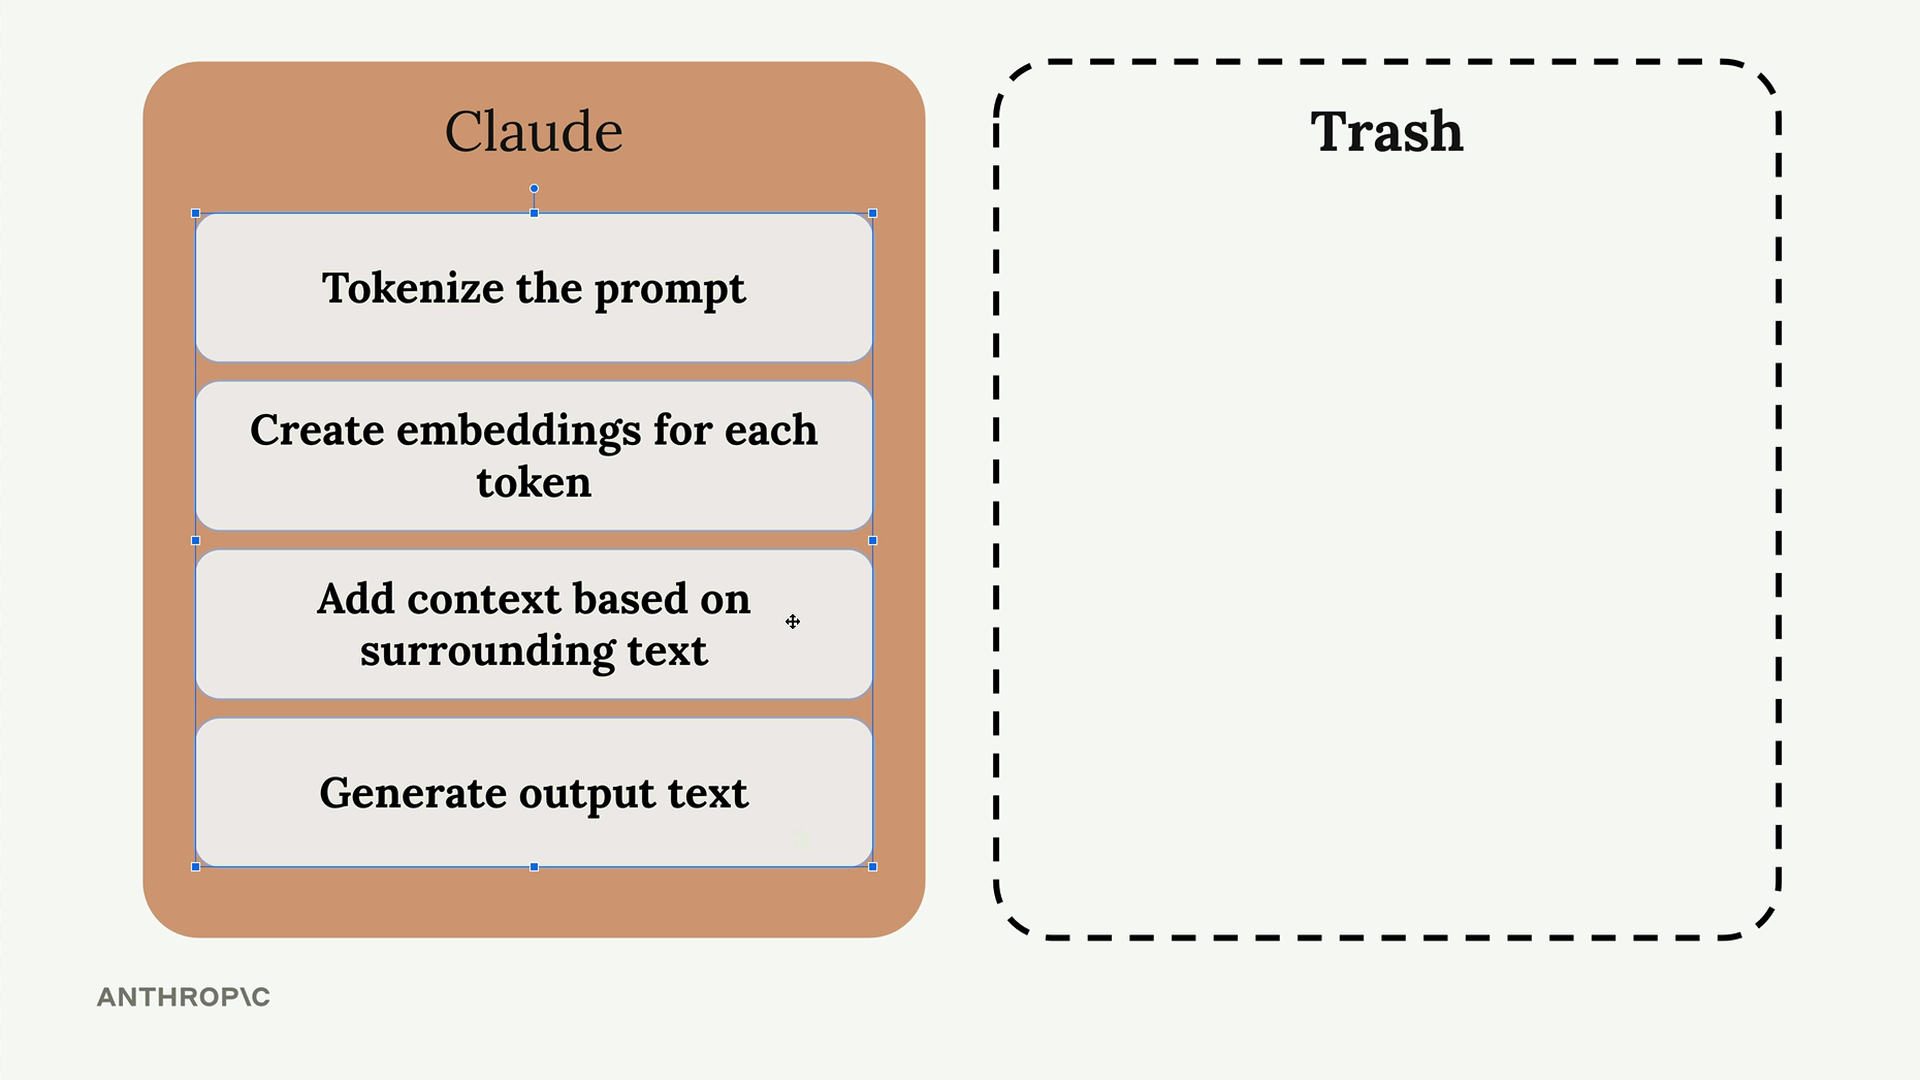
Le problème que pose le fait de jeter ce travail
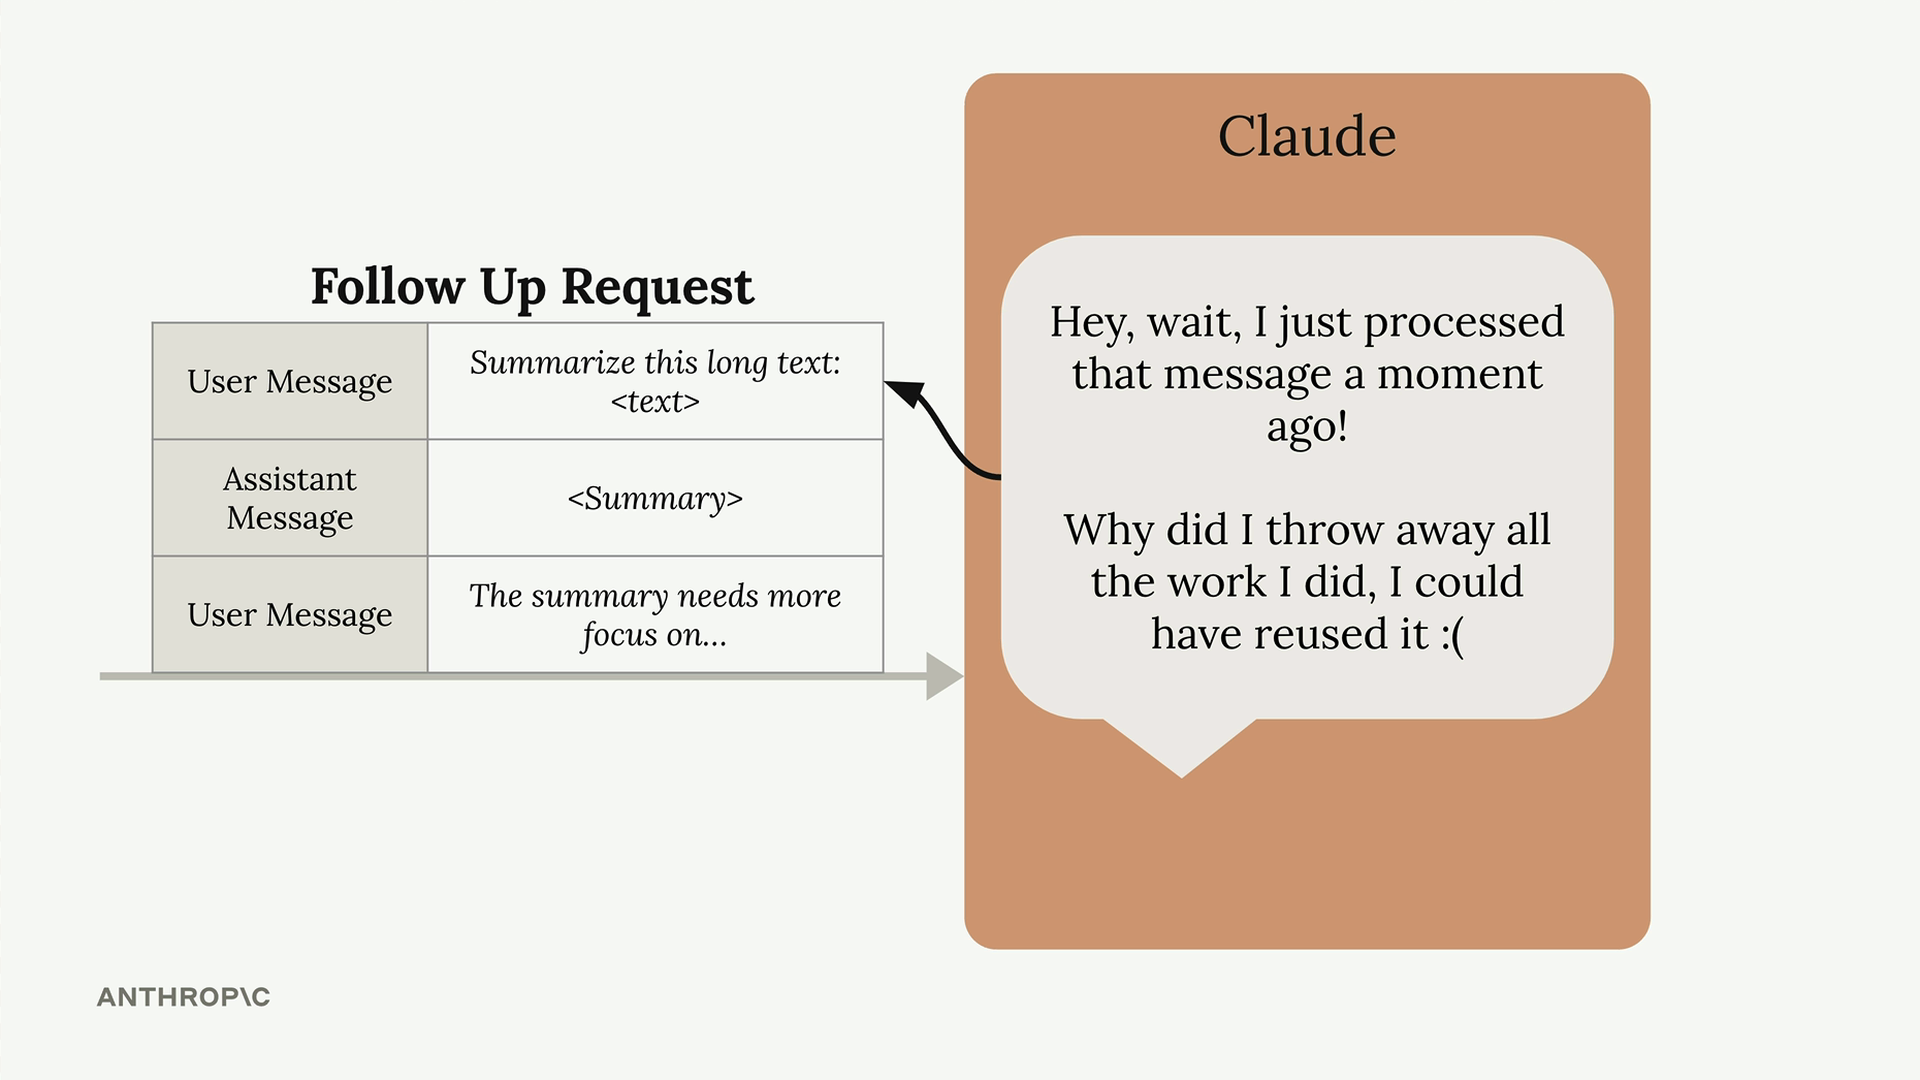
Cela crée une inefficacité lorsque vous avez des conversations avec Claude. Supposons que vous envoyiez une requête de suivi qui inclut le même message qu'auparavant, plus la réponse précédente de Claude, plus un nouveau message pour poursuivre la conversation.
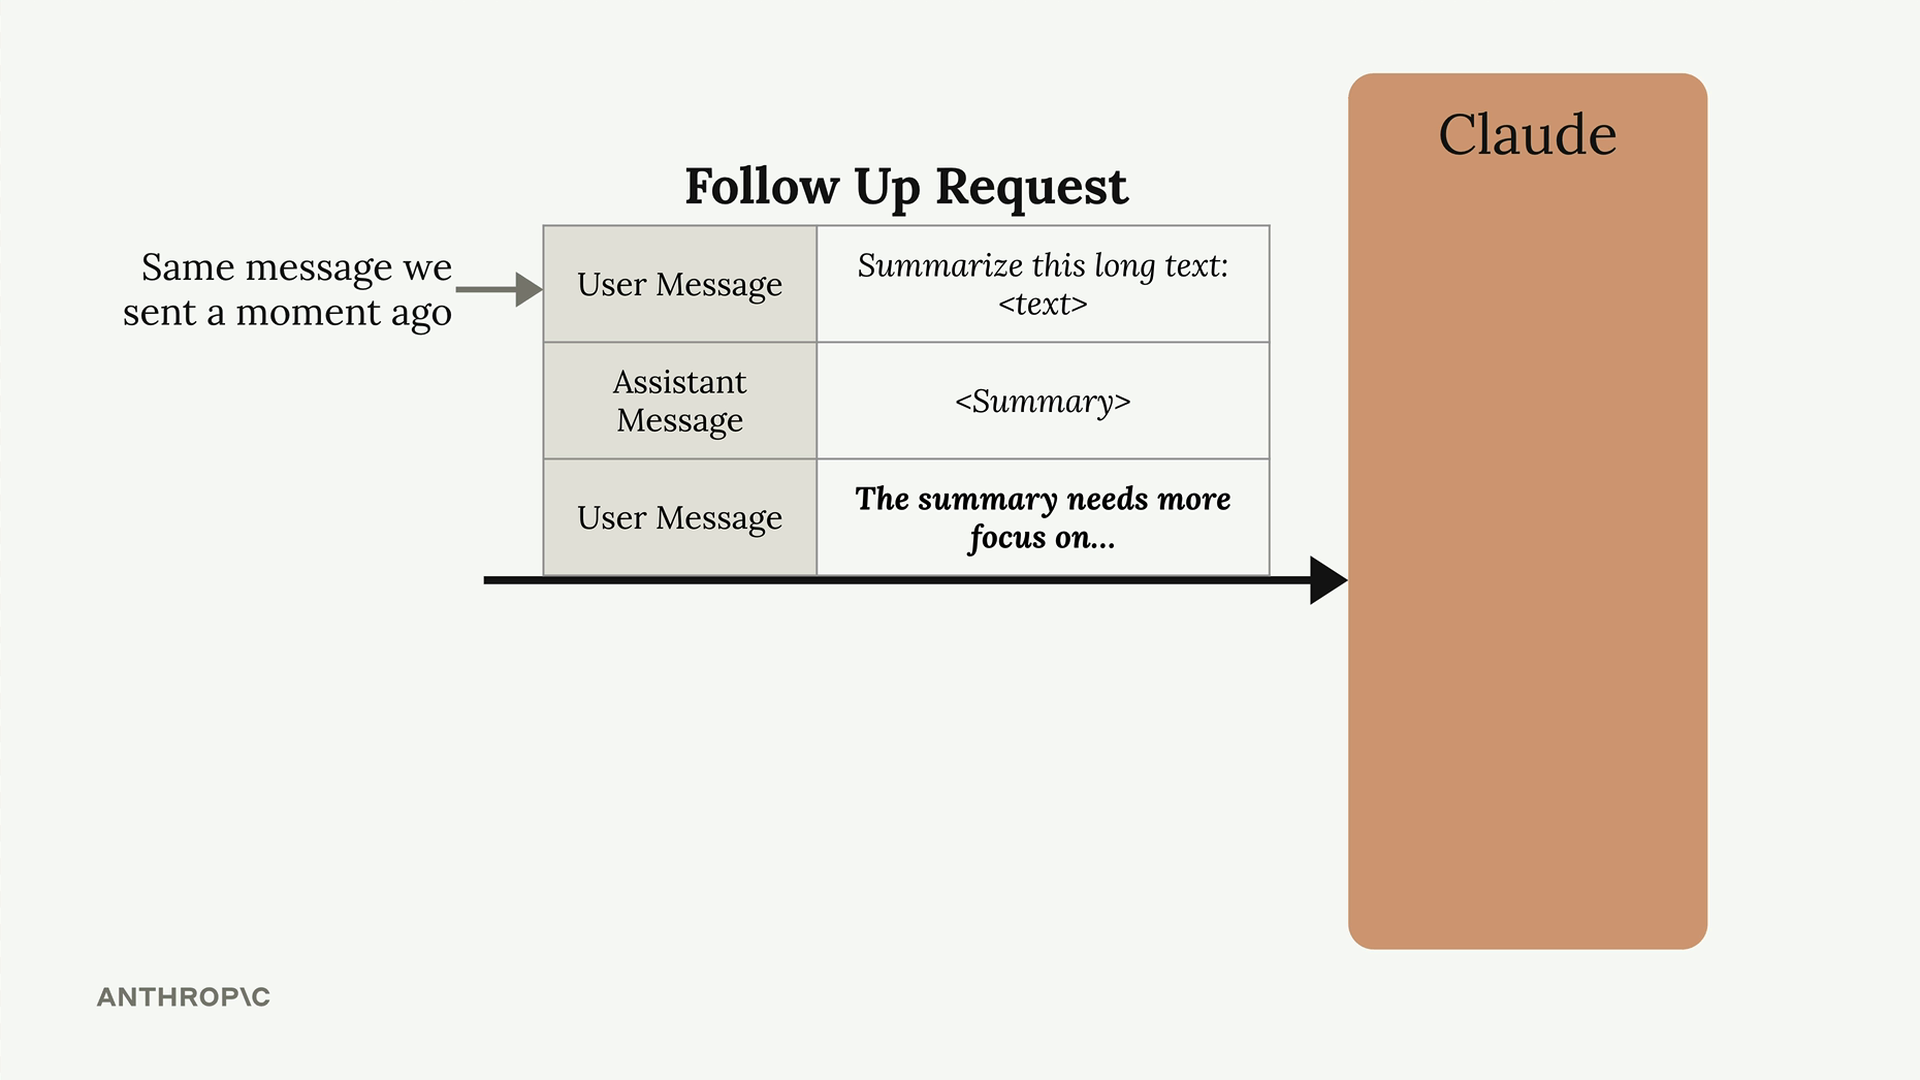
Lorsque Claude revoit ce message d'origine, il doit refaire exactement le même travail de calcul qu'il vient de jeter quelques instants plus tôt. Claude se dit en substance : « Je viens de traiter exactement ce message et d'effectuer tout ce travail, puis je l'ai jeté. Maintenant, je dois tout recommencer. »
Comment la mémorisation des requêtes résout ce problème
La mémorisation des requêtes résout cette inefficacité en conservant le travail de calcul au lieu de le jeter. Voici comment cela fonctionne :
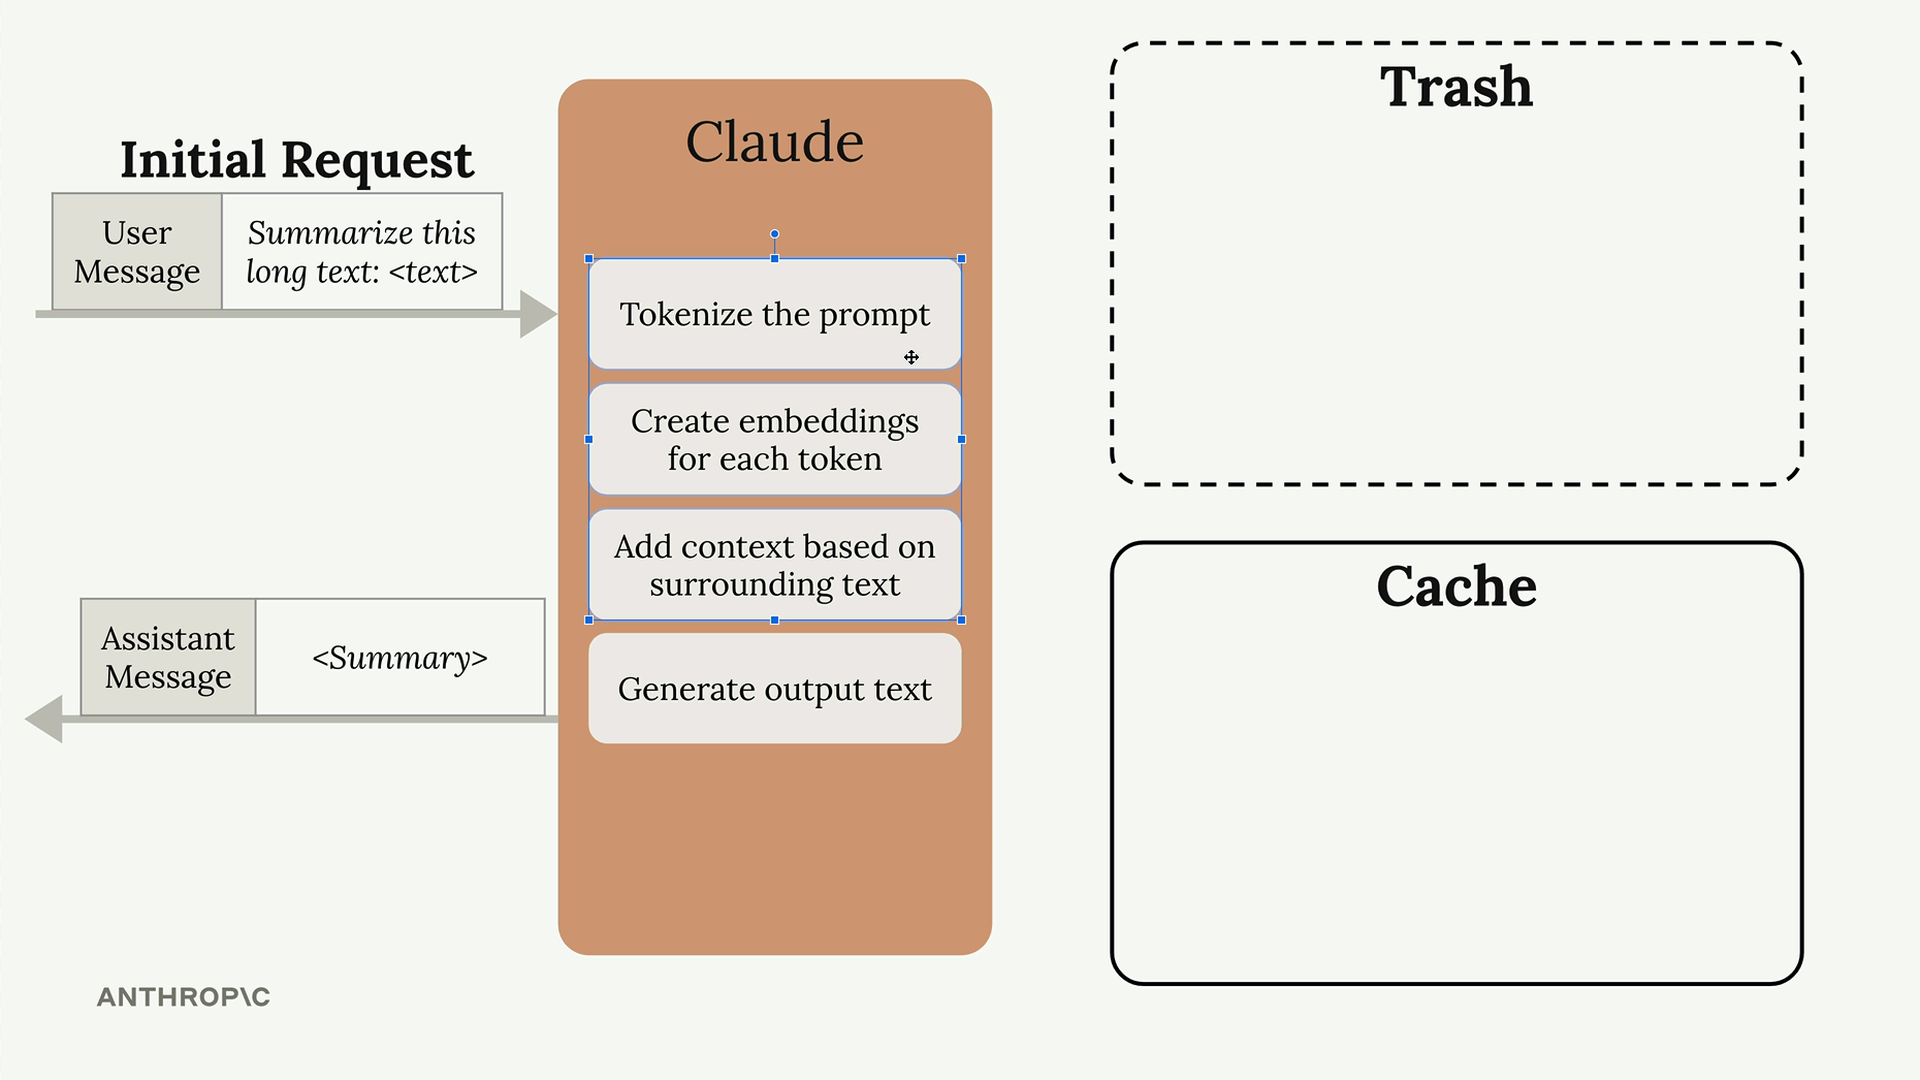
Lorsque Claude traite votre requête initiale, au lieu de jeter tout le travail de prétraitement, il stocke ce travail dans un cache. Le cache fonctionne comme une table de correspondance qui associe des messages d'entrée spécifiques à leurs résultats de calcul correspondants.
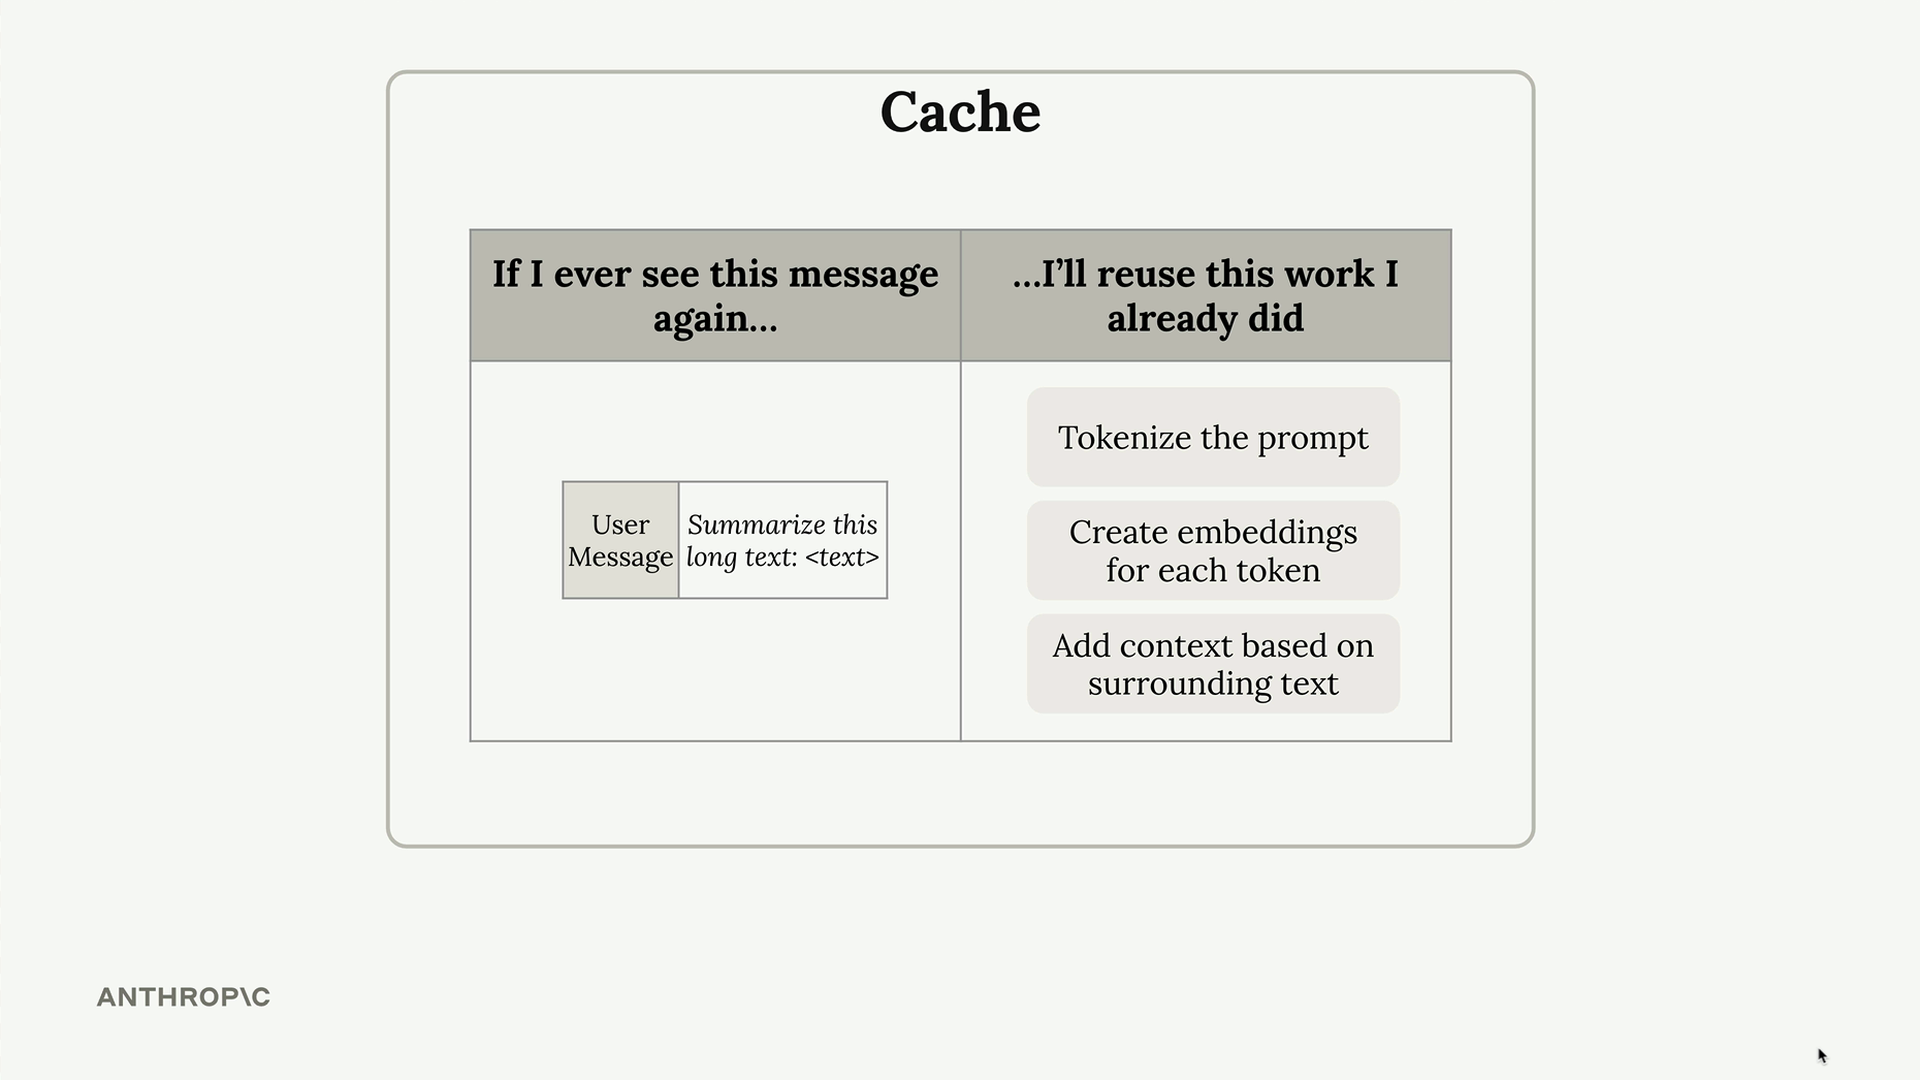
Lorsque vous envoyez une requête de suivi qui inclut le même contenu, Claude peut consulter son cache et réutiliser le travail précédent au lieu de repartir de zéro.
Principaux avantages et limites
La mémorisation des requêtes offre plusieurs avantages :
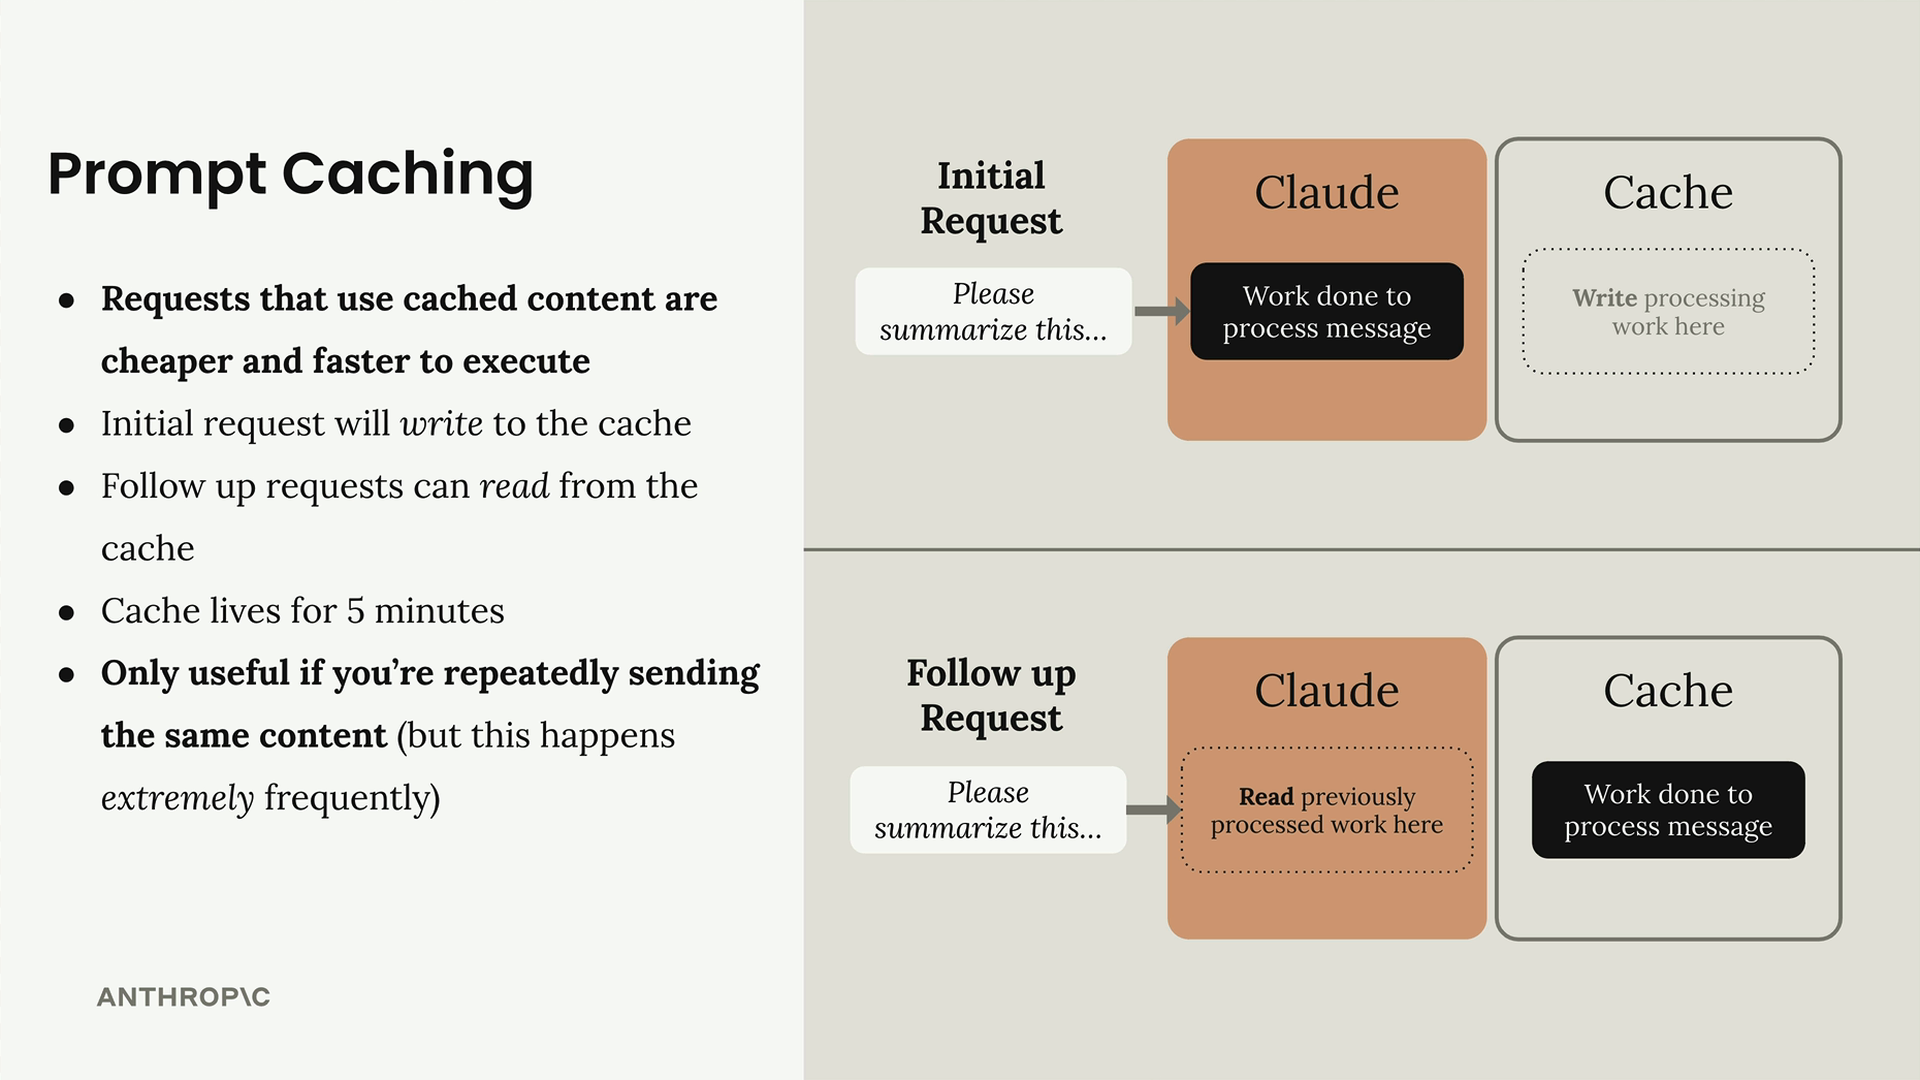
- Les requêtes qui utilisent du contenu mis en cache sont moins coûteuses et plus rapides à exécuter
- La requête initiale écrit dans le cache
- Les requêtes de suivi peuvent lire depuis le cache
- Le cache a une durée de vie de 5 minutes
- Utile uniquement si vous envoyez à plusieurs reprises le même contenu (ce qui se produit en réalité très fréquemment)
Le cache a une durée de vie de 5 minutes, il est donc particulièrement avantageux pour les conversations ou les flux de travail dans lesquels vous effectuez plusieurs requêtes avec un contenu qui se chevauche dans un court laps de temps. Ce schéma est en réalité très courant dans les applications réelles : pensez aux chatbots, aux outils d'analyse de documents, ou à tout système qui maintient le contexte d'une conversation.
La mémorisation des requêtes est particulièrement précieuse, car de nombreuses applications d'IA envoient effectivement le même contenu de manière répétée. Qu'il s'agisse d'invites système, d'historiques de conversation ou de documents volumineux en cours d'analyse, le même texte apparaît souvent dans plusieurs requêtes au sein d'une même session.