Lors de la création d'interfaces de chat avec des modèles d'IA, les utilisateurs s'attendent à voir les réponses apparaître immédiatement plutôt que d'attendre 10 à 30 secondes pour une réponse complète. La fonction converse_stream résout ce problème en diffusant le texte au fur et à mesure de sa génération, créant ainsi une bien meilleure expérience utilisateur.
Comment fonctionne le streaming
Plutôt que d'attendre que la réponse entière soit générée, le streaming renvoie des morceaux de texte dès qu'ils sont disponibles. Voici comment le flux change :
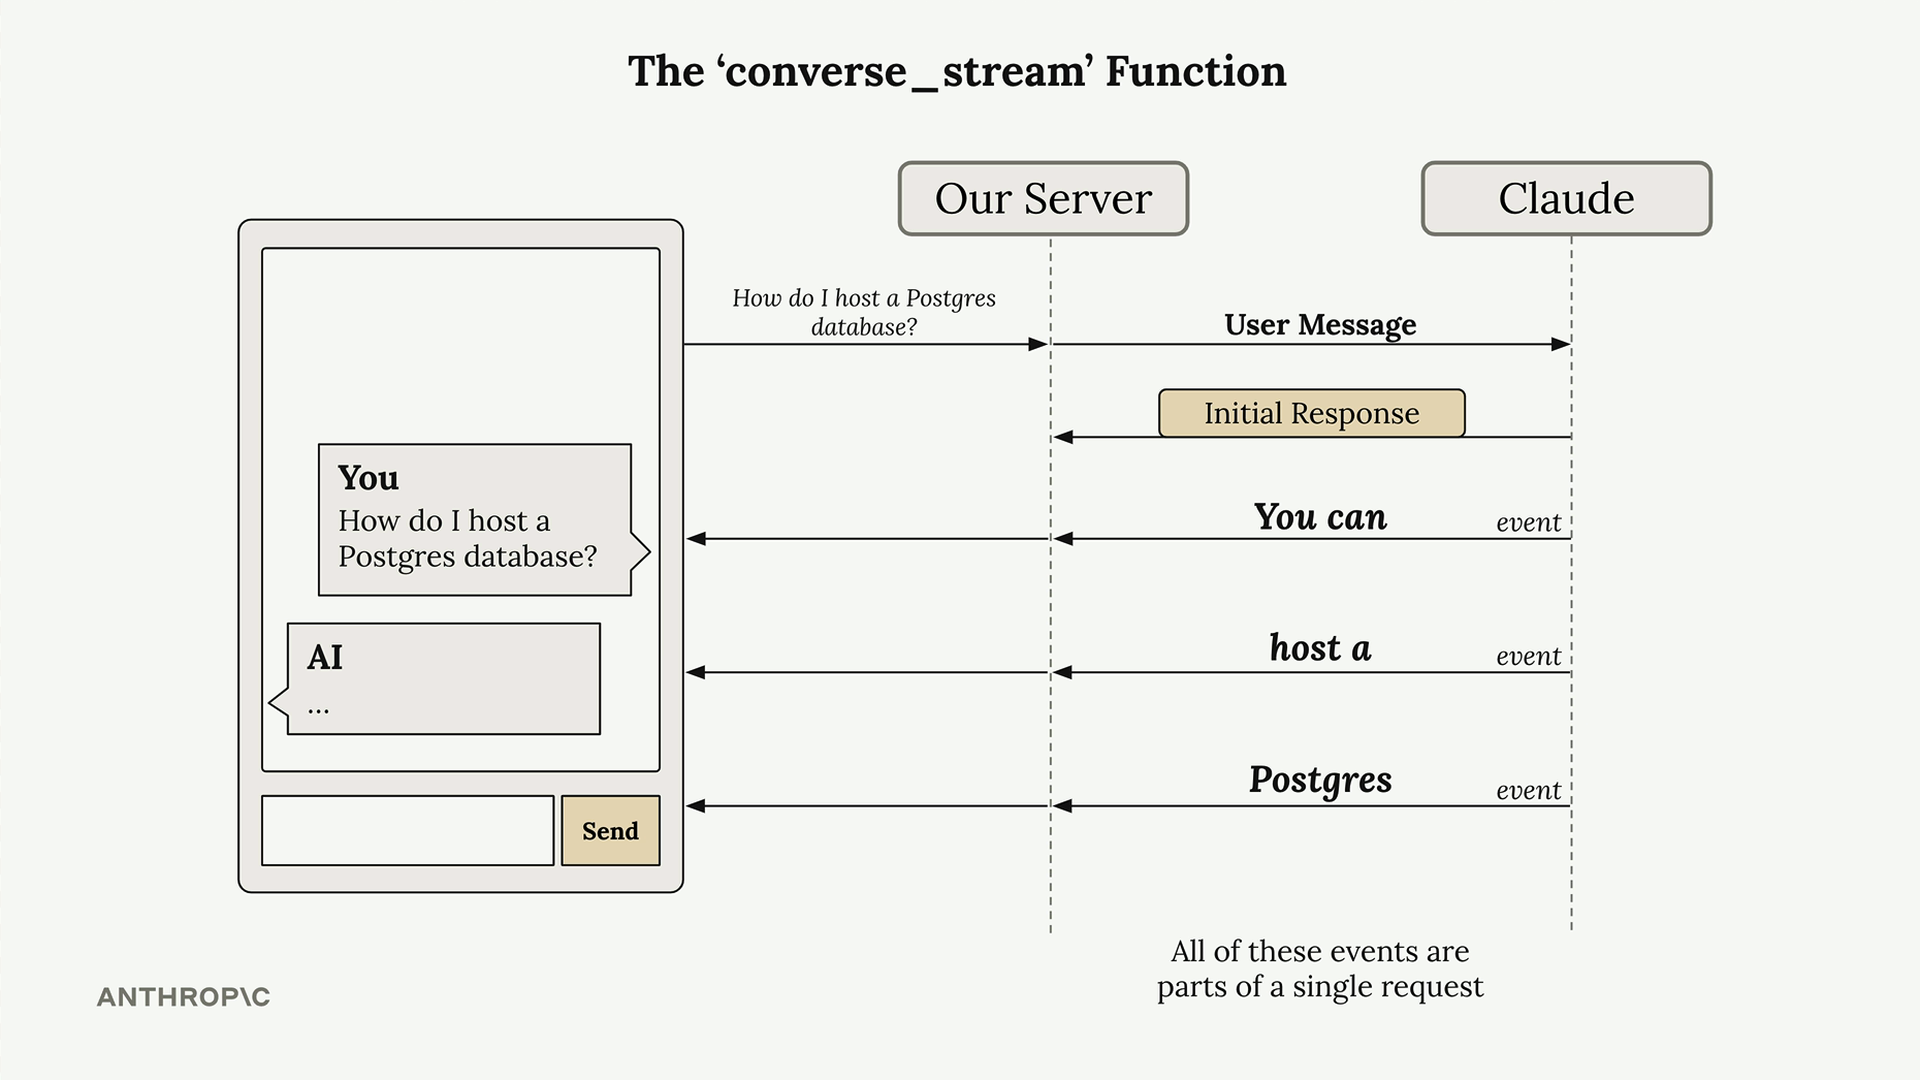
Lorsque vous appelez converse_stream, vous obtenez immédiatement une réponse initiale qui contient un objet stream. Ce flux est un générateur qui produit des événements au fur et à mesure que le modèle génère du texte. Chaque événement contient un petit fragment de la réponse globale.
Implémentation de base
Voici comment utiliser converse_stream dans votre code :
messages = []
add_user_message(messages, "Write a 1 sentence description of a fake database")
response = client.converse_stream(messages=messages, modelId=model_id)

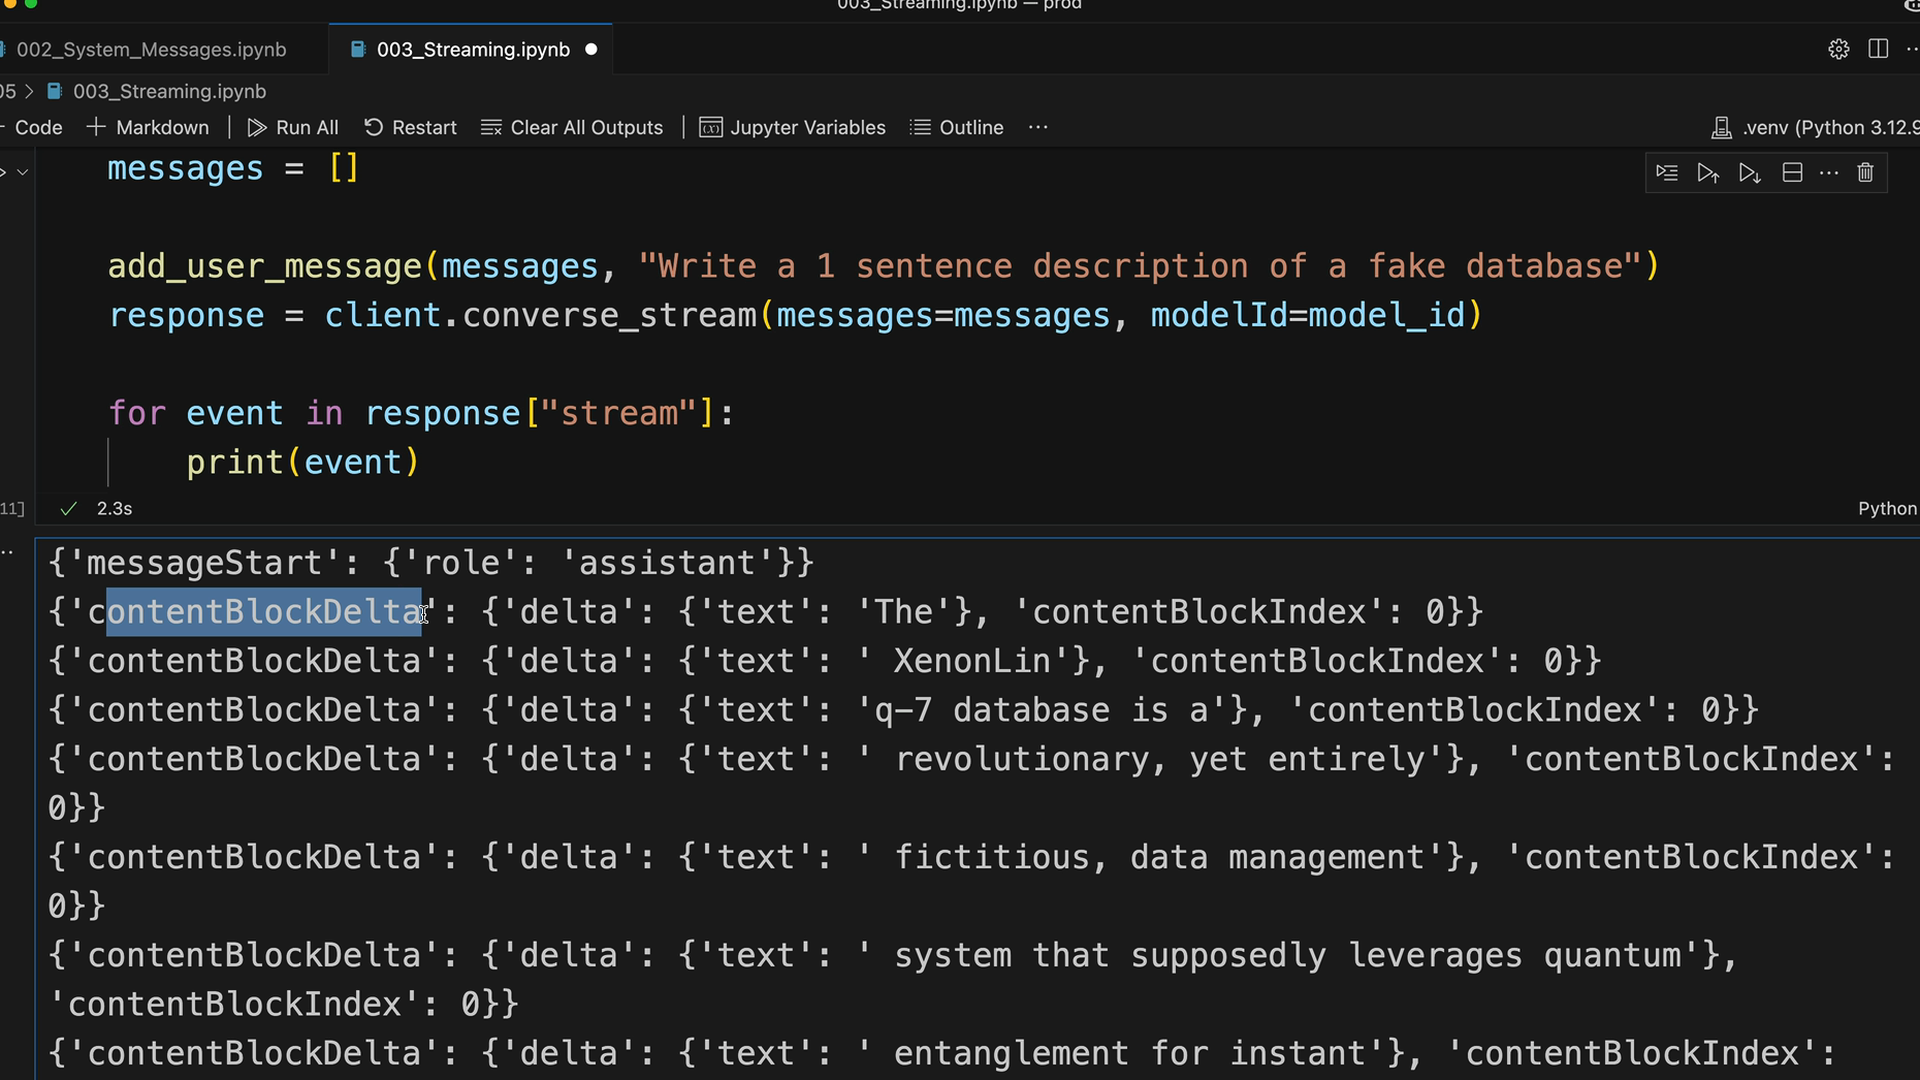
for event in response["stream"]:
    print(event)
Cela affichera tous les différents événements au fur et à mesure de leur arrivée. Vous verrez la réponse arriver par fragments plutôt que d'un seul coup.
Comprendre les événements de flux
Le flux produit plusieurs types d'événements, chacun ayant un objectif différent :
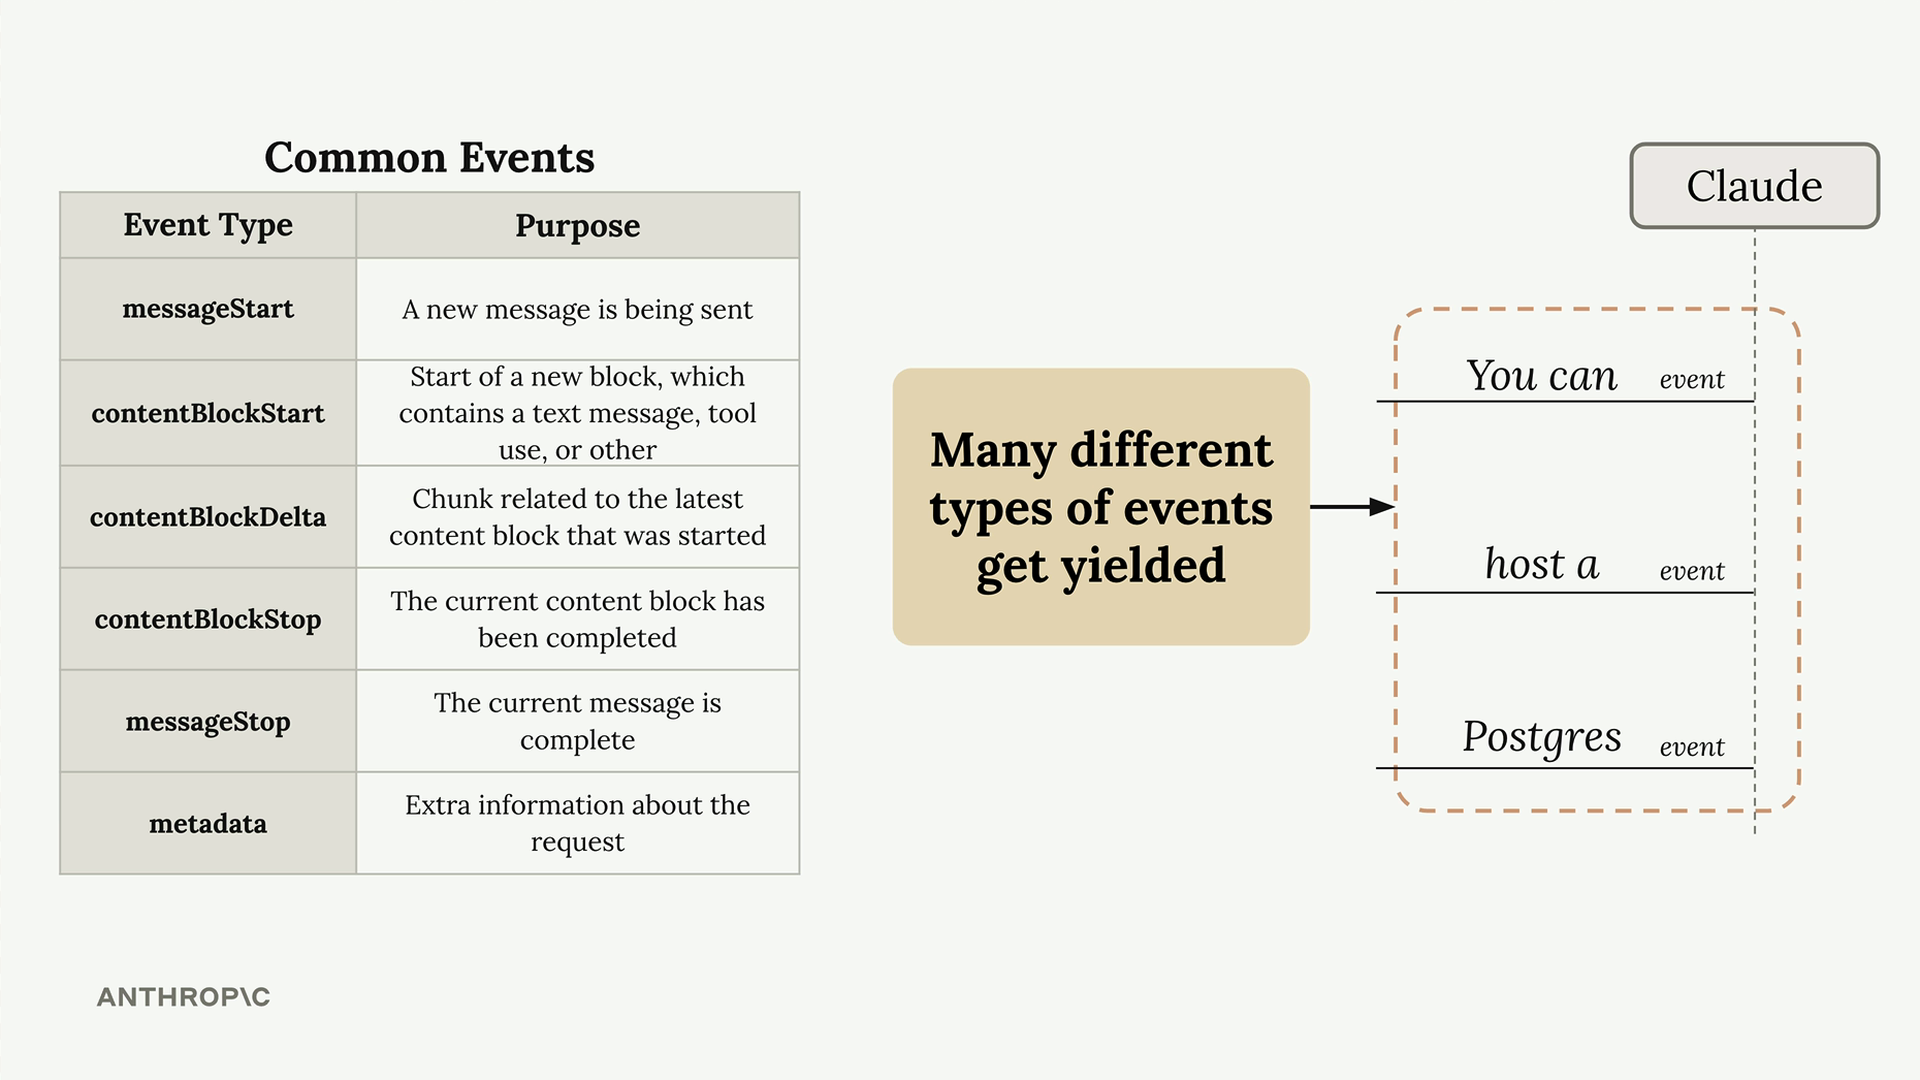
Pour la génération de texte de base, vous n'avez besoin de vous préoccuper que des événements contentBlockDelta. Ceux-ci contiennent les fragments de texte réellement générés que vous souhaitez afficher aux utilisateurs.
Les événements arrivent toujours dans un ordre prévisible : messageStart, plusieurs événements contentBlockDelta contenant votre texte, puis contentBlockStop, messageStop, et enfin metadata.
Extraire le texte
Pour obtenir uniquement le texte généré de chaque fragment, filtrez les événements contentBlockDelta et extrayez le texte :
text = ""
for event in response["stream"]:
    if "contentBlockDelta" in event:
        chunk = event["contentBlockDelta"]["delta"]["text"]
        print(chunk, end="")
        text += chunk

print("\n\nTotal Message:\n" + text)
Le paramètre end="" supprime le saut de ligne automatique que la fonction print de Python ajoute, ce qui rend le texte en streaming plus naturel à l'affichage.
Applications pratiques
Dans une application réelle, au lieu d'afficher chaque fragment, vous souhaiteriez généralement :
- Envoyer chaque fragment à votre frontend via WebSockets ou Server-Sent Events
- Mettre à jour l'interface utilisateur pour afficher la réponse croissante en temps réel
- Stocker le message complet une fois le streaming terminé
- Gérer toute erreur pouvant survenir pendant le streaming
Cette approche de streaming transforme l'expérience utilisateur de « soumettre et attendre » à « soumettre et regarder la réponse apparaître », rendant vos applications alimentées par l'IA beaucoup plus réactives et engageantes.