La récupération contextuelle est une technique qui améliore la précision des pipelines RAG en résolvant un problème fondamental : lorsque vous divisez un document en segments (chunks), chaque segment perd sa connexion avec le contexte plus large du document.
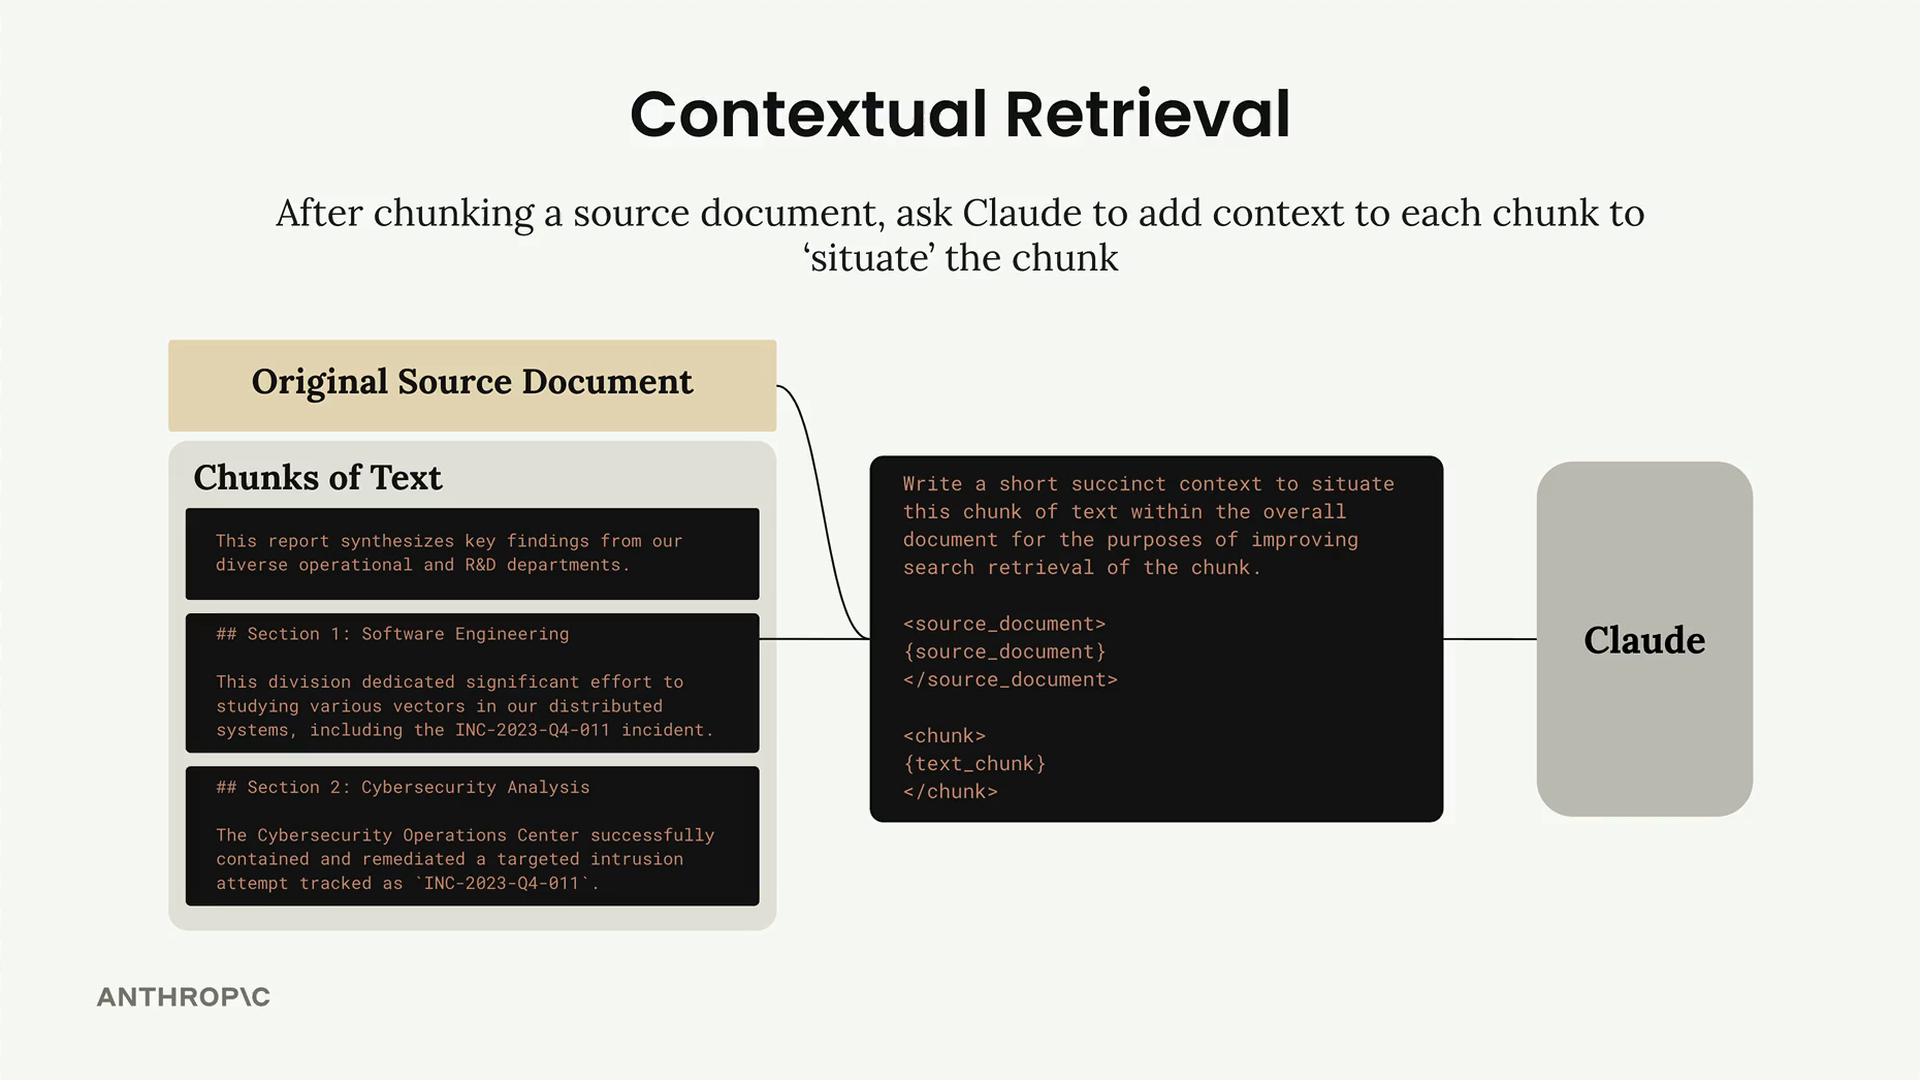
L'idée de base est simple. Après avoir segmenté votre document source, vous demandez à Claude d'ajouter du contexte à chaque segment avant de le stocker dans votre base de données de récupération. Cette étape de prétraitement permet de « situer » chaque segment au sein du document plus large.
Comment ça fonctionne
Pour chaque segment de texte, vous envoyez à la fois le segment et le document source original à Claude avec une requête de ce type :
Write a short and succinct snippet of text to situate this chunk within the
overall source document for the purposes of improving search retrieval of the chunk.

Here is the original source document:
<document>
{source_text}
</document>

Here is the chunk we want to situate within the whole document:
<chunk>
{text_chunk}
</chunk>

Answer only with the succinct context and nothing else.Claude pourrait générer un contexte tel que : « Cette section provient d'un rapport plus large sur un groupe pluridisciplinaire. Elle mentionne l'incident INC-2023-04-011, qui est également mentionné dans la section Analyse de cybersécurité. »
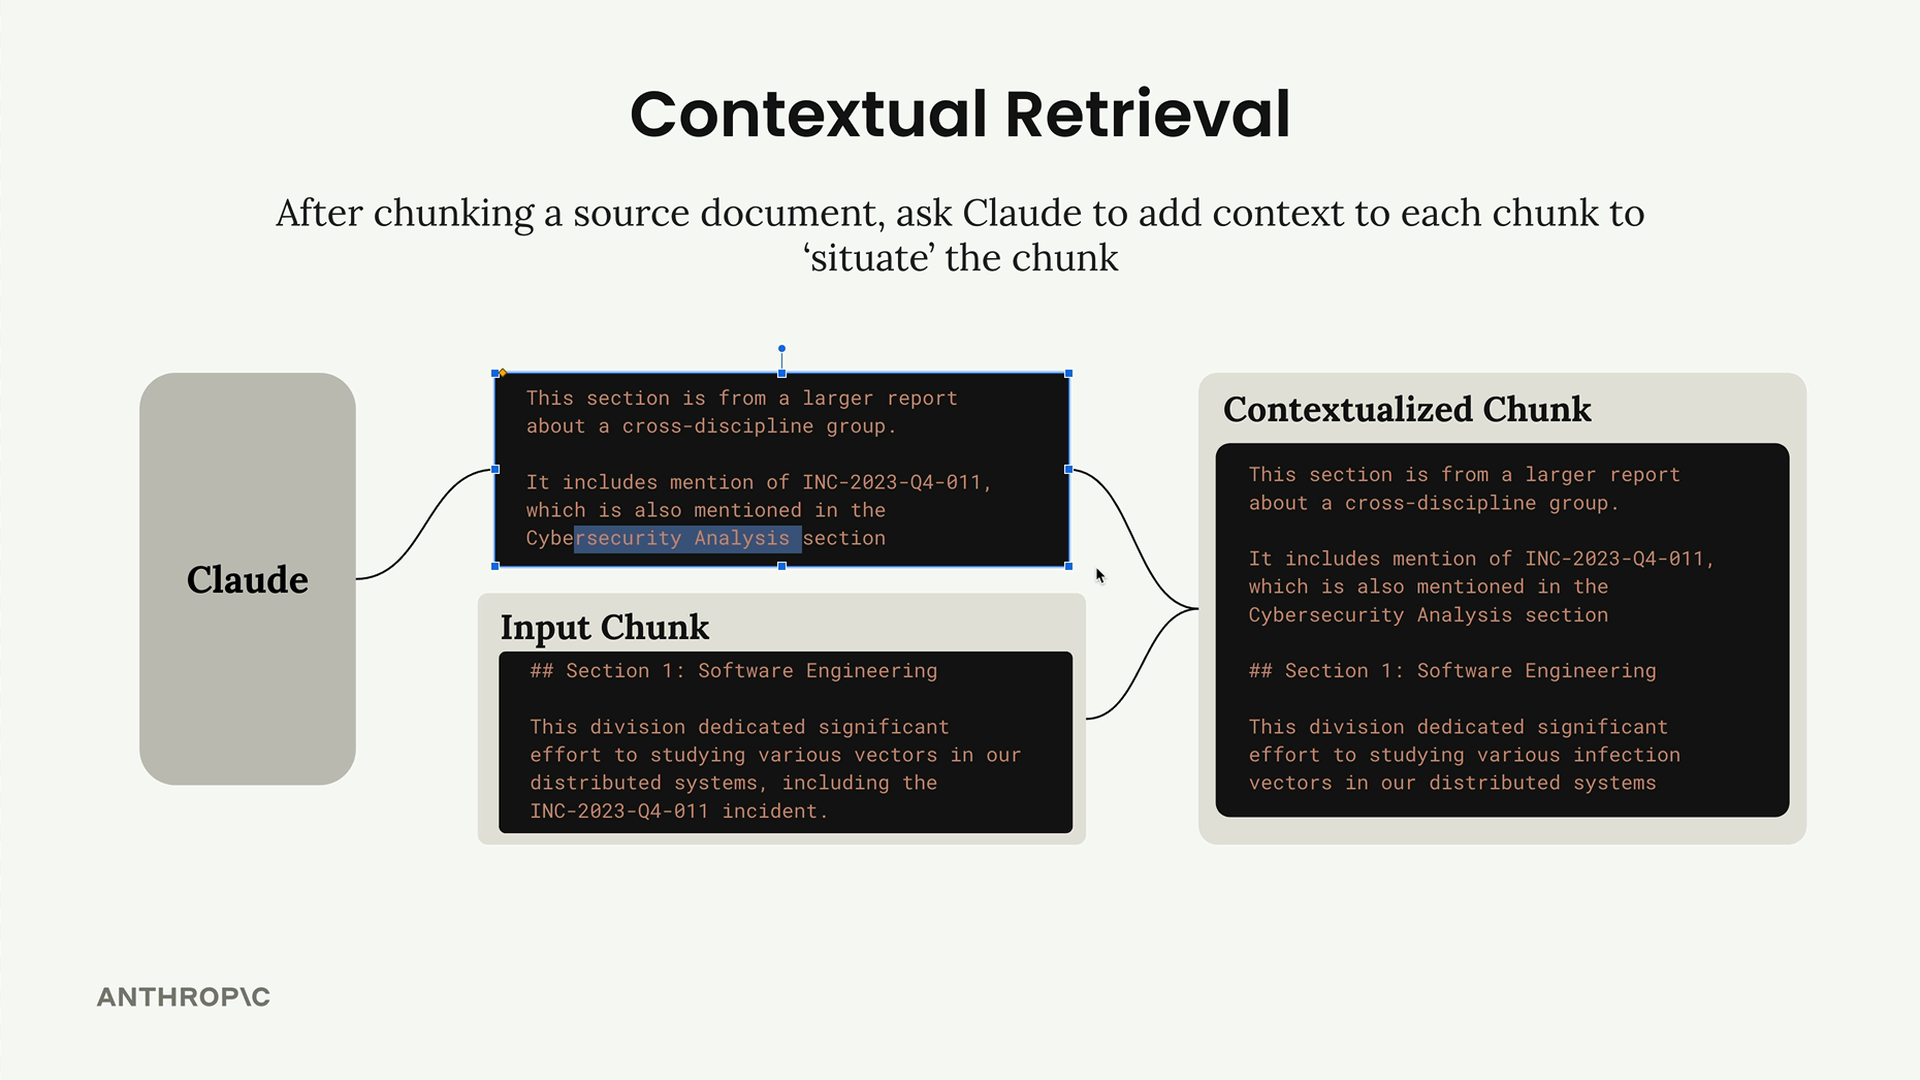
Vous combinez ensuite ce contexte généré avec le texte du segment original pour créer un « segment contextualisé » qui sera stocké dans vos index vectoriels et BM25.
Gérer les documents volumineux
Si votre document source est trop volumineux pour tenir dans une seule requête, vous pouvez fournir un ensemble réduit de contexte plutôt que le document entier.
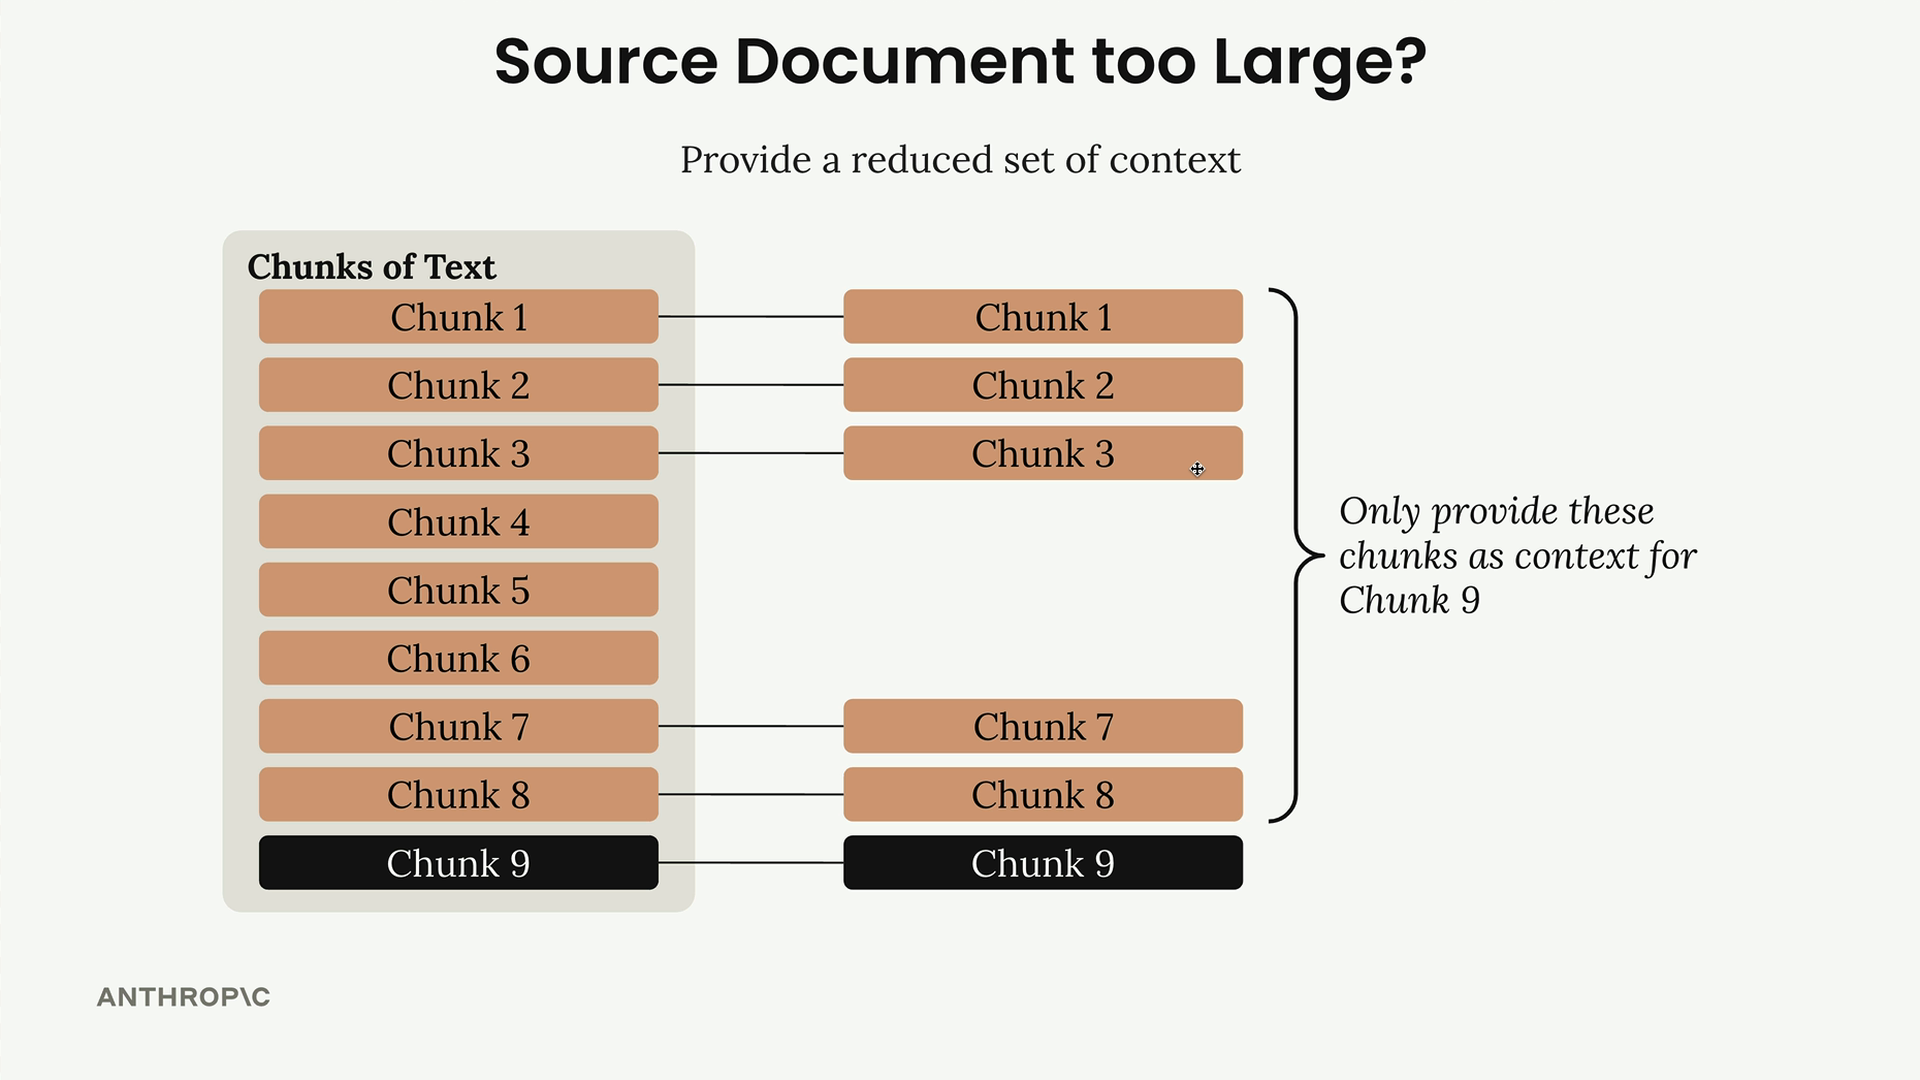
Pour tout segment que vous contextualisez, incluez :
- Quelques segments du début du document (contenant souvent des résumés ou des abrégés)
- Les segments précédant immédiatement le segment cible (fournissant un contexte local)
Cette approche donne à Claude suffisamment d'informations pour générer un contexte pertinent sans surcharger la requête avec l'intégralité du document.
Exemple d'implémentation
Voici une implémentation de base de la fonction de récupération contextuelle :
def add_context(text_chunk, source_text):
    prompt = f"""
    Write a short and succinct snippet of text to situate this chunk within the
    overall source document for the purposes of improving search retrieval of the chunk.

    Here is the original source document:
    <document>
    {source_text}
    </document>

    Here is the chunk we want to situate within the whole document:
    <chunk>
    {text_chunk}
    </chunk>

    Answer only with the succinct context and nothing else.
    """

    messages = []
    add_user_message(messages, prompt)
    result = chat(messages)

    return result["text"] + "\n" + text_chunk
Lors du traitement des segments de votre document, vous parcourriez chacun d'eux en boucle pour générer des versions contextualisées :
# Ajouter du contexte à chaque extrait de code, puis l'ajouter au récupérateur
for i, chunk in enumerate(chunks):
    # Construire le contexte à partir des extraits de code de début et des extraits précédents
    context_parts = []
    context_parts.extend(chunks[:min(num_start_chunks, len(chunks))])

    start_idx = max(0, i - num_prev_chunks)
    context_parts.extend(chunks[start_idx:i])

    context = "\n".join(context_parts)

    contextualized_chunk = add_context(chunk, context)
    retriever.add_document({"content": contextualized_chunk})
Résultats attendus
Le contexte généré fournit des informations précieuses sur la structure du document et les relations entre ses parties. Par exemple, Claude pourrait décrire un segment comme « la Section 2 d'une Revue annuelle de recherche interdisciplinaire, détaillant les efforts d'ingénierie logicielle visant à résoudre des problèmes de stabilité dans le Projet Phoenix. Elle suit la section Méthodologie et précède l'Analyse financière, et fait partie d'un rapport complet couvrant dix domaines de recherche au sein de l'organisation. »
Ce contexte supplémentaire aide le système de récupération à mieux comprendre non seulement ce que contient chaque segment, mais aussi comment il s'intègre dans la structure plus large du document et se rapporte aux autres sections. Bien que vous ne constatiez pas forcément d'amélioration spectaculaire avec des documents simples, la récupération contextuelle devient de plus en plus précieuse à mesure que vos documents se complexifient, avec des références croisées et des dépendances complexes entre les sections.