L'ingénierie de requêtes consiste à prendre une requête que vous avez rédigée et à l'améliorer pour obtenir des résultats plus fiables et de meilleure qualité. Ce processus implique de rédiger une requête initiale, d'évaluer sa performance, puis d'appliquer systématiquement des techniques d'ingénierie pour l'améliorer étape par étape.
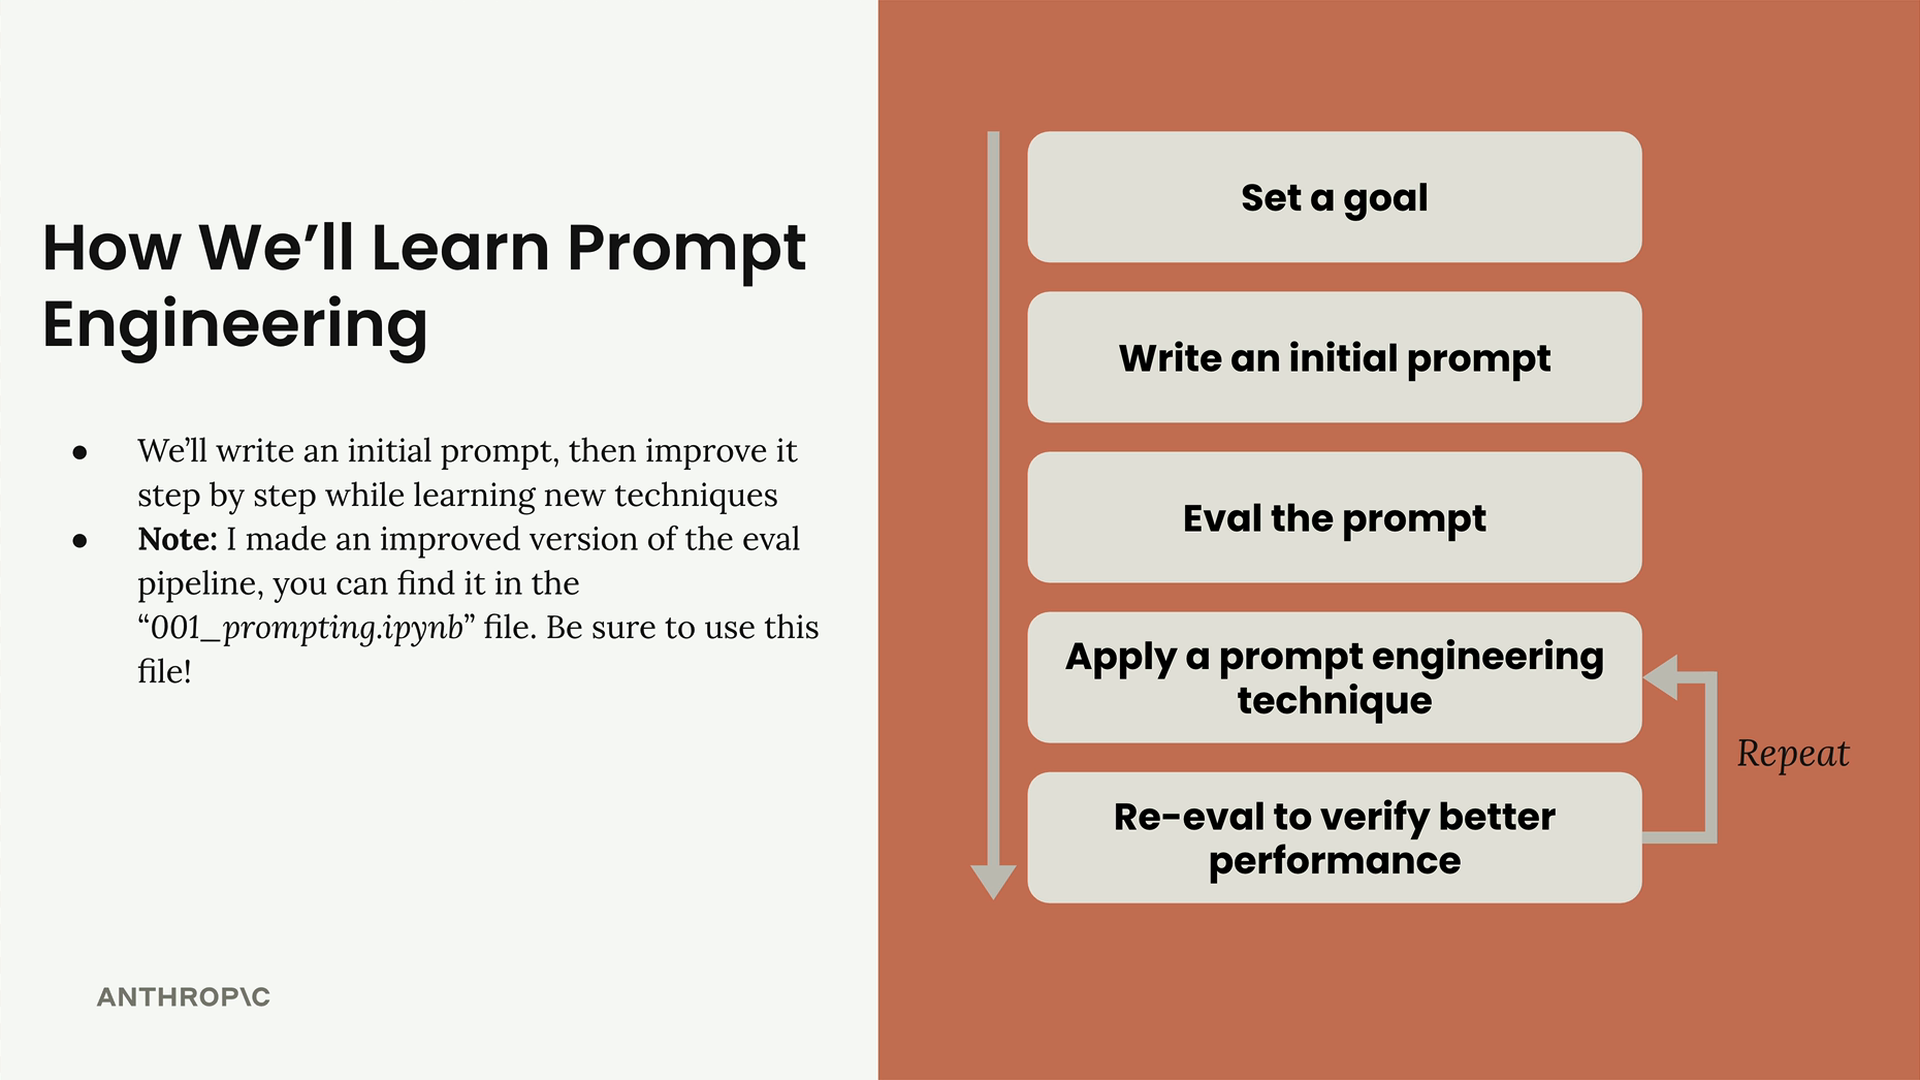
Le processus d'amélioration itérative
L'approche suit un cycle clair : définir un objectif, rédiger une requête initiale, l'évaluer, appliquer une technique d'ingénierie de requêtes, puis réévaluer pour vérifier l'amélioration des performances. Ce cycle se répète au fur et à mesure que vous affinez votre requête.
Pour cette série de tutoriels, nous allons travailler sur un exemple pratique : créer une requête qui génère des plans de repas d'une journée pour des athlètes en fonction de leur taille, de leur poids, de leurs objectifs physiques et de leurs restrictions alimentaires.
Mise en place du pipeline d'évaluation
L'évaluation utilise une version améliorée du pipeline des modules précédents, encapsulée dans une classe PromptEvaluator qui gère la génération du jeu de données et la notation par le modèle. Cette classe prend en charge la concurrence pour accélérer le processus d'évaluation :
evaluator = PromptEvaluator(max_concurrent_tasks=5)Commencez avec une valeur de concurrence faible (comme 3) pour éviter les erreurs de limite de débit. Vous pouvez ajuster cette valeur en fonction de votre quota API.
Génération des données de test
La méthode generate_dataset crée des cas de test pour votre requête. Vous devez spécifier :
- Une description de la tâche expliquant ce que votre requête doit faire
- Une spécification des entrées requises par votre requête
- Le nombre de cas de test à générer
Pour l'exemple du plan de repas :
dataset = evaluator.generate_dataset(
    task_description="Write a compact, concise 1 day meal plan for a single athlete",
    prompt_inputs_spec={
        "height": "Athlete's height in cm",
        "weight": "Athlete's weight in kg",
        "goal": "Goal of the athlete",
        "restrictions": "Dietary restrictions of the athlete"
    },
    num_cases=3
)
Rédiger votre requête initiale
Commencez avec une requête simple et basique pour établir une référence. La fonction run_prompt reçoit les entrées du cas de test et doit renvoyer la réponse du modèle :
def run_prompt(prompt_inputs):
    prompt = f"""
    What should this person eat?

    - Height: {prompt_inputs["height"]}
    - Weight: {prompt_inputs["weight"]}
    - Goal: {prompt_inputs["goal"]}
    - Dietary restrictions: {prompt_inputs["restrictions"]}
    """

    messages = []
    add_user_message(messages, prompt)
    return chat(messages)
Exécuter l'évaluation
Le processus d'évaluation compare la sortie de votre requête aux critères attendus. Vous pouvez ajouter des critères supplémentaires pour guider la notation :
results = evaluator.run_evaluation(
    run_prompt_function=run_prompt,
    dataset_file="dataset.json",
    extra_criteria="""
    The output should include:
    - Daily caloric total
    - Macronutrient breakdown
    - Meals with exact foods, portions, and timing
    """
)
Analyser les résultats
L'évaluation génère un fichier output.html que vous pouvez ouvrir dans votre navigateur. Ce rapport affiche des résultats détaillés pour chaque cas de test, y compris les scores, le raisonnement et la sortie réelle générée par votre requête.
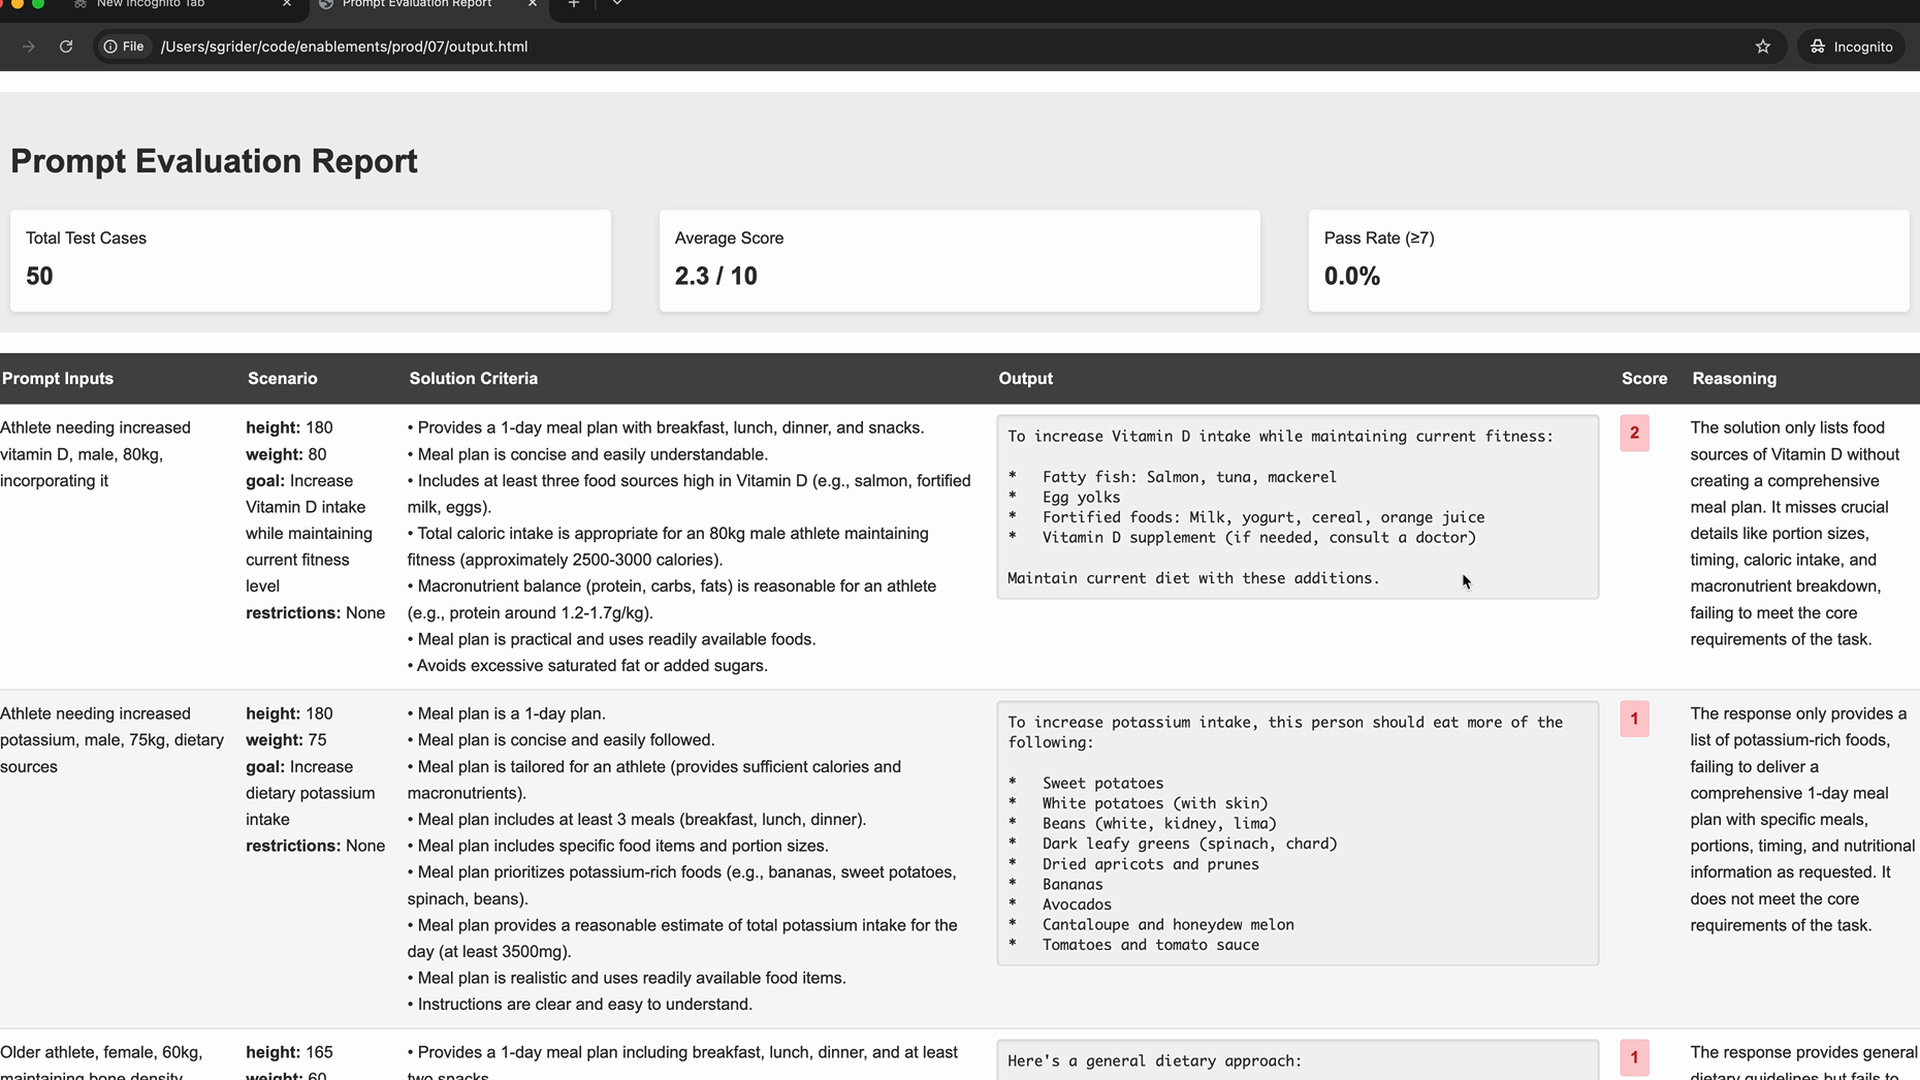
Ne vous laissez pas décourager par des scores initiaux bas - c'est normal ! La requête initiale de cet exemple n'a obtenu que 2,3 sur 10, mais cela vous donne une référence claire à partir de laquelle progresser.
Et maintenant ?
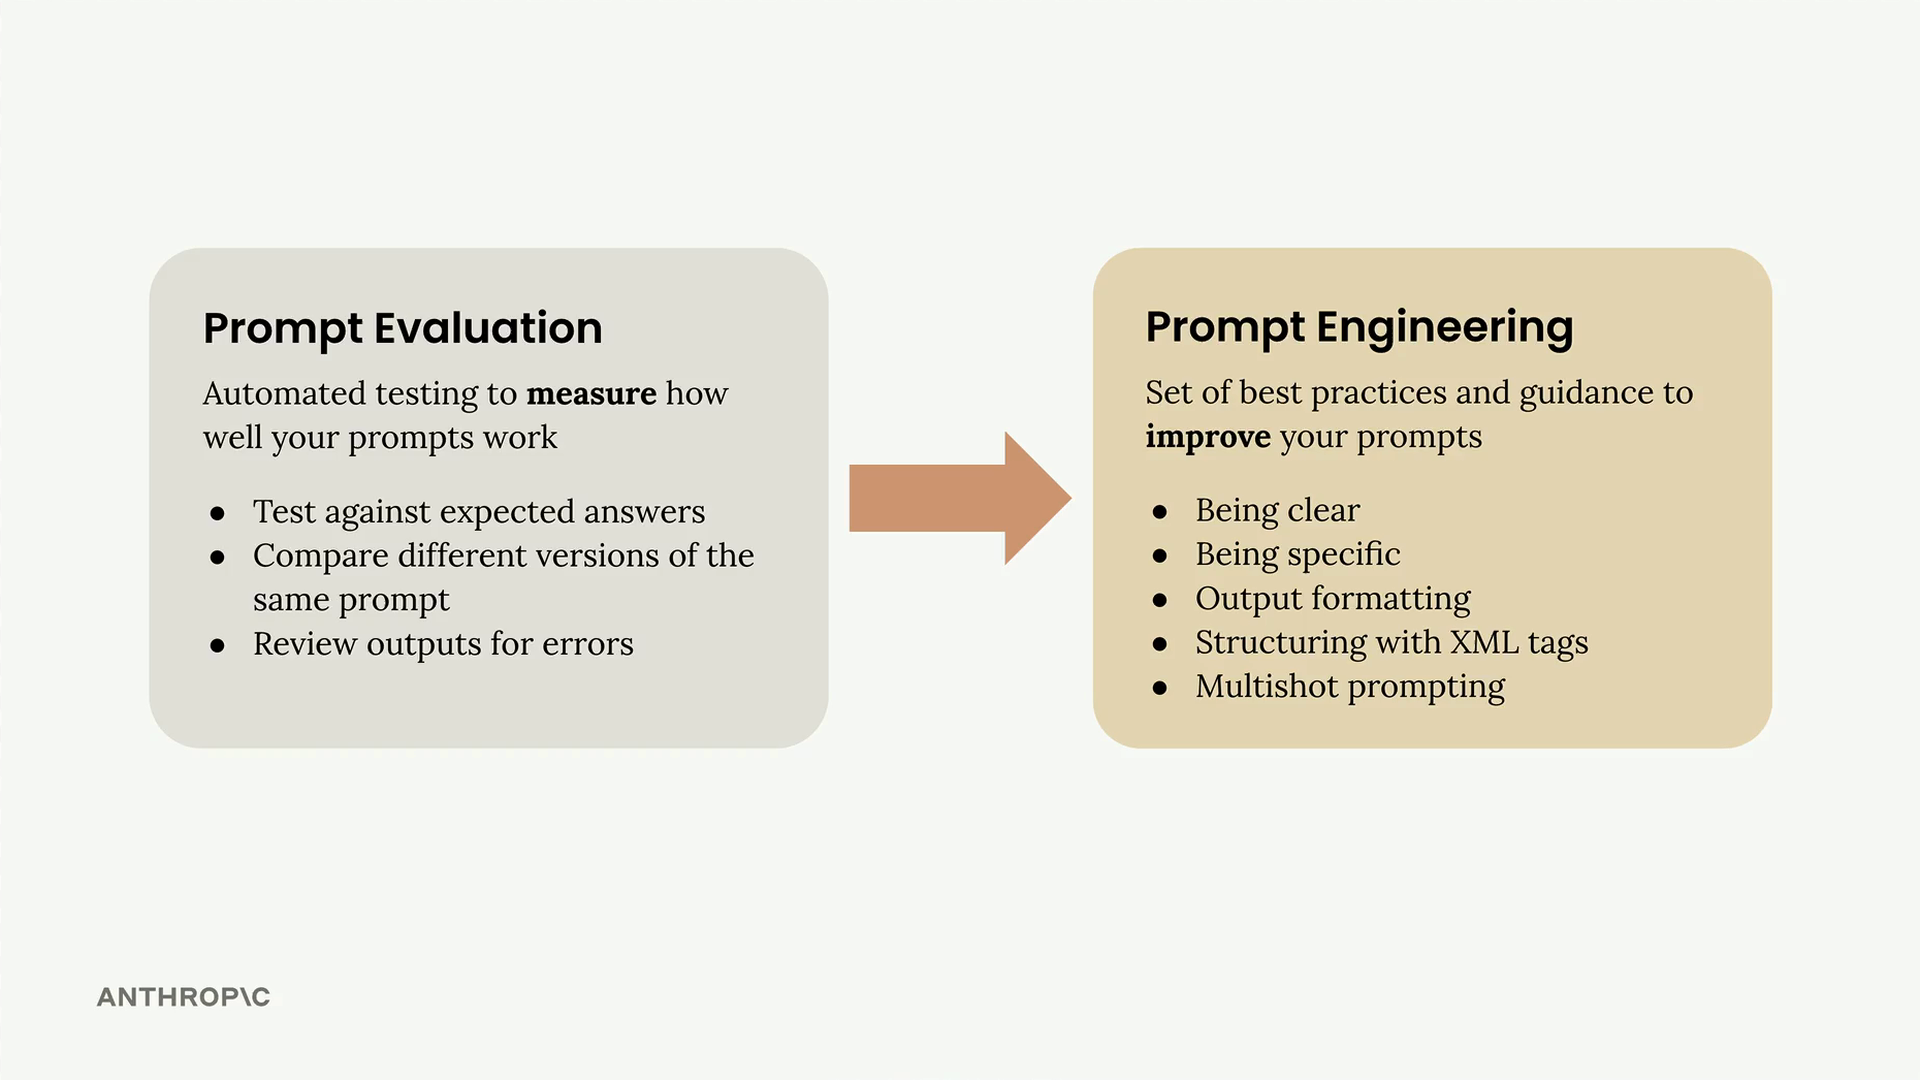
Avec votre référence établie, vous pouvez maintenant appliquer systématiquement des techniques d'ingénierie de requêtes telles qu'être plus précis, ajouter des exigences de formatage de sortie, utiliser des requêtes structurées et mettre en œuvre des exemples multi-shot. Chaque technique devrait améliorer votre score d'évaluation, vous donnant une progression mesurable vers votre objectif.