Nachdem wir die Grundlagen von RAG, Text-Chunking und Embeddings behandelt haben, gehen wir nun Schritt für Schritt die komplette RAG-Pipeline durch. Dieses detaillierte Beispiel zeigt dir genau, wie alle Teile in einer echten Implementierung zusammenwirken.
Schritt 1: Teile deinen Quelltext in Chunks
Zuerst nehmen wir unser Quelldokument und teilen es in handhabbare Chunks auf. Für dieses Beispiel verwenden wir zwei einfache Textabschnitte:
- Abschnitt 1: Medizinische Forschung - „Dieses Jahr gab es bedeutende Fortschritte in unserem Verständnis von XDR-47, einem ‚Bug', den wir noch nie zuvor gesehen haben."
- Abschnitt 2: Software-Engineering - „Diese Abteilung hat erhebliche Anstrengungen unternommen, um verschiedene Infektionsvektoren in unseren verteilten Systemen zu untersuchen"
Schritt 2: Embeddings generieren
Als Nächstes wandeln wir jeden Text-Chunk in numerische Embeddings um. Um das leichter verständlich zu machen, stellen wir uns vor, wir hätten ein perfektes Embedding-Modell, das immer genau zwei Zahlen zurückgibt, und wir wissen, wofür jede Zahl steht:
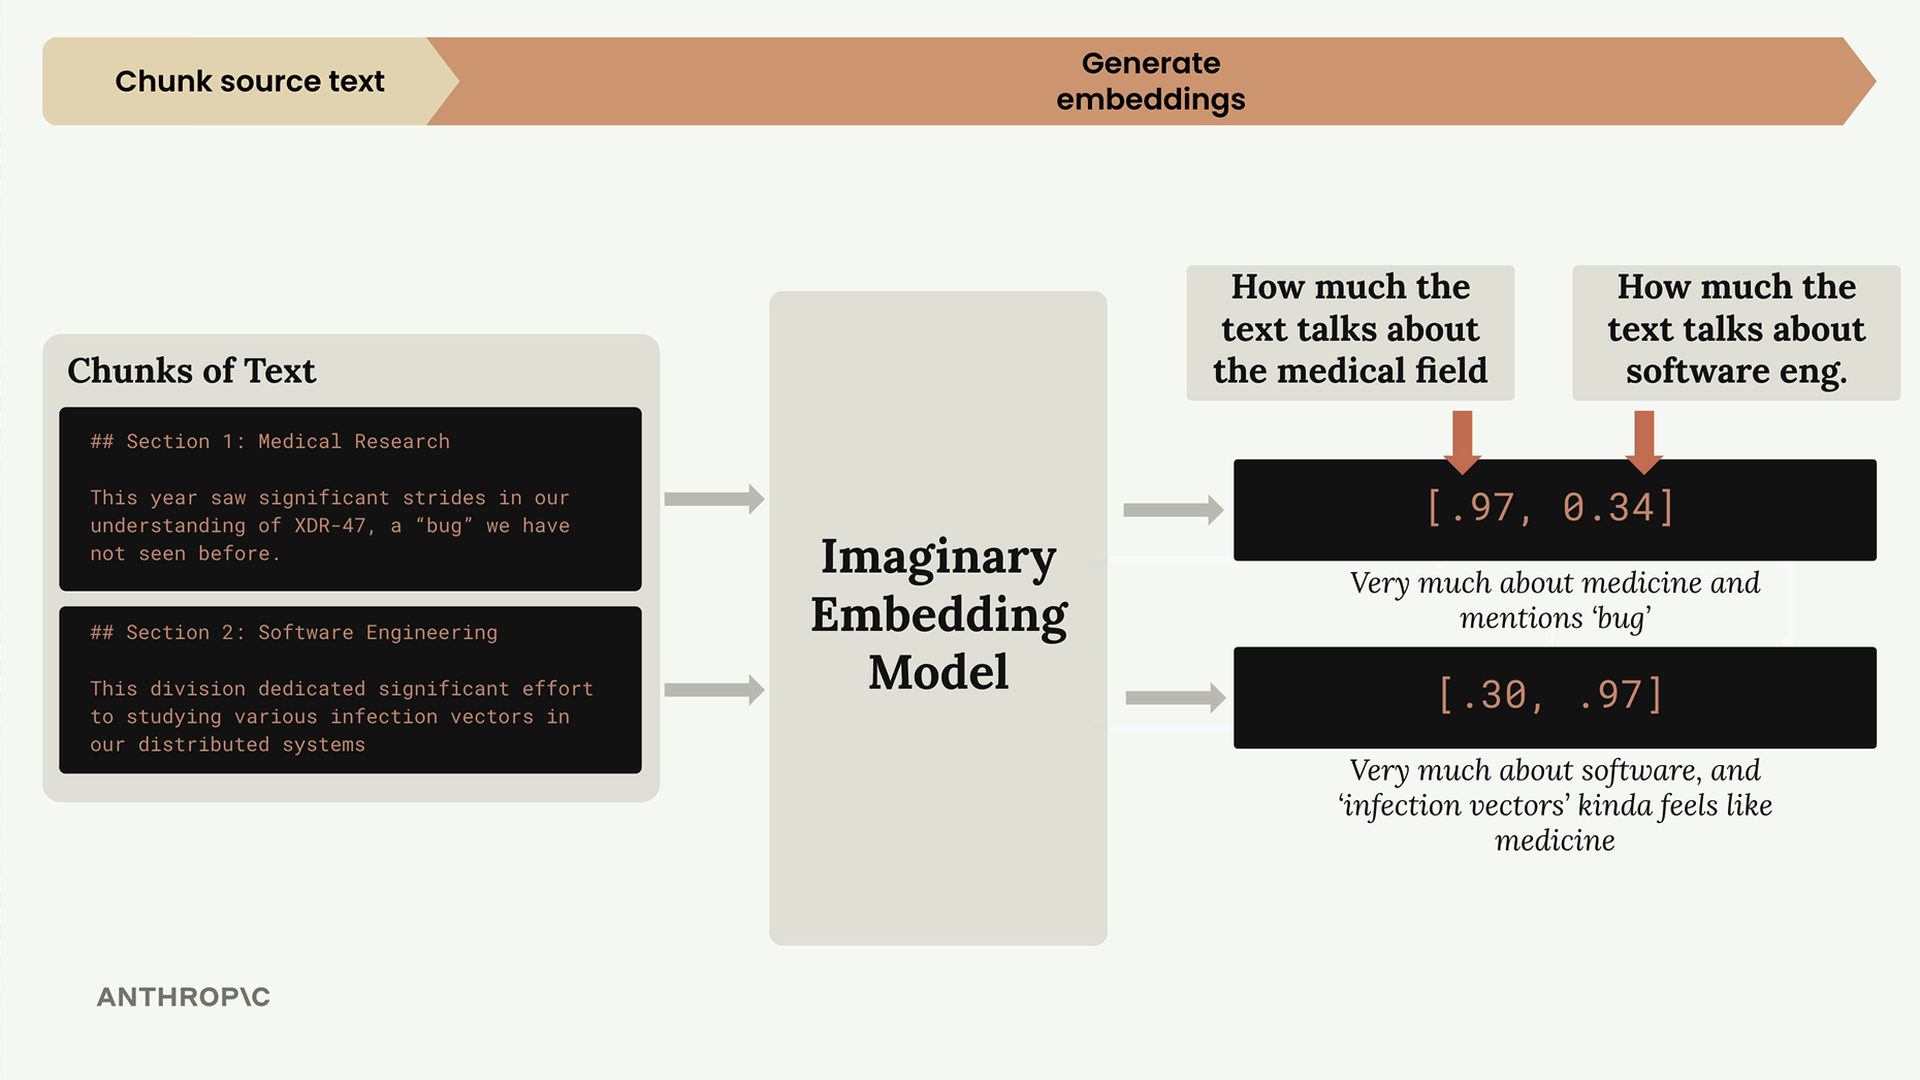
In unserem imaginären Modell:
- Erste Zahl: Wie viel der Text über Medizin spricht
- Zweite Zahl: Wie viel der Text über Software-Engineering spricht
Unser Abschnitt zur medizinischen Forschung erhält also [0.97, 0.34] - sehr medizinisch, wegen des Wortes „Bug" etwas softwarebezogen. Der Software-Engineering-Abschnitt erhält [0.30, 0.97] - stark softwarefokussiert, aber „Infektionsvektoren" hat medizinische Konnotationen.
Normalisierung
Bevor diese Embeddings gespeichert werden, durchlaufen sie einen Normalisierungsprozess, der jeden Vektor so skaliert, dass er eine Magnitude von 1.0 hat. Dies wird in der Regel automatisch von deiner Embedding-API übernommen, aber es ist wichtig zu verstehen, dass dies geschieht.
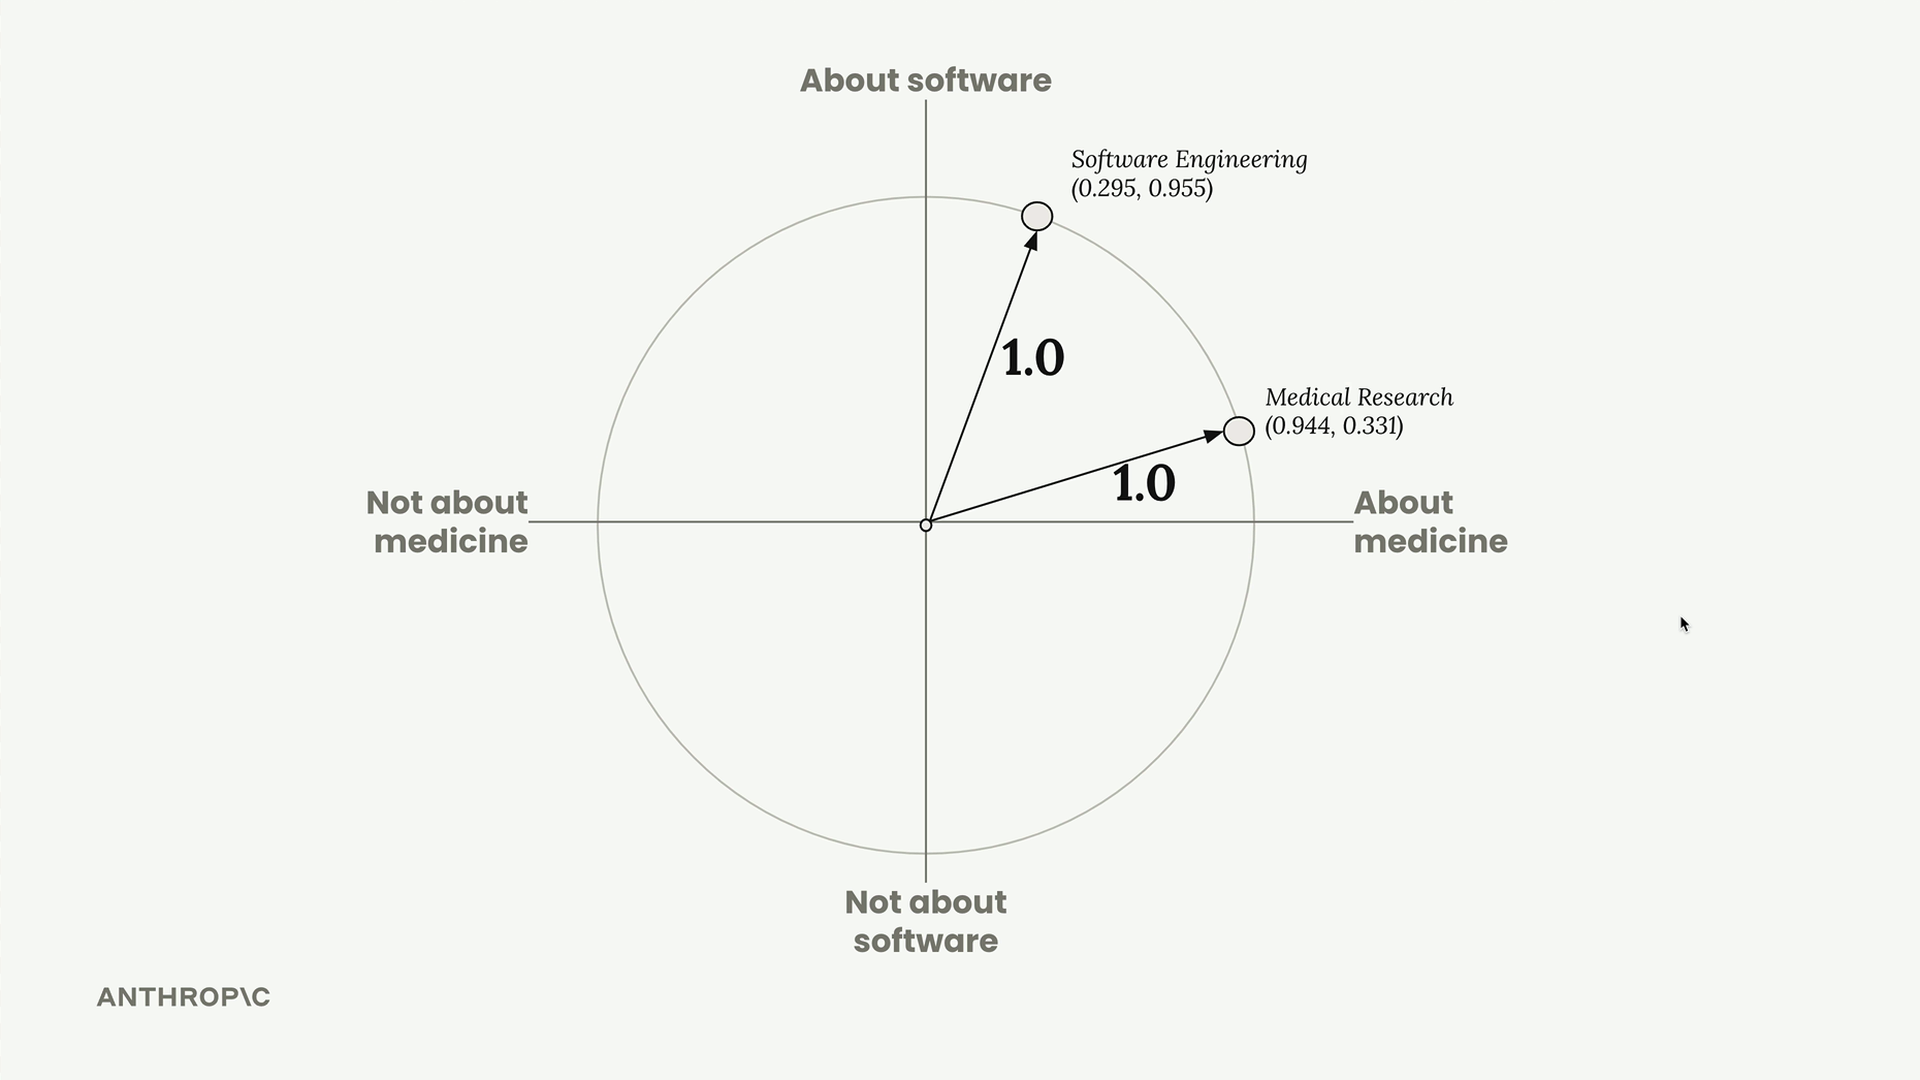
Nach der Normalisierung werden unsere Embeddings zu [0.944, 0.331] und [0.295, 0.955]. Wir können diese auf einem Einheitskreis visualisieren, auf dem beide Punkte genau auf dem Rand des Kreises liegen.
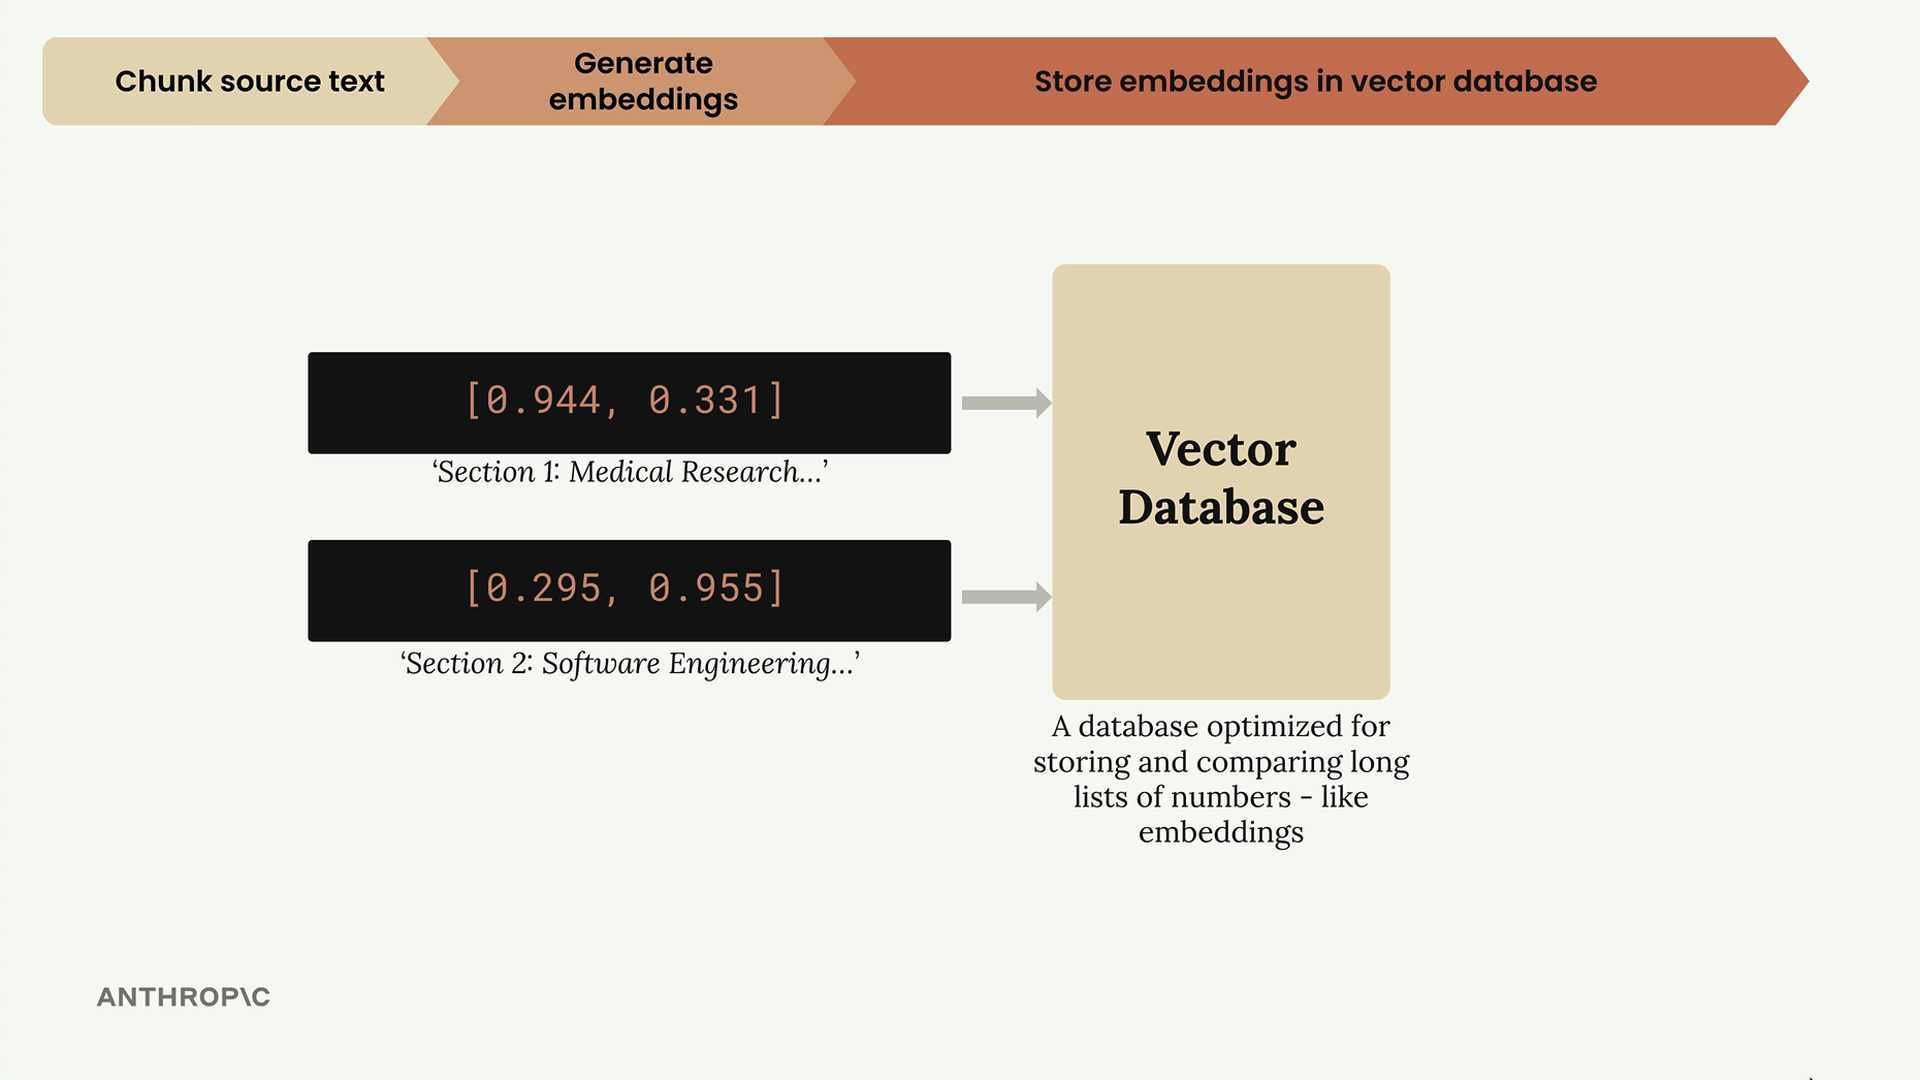
Schritt 3: In der Vektordatenbank speichern
Die normalisierten Embeddings werden in einer Vektordatenbank gespeichert - einer spezialisierten Datenbank, die für das Speichern, Vergleichen und Durchsuchen langer Zahlenlisten wie unserer Embeddings optimiert ist.
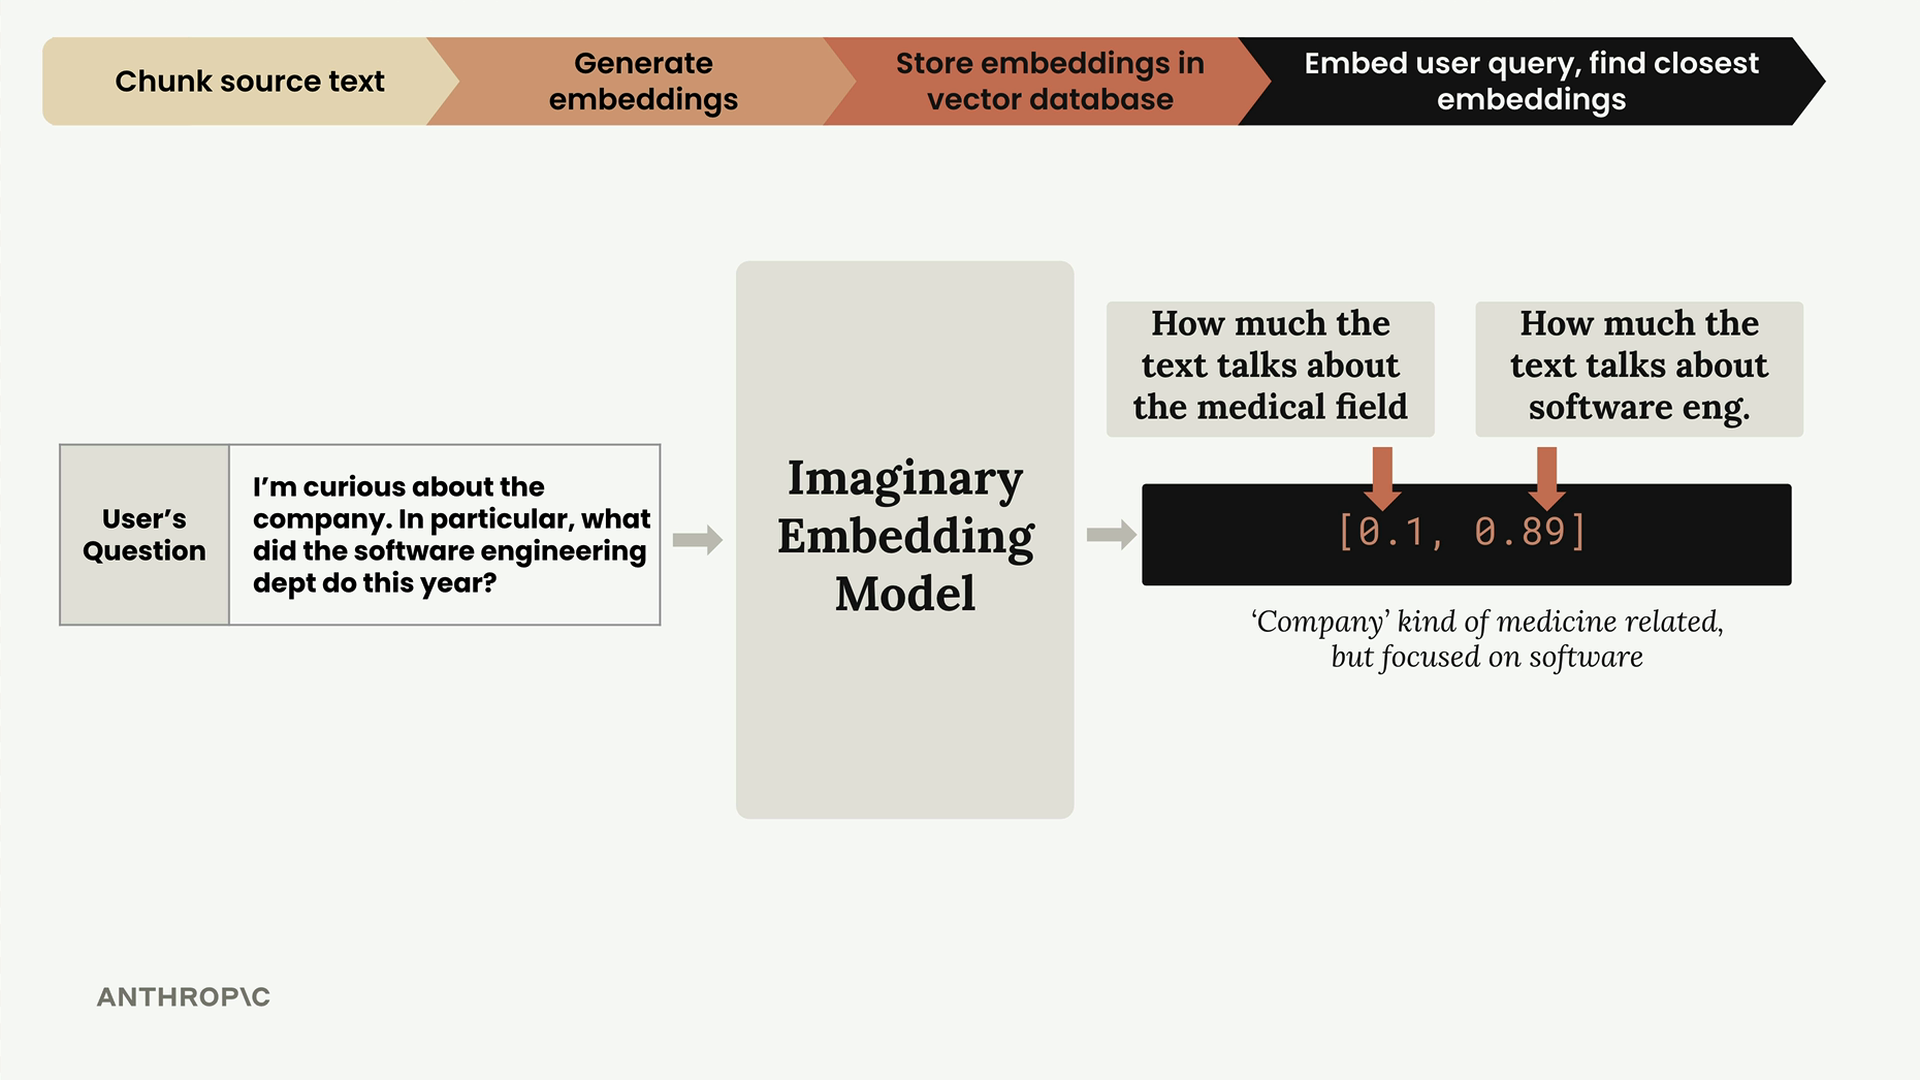
An diesem Punkt machen wir eine Pause. Die gesamte bisherige Arbeit war Vorverarbeitung, die im Voraus geschieht. Jetzt warten wir darauf, dass ein Nutzer eine Anfrage stellt.
Schritt 4: Nutzeranfrage verarbeiten
Wenn ein Nutzer eine Frage stellt wie „Ich bin neugierig auf das Unternehmen. Was hat die Software-Engineering-Abteilung dieses Jahr insbesondere gemacht?", führen wir seine Anfrage durch dasselbe Embedding-Modell.
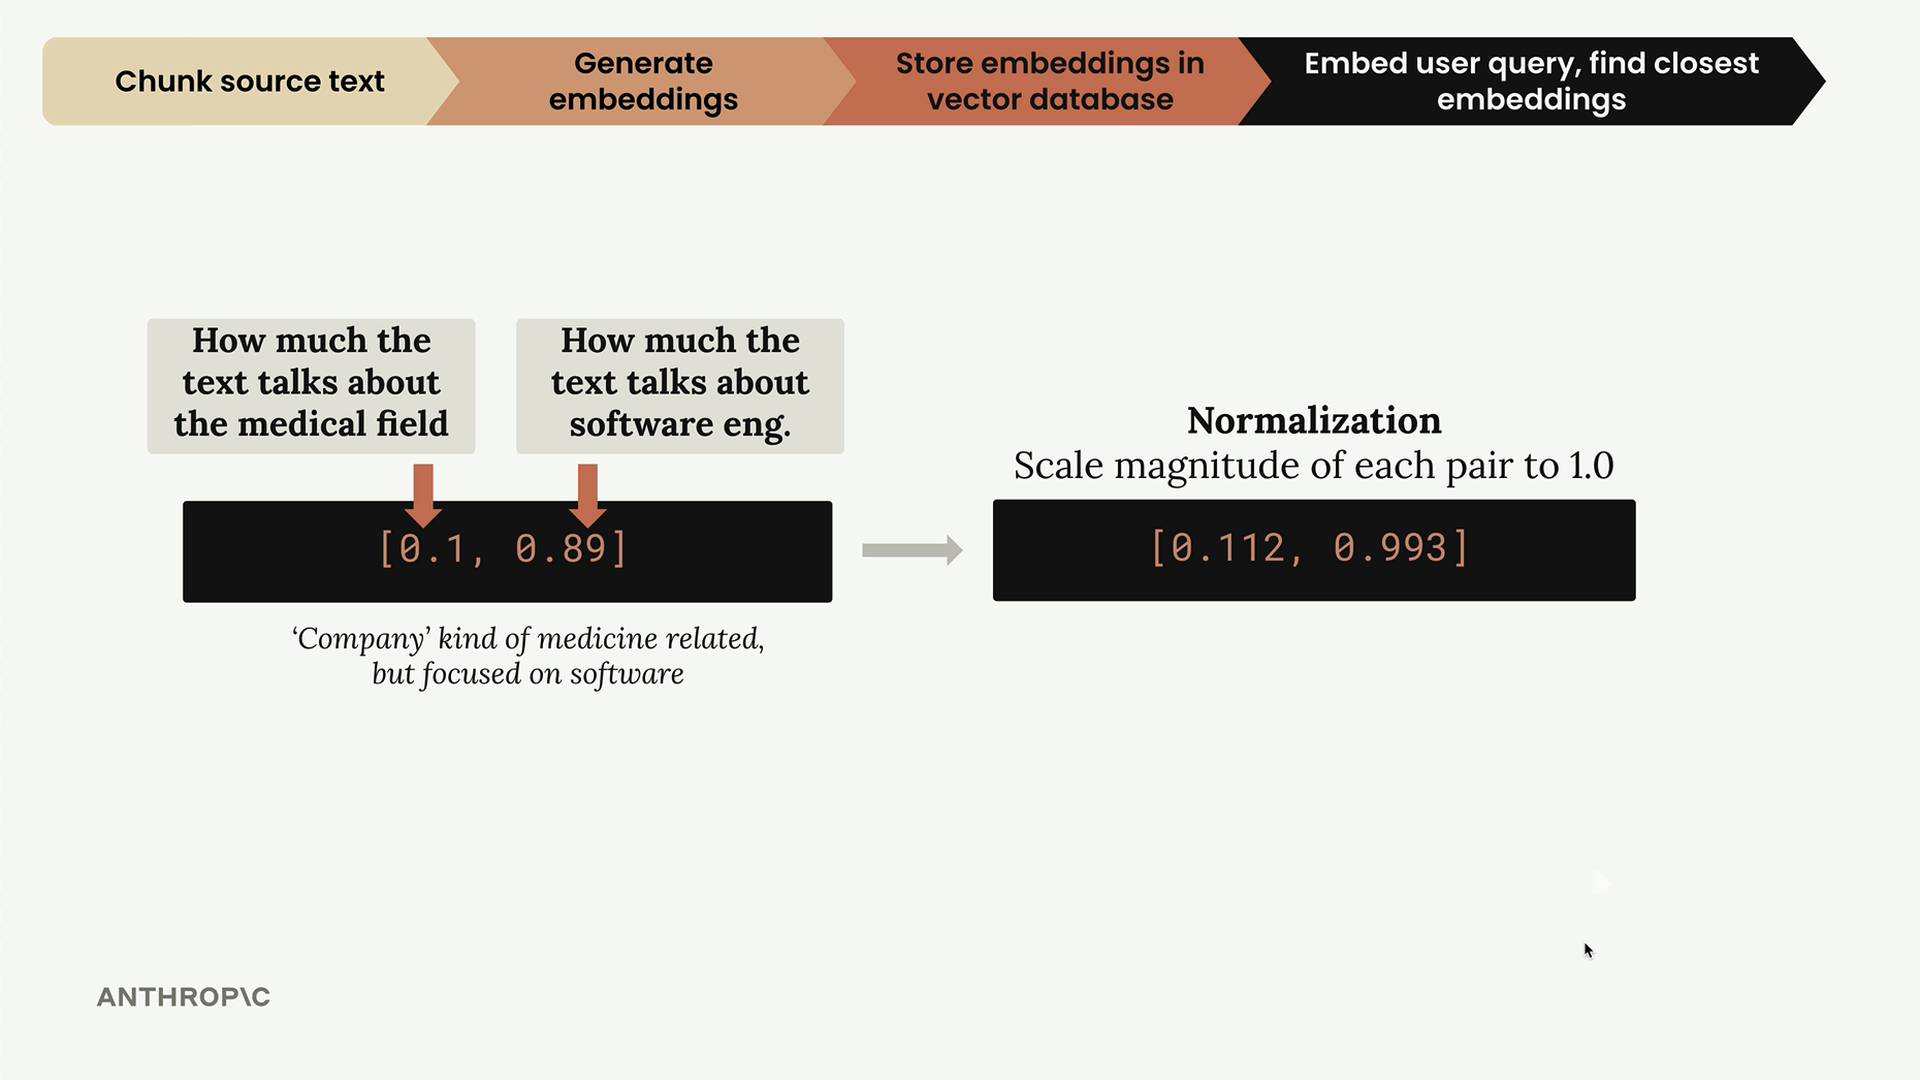
Diese Anfrage wird als [0.1, 0.89] eingebettet - niedriger medizinischer Wert, hoher Software-Engineering-Wert. Nach der Normalisierung wird sie zu [0.112, 0.993].
Schritt 5: Ähnliche Embeddings finden
Jetzt fragen wir die Vektordatenbank: „Finde das gespeicherte Embedding, das diesem Nutzeranfrage-Embedding am nächsten ist." Die Datenbank gibt den Software-Engineering-Abschnitt zurück, weil er am ähnlichsten ist.
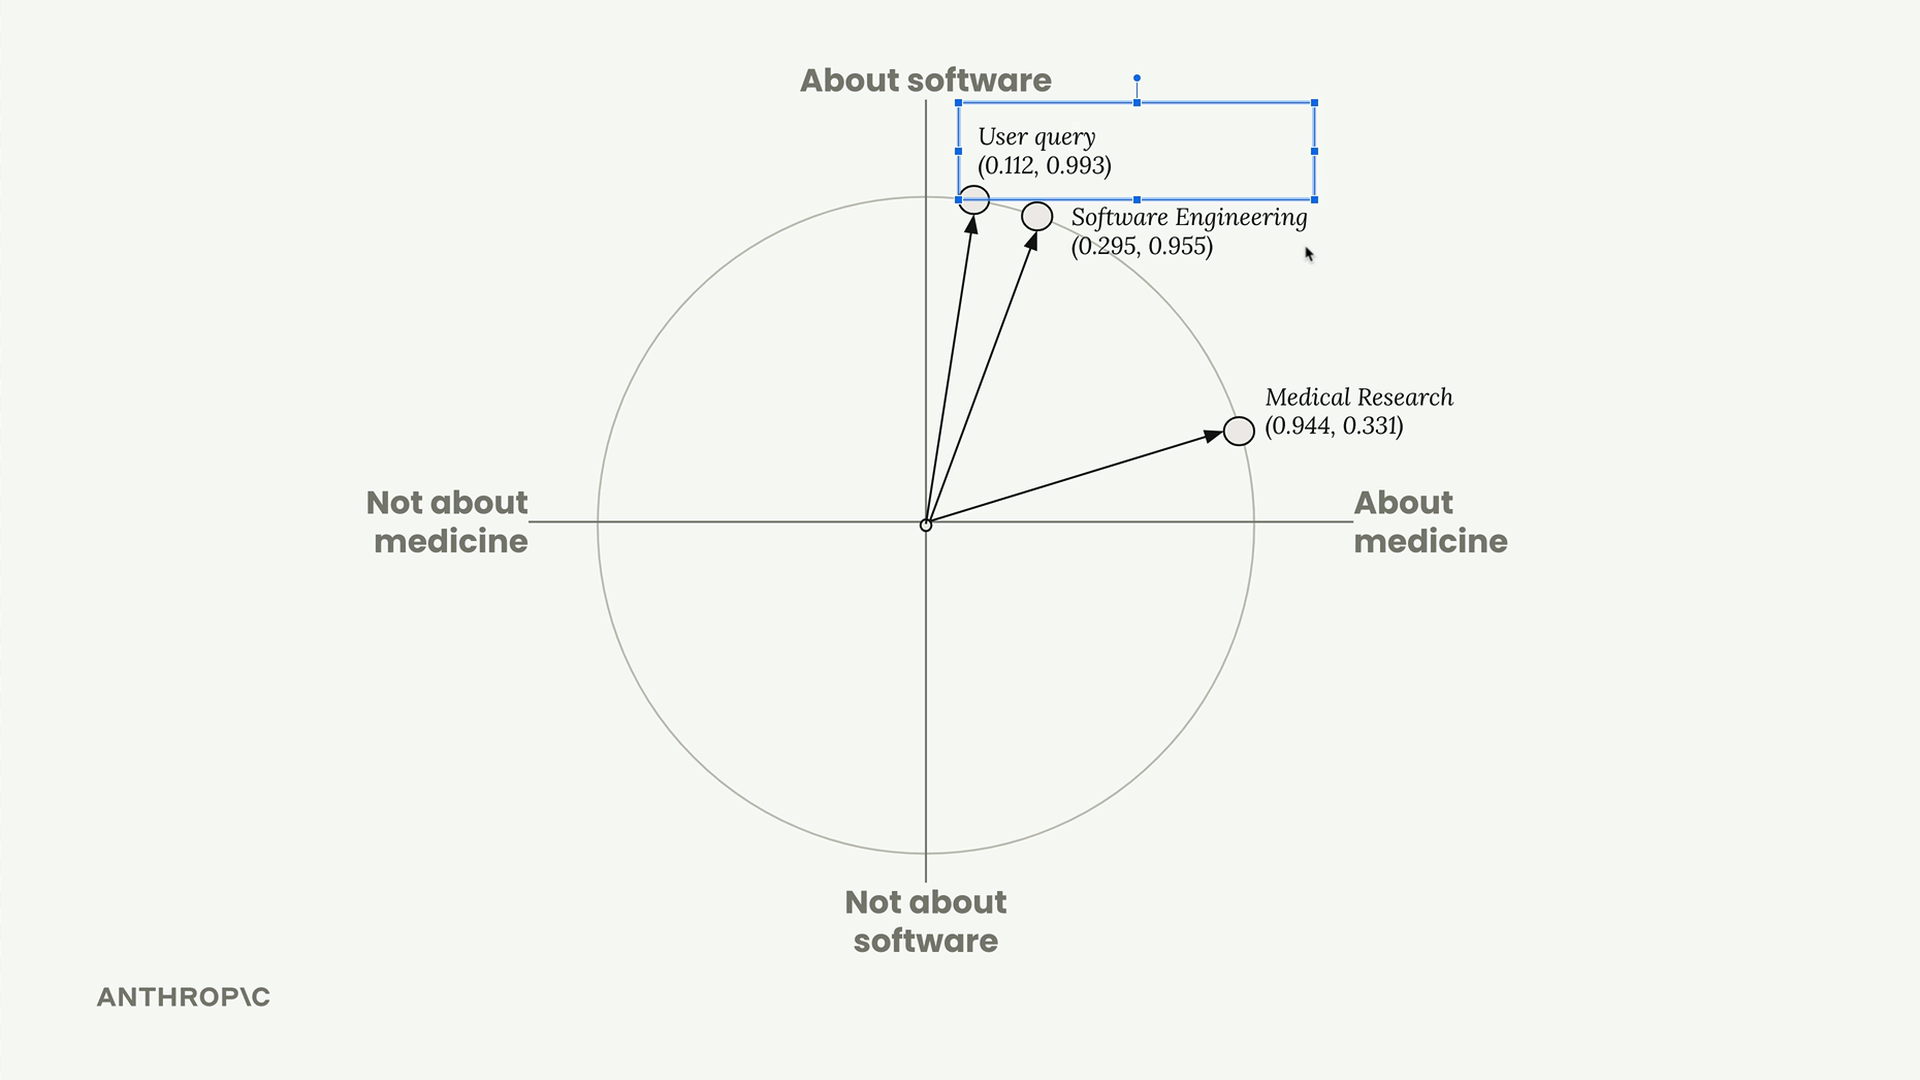
Aber wie bestimmt die Datenbank „am nächsten"? Sie verwendet Kosinus-Ähnlichkeit.
Kosinus-Ähnlichkeit
Die Vektordatenbank berechnet den Kosinus des Winkels zwischen Vektoren, um die Ähnlichkeit zu messen. Das ergibt eine Zahl zwischen -1 und 1:
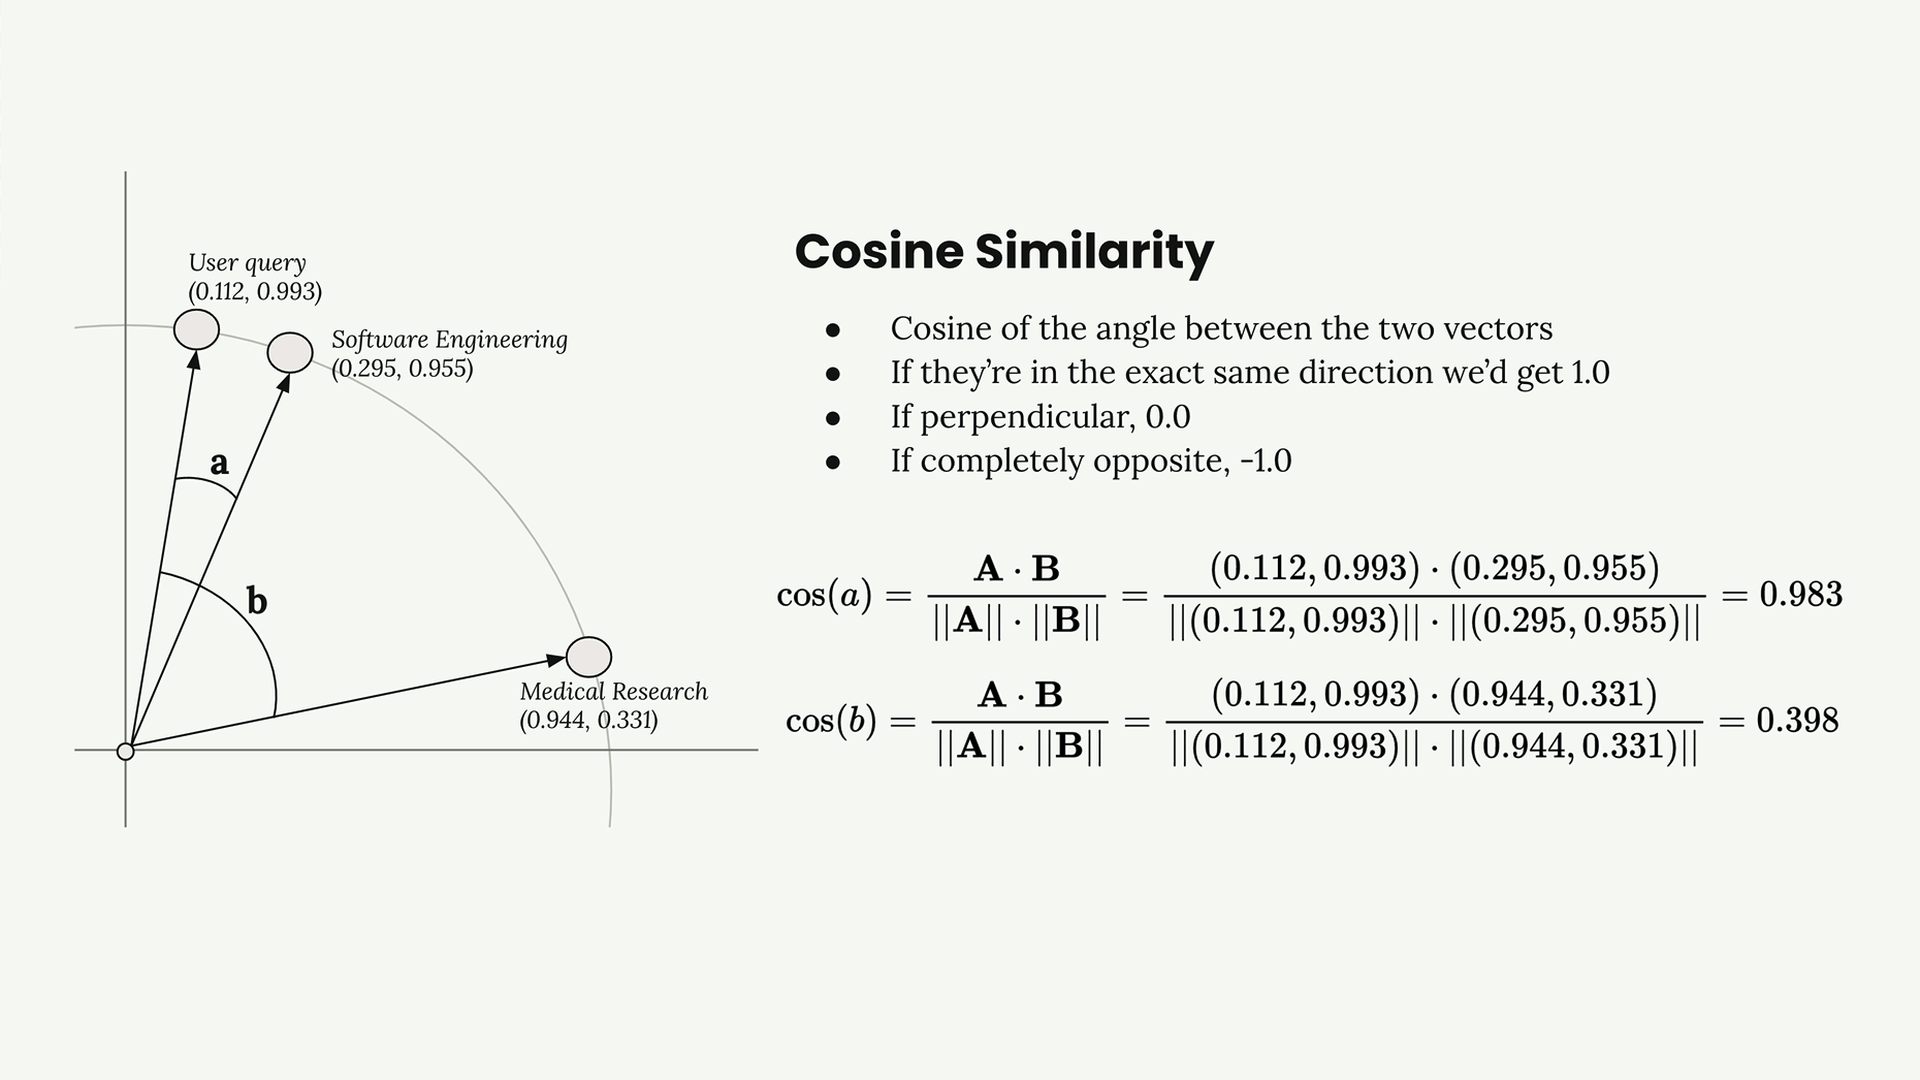
- 1.0 = Vektoren zeigen in genau die gleiche Richtung (sehr ähnlich)
- 0.0 = Vektoren stehen senkrecht zueinander (nicht verwandt)
- -1.0 = Vektoren zeigen in entgegengesetzte Richtungen (sehr unterschiedlich)
In unserem Beispiel:
- Nutzeranfrage vs. Software-Engineering: Kosinus-Ähnlichkeit = 0.983 (sehr ähnlich!)
- Nutzeranfrage vs. Medizinische Forschung: Kosinus-Ähnlichkeit = 0.398 (weniger ähnlich)
Kosinus-Distanz
In der Dokumentation von Vektordatenbanken wirst du oft auf „Kosinus-Distanz" stoßen. Das ist einfach 1 - cosine similarity, was die Skala umkehrt, sodass kleinere Zahlen ähnlicher bedeuten:
- 0.0 = sehr ähnlich
- 1.0 = senkrecht
- 2.0 = vollständig entgegengesetzt
Schritt 6: Den finalen Prompt erstellen
Abschließend nehmen wir die Frage des Nutzers und den relevantesten Text-Chunk (den Software-Engineering-Abschnitt) und kombinieren sie zu einem Prompt für Claude:
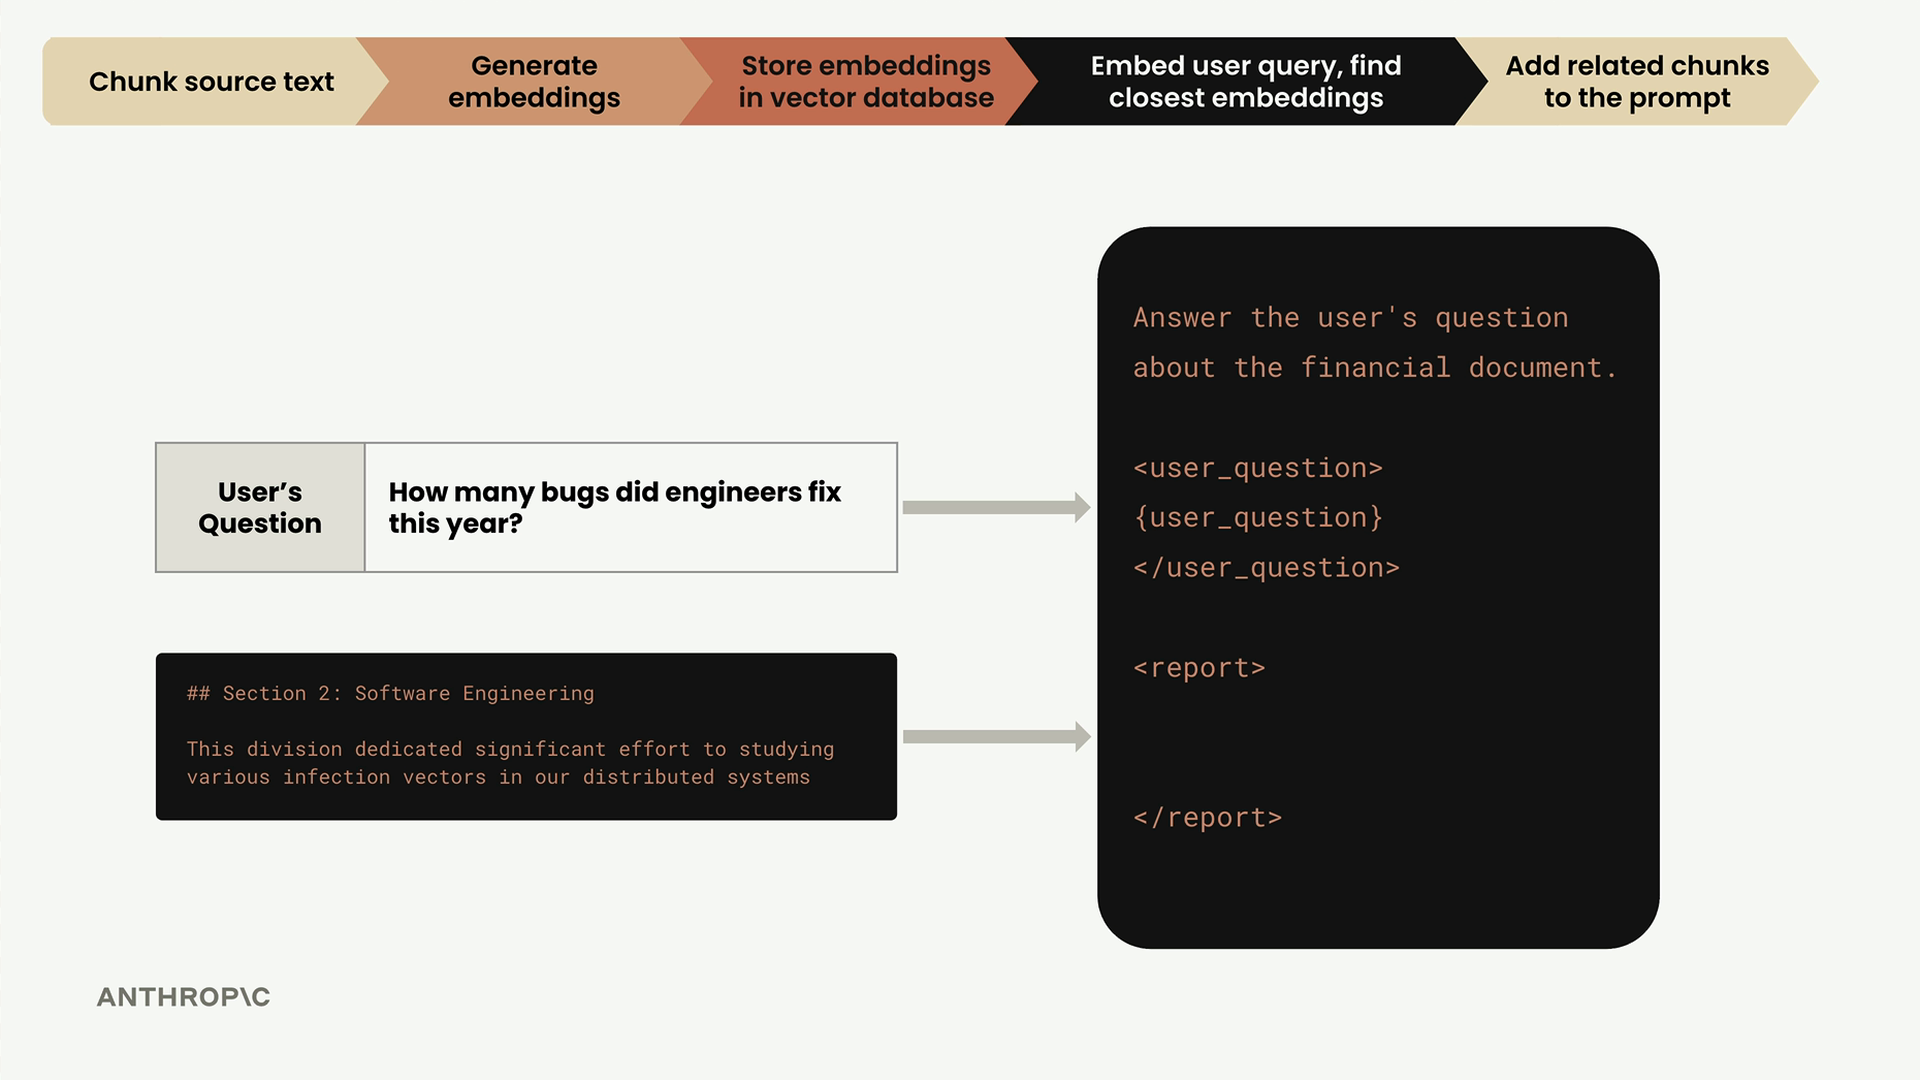
Answer the user's question about the financial document.

<user_question>
How many bugs did engineers fix this year?
</user_question>

<report>
## Section 2: Software Engineering
This division dedicated significant effort to studying various infection vectors in our distributed systems
</report>Und das ist die komplette RAG-Pipeline! Das System hat erfolgreich den relevantesten Kontext für die Software-Engineering-Frage des Nutzers gefunden und ihn Claude zur Verfügung gestellt, um eine fundierte Antwort zu generieren.
Dieser Prozess läuft automatisch jedes Mal ab, wenn ein Nutzer eine Anfrage stellt, wodurch Claude Fragen basierend auf deinen spezifischen Dokumenten beantworten kann, anstatt sich nur auf sein allgemeines Trainingswissen zu stützen.