Nun, da wir den RAG-Flow konzeptionell verstehen, wollen wir ihn Schritt für Schritt anhand eines praktischen Beispiels implementieren. Wir arbeiten uns durch alle fünf Stufen des RAG-Prozesses, vom Chunking von Text bis zum Finden relevanter Dokumente für Benutzeranfragen.
Einrichten der Vektordatenbank
Für diese Implementierung verwenden wir eine benutzerdefinierte VectorIndex-Klasse, die die grundlegende Funktionalität bietet, die wir zum Speichern und Durchsuchen von Embeddings benötigen. Die Klasse übernimmt die Vektorspeicherung, Distanzberechnungen (mit Kosinus-Ähnlichkeit) und den Dokumentabruf.
Die Fünf-Schritte-RAG-Implementierung
Gehen wir jeden Schritt des RAG-Prozesses durch:
Schritt 1: Den Text nach Abschnitten chunken
Zunächst müssen wir unser Ausgangsdokument in handhabbare Chunks aufteilen. Wir verwenden denselben abschnittsbasierten Chunking-Ansatz wie zuvor:
chunks = chunk_by_section(text)Dies teilt unsere Datei report.md in logische Abschnitte auf, die wir einzeln verarbeiten können.
Schritt 2: Embeddings für jeden Chunk generieren
Als Nächstes wandeln wir jeden Text-Chunk in ein numerisches Embedding um, das seine semantische Bedeutung erfasst:
embeddings = generate_embedding(chunks)Diese Embeddings ermöglichen es uns, mathematische Vergleiche zwischen verschiedenen Textstücken durchzuführen.
Schritt 3: Embeddings in der Vektordatenbank speichern
Jetzt erstellen wir unseren Vektorspeicher und befüllen ihn mit unseren Embeddings und dem zugehörigen Text:
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
Beachte, dass wir sowohl das Embedding als auch den ursprünglichen Textinhalt speichern. Das ist entscheidend, denn wenn wir später ähnliche Embeddings abrufen, benötigen wir Zugriff auf den tatsächlichen Text, nicht nur auf die numerischen Vektoren. Das Embedding allein ist für uns als Entwickler nicht nützlich – wir brauchen den für Menschen lesbaren Inhalt, den es repräsentiert.
Schritt 4: Ein Embedding für die Benutzeranfrage generieren
Wenn ein Benutzer eine Frage stellt, müssen wir seine Anfrage in denselben Embedding-Raum wie unsere gespeicherten Dokumente umwandeln:
user_embedding = generate_embedding("What did the software engineering dept do last year?")Schritt 5: Nach relevanten Dokumenten suchen
Schließlich durchsuchen wir unseren Vektorspeicher, um die relevantesten Chunks zu finden:
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
Dies liefert die beiden ähnlichsten Chunks zusammen mit ihren Kosinus-Distanzwerten.
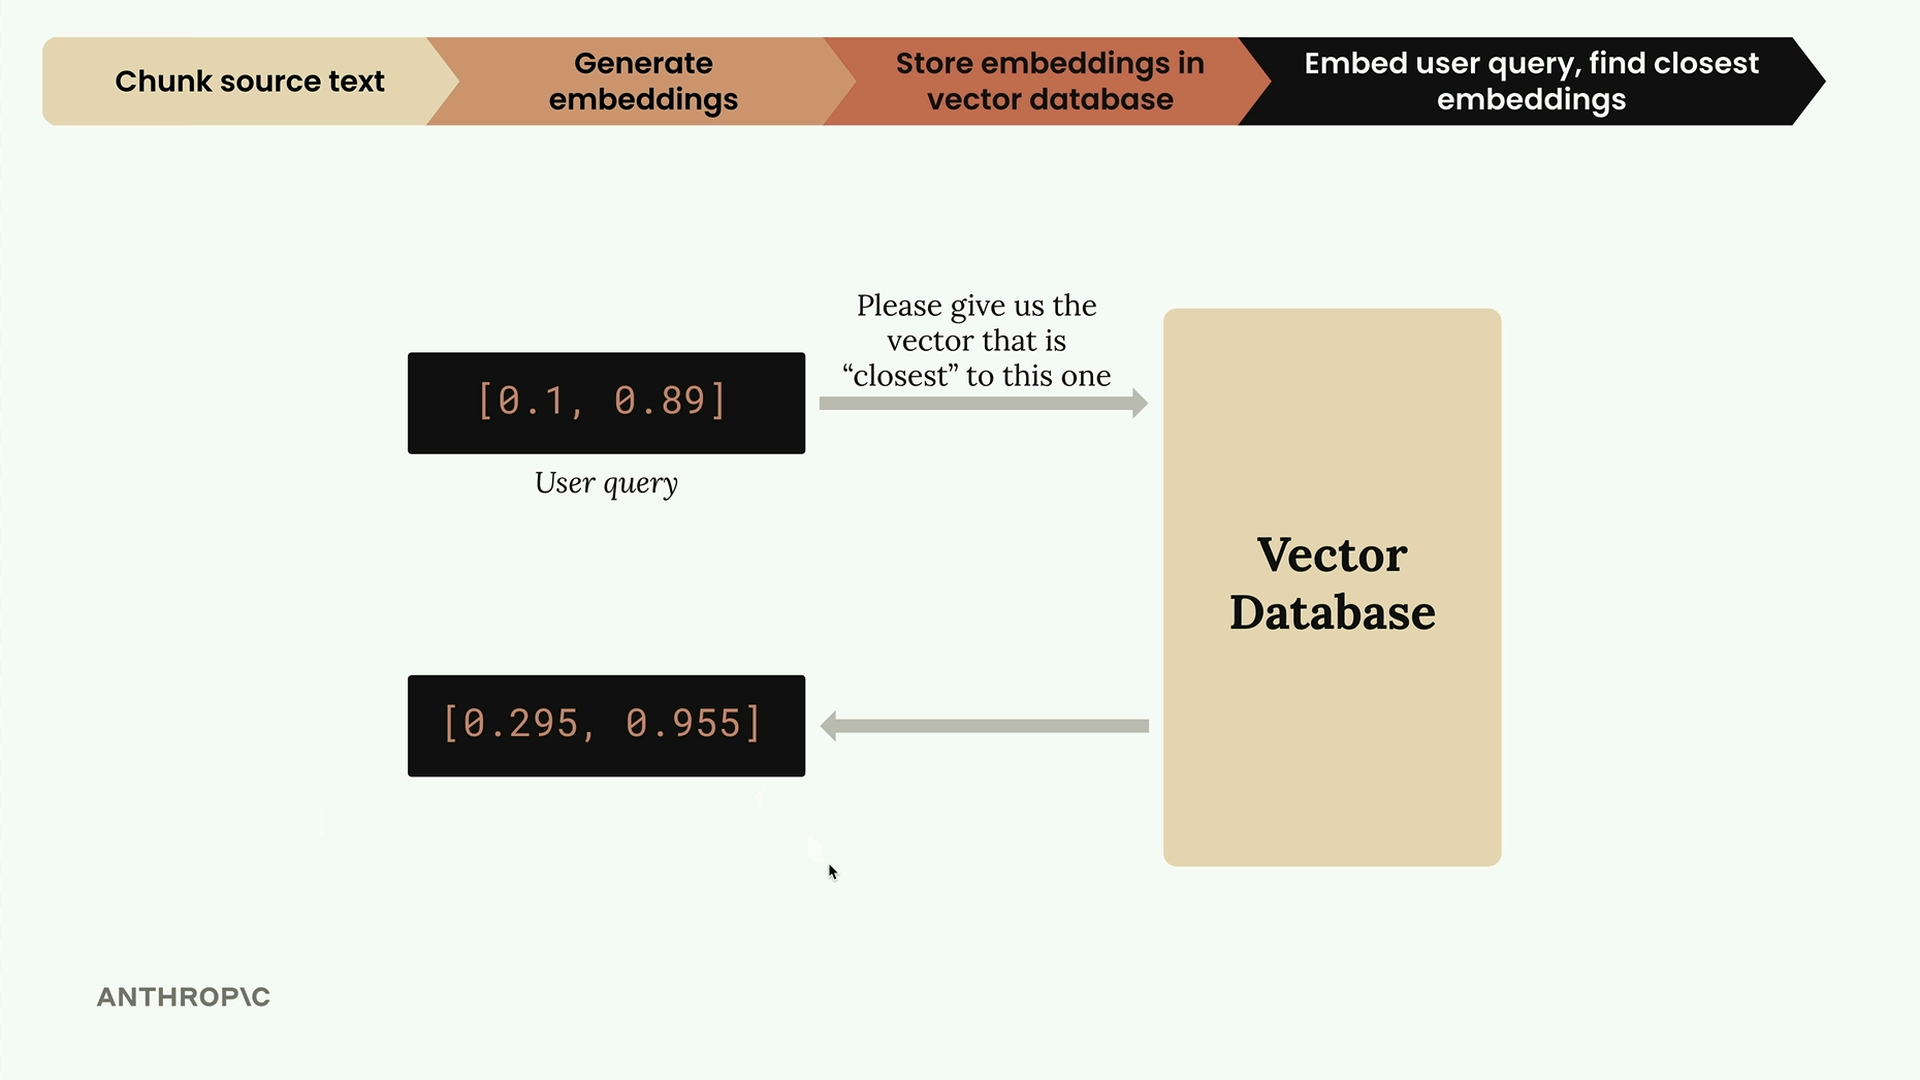
Das obige Diagramm veranschaulicht, wie die Vektordatenbank eine Benutzeranfrage verarbeitet. Wenn wir eine Frage stellen, wird sie in einen Embedding-Vektor umgewandelt, und die Datenbank findet die gespeicherten Vektoren, die ihm im hochdimensionalen Raum am „nächsten“ sind.
Die Ergebnisse verstehen
Wenn wir dieses Beispiel mit der Anfrage zur Software-Engineering-Abteilung ausführen, erhalten wir zwei relevante Abschnitte zurück:
- Abschnitt 2: Software Engineering - Project Phoenix Stability Enhancements (Distanz: 0,71)
- Methodik-Abschnitt (Distanz: 0,72)
Je niedriger der Distanzwert, desto ähnlicher ist der Inhalt unserer Anfrage. Beide Ergebnisse sind relevant für unsere Frage, was die Software-Engineering-Abteilung erreicht hat.
Warum Inhalt zusammen mit Embeddings speichern
Du fragst dich vielleicht, warum wir den ursprünglichen Text zusammen mit jedem Embedding speichern. Der Grund ist praktisch: Embeddings sind nur Arrays von Zahlen, die für Menschen keine direkte Bedeutung haben. Wenn unsere Suche die ähnlichsten Embeddings zurückgibt, benötigen wir den tatsächlichen Textinhalt, um zu verstehen, was gefunden wurde, und um ihn bei der Generierung von Antworten zu verwenden.
Manche Implementierungen speichern nur eine ID, die auf den ursprünglichen Text zurückverweist, aber der Einfachheit halber speichern wir den Inhalt direkt bei jedem Vektor.
Wie geht es weiter
Diese Implementierung deckt den grundlegenden RAG-Workflow ab, aber es gibt noch Verbesserungen, die wir vornehmen können. In realen Anwendungen könntest du auf Szenarien stoßen, in denen dieser grundlegende Ansatz nicht wie erwartet funktioniert, und wir werden diese Verfeinerungen in den kommenden Abschnitten erkunden.