Beim Erstellen von Anwendungen mit Claude hilft dir das Verständnis des vollständigen Request-Lebenszyklus, bessere Systeme zu architektieren und Probleme effektiver zu debuggen. Gehen wir gemeinsam durch, was passiert, wenn ein Nutzer eine Nachricht an deine KI-gestützte Chat-Anwendung sendet.
Der vollständige Request-Ablauf
Der Weg von der Nutzereingabe zur KI-Antwort umfasst fünf unterschiedliche Schritte: Request an den Server, Request an Vertex, Modellverarbeitung, Antwort an den Server und Antwort an den Client. Jeder Schritt spielt eine entscheidende Rolle bei der Bereitstellung jener „magischen“ Antwort, die Nutzer erwarten.
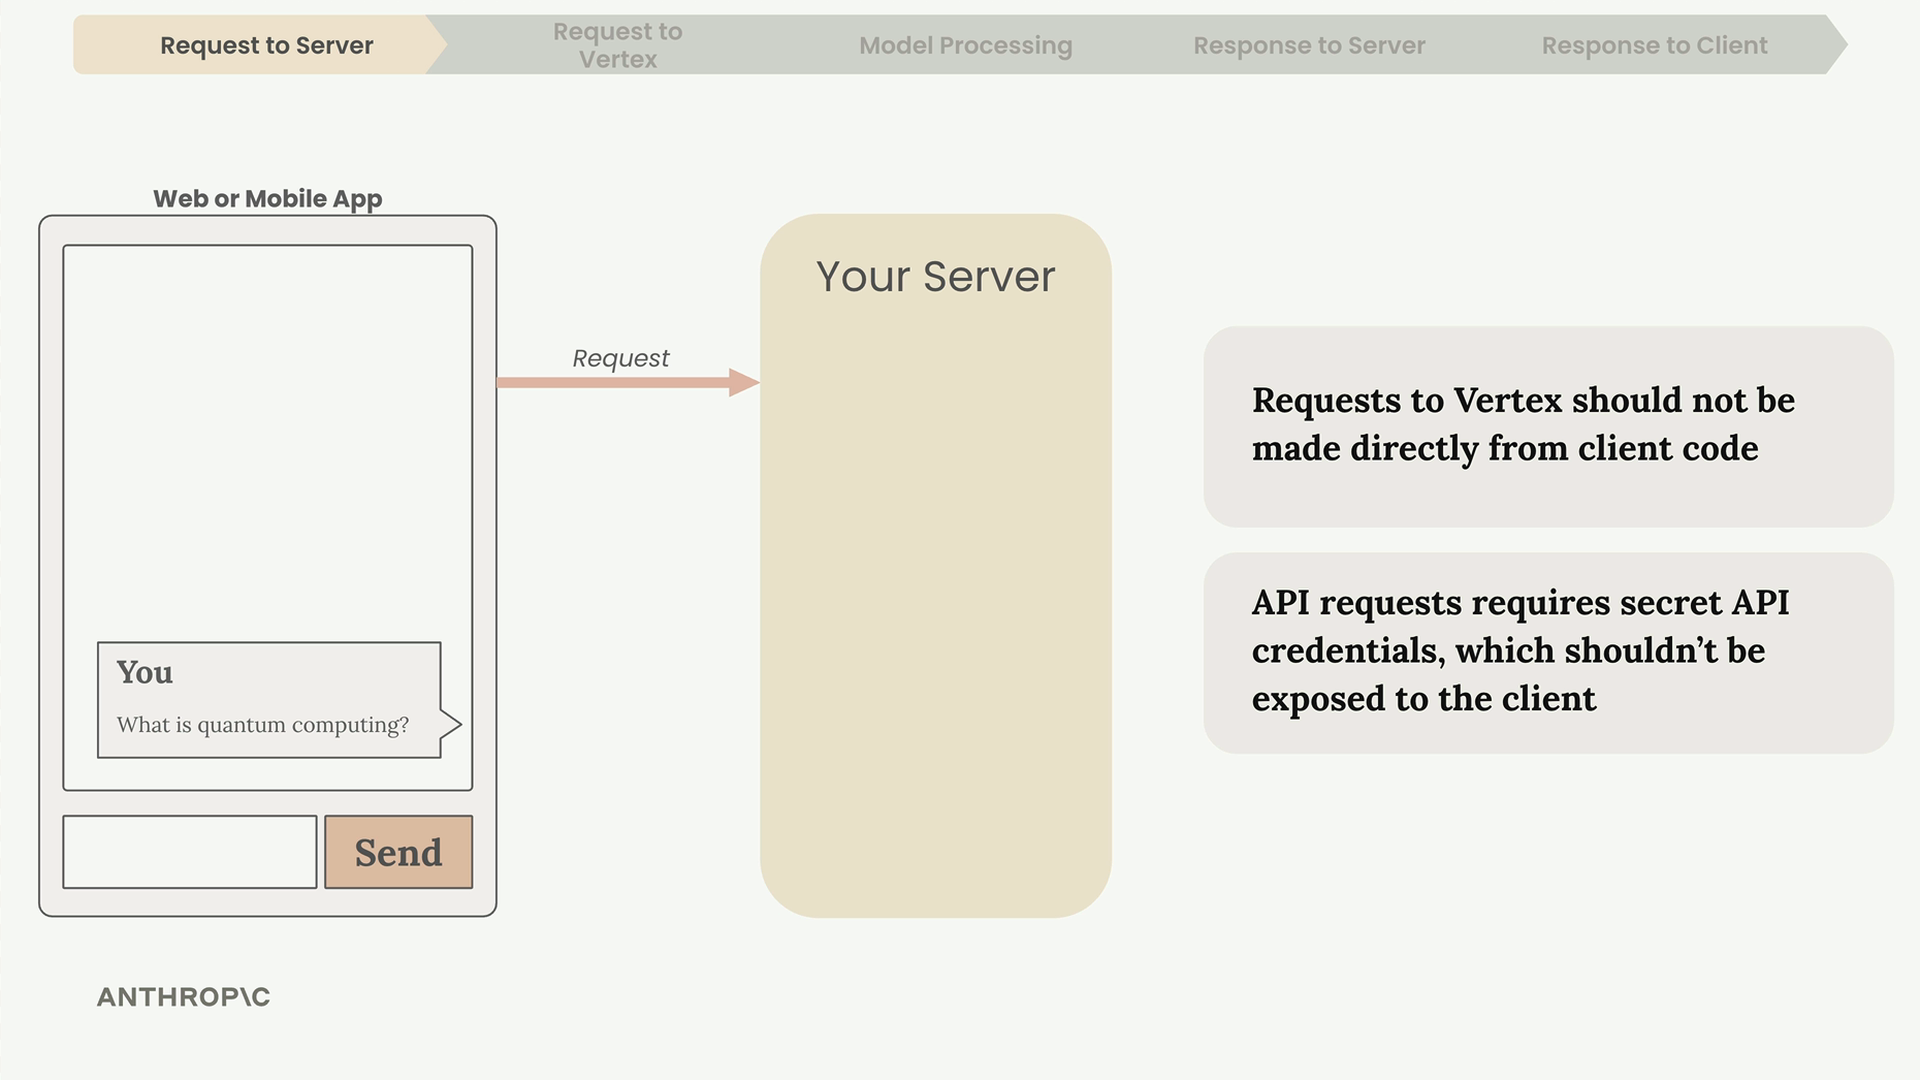
Warum du einen Server brauchst
Stelle API-Requests niemals direkt aus clientseitigem Code. Hier ist der Grund:
- API-Requests erfordern geheime Anmeldedaten, die sicher bleiben müssen
- Das Offenlegen von Anmeldedaten im Client-Code macht sie für jeden sichtbar
- Dein Server fungiert als sichere Vermittlungsinstanz zwischen deiner App und Vertex
Leite Requests immer über deinen eigenen Server, den du kontrollierst und absicherst.
Den API-Request stellen
Dein Server kommuniziert mit Vertex entweder über Anthropics SDKs oder Googles offizielle Vertex-SDKs. Anthropic stellt offizielle SDKs für Python, TypeScript, Go und Ruby bereit.
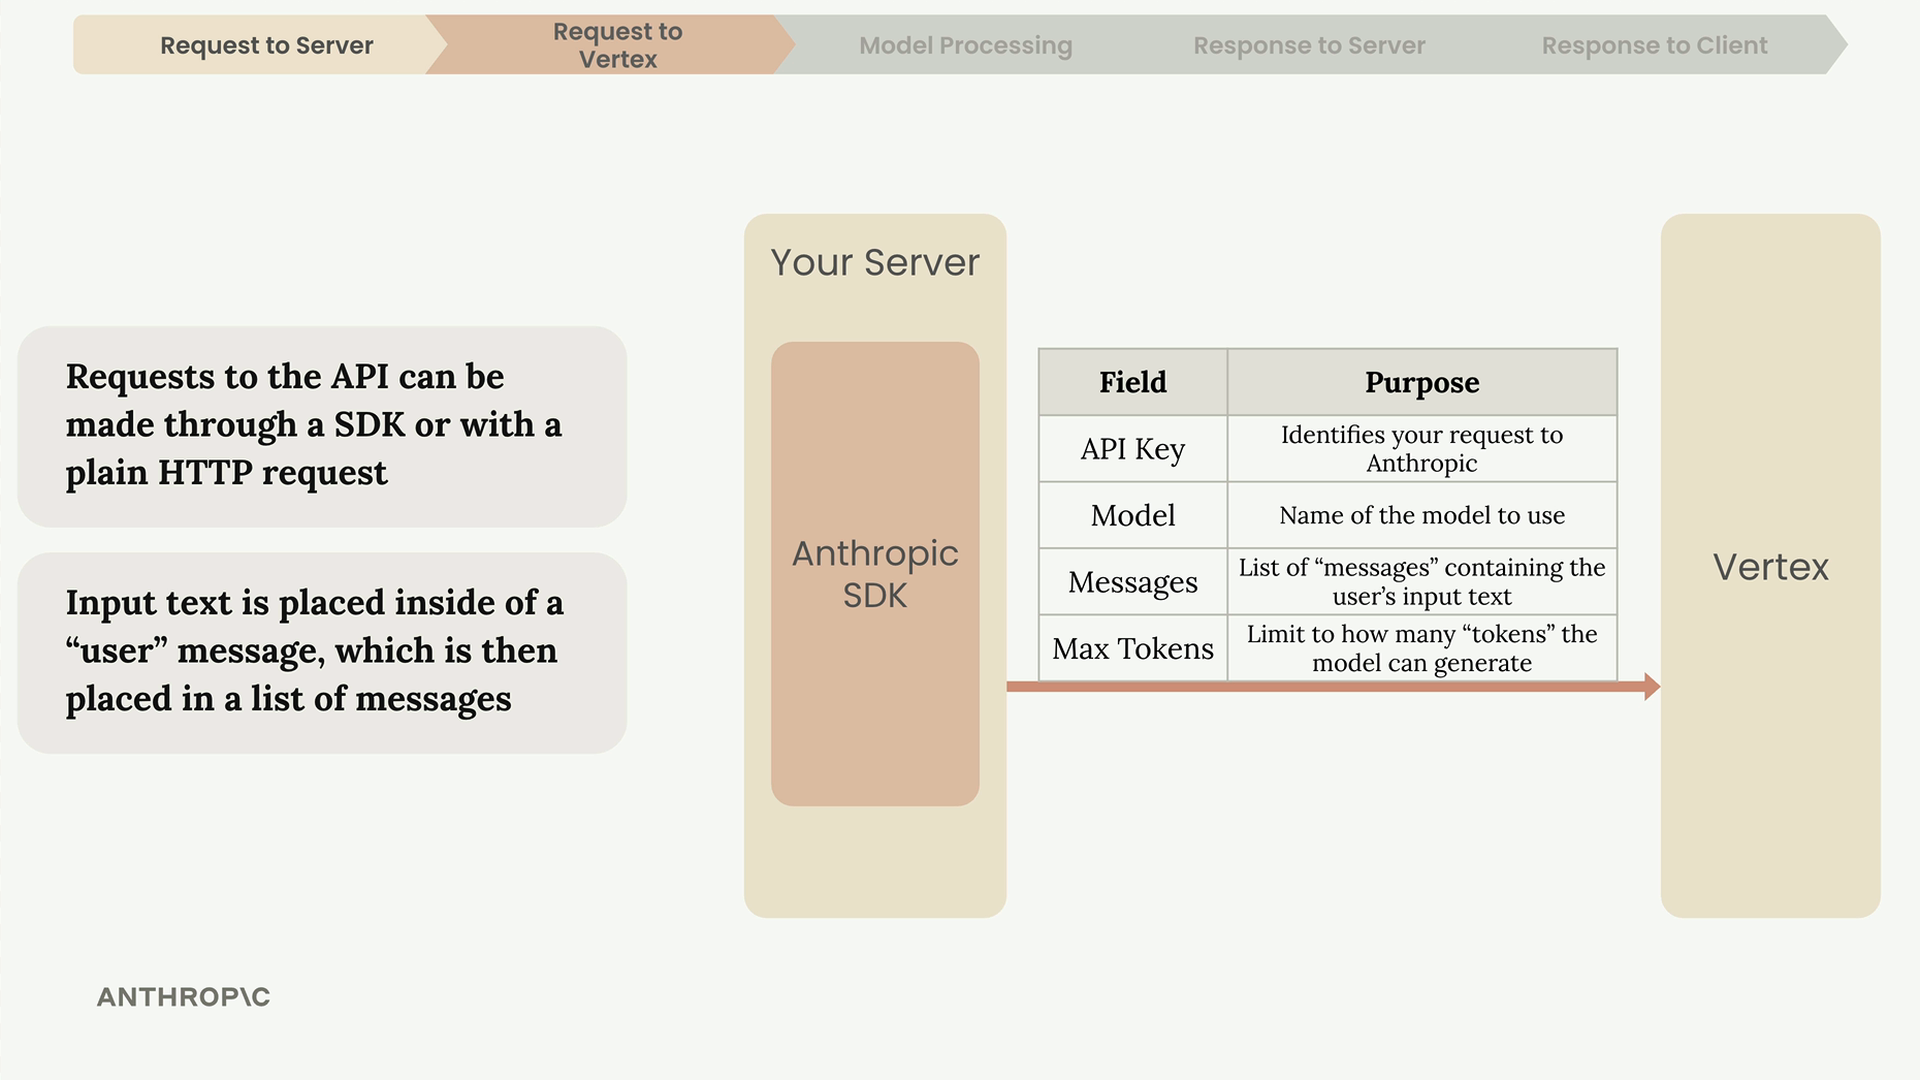
Jeder Request muss diese wichtigen Felder enthalten:
- Google Cloud Credentials - Autorisiert deinen Request bei Google Cloud
- Model - Name des zu verwendenden spezifischen Modells
- Messages - Liste, die den Eingabetext des Nutzers enthält
- Max Tokens - Begrenzt, wie viele Tokens das Modell generieren kann
Die Eingabe des Nutzers wird in eine „user“-Nachricht eingefügt, die dann in eine Liste von Nachrichten eingeht, die an die API gesendet wird.
Innerhalb von Claude: Der Textgenerierungsprozess
Sobald Vertex deinen Request erhalten hat, verarbeitet Claude ihn in vier Stufen: Tokenisierung, Embedding, Kontextualisierung und Generierung.
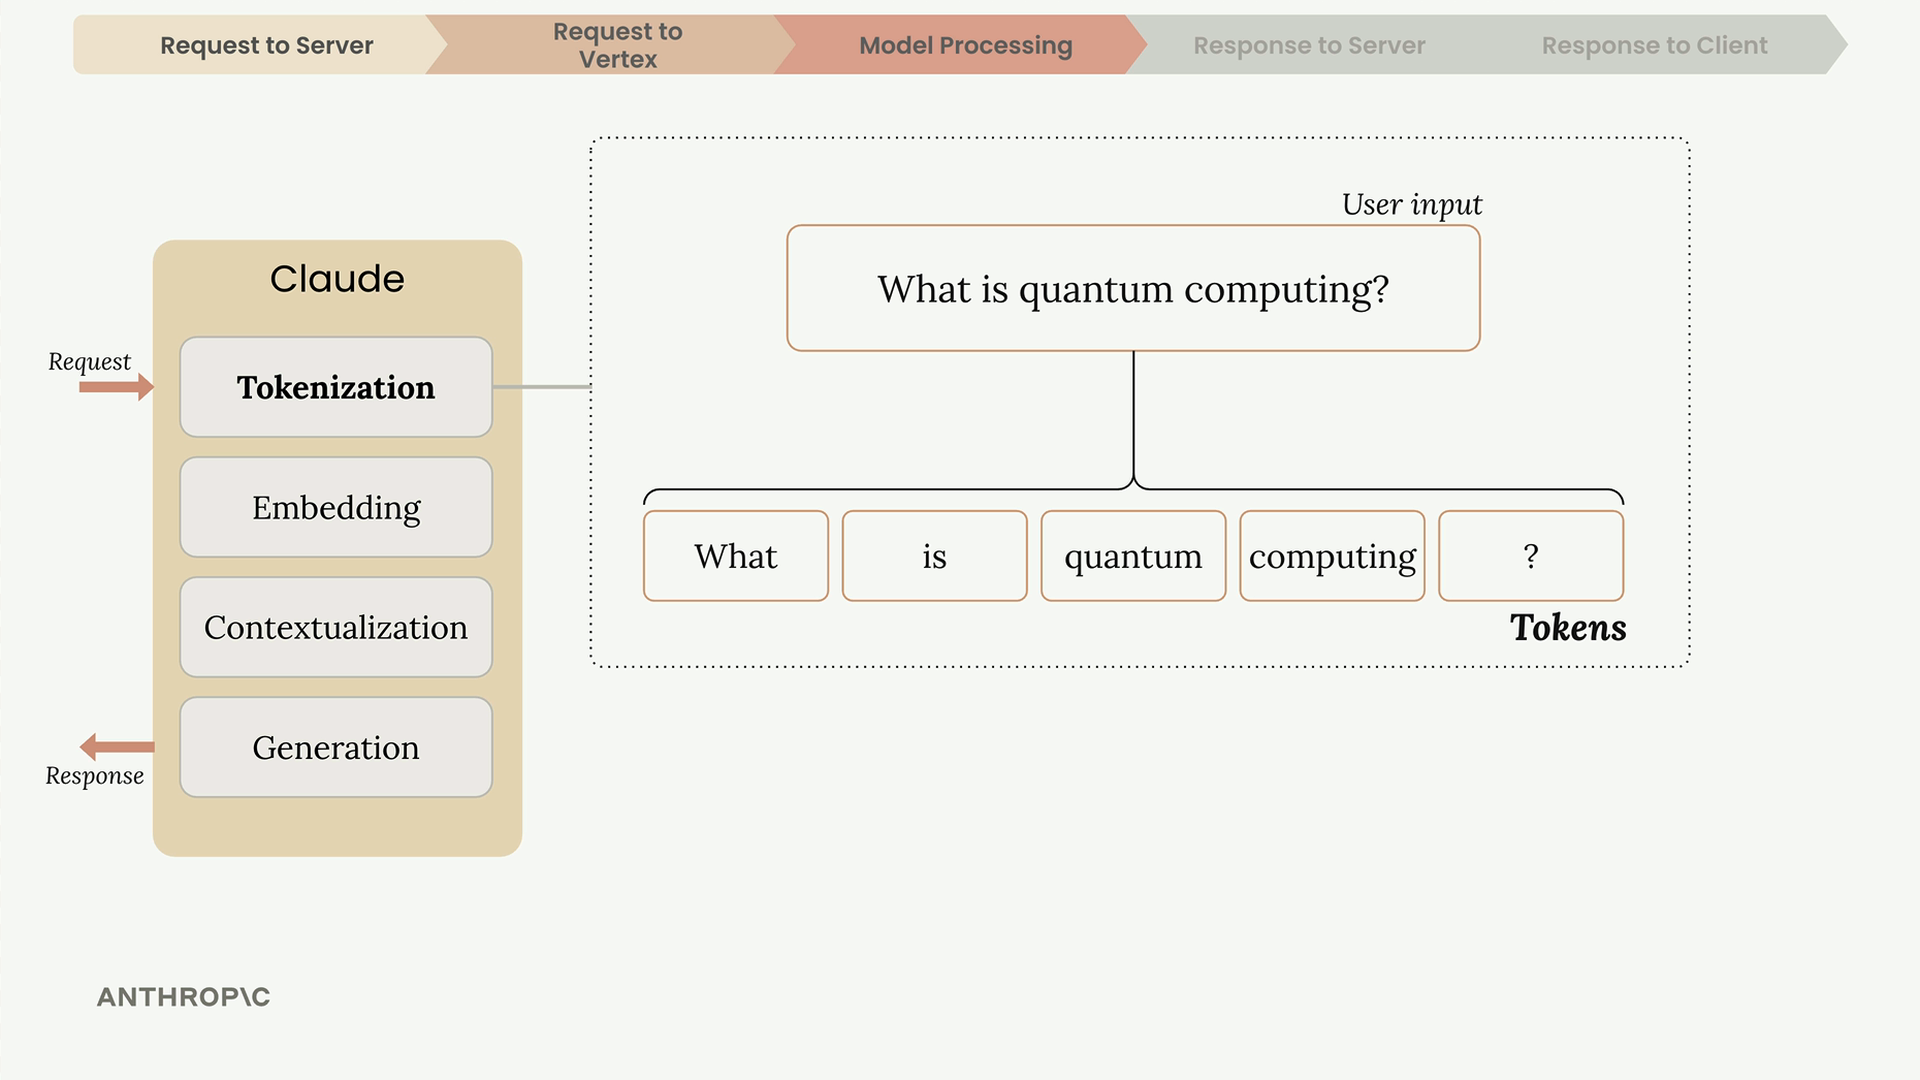
Tokenisierung
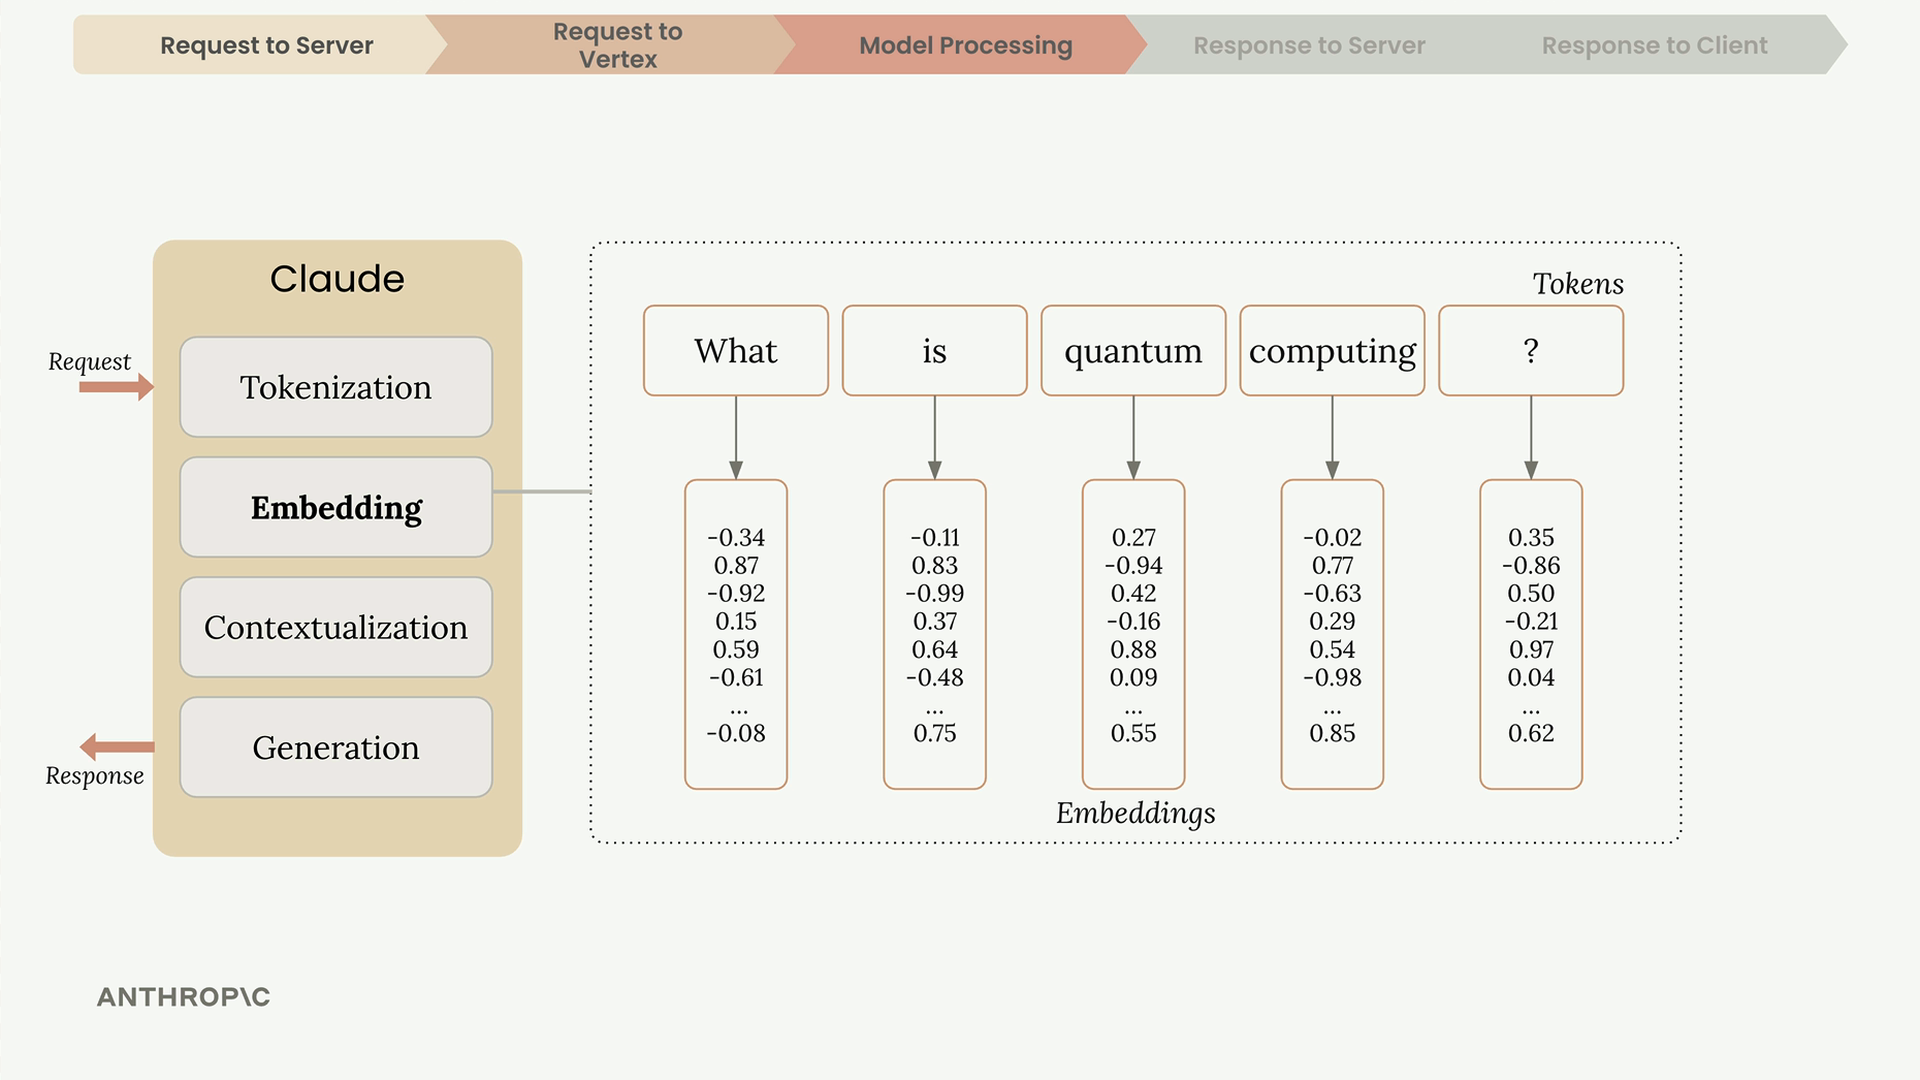
Claude zerlegt den Eingabetext zunächst in kleinere Teile, die Tokens genannt werden. Dabei kann es sich um ganze Wörter, Wortteile, Leerzeichen oder Symbole handeln. Der Einfachheit halber kannst du dir jedes Wort als ein Token vorstellen.
Embedding
Jedes Token wird in ein Embedding umgewandelt - eine lange Liste von Zahlen, die alle möglichen Bedeutungen dieses Wortes darstellt. Stell dir Embeddings als zahlenbasierte Definitionen vor.
Kontextualisierung
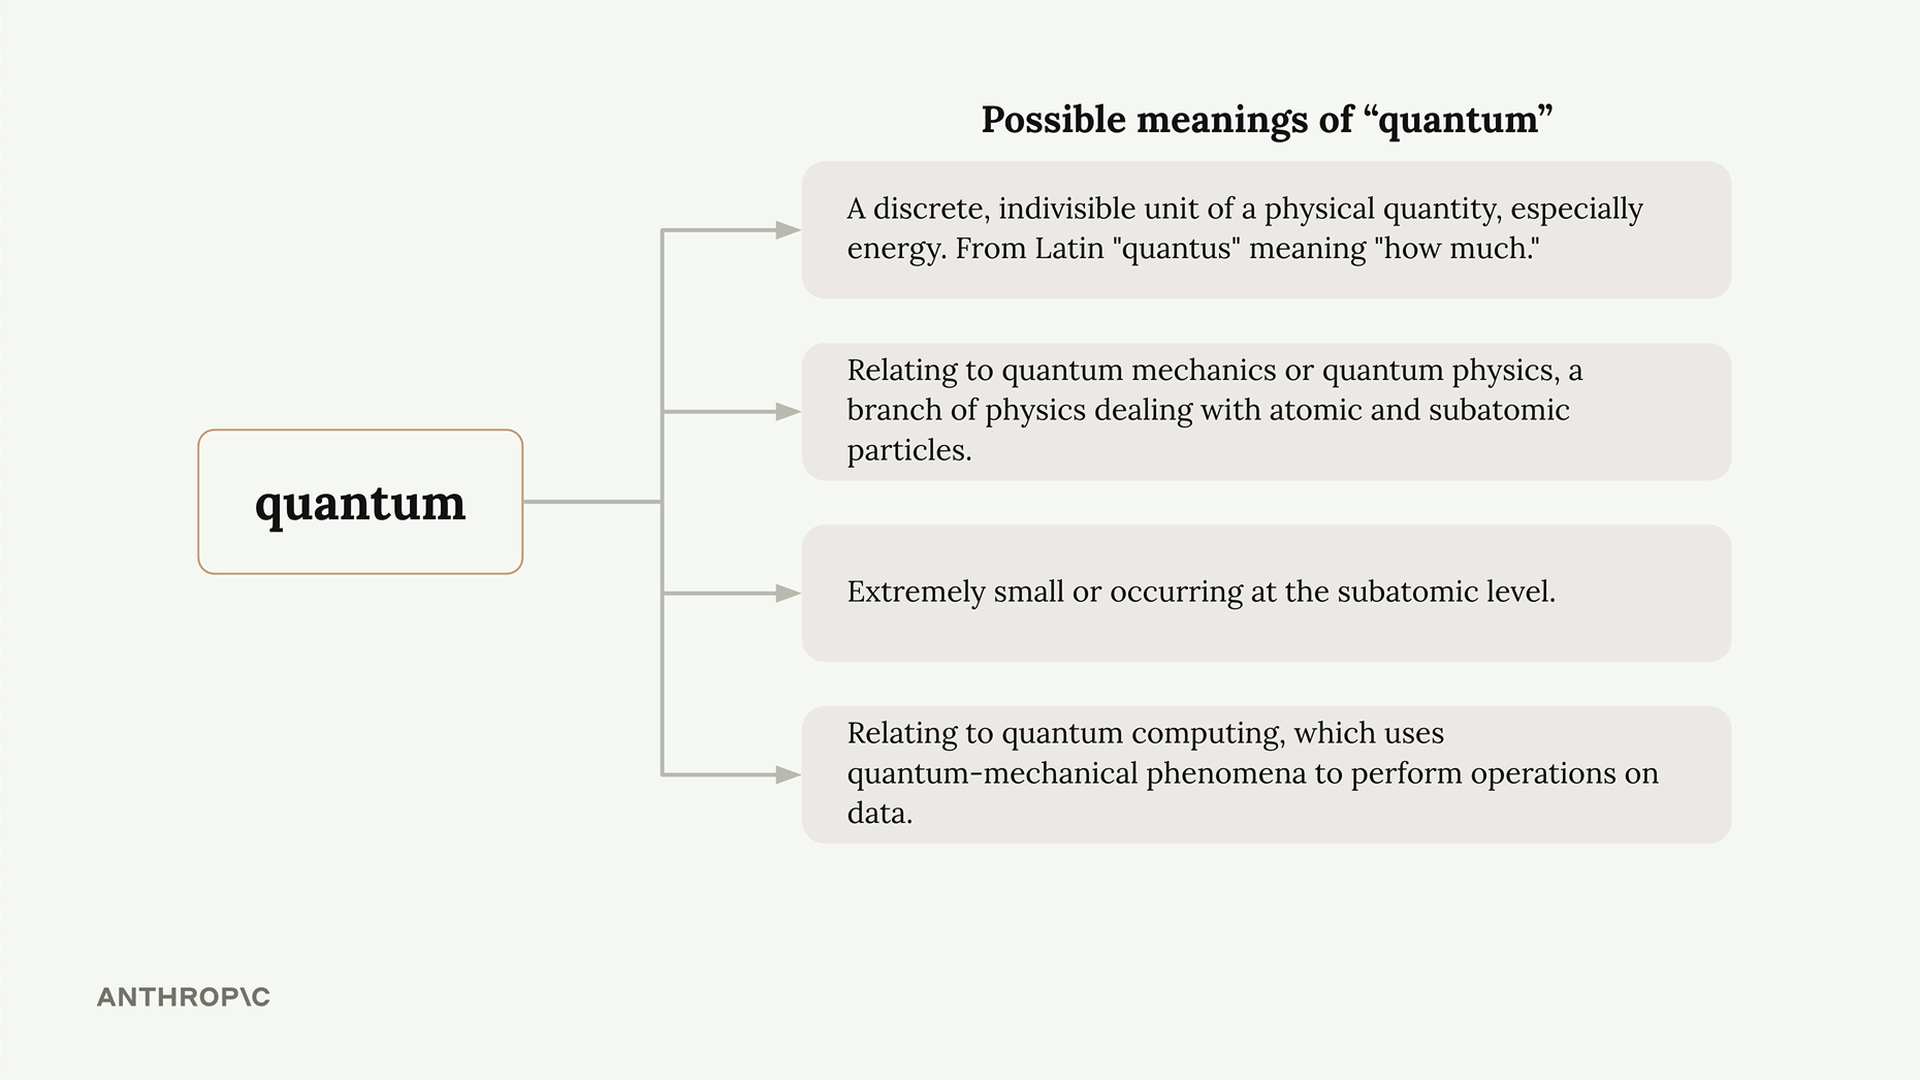
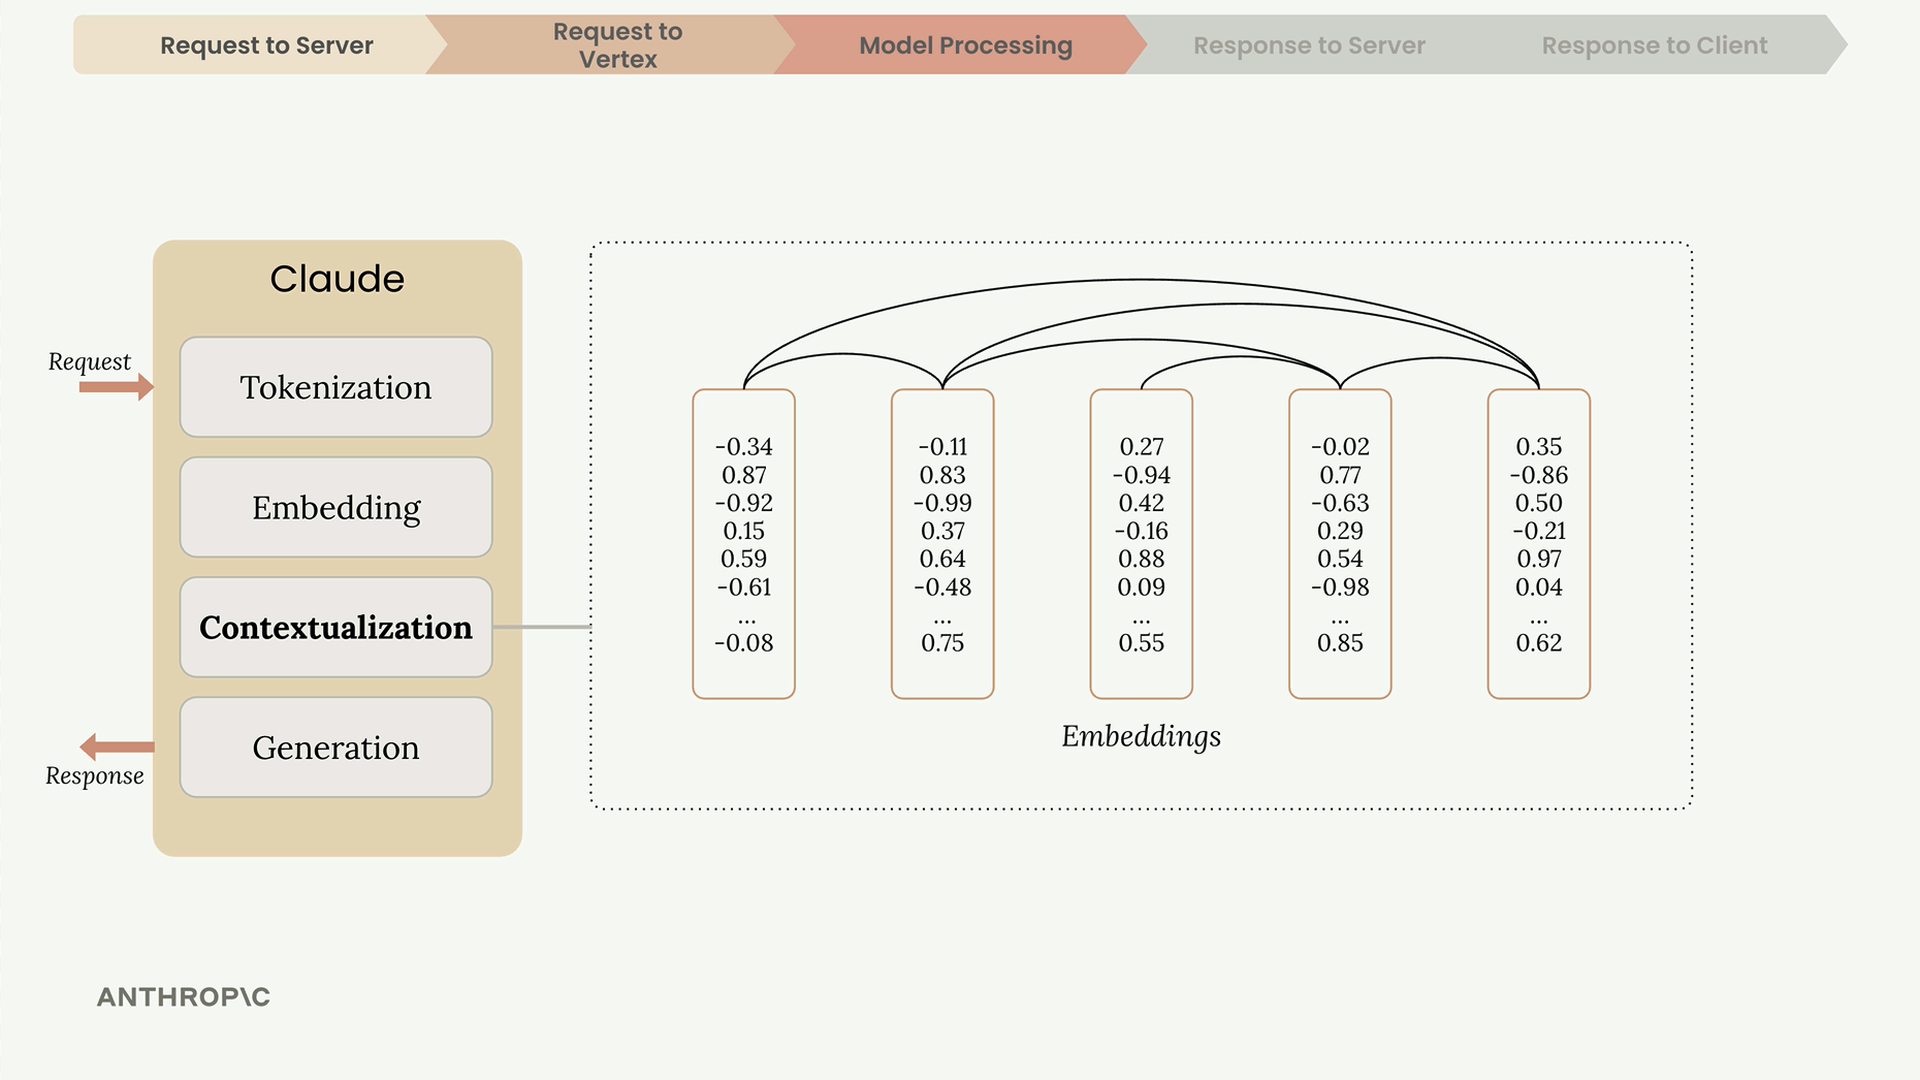
Da Wörter mehrere Bedeutungen haben können, nutzt Claude den Kontext, um die richtige Interpretation zu bestimmen. Das Wort „Quanten“ könnte sich auf Physik, Computing beziehen oder einfach „sehr klein“ bedeuten - der Kontext der umgebenden Wörter klärt die beabsichtigte Bedeutung.
Während der Kontextualisierung wird jedes Embedding basierend auf seinen Nachbarn angepasst, wobei die Bedeutung hervorgehoben wird, die im gegebenen Kontext am meisten Sinn ergibt.
Generierung
Die kontextualisierten Embeddings durchlaufen eine Ausgabeschicht, die Wahrscheinlichkeiten für jedes mögliche nächste Wort erzeugt. Claude wählt nicht immer das Wort mit der höchsten Wahrscheinlichkeit - es nutzt eine Mischung aus Wahrscheinlichkeit und Zufälligkeit, um natürlichere, abwechslungsreichere Antworten zu erzeugen.
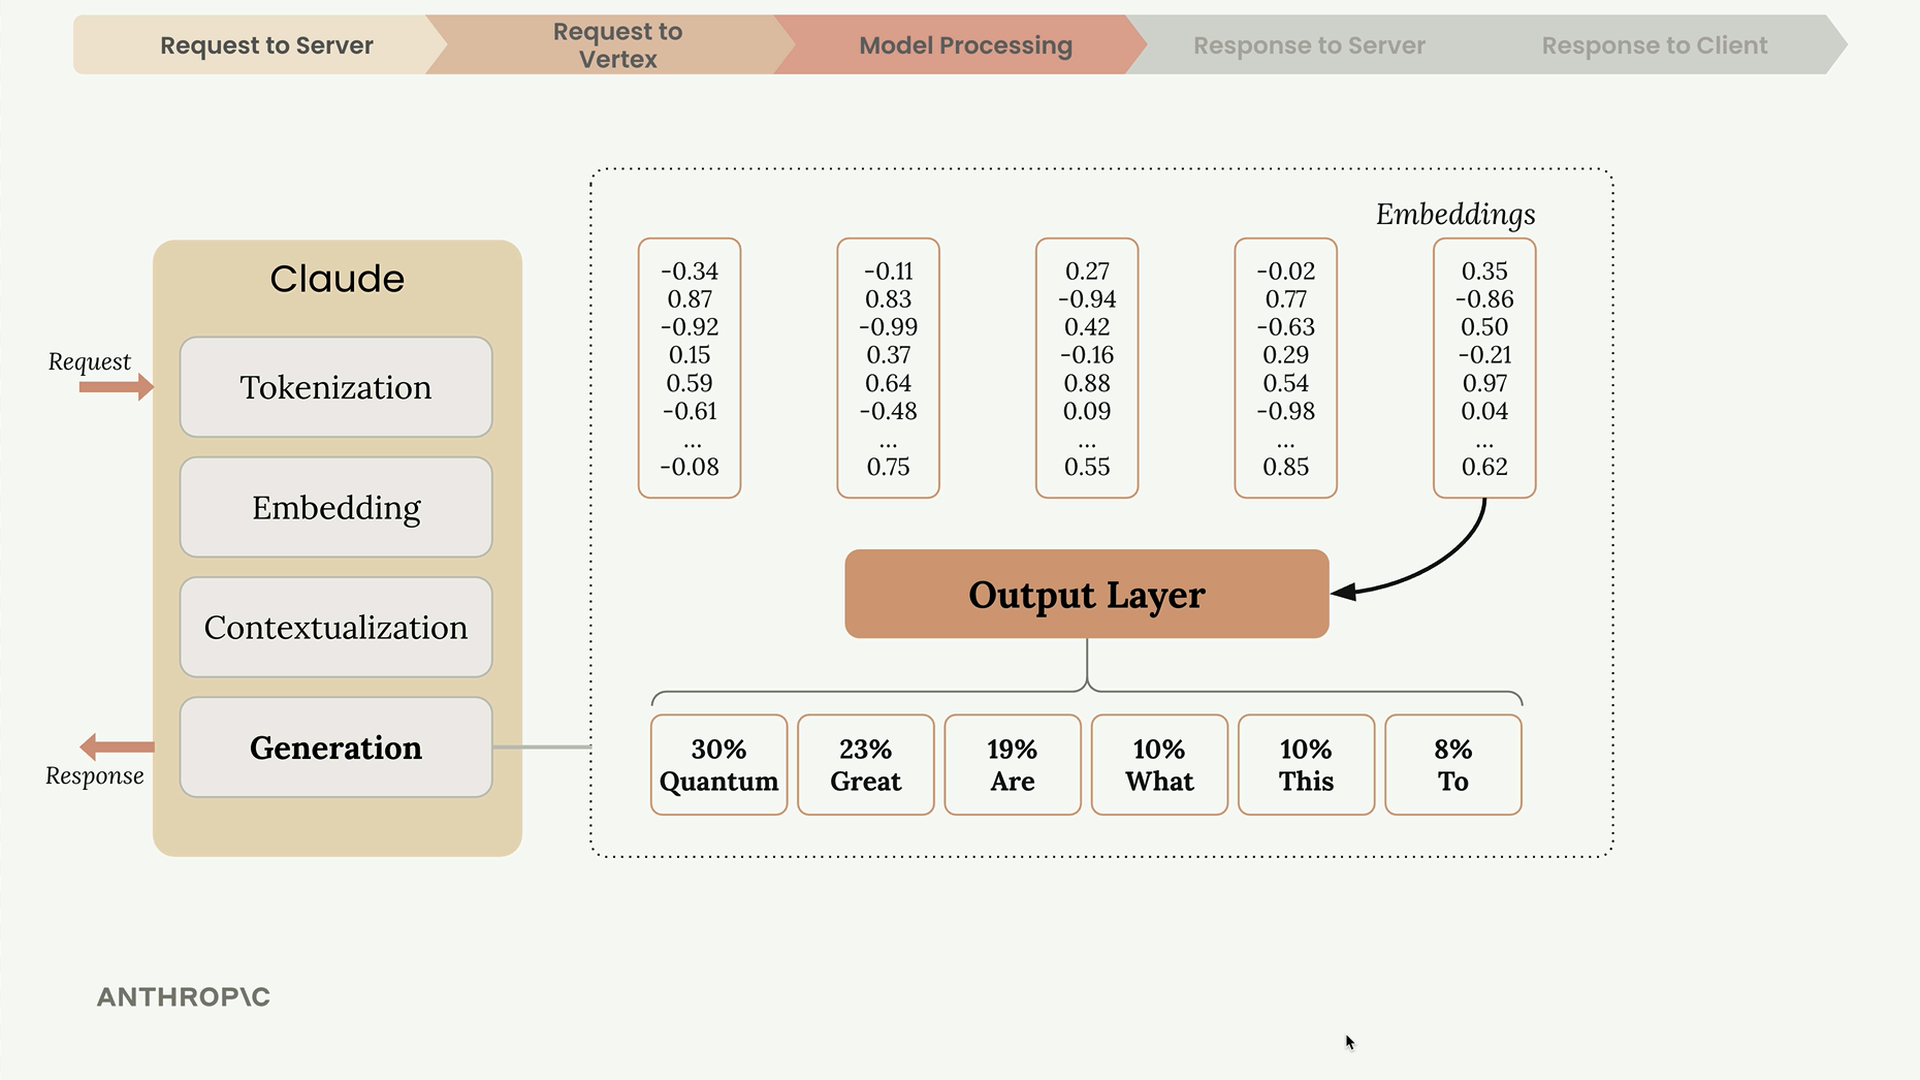
Nach der Auswahl eines Wortes fügt Claude es der Sequenz hinzu und wiederholt den gesamten Prozess für das nächste Wort.
Wann die Generierung stoppt
Nach der Generierung jedes Tokens prüft Claude mehrere Bedingungen, um zu entscheiden, ob fortgefahren werden soll:
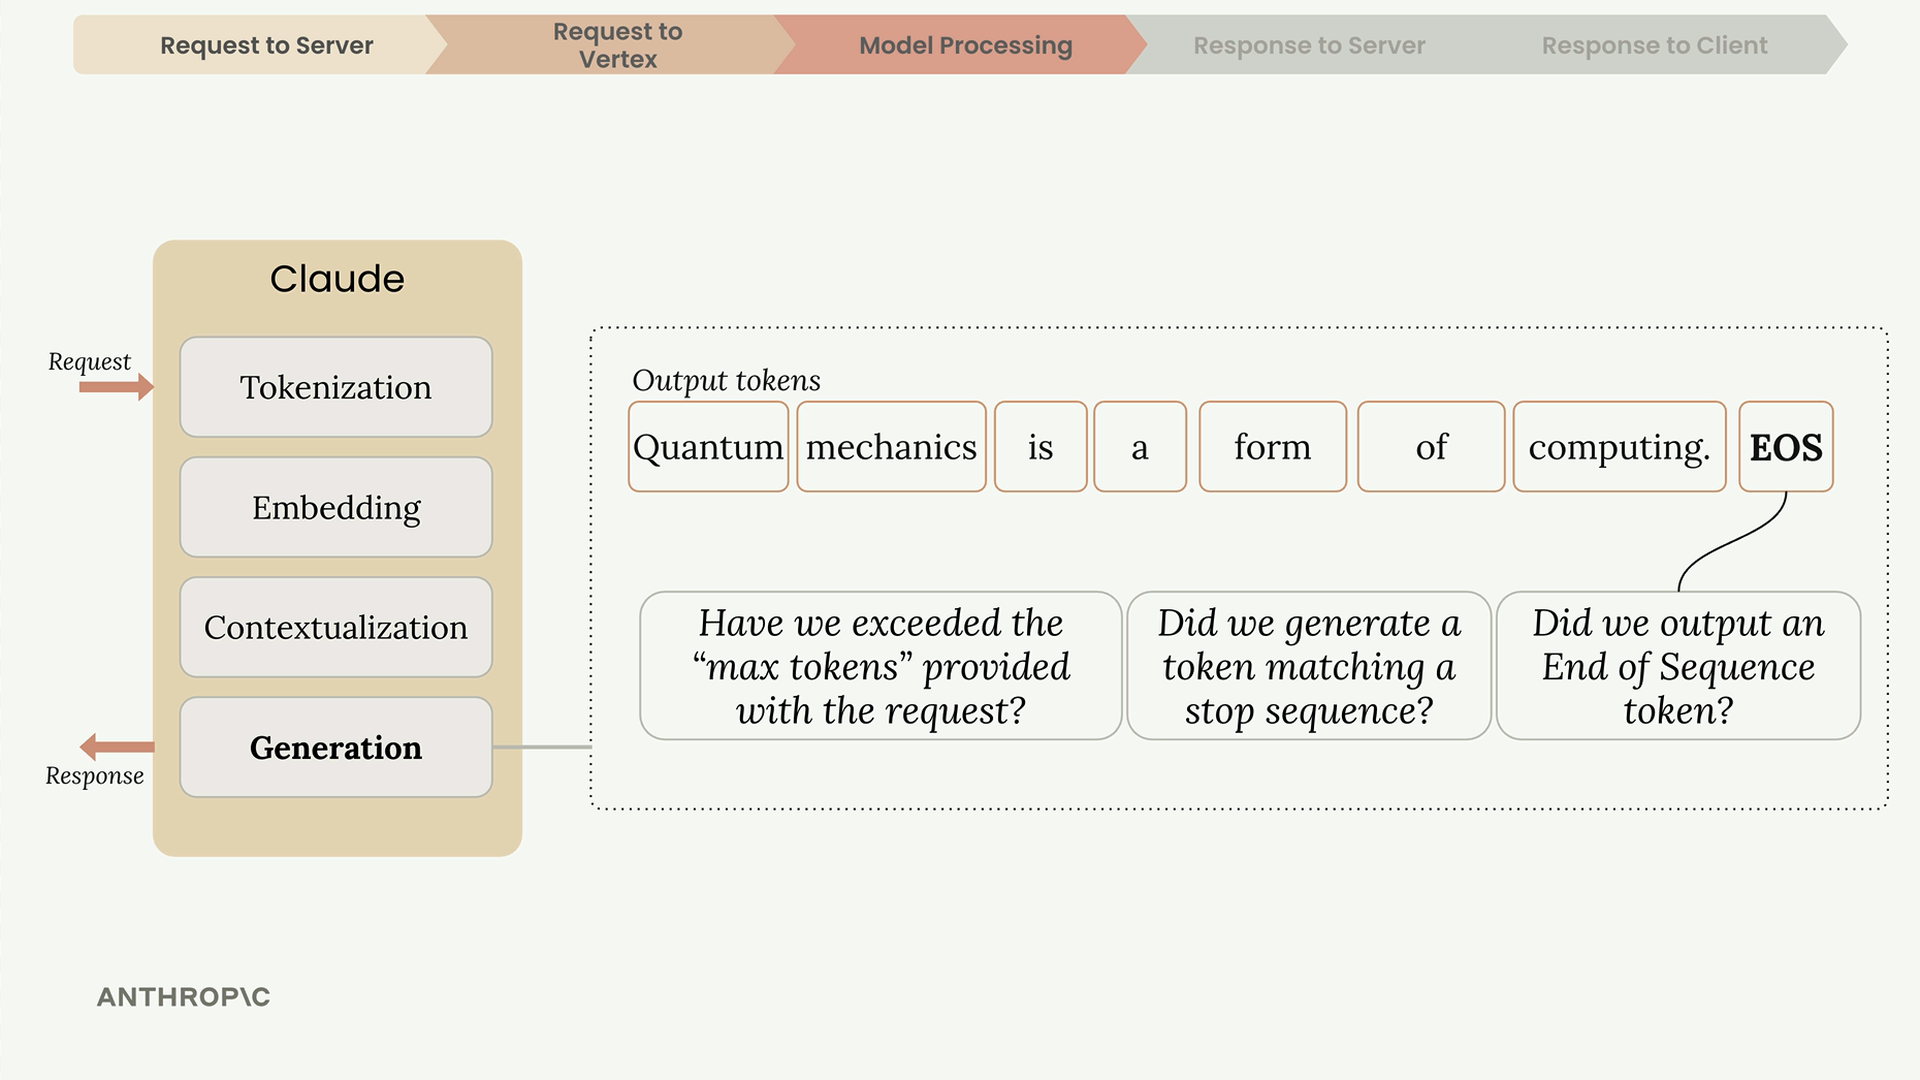
- Max Tokens erreicht - Wurde die von dir angegebene Grenze erreicht?
- Natürliches Ende - Wurde ein End-of-Sequence-Token generiert?
- Stop Sequence - Ist eine vordefinierte Stoppphrase aufgetreten?
Das End-of-Sequence-Token ist ein spezielles Signal (kein sichtbarer Text), mit dem Claude anzeigt, dass es einen natürlichen Abschluss erreicht hat.
Die Antwort
Sobald die Generierung abgeschlossen ist, sendet Vertex eine Antwort an deinen Server zurück, die Folgendes enthält:
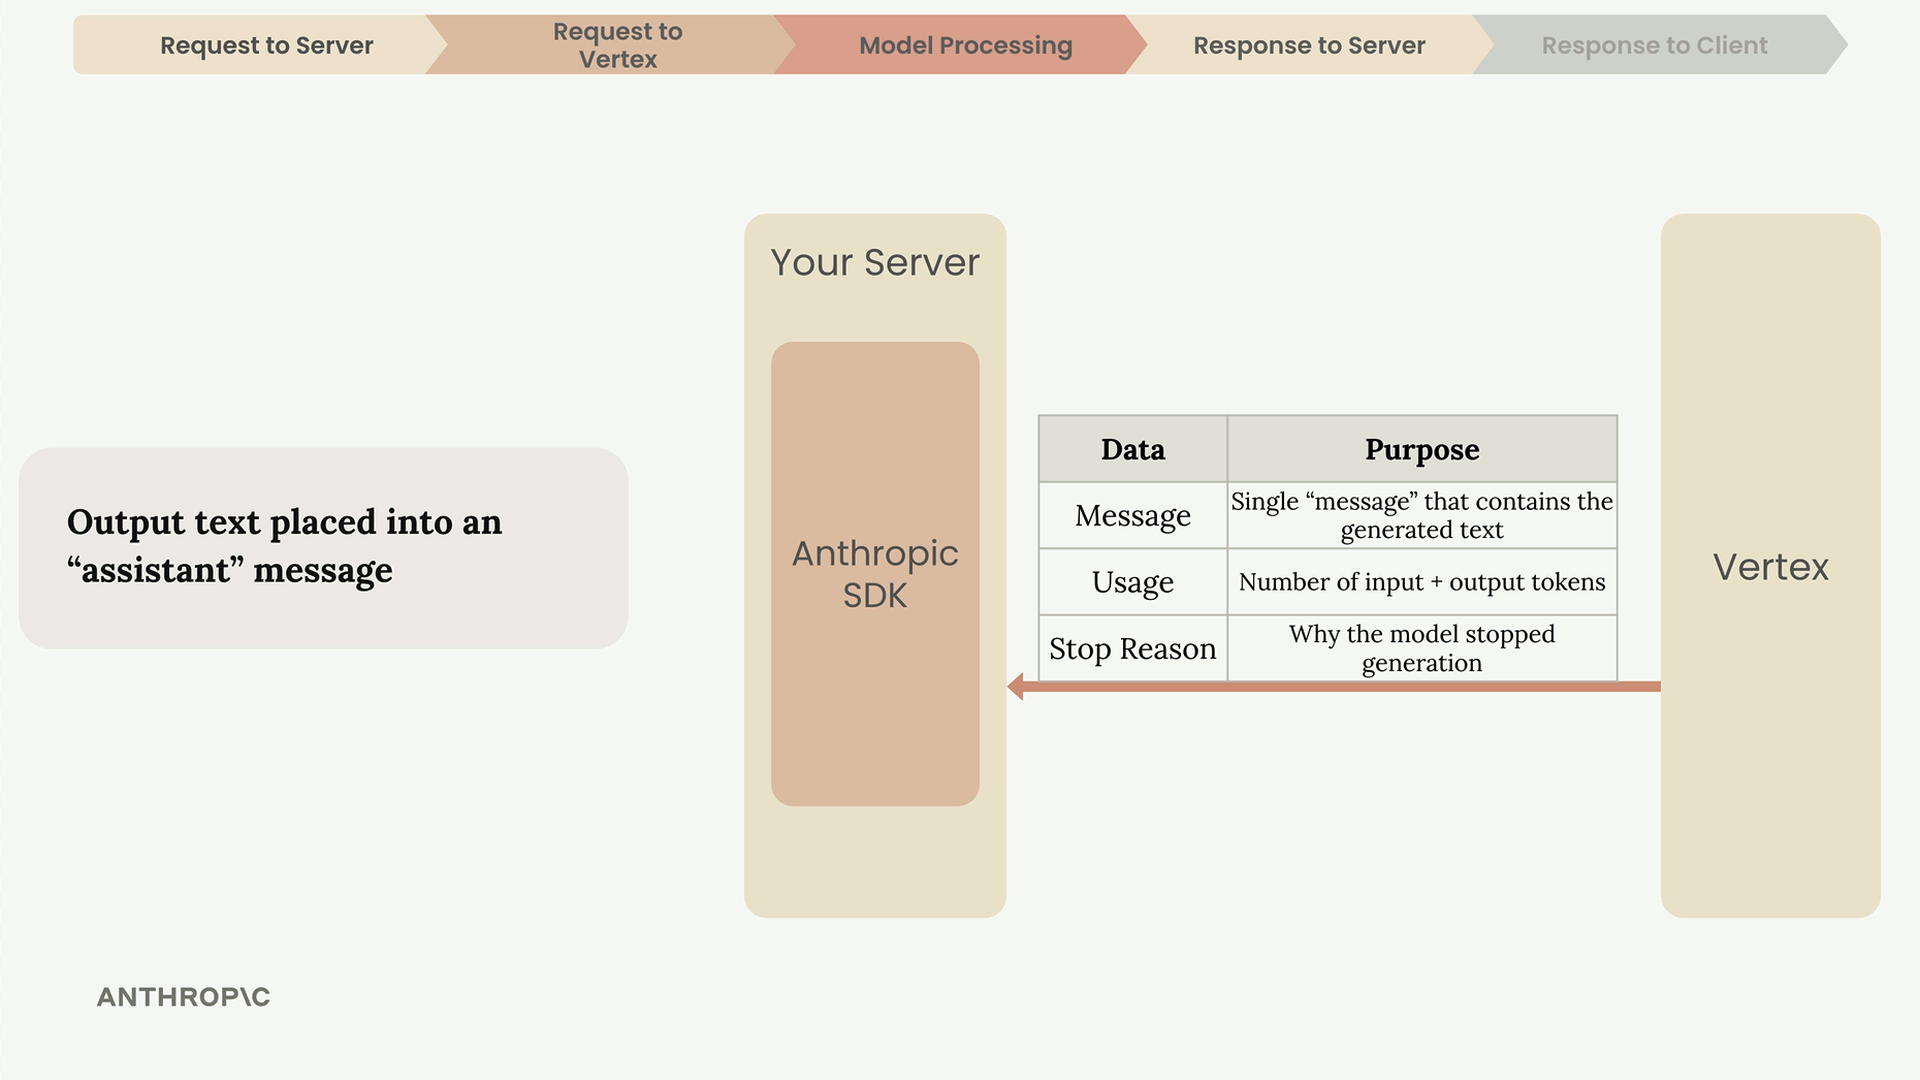
- Message - Der generierte Text
- Usage - Anzahl der Eingabe- und Ausgabe-Tokens
- Stop Reason - Warum das Modell die Generierung beendet hat
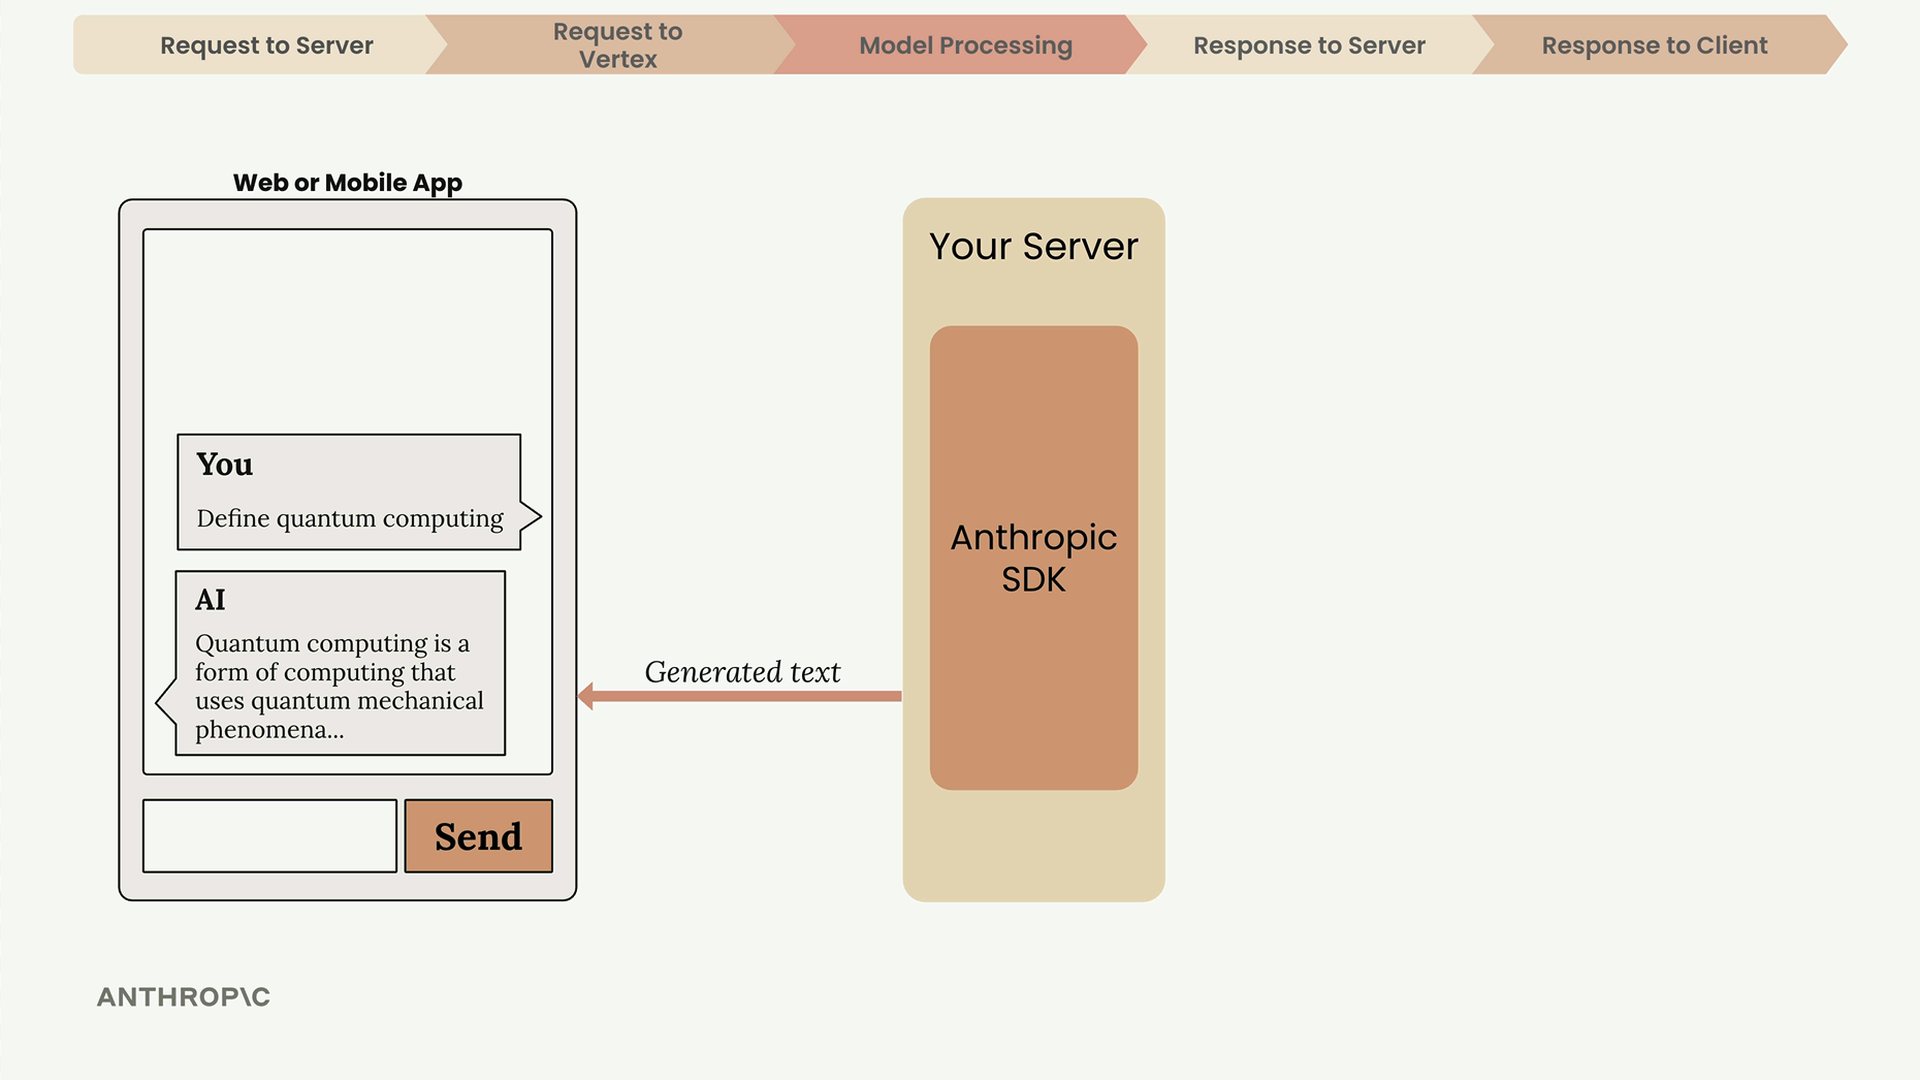
Dein Server leitet den generierten Text dann an deine Client-Anwendung weiter, wo er in der Chat-Oberfläche erscheint.
Das Gesamtbild
Dieser gesamte Prozess - von der Nutzereingabe über Tokenisierung, Embedding, Kontextualisierung, Generierung und zurück zum Nutzer - geschieht in Sekunden. Das Verständnis dieses Ablaufs hilft dir, robustere Anwendungen zu erstellen und Probleme zu beheben, wenn sie auftreten.
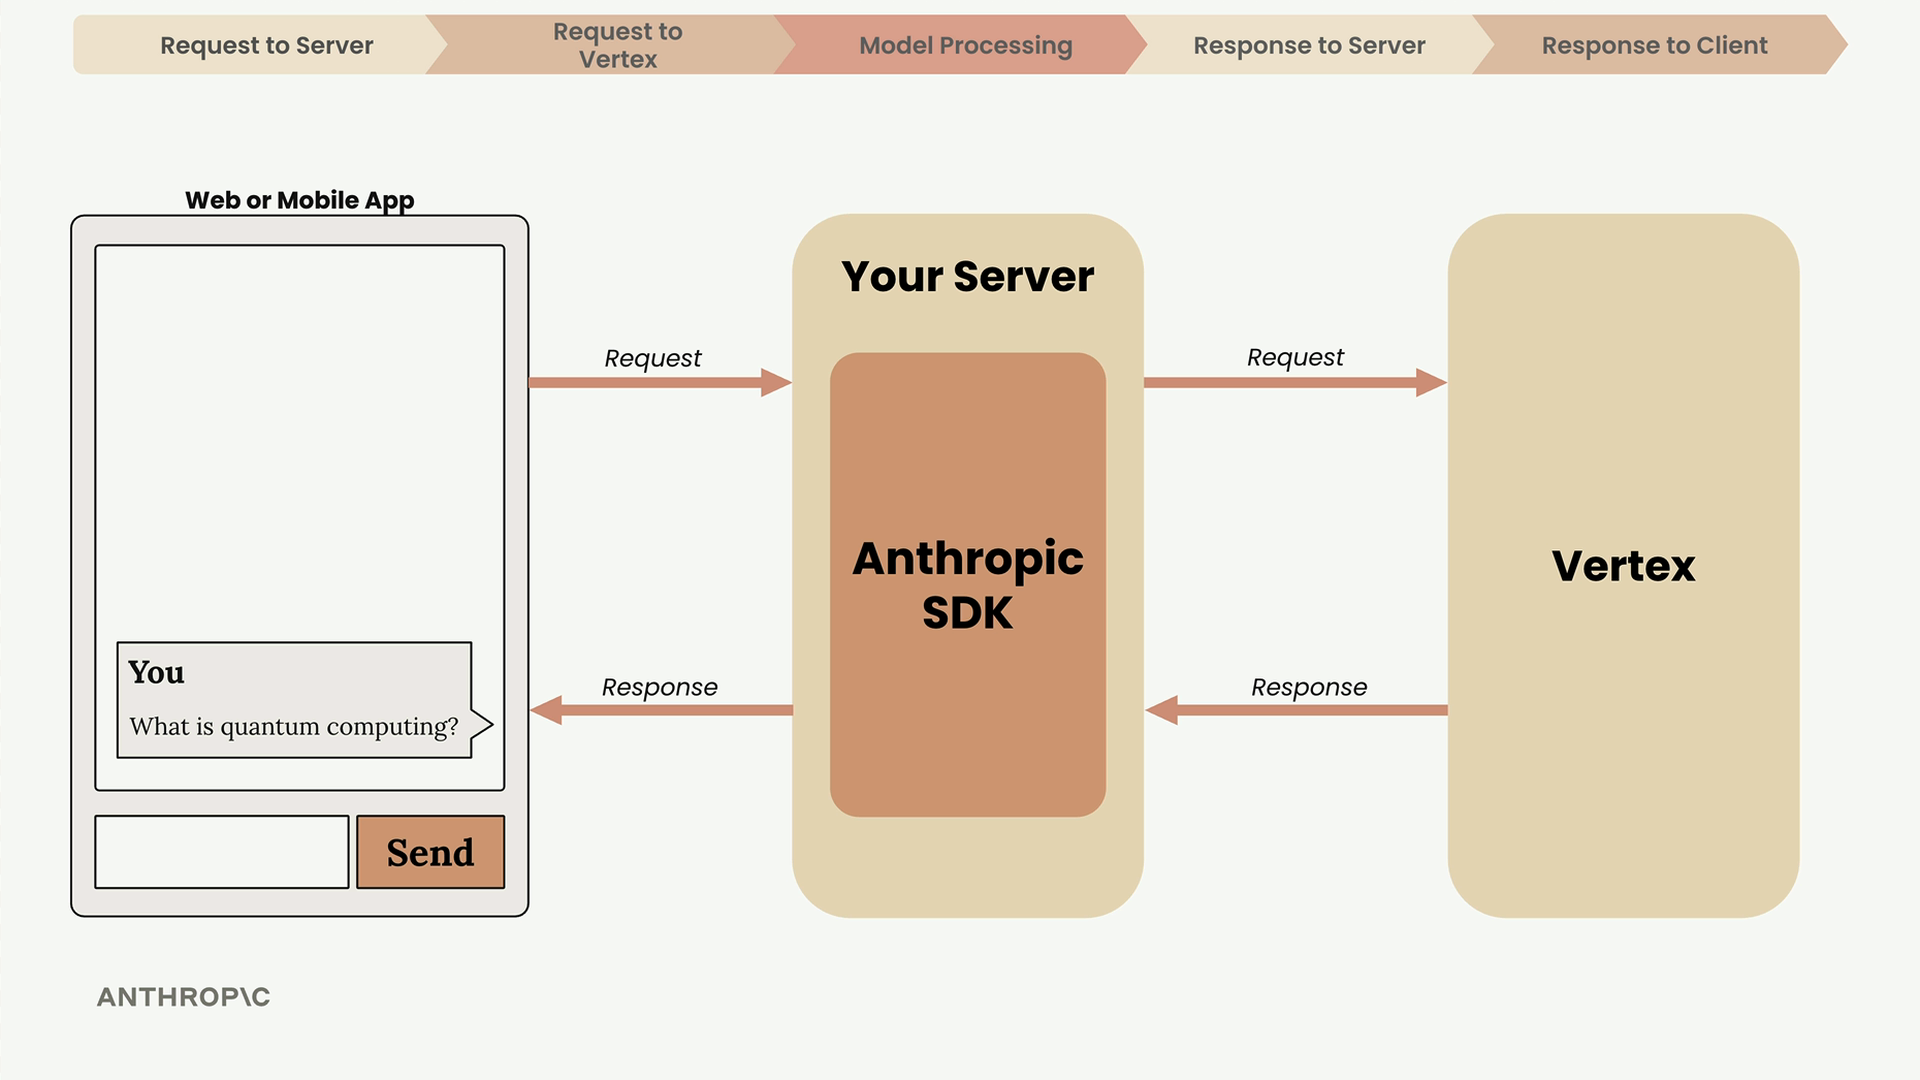
Die wichtigste Erkenntnis: Verwende immer einen Server als Vermittlungsinstanz, verstehe, dass Textgenerierung ein iterativer Prozess ist, und achte auf die Antwort-Metadaten, um die Nutzung zu überwachen und das Modellverhalten zu verstehen.