Beim Aufbau von Prompt-Evaluierungs-Workflows liefern Bewertungssysteme objektive Signale über die Qualität der Ausgabe. Ein Bewerter nimmt eine Modellausgabe entgegen und gibt eine Art messbares Feedback zurück - typischerweise eine Zahl zwischen 1 und 10, wobei 10 hohe Qualität und 1 schlechte Qualität darstellt.
Arten von Bewertern
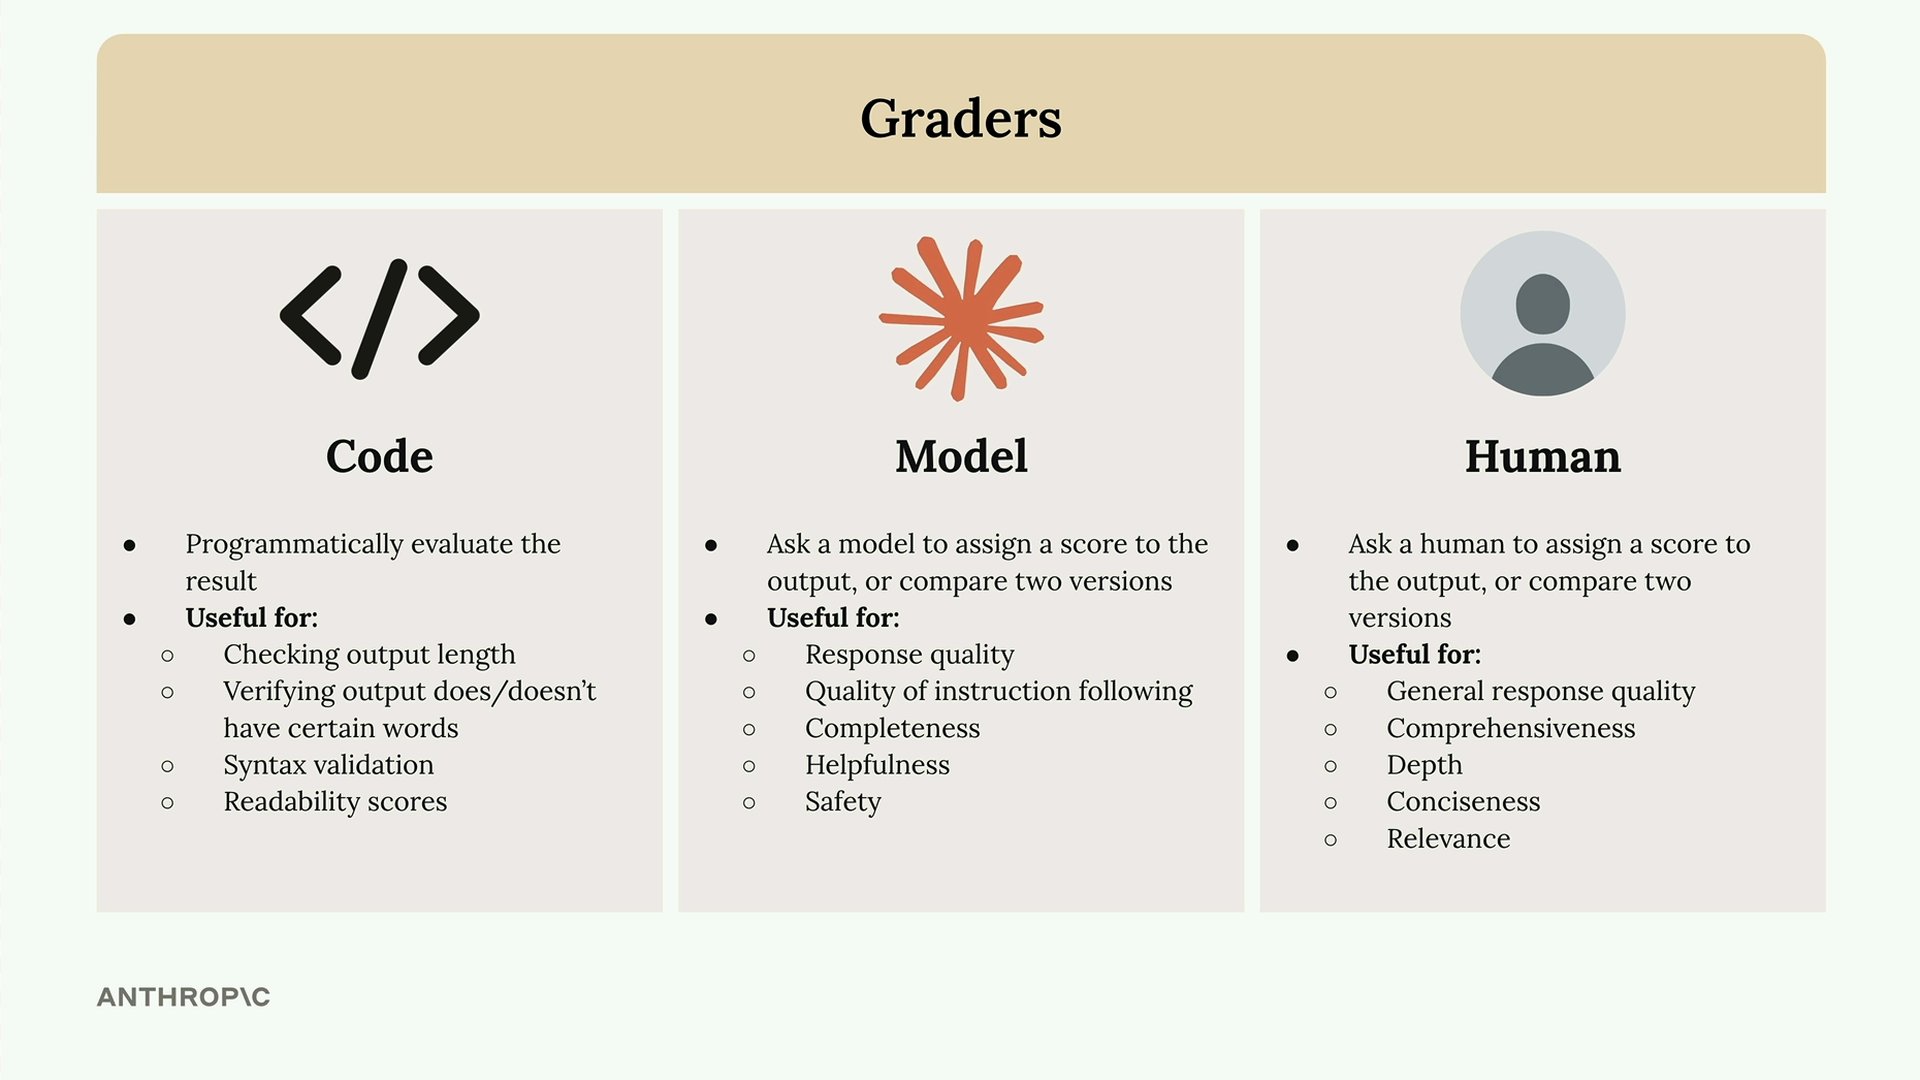
Es gibt drei Hauptansätze zur Bewertung von Modellausgaben:
- Code-Bewerter - Bewerten Ausgaben programmatisch mithilfe von benutzerdefiniertem Code
- Modell-Bewerter - Verwenden ein weiteres KI-Modell zur Qualitätsbeurteilung
- Menschliche Bewerter - Lassen Personen Ausgaben manuell überprüfen und bewerten
Code-Bewerter
Mit Code-Bewertern kannst du jede beliebige programmatische Prüfung implementieren. Häufige Anwendungen sind:
- Überprüfung der Länge der Ausgabe
- Überprüfung, ob die Ausgabe bestimmte Wörter enthält oder nicht
- Syntaxvalidierung für JSON, Python oder Regex
- Lesbarkeitswerte, um ein angemessenes Lese-Niveau sicherzustellen
Modell-Bewerter
Modell-Bewerter bieten enorme Flexibilität, indem sie einen zusätzlichen API-Aufruf zur Bewertung von Ausgaben verwenden. Sie eignen sich zur Beurteilung von:
- Antwortqualität
- Qualität der Befolgung von Anweisungen
- Vollständigkeit
- Hilfsbereitschaft
- Sicherheit
Menschliche Bewerter
Menschliche Bewerter bieten die meiste Flexibilität, haben aber erhebliche Nachteile. Zwar können Menschen Antworten anhand beliebiger Kriterien bewerten, doch der Prozess ist zeitaufwendig und mühsam.
Festlegung von Bewertungskriterien
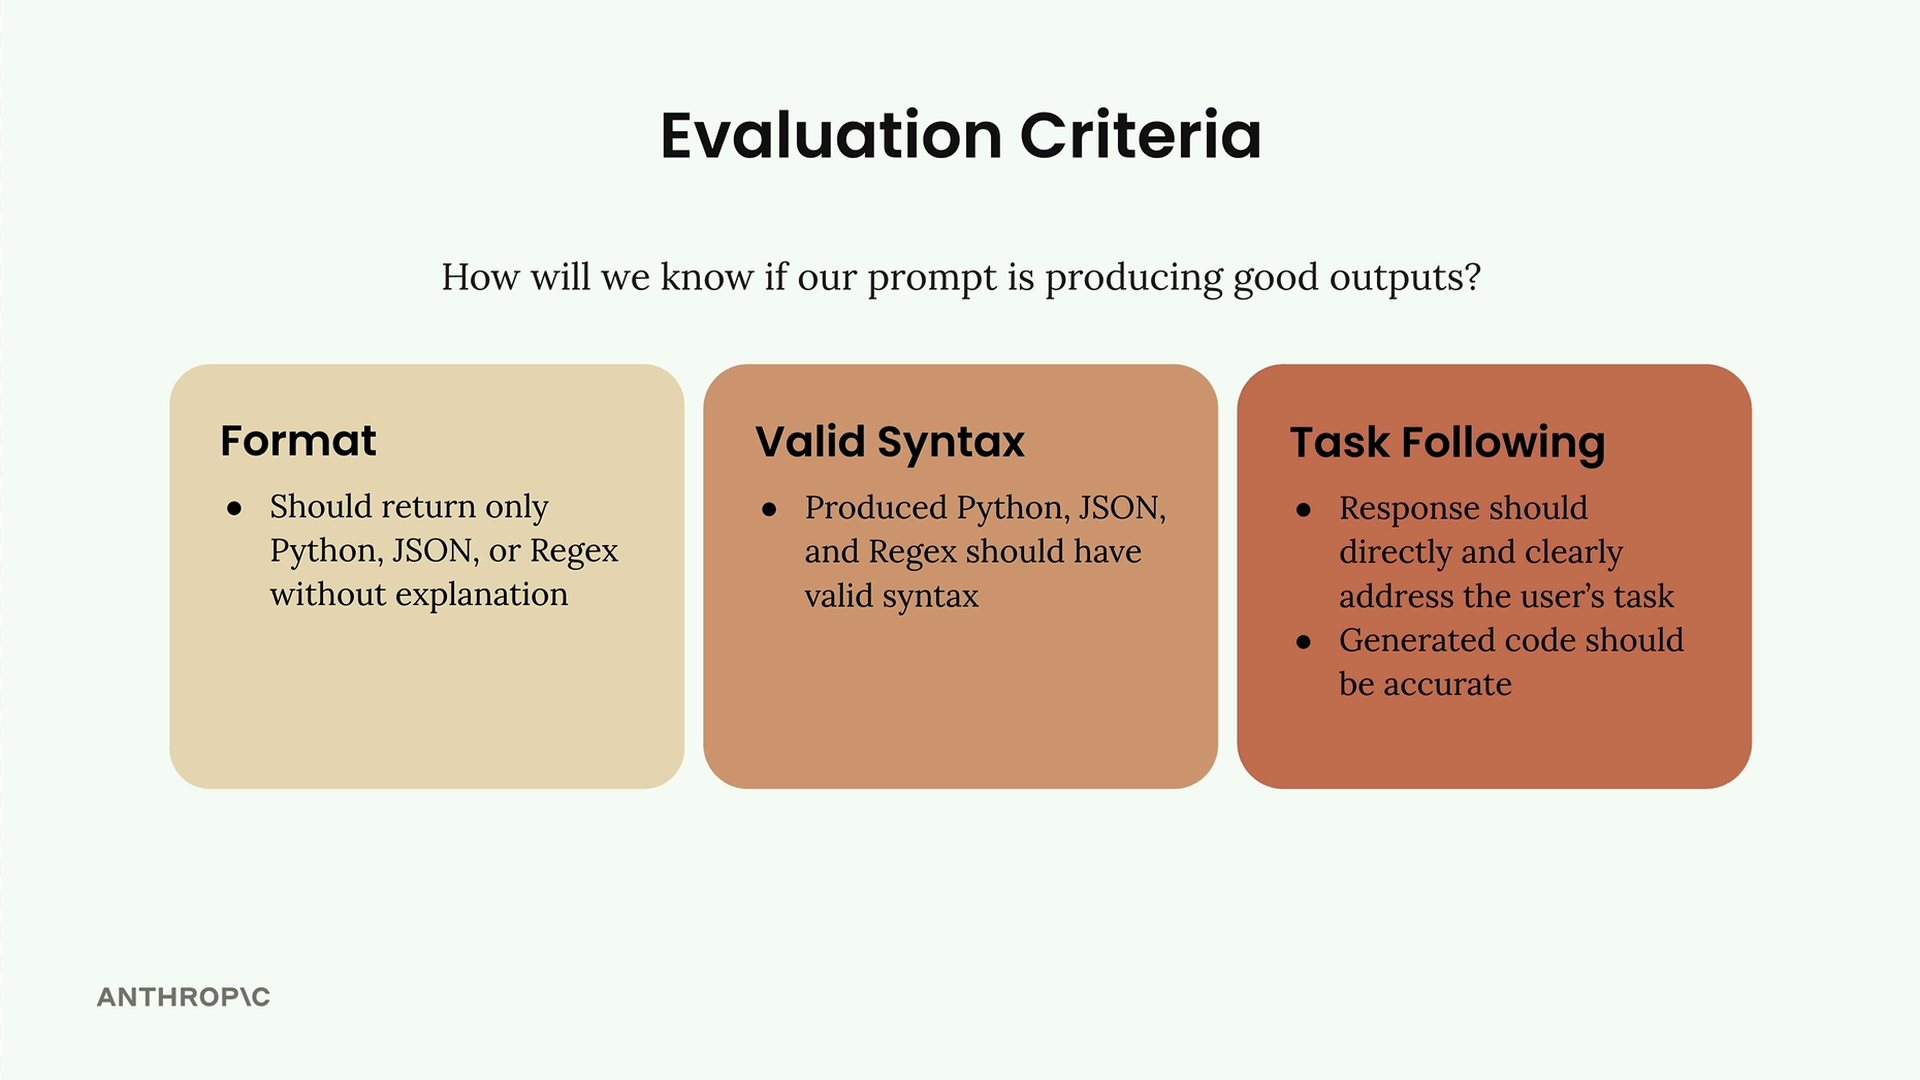
Bevor du einen Bewerter implementierst, benötigst du klare Bewertungskriterien. Für einen Prompt zur Code-Generierung könntest du dich auf Folgendes konzentrieren:
- Format - Sollte nur Python, JSON oder Regex ohne Erklärung zurückgeben
- Gültige Syntax - Der erzeugte Code sollte eine gültige Syntax aufweisen
- Aufgabenbefolgung - Die Antwort sollte die Aufgabe des Nutzers direkt mit korrektem Code erfüllen
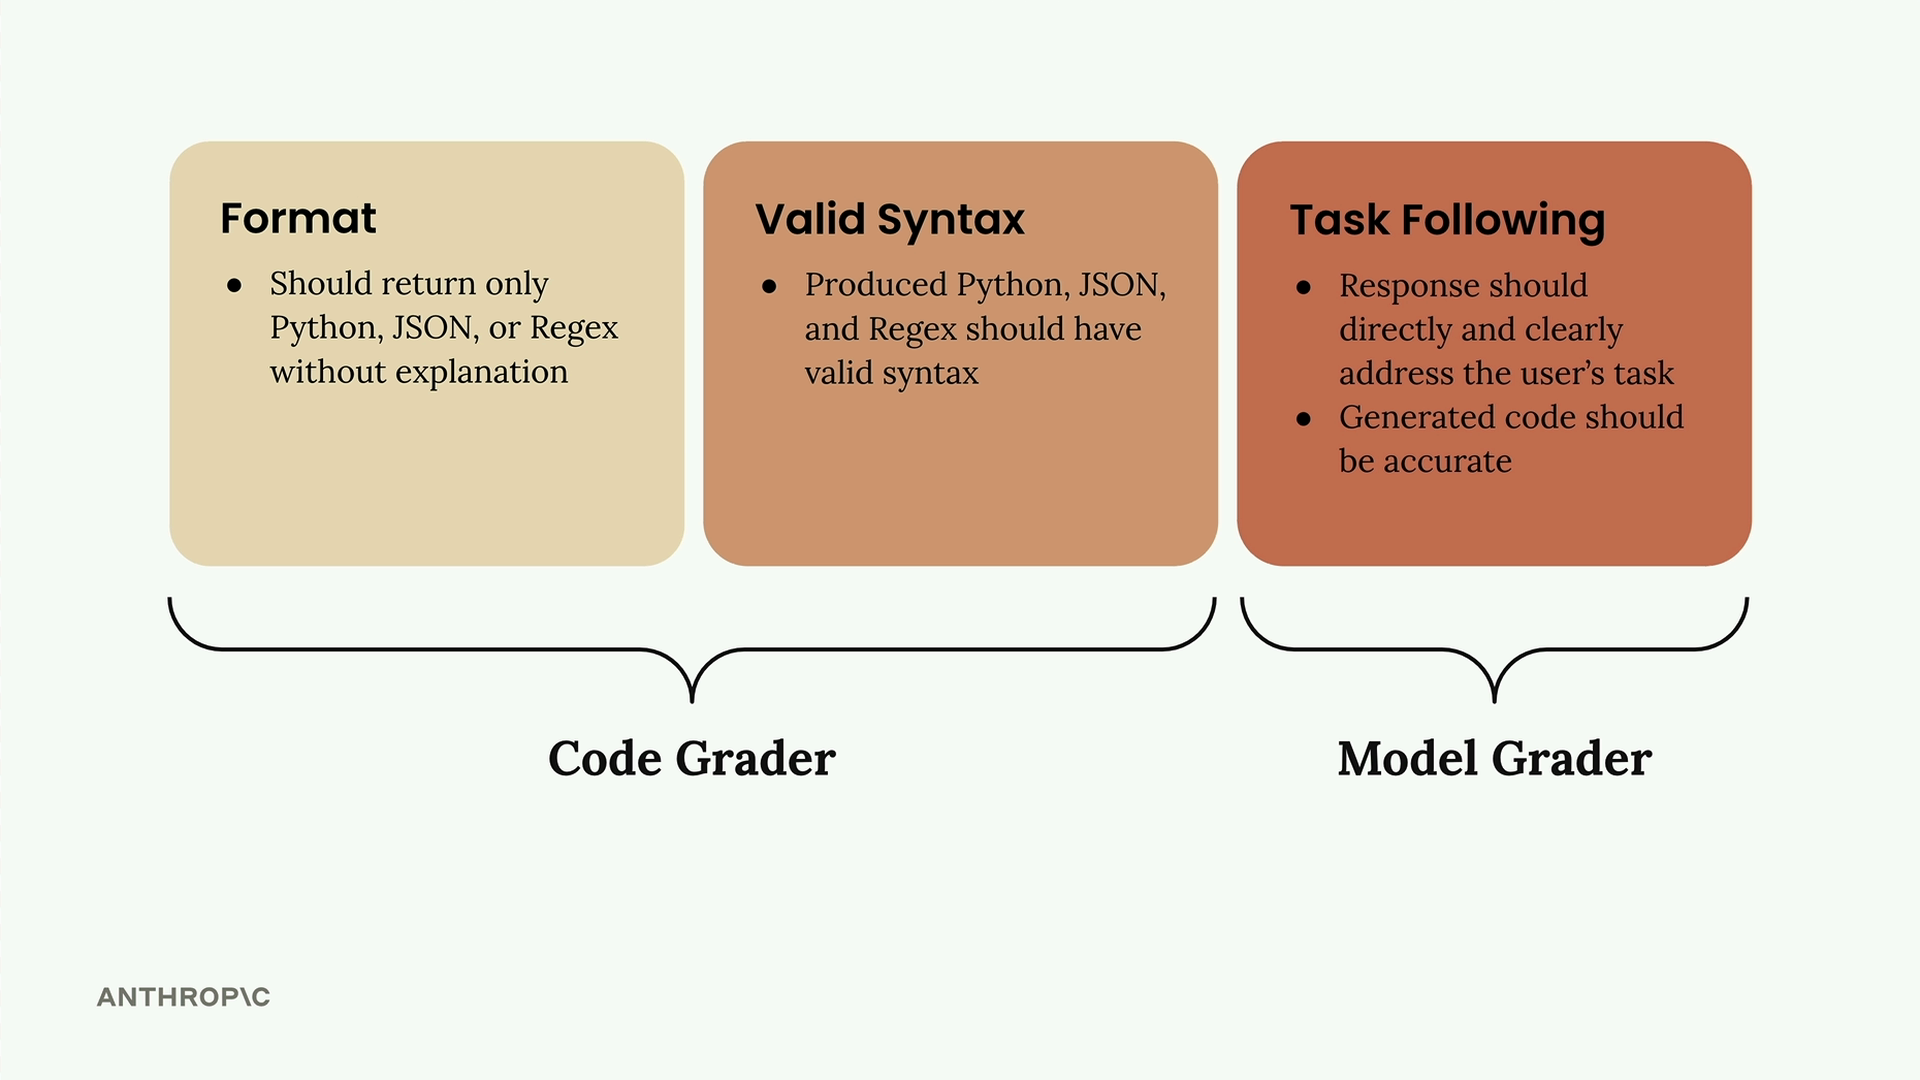
Die ersten beiden Kriterien eignen sich gut für Code-Bewerter, während die Aufgabenbefolgung aufgrund ihrer Flexibilität besser für Modell-Bewerter geeignet ist.
Implementierung eines Modell-Bewerters
Modell-Bewerter sind oft am einfachsten zu implementieren. Hier ist eine grundlegende Struktur:
def grade_by_model(test_case, output):
    eval_prompt = f"""
    You are an expert code reviewer. Evaluate this AI-generated solution.

    Task: {test_case["task"]}
    Solution: {output}

    Provide your evaluation as a structured JSON object with:
    - "strengths": An array of 1-3 key strengths
    - "weaknesses": An array of 1-3 key areas for improvement
    - "reasoning": A concise explanation of your assessment
    - "score": A number between 1-10
    """

    messages = []
    add_user_message(messages, eval_prompt)
    add_assistant_message(messages, "```json")
    eval_text = chat(messages, stop_sequences=["```"])
    return json.loads(eval_text)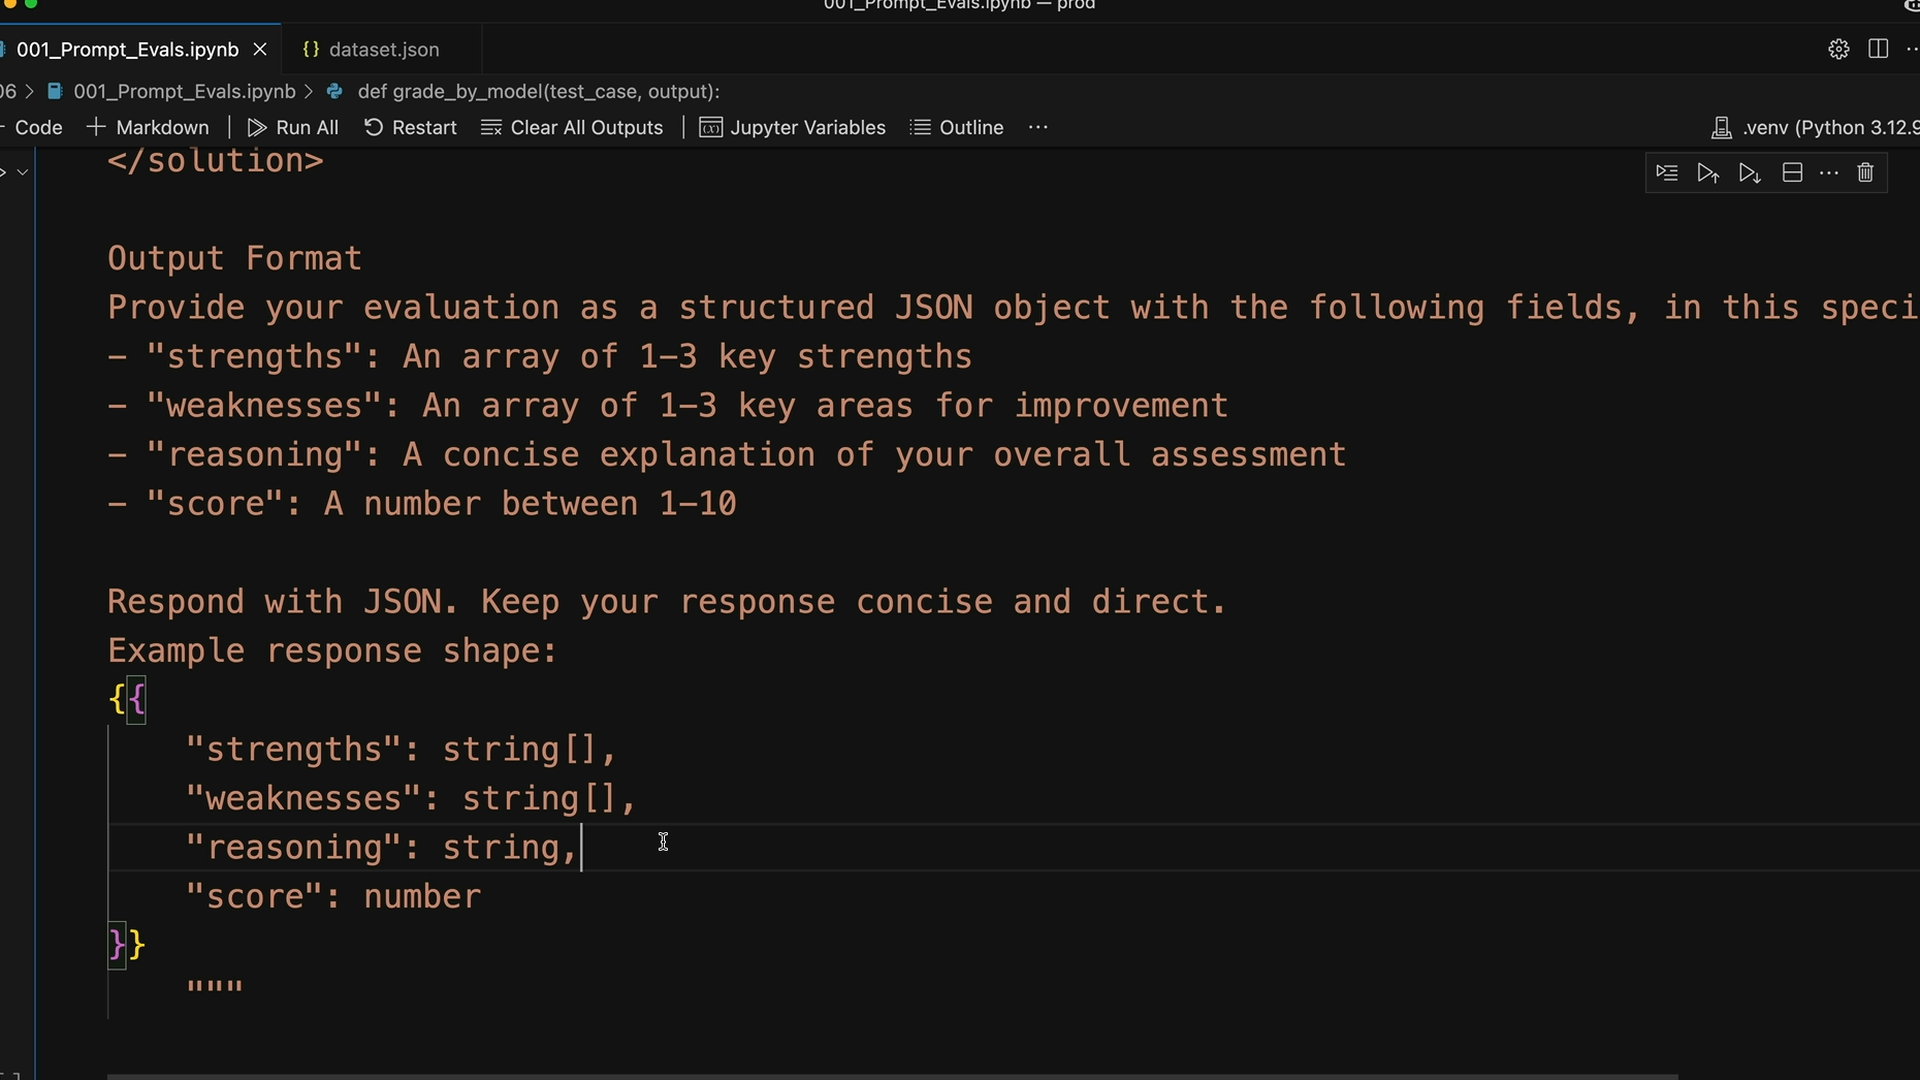
Der Bewertungsprompt sollte umfassend sein und Folgendes enthalten:
- Eine klare Rollendefinition für den Bewerter
- Die ursprüngliche Aufgabe
- Die von der KI generierte Lösung, die bewertet werden soll
- Spezifische Anforderungen an das Ausgabeformat
Frage nach mehr als nur einem Score. Fordere Stärken, Schwächen und Begründungen zusammen mit dem numerischen Score an. Dies verhindert, dass das Modell auf mittelmäßige Scores wie 6 ausweicht, und erzwingt eine durchdachtere Bewertung.
Integration von Bewertern in deinen Workflow
Sobald du eine Bewertungsfunktion hast, integriere sie in deinen Testfall-Runner:
def run_test_case(test_case):
    output = run_prompt(test_case)

    # Rufe den Modell-Grader auf
    model_grade = grade_by_model(test_case, output)
    score = model_grade["score"]
    reasoning = model_grade["reasoning"]

    return {
        "output": output,
        "test_case": test_case,
        "score": score,
        "reasoning": reasoning
    }
Nachdem du alle Testfälle ausgeführt hast, berechne einen durchschnittlichen Score, um eine objektive Kennzahl für die Leistung deines Prompts zu erhalten:
from statistics import mean

def run_eval(dataset):
    results = []
    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    average_score = mean([result["score"] for result in results])
    print(f"Average score: {average_score}")

    return results
Dies gibt dir eine konkrete Zahl, auf deren Verbesserung du dich konzentrieren kannst. Zwar können Modell-Bewerter etwas launisch sein und von besserer Anleitung profitieren, doch sie bieten einen Ausgangspunkt für eine objektive Bewertung, die du iterieren und verbessern kannst.