Der von uns entwickelte hybride Retrieval-Ansatz funktioniert gut, hat aber noch einige Unschärfen. Wenn wir nach „was hat das Engineering-Team mit INC-2023-Q4-011 gemacht?“ suchen, würden wir erwarten, dass der Abschnitt Software Engineering höher eingestuft wird, da er das Engineering-Team und den Vorfall ausdrücklich erwähnt. Der Abschnitt Cybersecurity steht jedoch immer noch an erster Stelle.
Hier kommt Re-Ranking ins Spiel – eine Nachbearbeitungstechnik, die die Genauigkeit des Retrievals deutlich verbessern kann.
So funktioniert Re-Ranking
Re-Ranking fügt einen zusätzlichen Schritt nach deinem hybriden Suchprozess hinzu. Anstatt einfach die zusammengeführten Ergebnisse aus deinem Vektor- und BM25-Index zurückzugeben, leitest du diese Ergebnisse durch ein LLM, um sie intelligent neu anzuordnen.
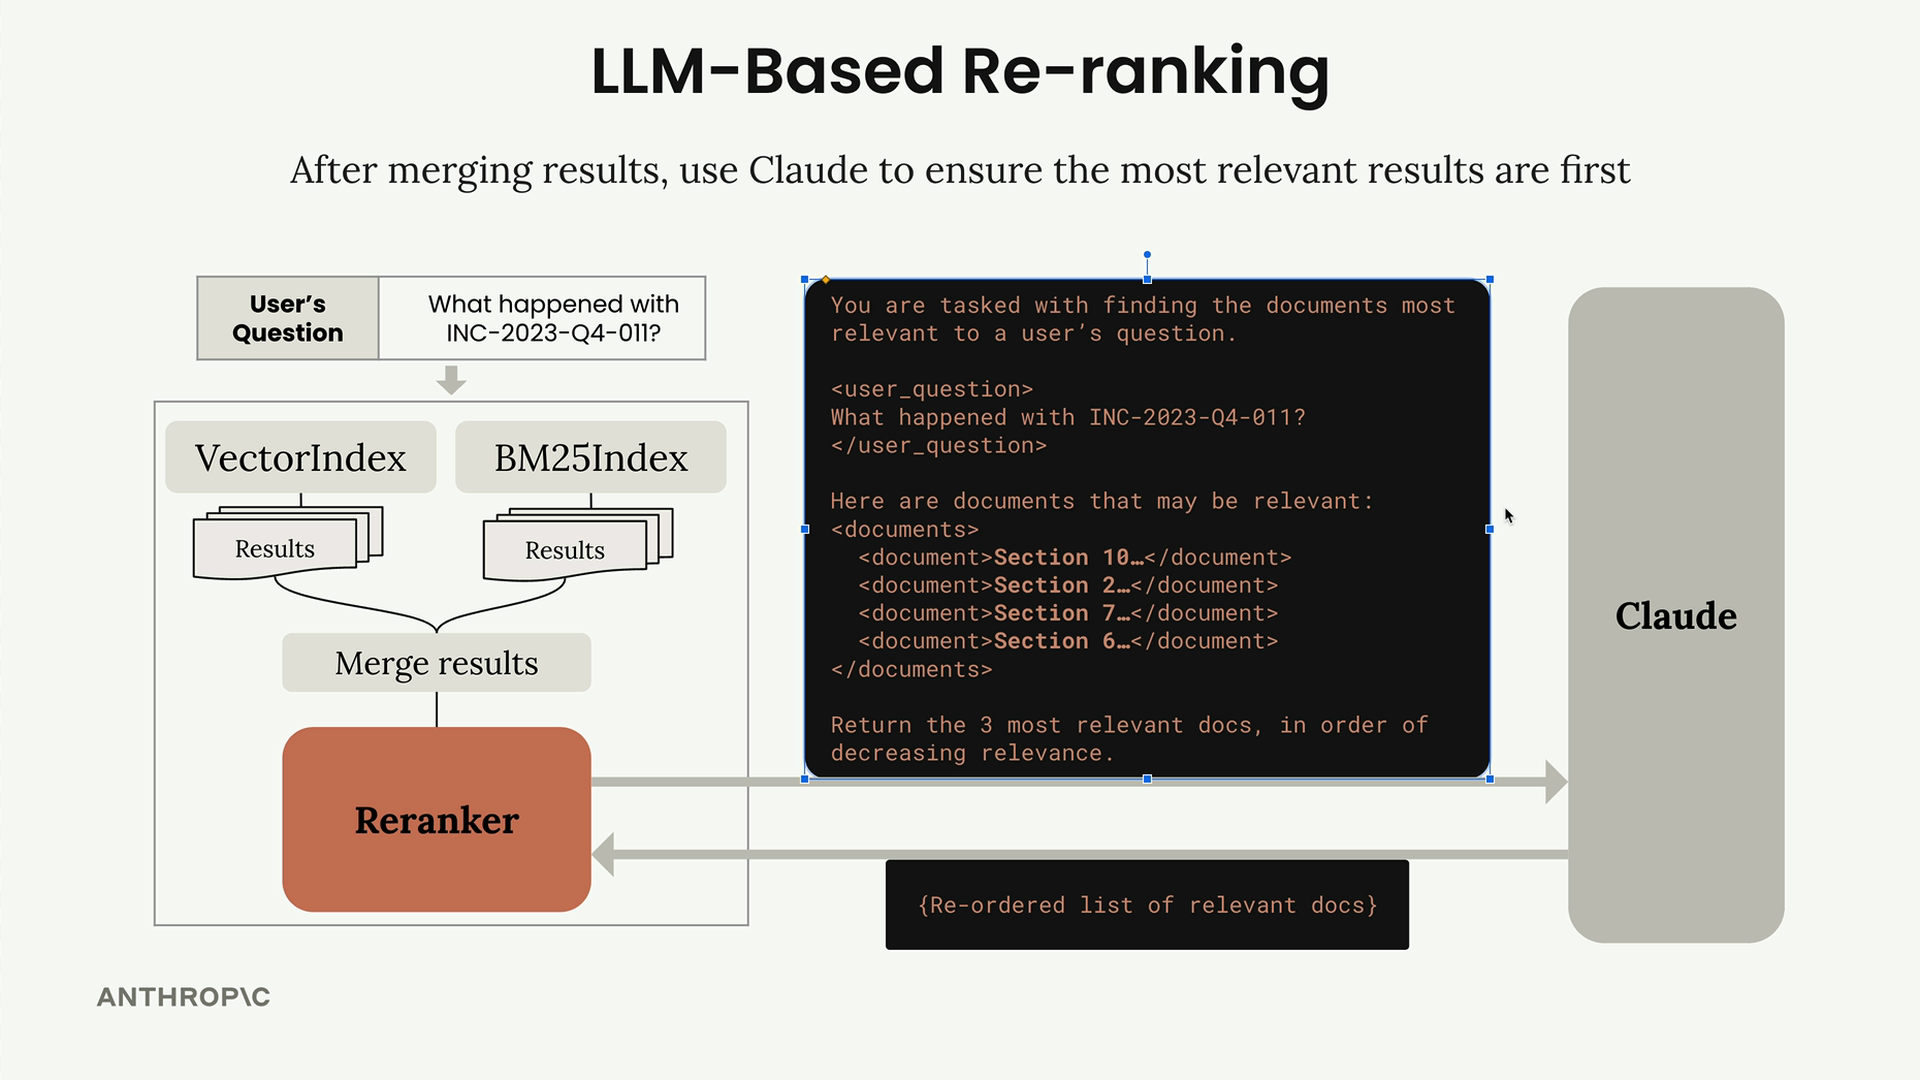
Der Prozess ist unkompliziert:
- Führe deine bestehende Hybridsuche aus (Vektor + BM25)
- Führe die Ergebnisse wie zuvor zusammen
- Sende die zusammengeführten Ergebnisse mit einem Re-Ranking-Prompt an Claude
- Erhalte eine neu geordnete Liste der relevantesten Dokumente zurück
Der Re-Ranking-Prompt
Die Prompt-Struktur ist einfach, aber effektiv. Du gibst Claude die Frage des Nutzers und alle Kandidatendokumente und bittest es anschließend, die relevantesten in absteigender Reihenfolge der Relevanz zurückzugeben.
You are about to be given a set of documents, along with an id of each.
Your task is to select the {k} most relevant documents to answer the user's question.

Here is the user's question:
<question>
{query_text}
</question>

Here are the documents to select from:
<documents>
{joined_docs}
</documents>

Respond in the following format:
```json
{
  "document_ids": str[] # List document ids, {k} elements long, sorted in order of decreasing relevance
}
```Überlegungen zur Effizienz
Eine wichtige Optimierung besteht darin, Dokument-IDs zu verwenden, anstatt Claude zu bitten, vollständige Textabschnitte zurückzugeben. Wenn du Claude bitten würdest, den vollständigen Text jedes relevanten Dokuments zurückzugeben, würdest du Zeit damit verschwenden, darauf zu warten, dass es große Textmengen kopiert.
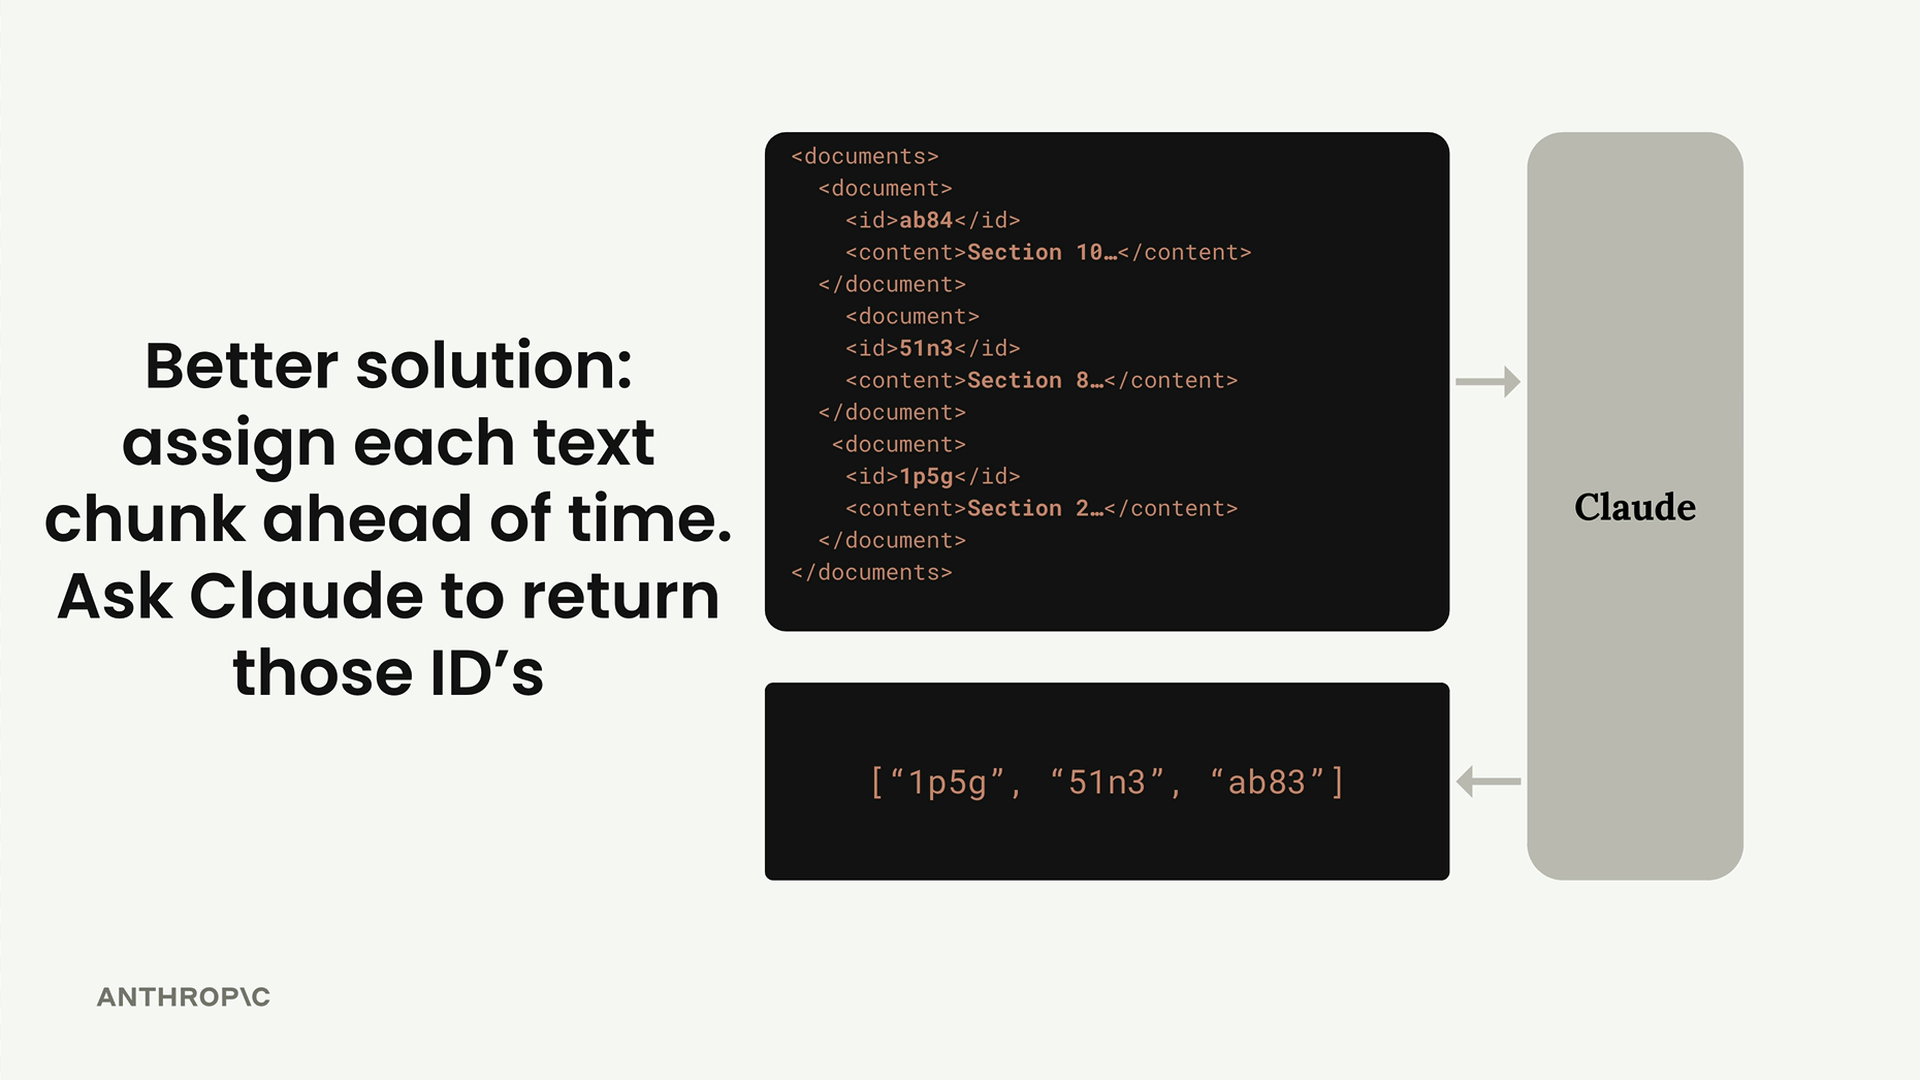
Weise stattdessen jedem Textabschnitt im Voraus eine eindeutige ID zu und bitte Claude dann, nur diese IDs in der bevorzugten Reihenfolge zurückzugeben. Dadurch wird der Re-Ranking-Prozess deutlich schneller, während du dennoch die benötigten neu geordneten Ergebnisse erhältst.
Implementierung
Die Re-Ranker-Funktion wird automatisch aufgerufen, nachdem deine anfängliche Hybridsuche abgeschlossen ist. Hier ist die grundlegende Struktur:
def reranker_fn(docs, query_text, k):
    joined_docs = "\n".join([
        f"""
        <document>
        <document_id>{doc["id"]}</document_id>
        <document_content>{doc["content"]}</document_content>
        </document>
        """
        for doc in docs
    ])

    # Prompt mit Nutzerfrage und Dokumenten erstellen
    # An Claude mit JSON-Antwortformat senden
    # Neu sortierte Dokument-IDs parsen und zurückgeben
Du kannst dies in deinen Retriever integrieren, indem du die Re-Ranker-Funktion als Parameter übergibst:
retriever = Retriever(bm25_index, vector_index, reranker_fn=reranker_fn)Ergebnisse
Der Re-Ranking-Ansatz zeigt deutliche Verbesserungen. Beim Testen der Anfrage „was hat das Engineering-Team mit INC-2023-Q4-011 gemacht?“ erscheint der Abschnitt Software Engineering nun korrekt an erster Stelle, noch vor dem Abschnitt Cybersecurity. Claude hat erfolgreich erkannt, dass der Nutzer gezielt nach der Beteiligung des Engineering-Teams an dem Vorfall gefragt hat.
Kompromisse
Re-Ranking bringt Kompromisse mit sich, die du berücksichtigen solltest:
- Erhöhte Latenz: Du musst jetzt warten, bis ein zusätzlicher LLM-Aufruf abgeschlossen ist
- Verbesserte Genauigkeit: Das LLM kann Kontext und Absicht besser verstehen als reine Ähnlichkeitswerte
- Kostenüberlegungen: Jede Suche erfordert jetzt einen LLM-API-Aufruf
Für viele Anwendungen rechtfertigt die Verbesserung der Genauigkeit die zusätzliche Latenz und Kosten, insbesondere wenn präzises Retrieval für deinen Anwendungsfall entscheidend ist.