Beim Aufbau einer RAG-Pipeline wirst du schnell feststellen, dass semantische Suche allein nicht immer die besten Ergebnisse liefert. Manchmal benötigst du exakte Begriffsübereinstimmungen, die semantische Suche möglicherweise übersieht. Die Lösung besteht darin, semantische Suche mit lexikalischer Suche zu kombinieren, indem du eine Technik namens BM25 verwendest.
Das Problem mit semantischer Suche allein
Angenommen, du suchst in einem Dokument nach einer bestimmten Vorfall-ID wie „INC-2023-Q4-011“. Obwohl dieser exakte Begriff mehrfach in relevanten Abschnitten vorkommt, könnte die semantische Suche nicht zusammenhängende Abschnitte zurückgeben, die semantisch ähnlich sind, aber den spezifischen gesuchten Begriff tatsächlich nicht enthalten.
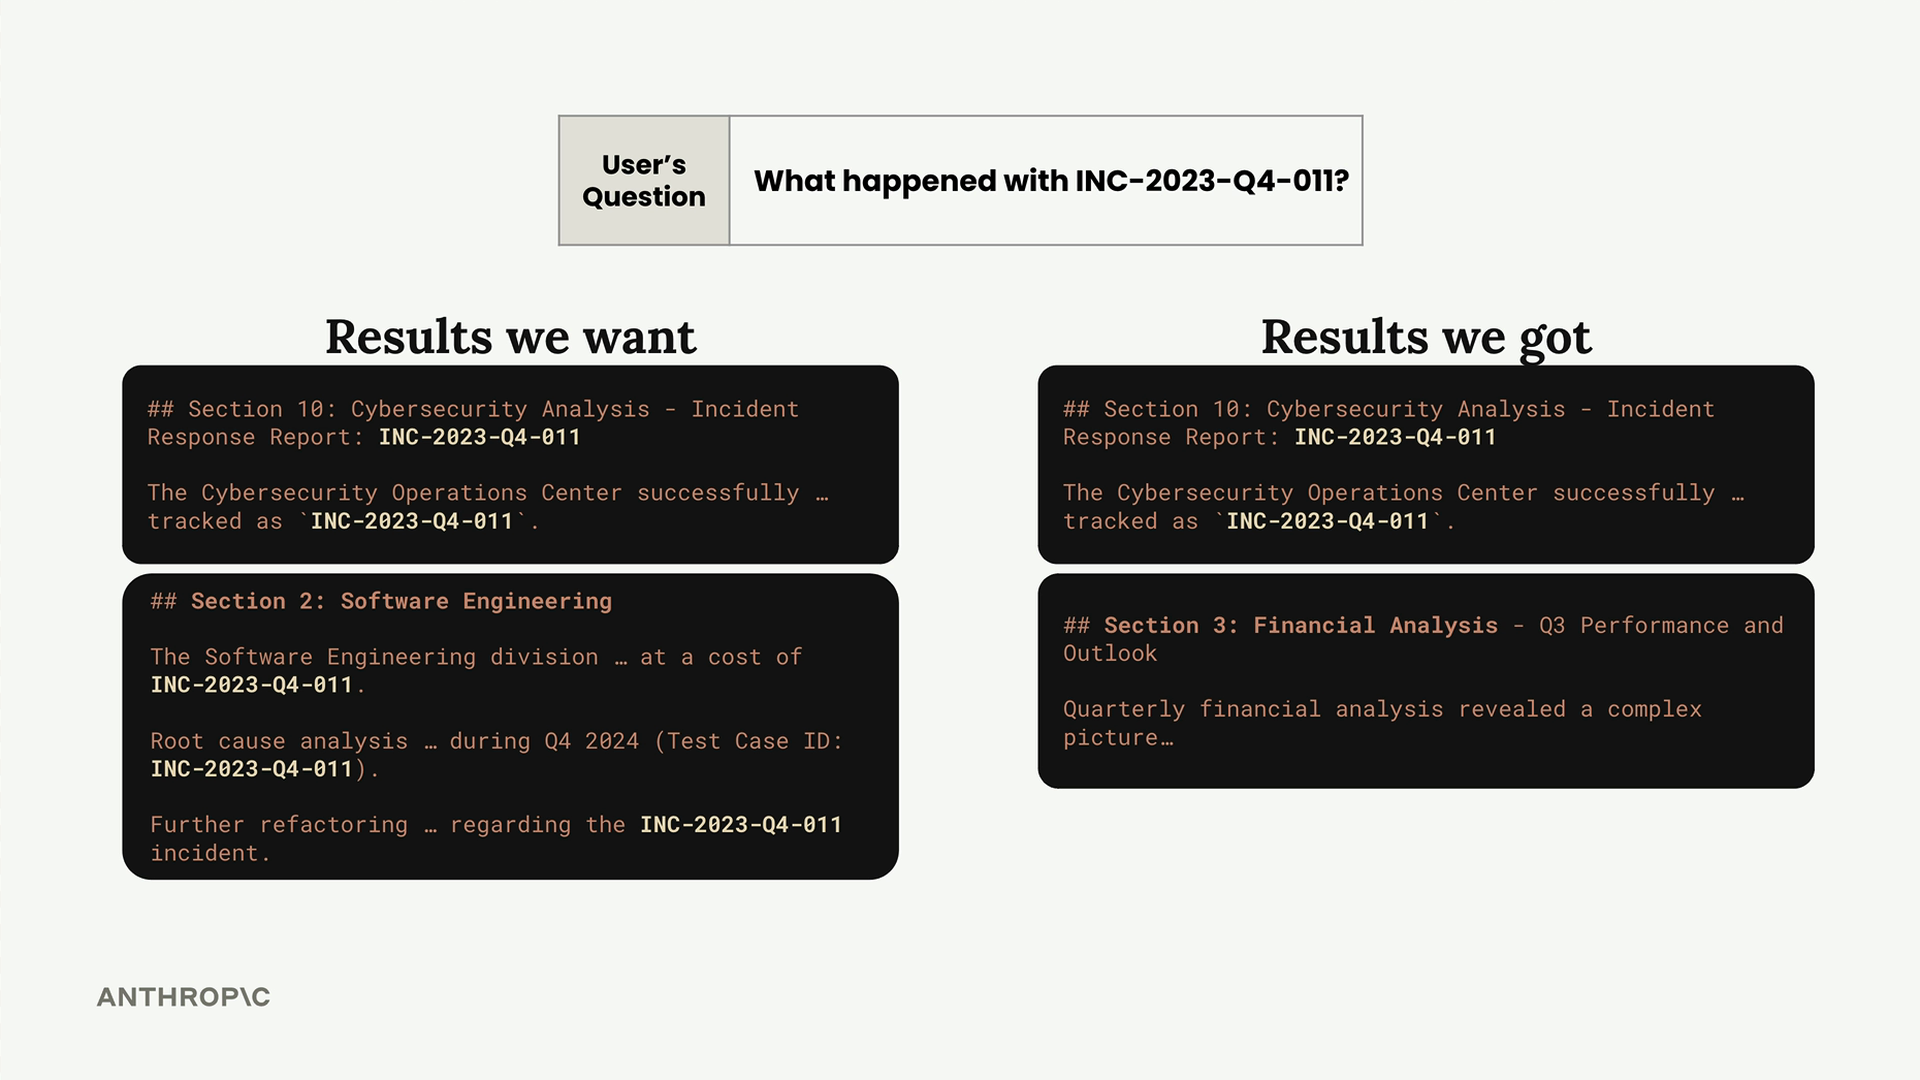
Dies geschieht, weil sich semantische Suche auf Bedeutung statt auf exakte Übereinstimmungen konzentriert. Wenn du präzises Begriffsmatching benötigst, brauchst du einen anderen Ansatz.
Hybride Suchstrategie
Die Lösung besteht darin, zwei Suchen parallel auszuführen und die Ergebnisse zusammenzuführen:
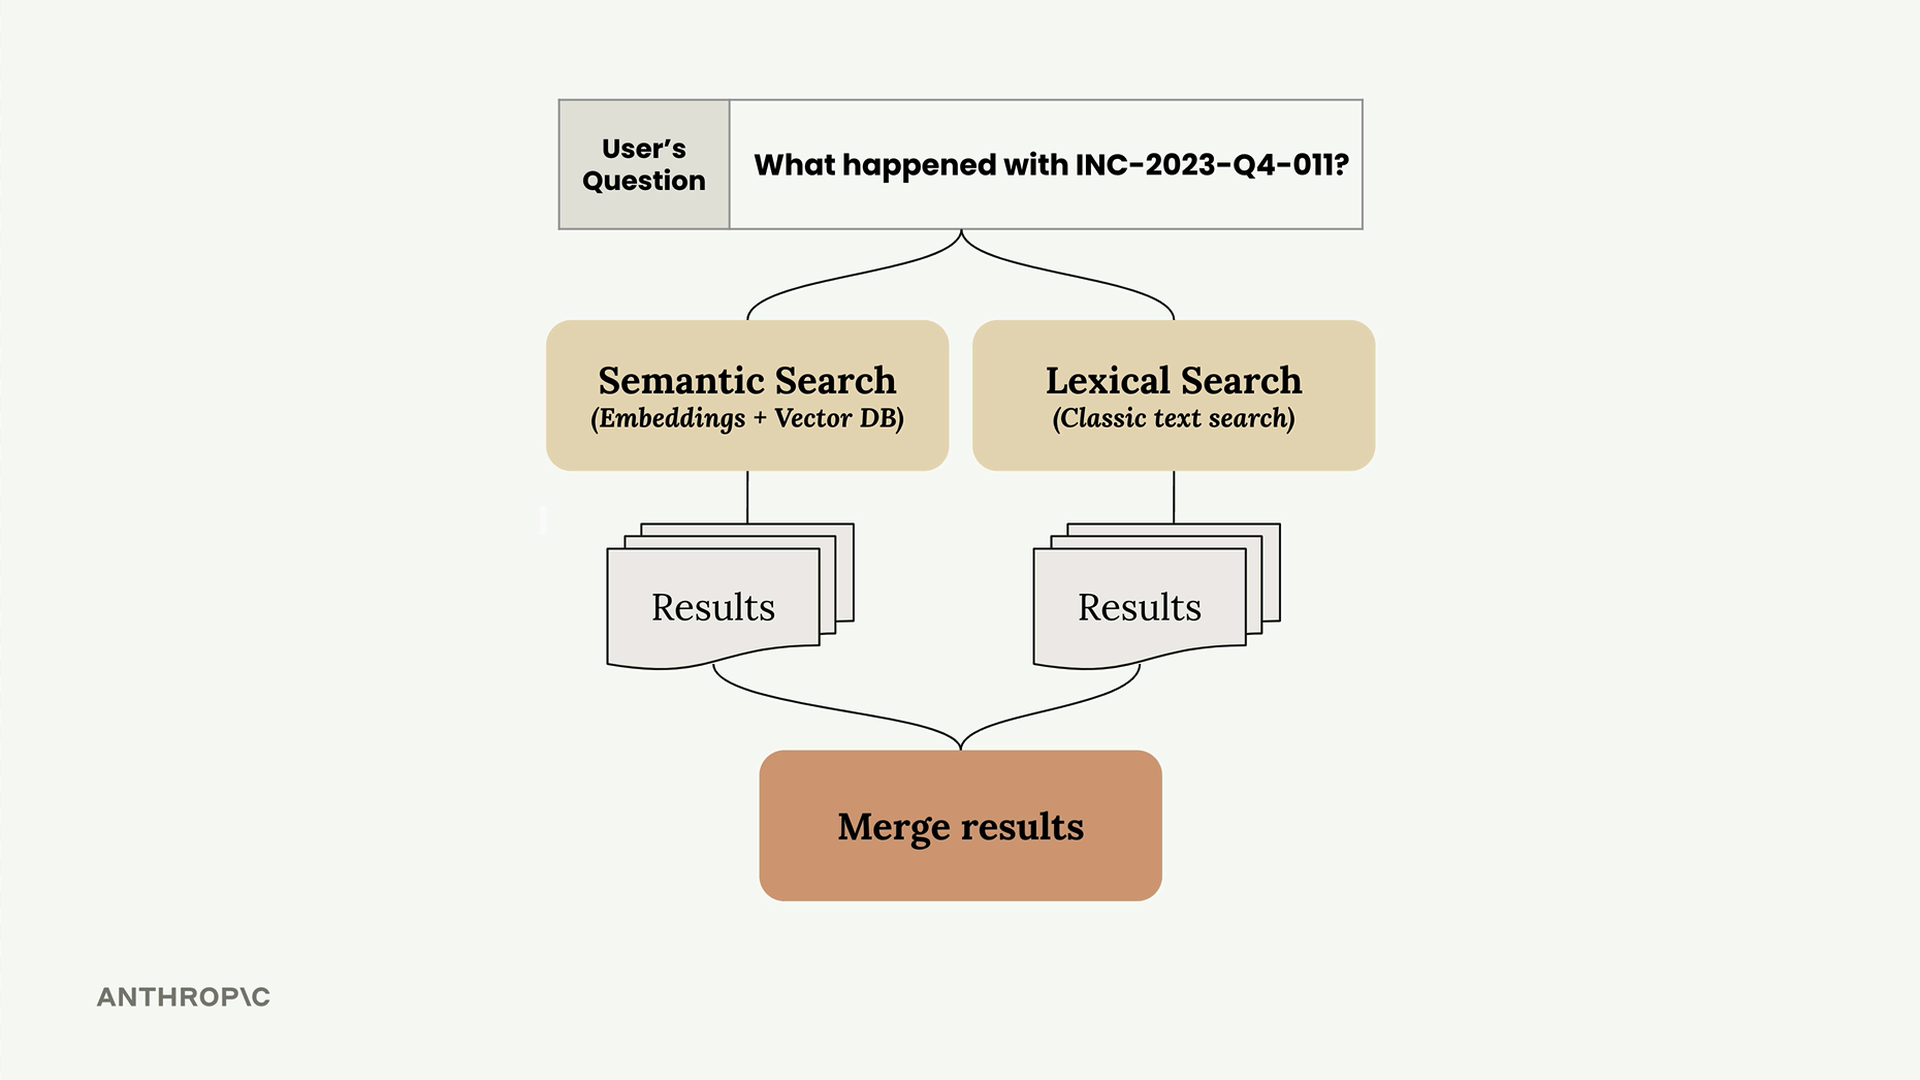
- Semantische Suche - Nutzt Embeddings und Vektordatenbanken für bedeutungsbasiertes Matching
- Lexikalische Suche - Nutzt klassische Textsuche für exaktes Begriffsmatching
- Ergebnisse zusammenführen - Kombiniert beide Ergebnismengen für bessere Abdeckung
Wie BM25 funktioniert
BM25 (Best Match 25) ist ein beliebter Algorithmus für lexikalische Suche in RAG-Pipelines. So verarbeitet er eine Suchanfrage:
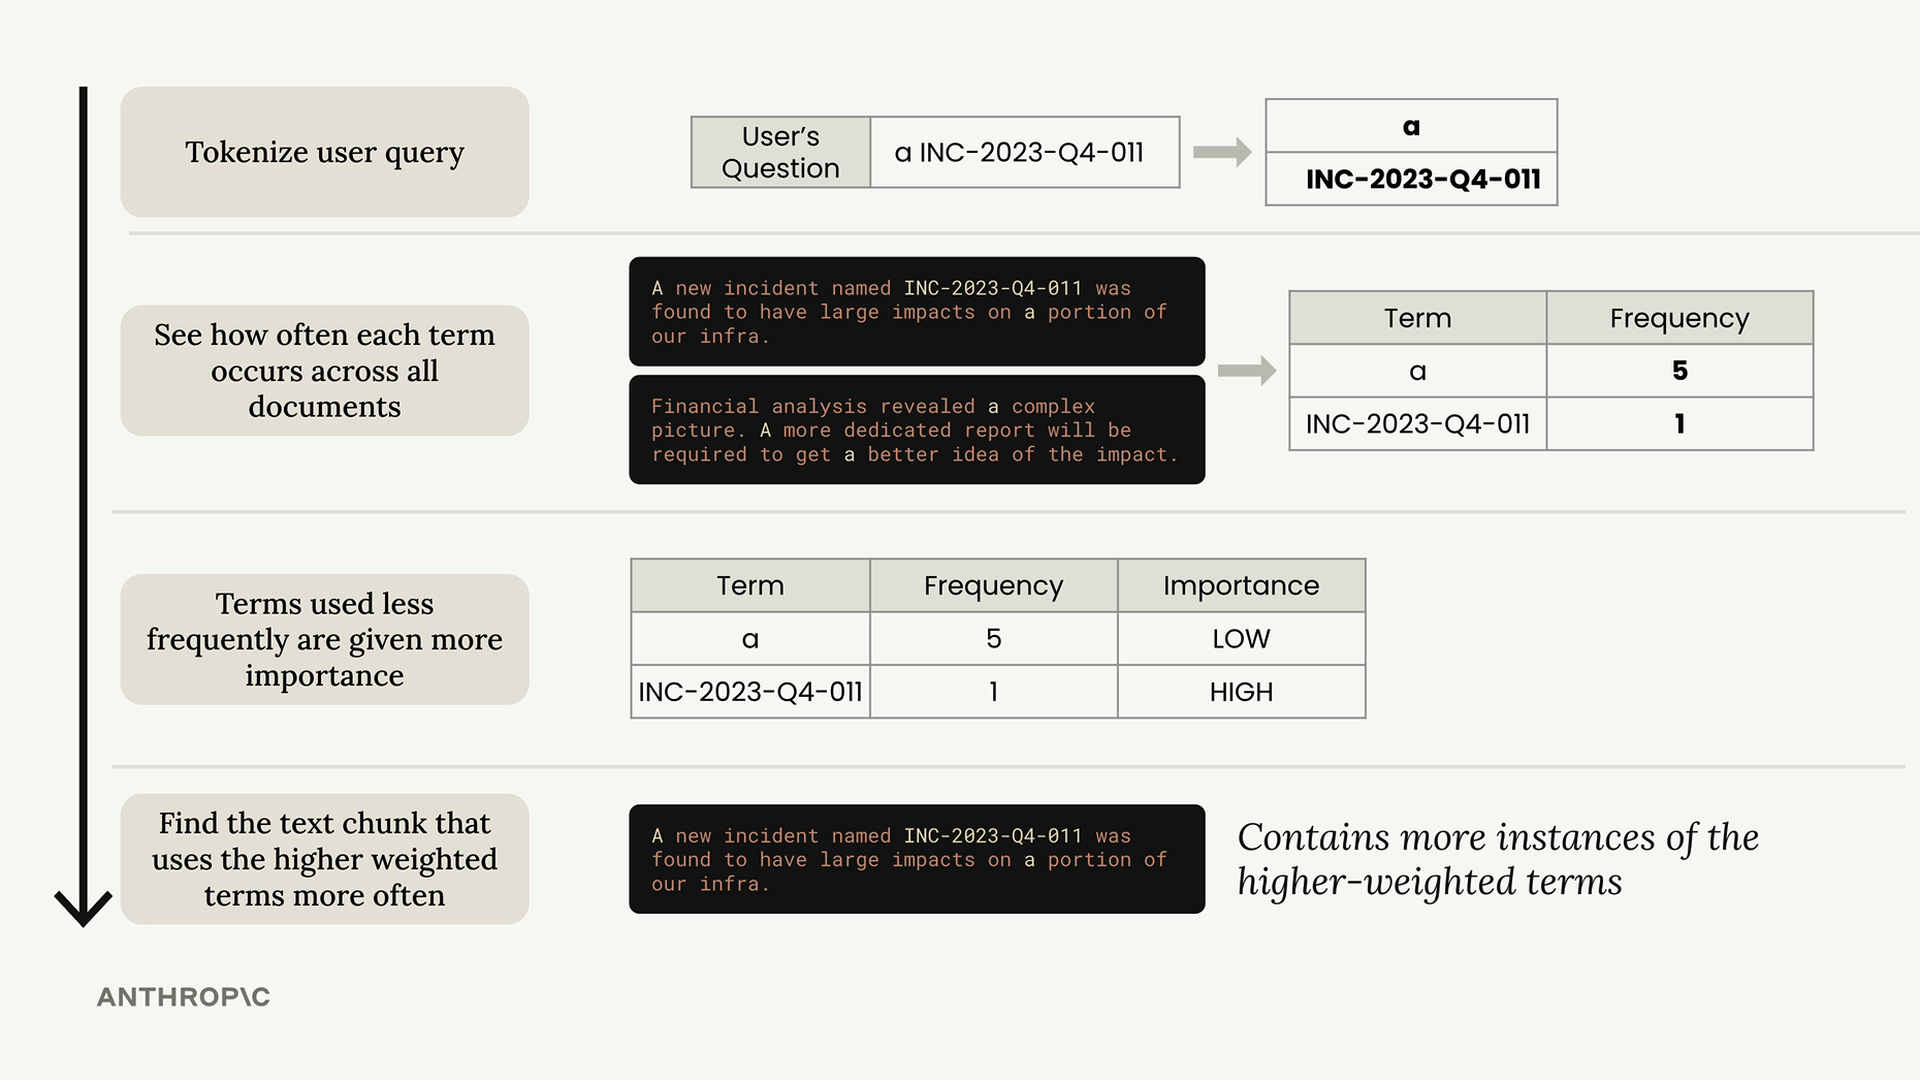
Der Algorithmus folgt diesen zentralen Schritten:
- Anfrage tokenisieren - Die Frage des Nutzers in einzelne Begriffe zerlegen
- Begriffshäufigkeit zählen - Prüfen, wie oft jeder Begriff in allen Dokumenten vorkommt
- Begriffe nach Seltenheit gewichten - Seltener verwendete Begriffe erhalten höhere Wichtigkeitswerte
- Beste Übereinstimmungen finden - Chunks zurückgeben, die mehr Vorkommen der höher gewichteten Begriffe enthalten
Die zentrale Erkenntnis ist, dass seltene Begriffe wie „INC-2023-Q4-011“ für die Suche weitaus wichtiger sind als gängige Wörter wie „a“ oder „the“.
Implementierung der BM25-Suche
So richtest du ein BM25-Suchsystem ein:
# Erstelle einen BM25-Store
store = BM25Index()

# Füge dem Store Dokumente hinzu
for chunk in chunks:
    store.add_document({"content": chunk})

# Durchsuche den Store
results = store.search("What happened with INC-2023-Q4-011?", 3)
Die BM25-Implementierung bietet dieselbe API wie dein semantisches Suchsystem - beide verfügen über die Methoden add_document() und search(), wodurch sie sich leicht zusammen nutzen lassen.
Bessere Suchergebnisse
Wenn du dieselbe Anfrage, die mit semantischer Suche allein fehlschlug, durch BM25 laufen lässt, erhältst du wesentlich bessere Ergebnisse. Anstatt irrelevante Abschnitte zurückzugeben, priorisiert BM25 die Abschnitte, die tatsächlich deine spezifischen Suchbegriffe enthalten.
Der Algorithmus erkennt korrekt, dass „INC-2023-Q4-011“ ein seltener, wichtiger Begriff ist, und stuft Dokumente, die ihn enthalten, deutlich höher ein als Dokumente mit nur gängigen Wörtern aus der Anfrage.
Nächste Schritte
Da du nun sowohl semantische als auch lexikalische Suchsysteme unabhängig voneinander funktionierend hast, besteht der nächste Schritt darin, ihre Ergebnisse zusammenzuführen. Dieser hybride Ansatz bietet dir das Beste aus beiden Welten - das kontextuelle Verständnis der semantischen Suche kombiniert mit der Präzision des exakten Begriffsmatchings der lexikalischen Suche.
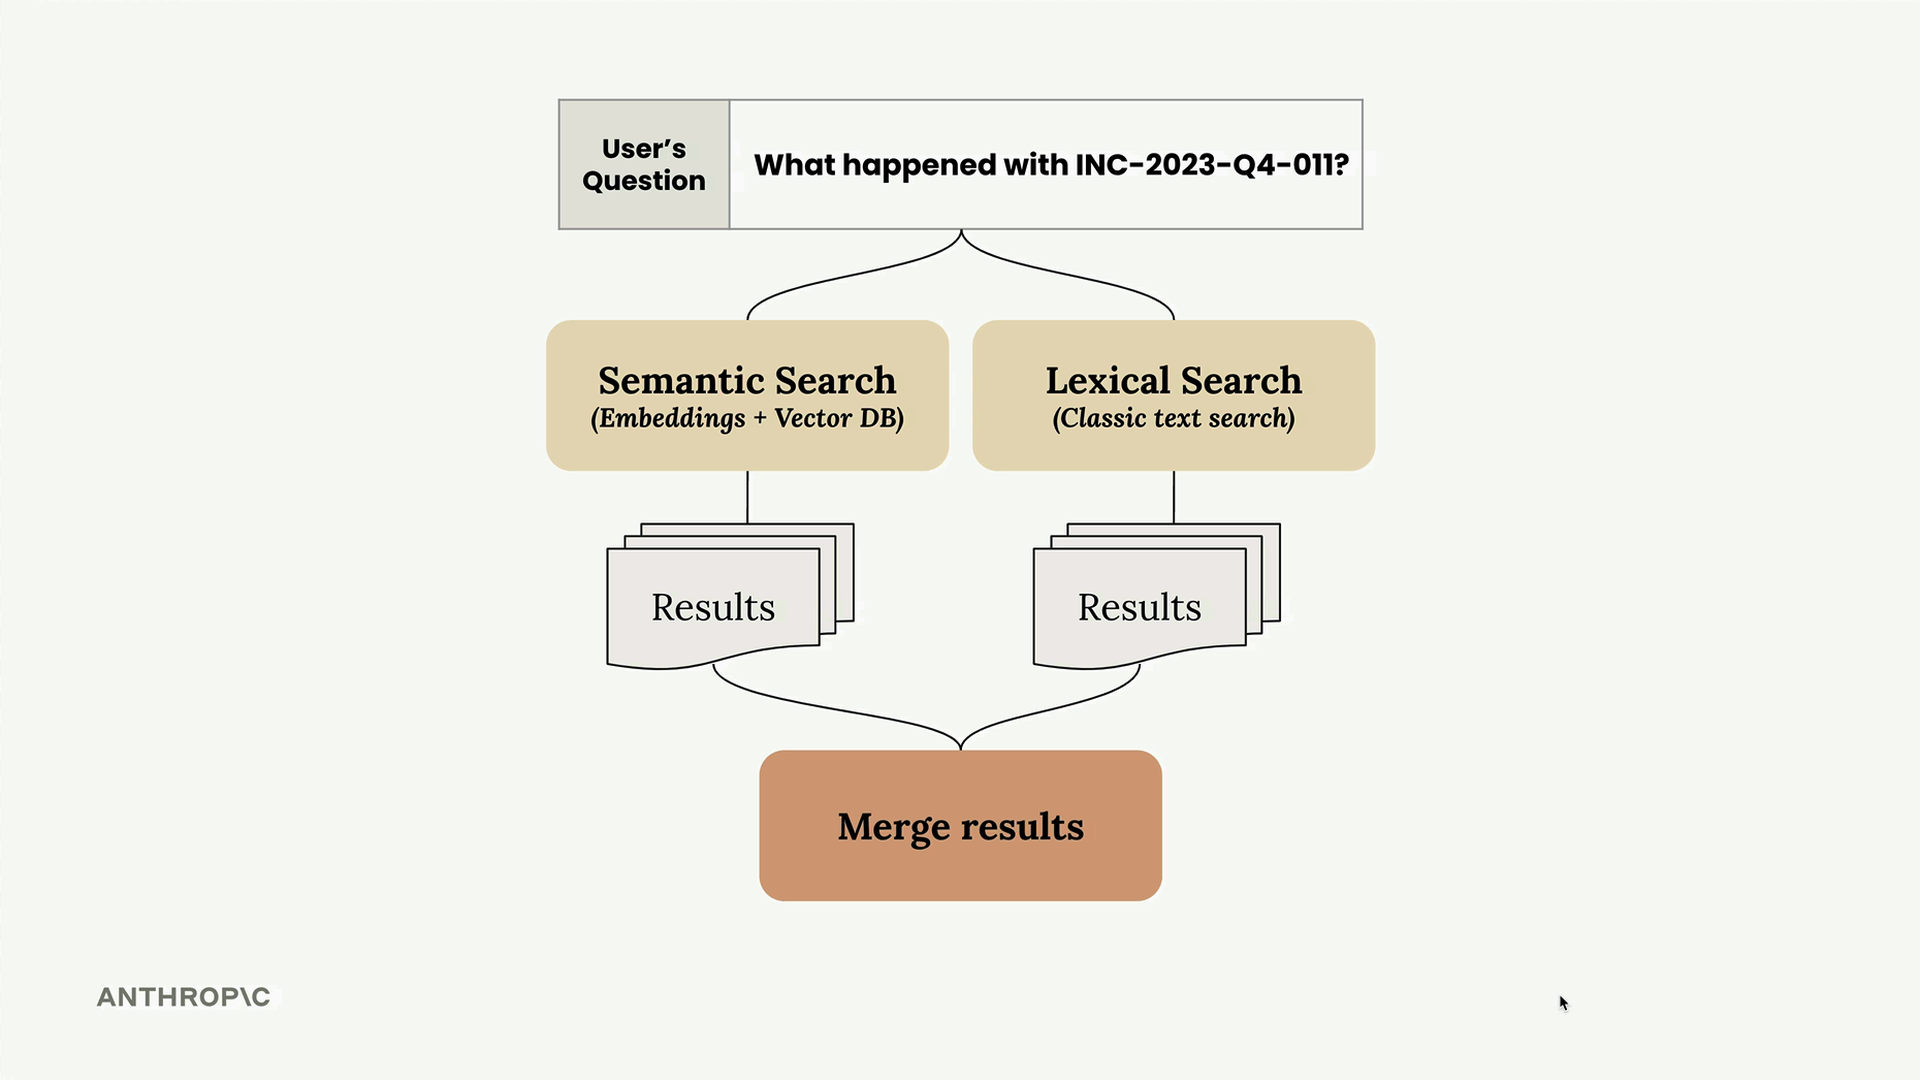
Beide Suchsysteme nutzen ähnliche APIs, wodurch es unkompliziert ist, beide parallel abzufragen und ihre Ergebnisse zu einer einzigen, umfassenderen Ergebnismenge zu kombinieren.