Nachdem du Text-Chunks aus einem Dokument extrahiert hast, besteht der nächste Schritt in einer RAG-Pipeline darin, herauszufinden, welche Chunks für die Frage eines Nutzers am relevantesten sind. Dies ist im Wesentlichen ein Suchproblem – du musst alle deine Chunks durchsuchen und diejenigen identifizieren, die sich auf das beziehen, wonach der Nutzer fragt.
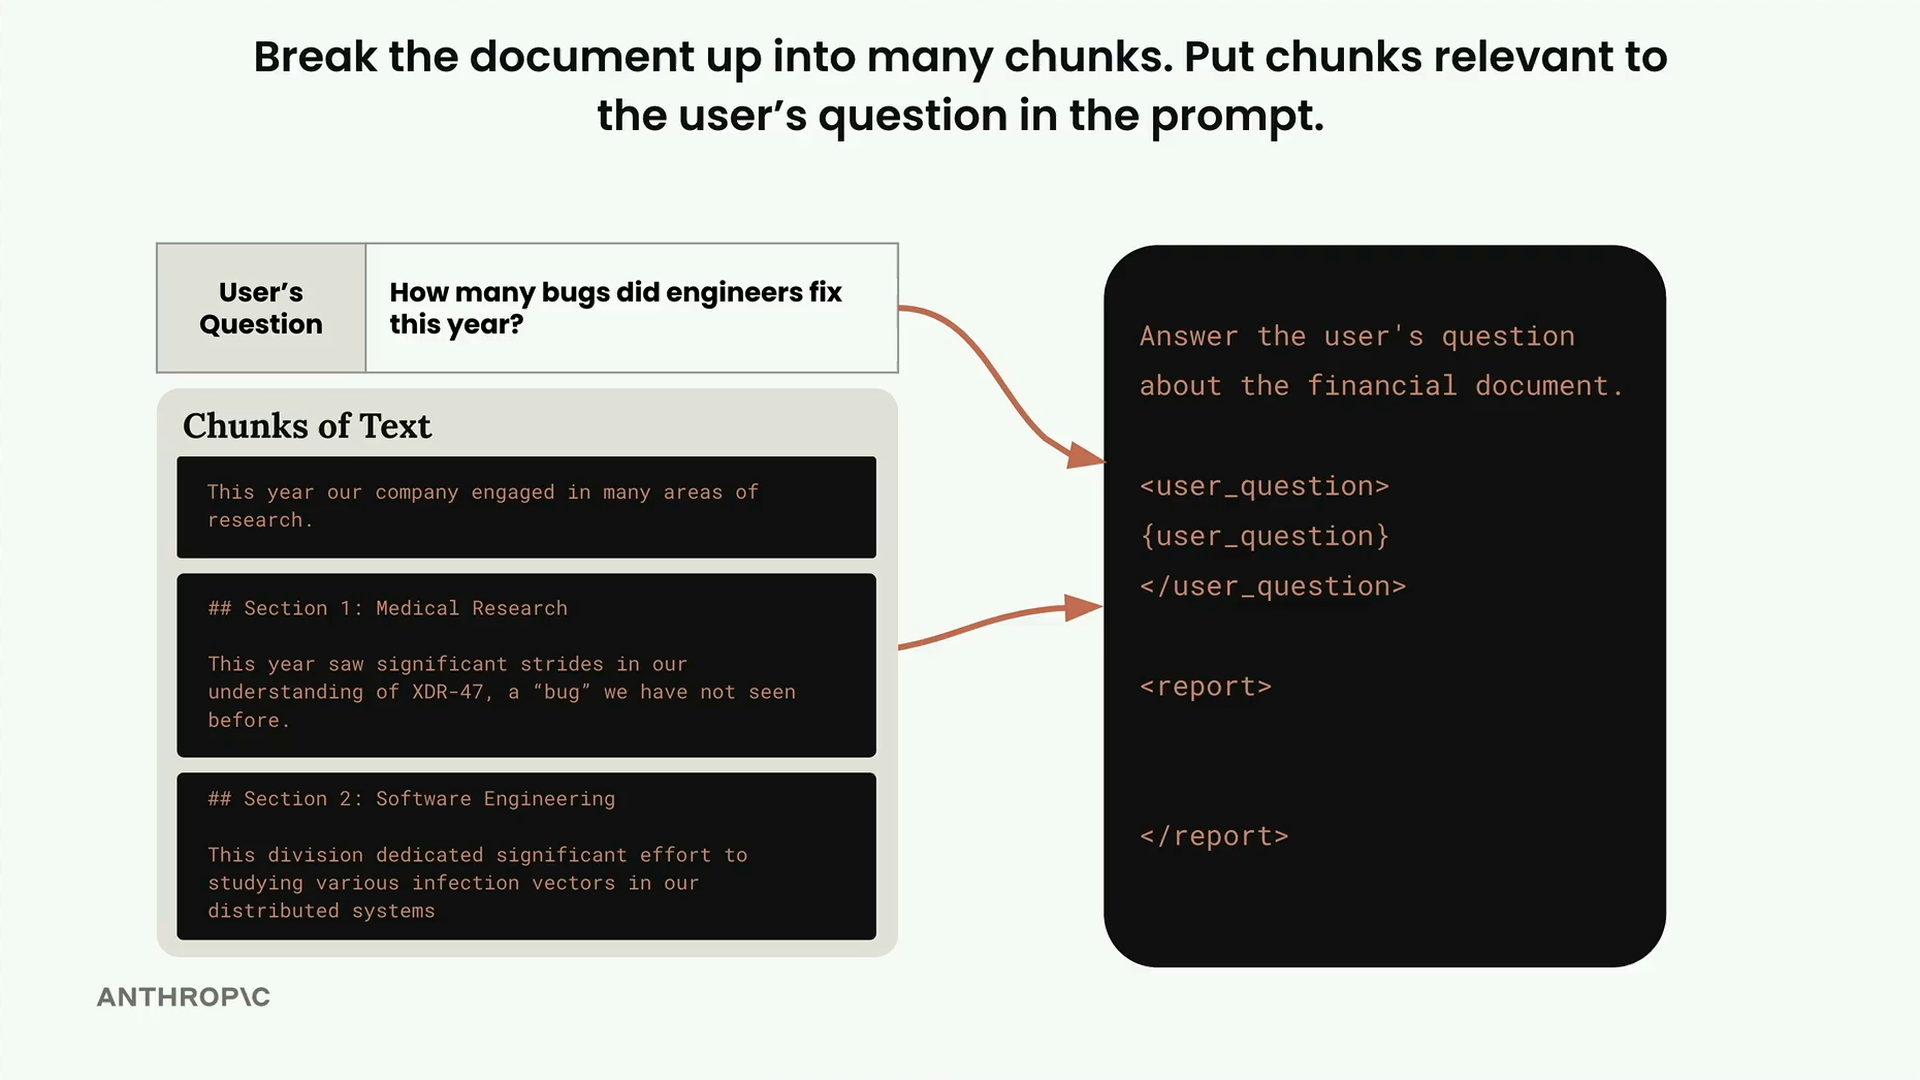
Semantische Suche
Der gängigste Ansatz, um relevante Chunks zu finden, ist die semantische Suche. Im Gegensatz zur traditionellen stichwortbasierten Suche verwendet die semantische Suche Text-Embeddings, um die tatsächliche Bedeutung sowohl der Frage des Nutzers als auch jedes einzelnen Text-Chunks zu verstehen. Dies ermöglicht es dem System, konzeptionell verwandte Inhalte zu finden, selbst wenn die genauen Wörter nicht übereinstimmen.
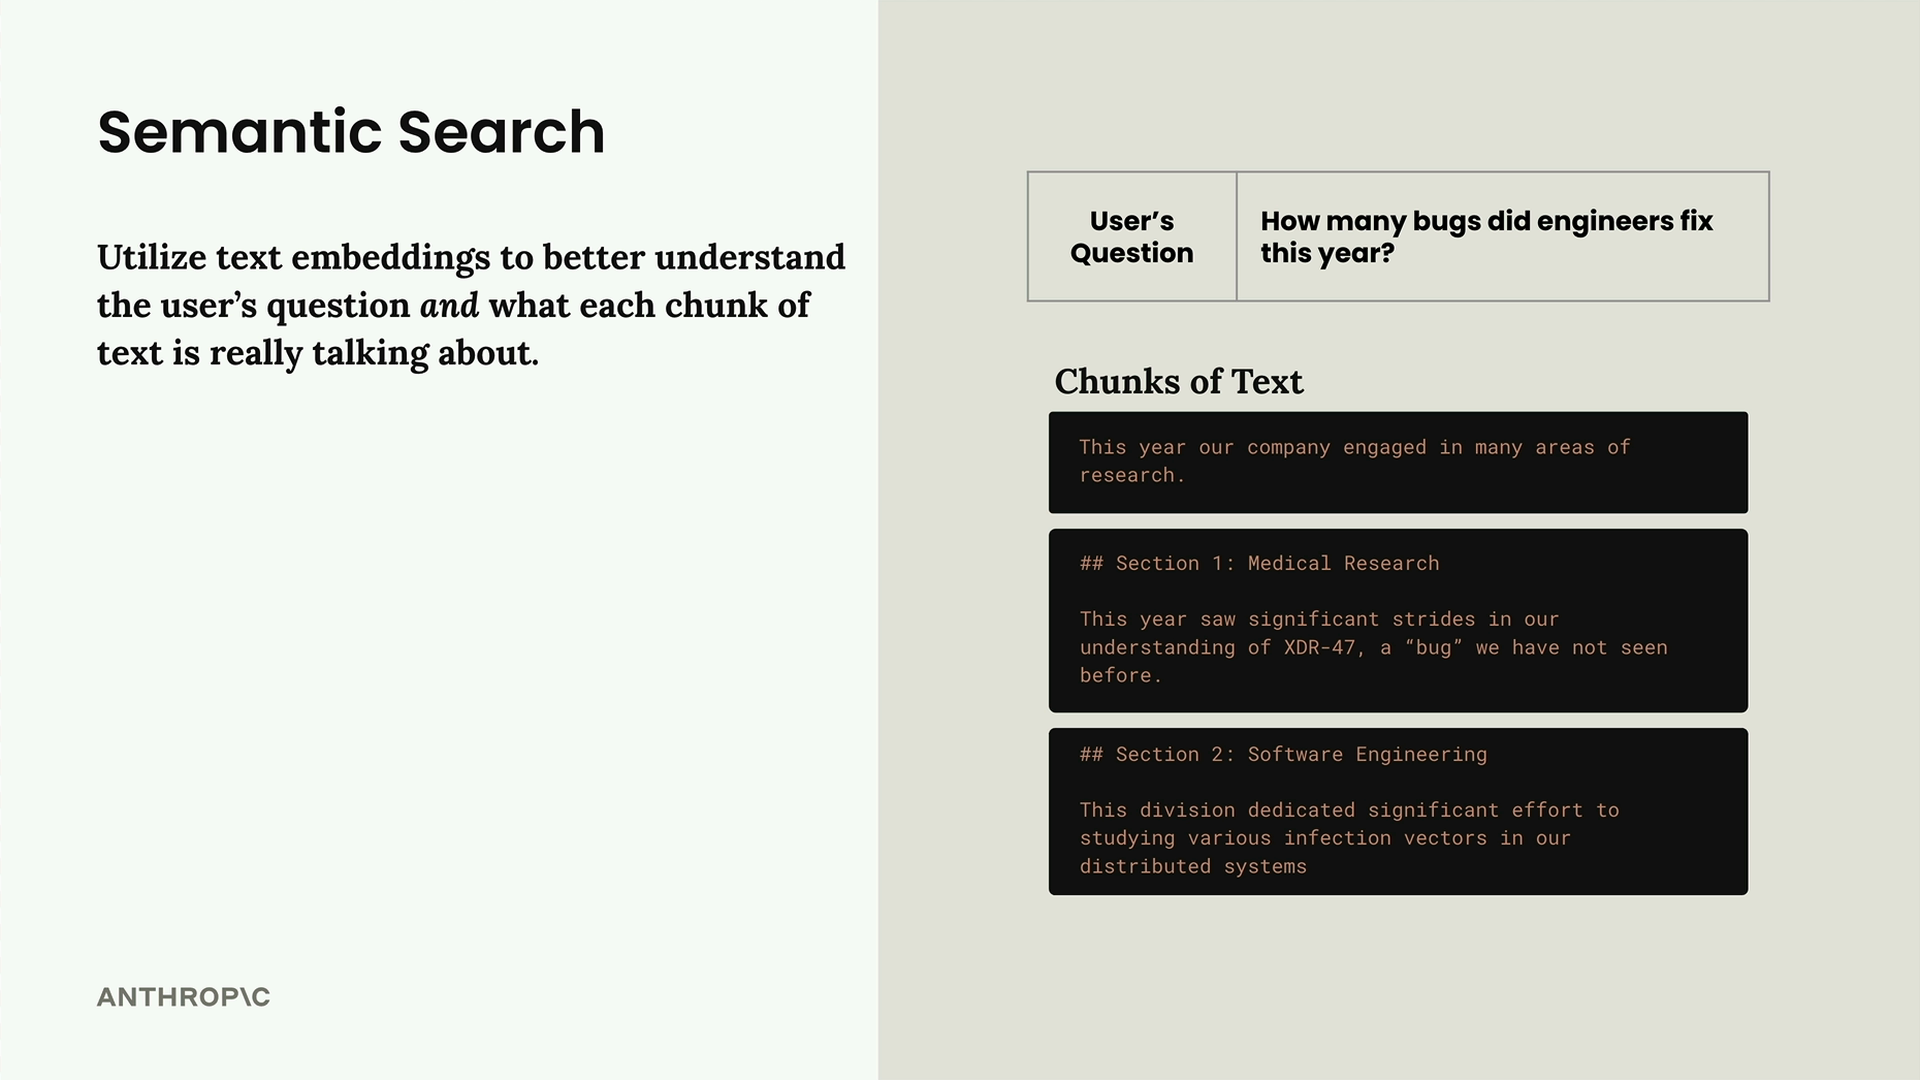
Was sind Text-Embeddings?
Ein Text-Embedding ist eine numerische Darstellung der Bedeutung, die in einem Text enthalten ist. Stell es dir so vor, als würdest du Wörter und Sätze in ein Format umwandeln, mit dem Computer mathematisch arbeiten können.
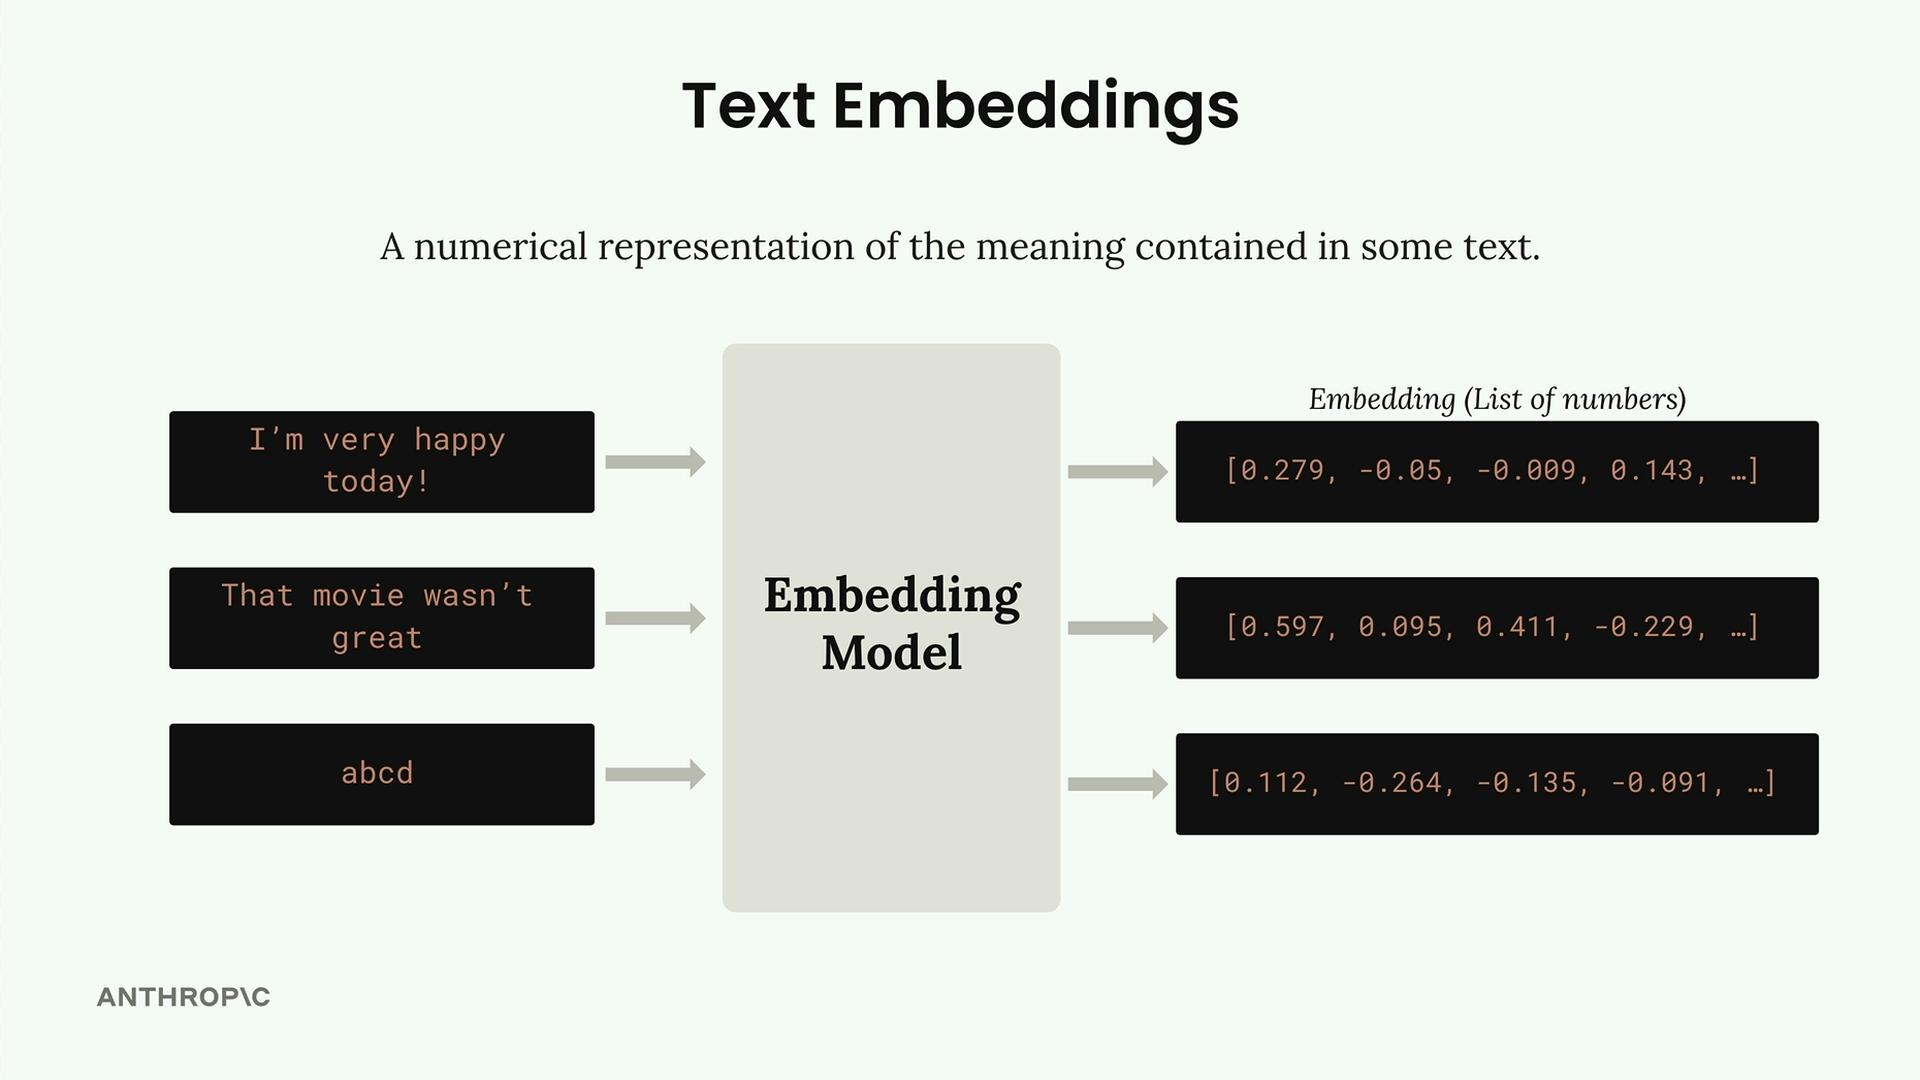
So funktioniert der Prozess:
- Du gibst Text in ein Embedding-Modell ein
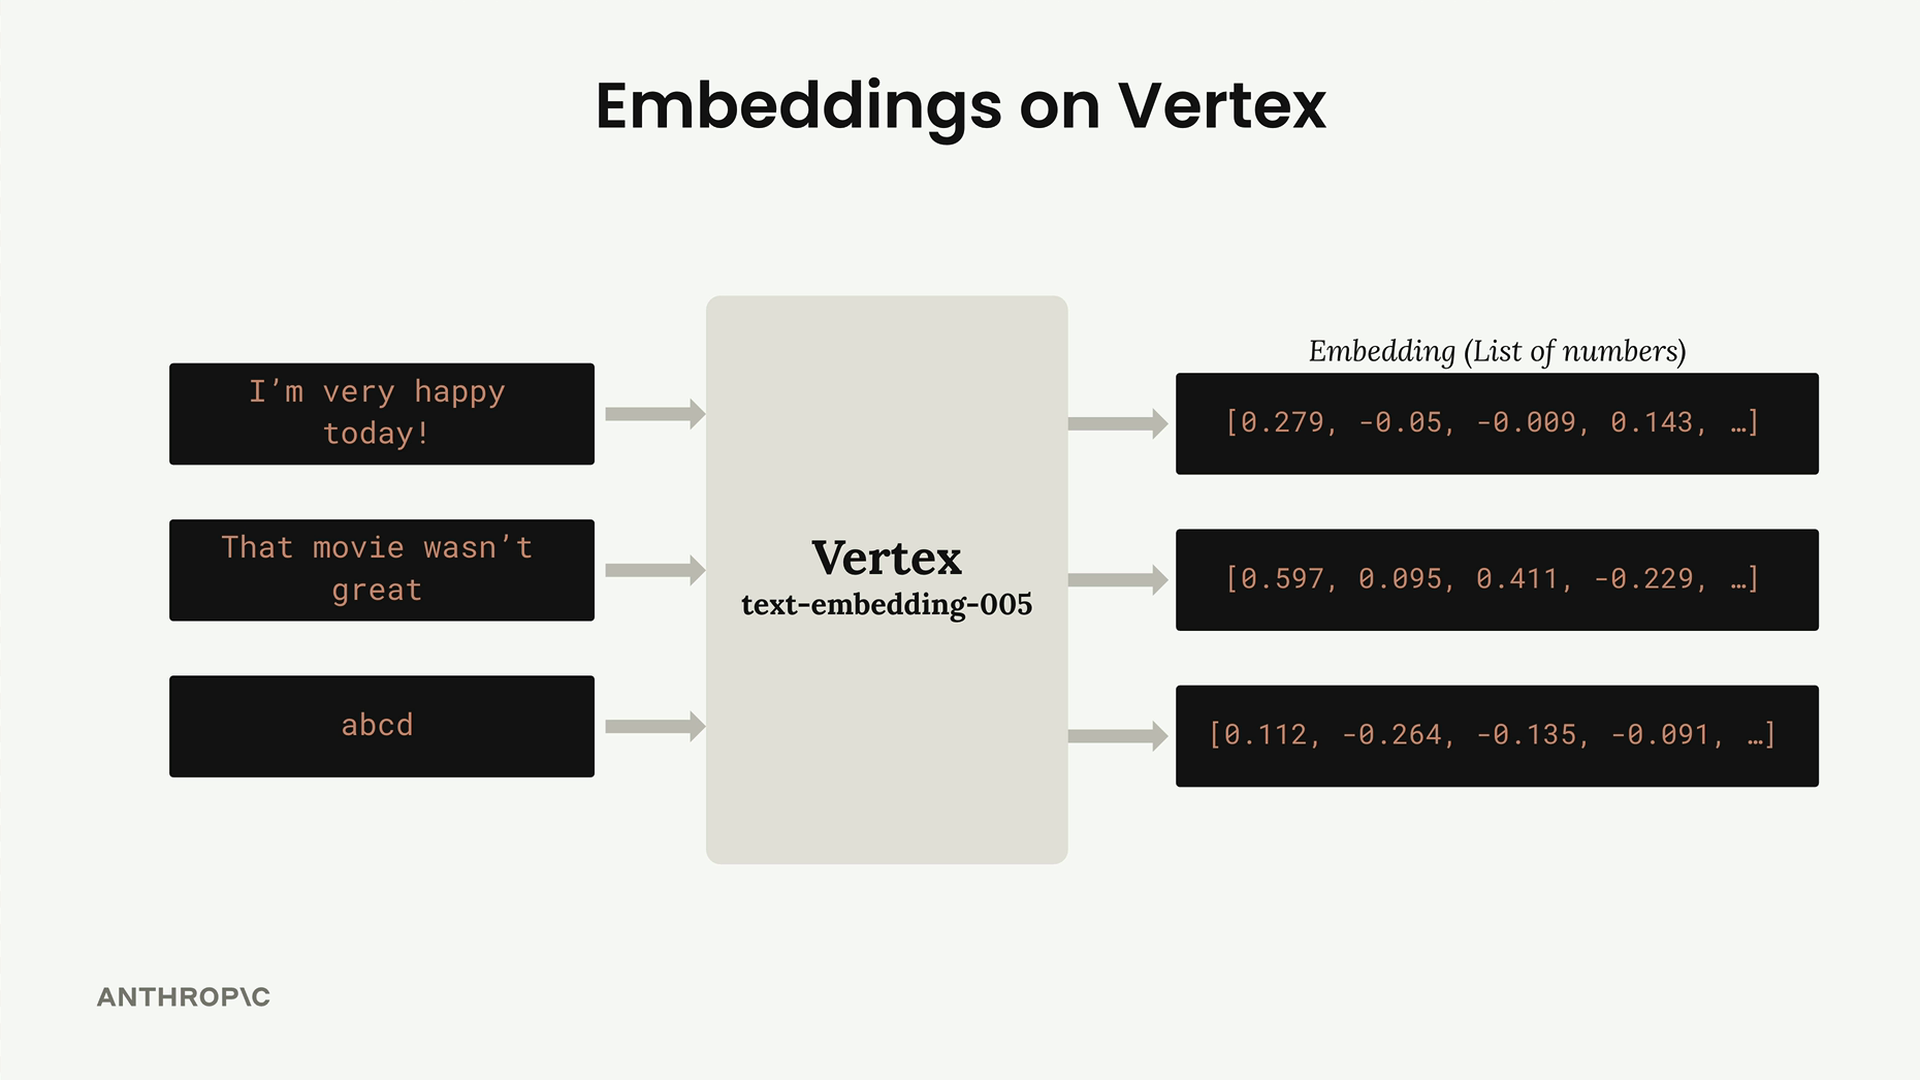
- Das Modell gibt eine lange Liste von Zahlen aus (das Embedding)
- Jede Zahl liegt im Bereich von -1 bis +1
- Diese Zahlen repräsentieren unterschiedliche Eigenschaften oder Merkmale des Eingabetexts
Die Zahlen verstehen
Jede Zahl in einem Embedding ist im Wesentlichen ein „Score“ für eine bestimmte Eigenschaft des Eingabetexts. Es gibt jedoch einen wichtigen Vorbehalt: Wir wissen eigentlich nicht, wofür jede einzelne Zahl genau steht.
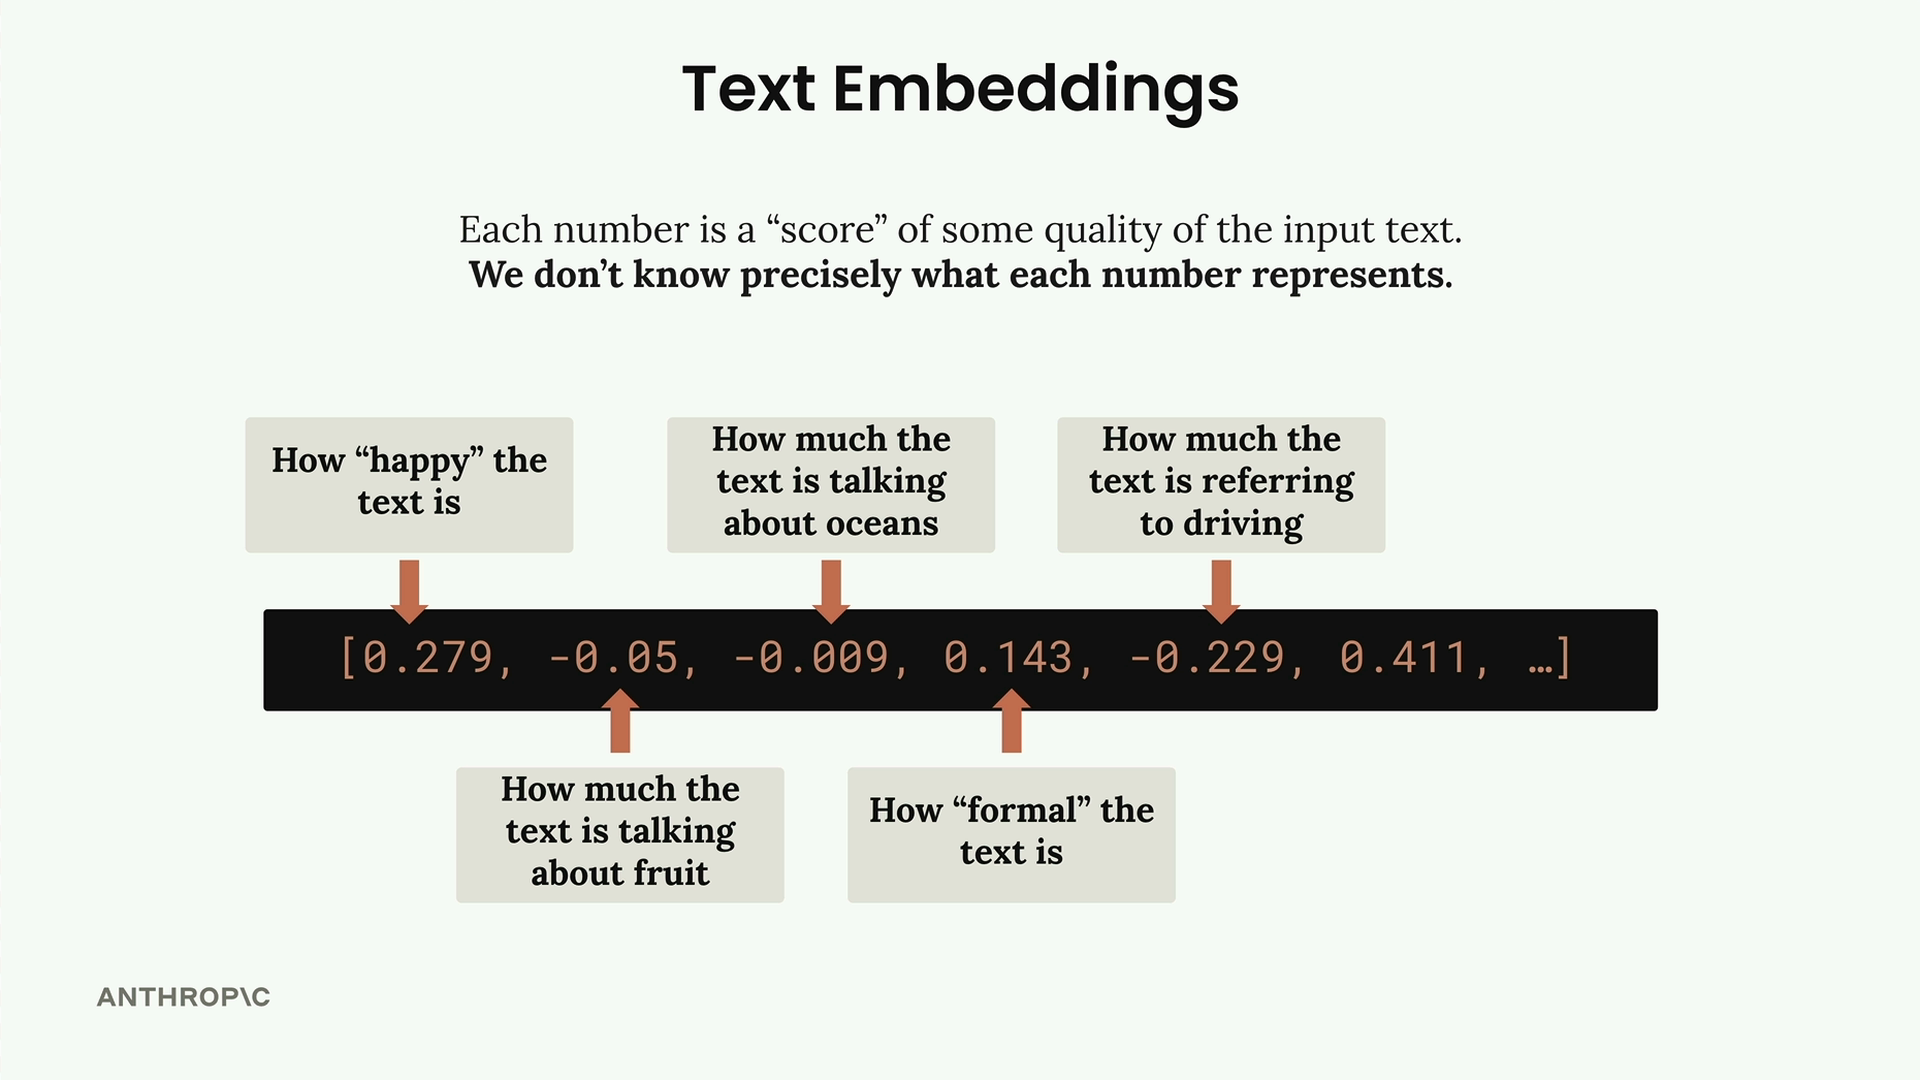
Es ist zwar hilfreich, sich vorzustellen, dass eine Zahl „wie glücklich der Text ist“ repräsentieren könnte und eine andere „wie viel der Text über Ozeane spricht“, aber dies sind nur konzeptionelle Beispiele. Das Embedding-Modell lernt diese Merkmale während des Trainings, aber sie sind für uns nicht explizit gekennzeichnet oder interpretierbar.
Trotz dieser Undurchsichtigkeit sind Embeddings unglaublich leistungsfähig, weil sie semantische Bedeutung auf eine Weise erfassen, die einen mathematischen Vergleich zwischen verschiedenen Textstücken ermöglicht.
Embeddings auf Vertex AI
Claude kann keine Embeddings direkt generieren. Stattdessen musst du ein spezialisiertes Embedding-Modell verwenden. Auf Vertex AI heißt das Modell, das wir verwenden werden, text-embedding-005.
Implementierung
Um mit Embeddings auf Vertex AI zu arbeiten, musst du das Google GenAI SDK installieren:
pip install google-genaiHier ist die grundlegende Einrichtung zum Generieren von Embeddings:
from google import genai

client = genai.Client(
    project="YOUR_PROJECT_ID",
    location="global",
    vertexai=True
)

def generate_embedding(text):
    response = client.models.embed_content(
        model="text-embedding-005",
        contents=text
    )

    if not response.embeddings:
        return []

    return [e.values for e in response.embeddings]
Wenn du diese Funktion mit einem Text-Chunk ausführst, erhältst du eine Liste von Fließkommazahlen zurück, die die semantische Bedeutung dieses Texts repräsentieren. Diese Embeddings bilden die Grundlage für die Implementierung der semantischen Suche in deinem RAG-System.
Der nächste Schritt besteht darin zu verstehen, wie man diese Embeddings verwendet, um tatsächlich die relevantesten Chunks für die Frage eines Nutzers zu finden, was den mathematischen Vergleich von Embeddings zur Bestimmung der Ähnlichkeit beinhaltet.