Wenn du mit Claude arbeitest, ist das Schreiben eines guten Prompts nur der Anfang. Um zuverlässige KI-Anwendungen zu entwickeln, musst du zwei zentrale Konzepte verstehen: Prompt-Engineering und Prompt-Evaluierung. Prompt-Engineering gibt dir Techniken an die Hand, um bessere Prompts zu schreiben, während die Prompt-Evaluierung dir hilft zu messen, wie gut diese Prompts tatsächlich funktionieren.
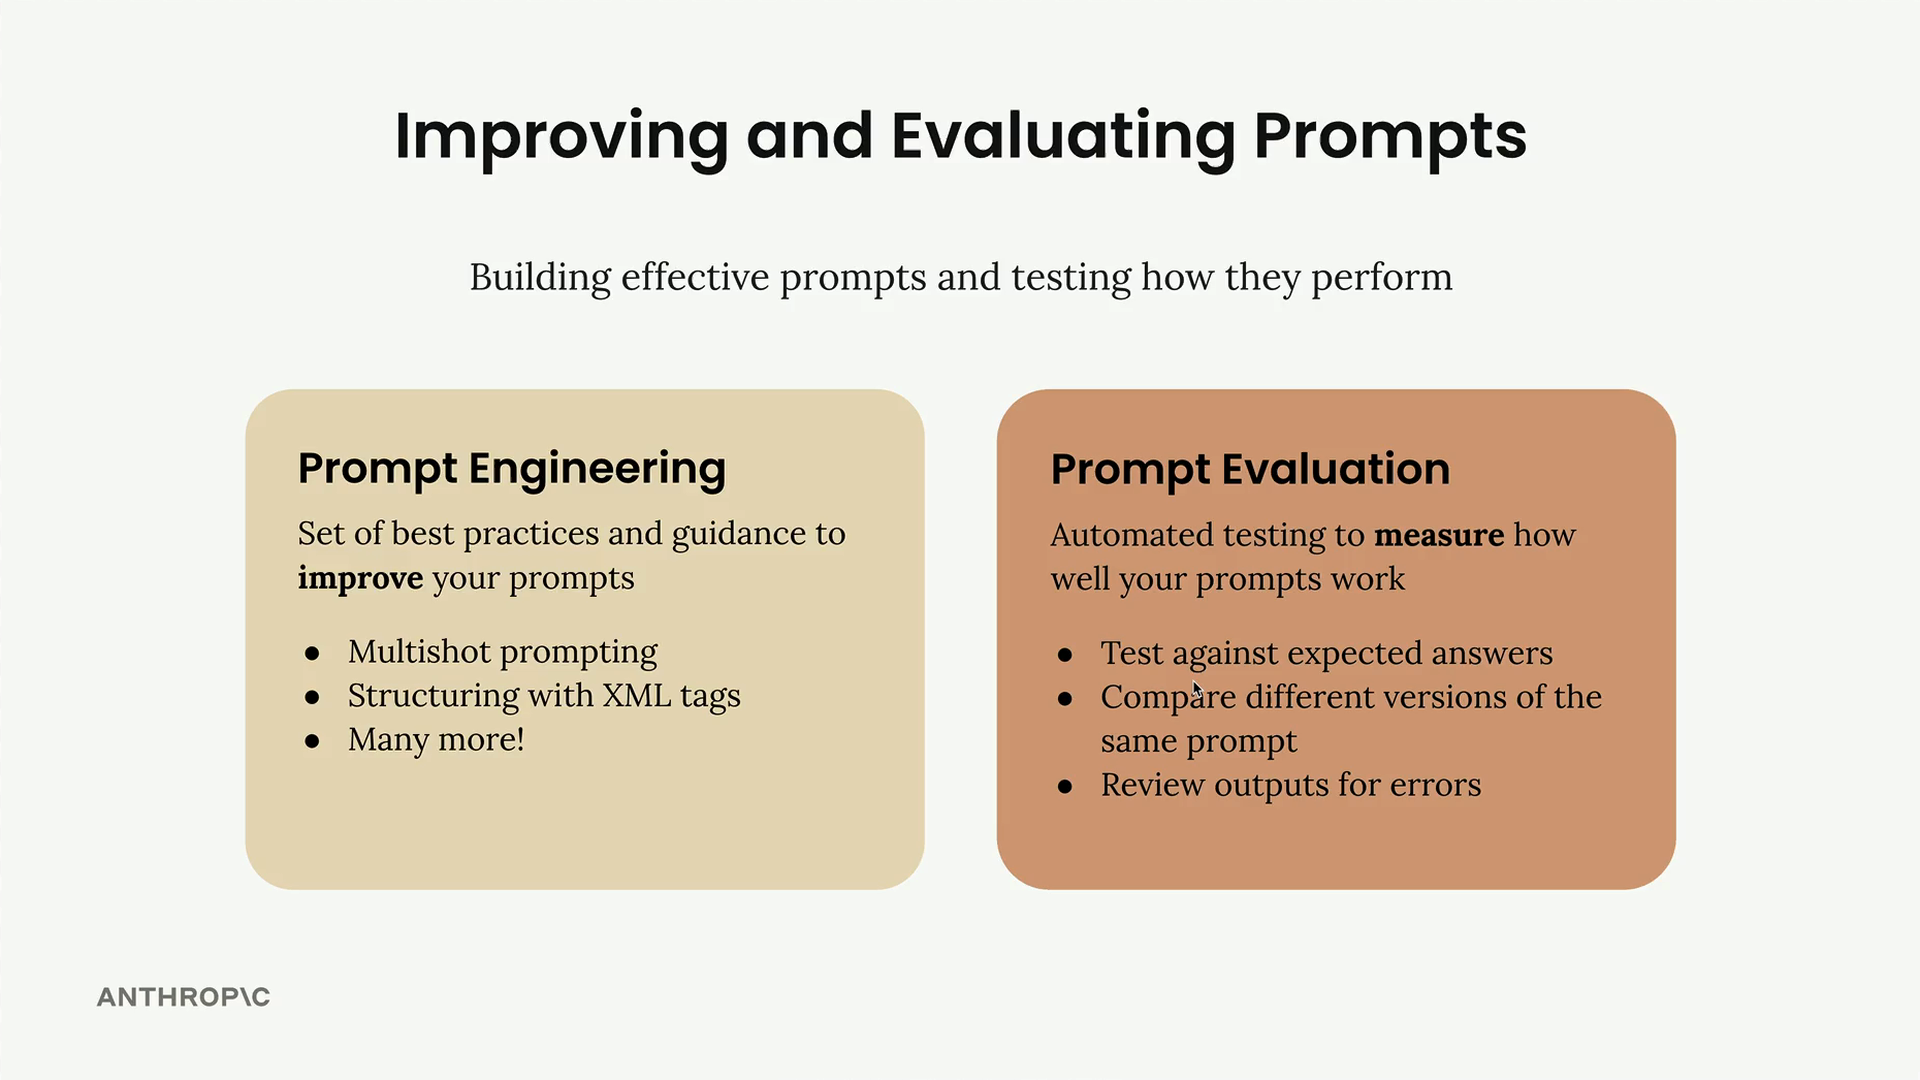
Prompt-Engineering vs. Prompt-Evaluierung
Prompt-Engineering ist dein Werkzeugkasten zum Schreiben und Verbessern von Prompts. Es ist eine Reihe bewährter Praktiken, die Claude dabei helfen, genau zu verstehen, worum du bittest und wie du eine Antwort erwartest. Betrachte es als die Kunst des Prompt-Schreibens – Techniken wie Multishot-Prompting, Strukturierung mit XML-Tags und viele weitere Ansätze, die wir noch erkunden werden.
Prompt-Evaluierung hingegen dreht sich um Messung. Es handelt sich um automatisiertes Testen, das dir objektive Metriken darüber liefert, ob deine Prompts tatsächlich effektiv sind. Anstatt zu raten, ob dein Prompt gut funktioniert, ermöglicht dir die Evaluierung:
- Gegen erwartete Antworten zu testen
- Verschiedene Versionen desselben Prompts zu vergleichen
- Ausgaben auf Fehler zu überprüfen
Die drei Wege nach dem Schreiben eines Prompts
Sobald du einen Prompt entworfen hast, stehen dir in der Regel drei Optionen für das weitere Vorgehen zur Verfügung:
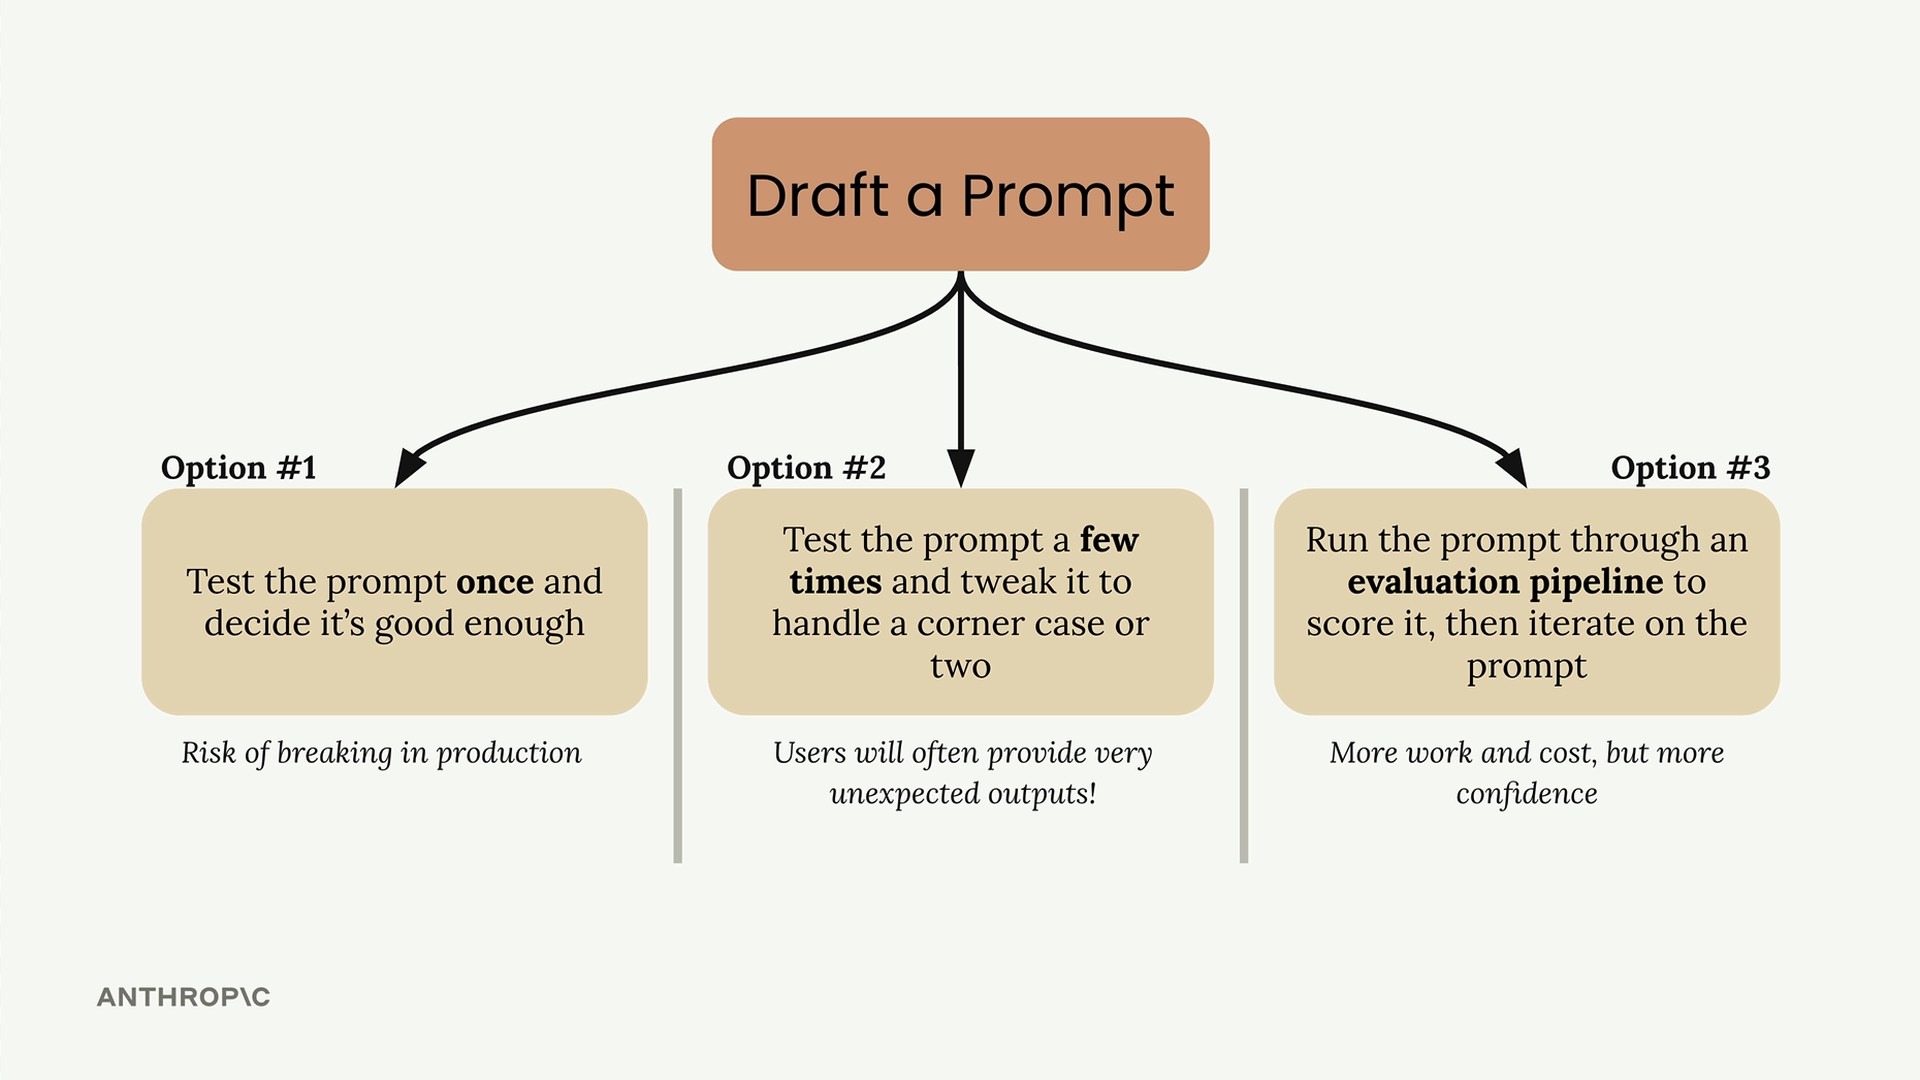
Option 1: Teste den Prompt einmal und entscheide, dass er gut genug ist. Dies birgt ein erhebliches Risiko, in der Produktion zu versagen, wenn Nutzer unerwartete Eingaben liefern.
Option 2: Teste den Prompt ein paar Mal und passe ihn an, um einen oder zwei Sonderfälle zu behandeln. Auch wenn das besser ist als Option 1, werden Nutzer oft sehr unerwartete Ausgaben liefern, die du nicht bedacht hast.
Option 3: Lass den Prompt durch eine Evaluierungs-Pipeline laufen, um ihn zu bewerten, und iteriere dann auf Basis objektiver Daten am Prompt. Dies erfordert im Vorfeld mehr Aufwand und Kosten, gibt dir aber deutlich mehr Vertrauen in die Zuverlässigkeit deines Prompts.
Warum die meisten Entwickler in Test-Fallen tappen
Die Optionen 1 und 2 sind Fallen, in die alle Entwickler tappen – mich eingeschlossen. Es ist naheliegend, einen Prompt zu schreiben, ihn ein paar Mal mit den eigenen Eingaben zu testen und zu denken: „Das sieht gut genug aus.“ Aber wenn du ernsthafte Anwendungen entwickelst, führt dieser Ansatz oft zu Problemen in der Produktion.
Das Problem ist, dass du nicht alle Arten vorhersagen kannst, wie Nutzer mit deinem Prompt interagieren werden. Was in deinen begrenzten Tests perfekt zu funktionieren scheint, kann bei realen Nutzungsmustern komplett versagen.
Der Wert systematischer Evaluierung
Option 3 – das Durchlaufen deines Prompts durch eine Evaluierungs-Pipeline – liefert dir objektive Daten über die Leistung. Anstatt dich auf Bauchgefühl oder begrenzte manuelle Tests zu verlassen, erhältst du messbare Werte, die dir zeigen, wie gut dein Prompt mit einer Vielzahl von Eingaben umgeht.
Dieser Ansatz erlaubt es dir, selbstbewusst zu iterieren. Du kannst Änderungen an deinem Prompt vornehmen und sofort sehen, ob diese Änderungen die Leistung verbessern oder verschlechtern. Es ist der Unterschied zwischen Raten und Wissen, ob deine Prompt-Verbesserungen tatsächlich funktionieren.
Während die Evaluierung mehr vorab investierte Zeit und Ressourcen erfordert, zahlt sie sich aus, wenn du zuverlässige, produktionsreife Prompts brauchst, die über unterschiedliche Nutzereingaben hinweg konsistent funktionieren.