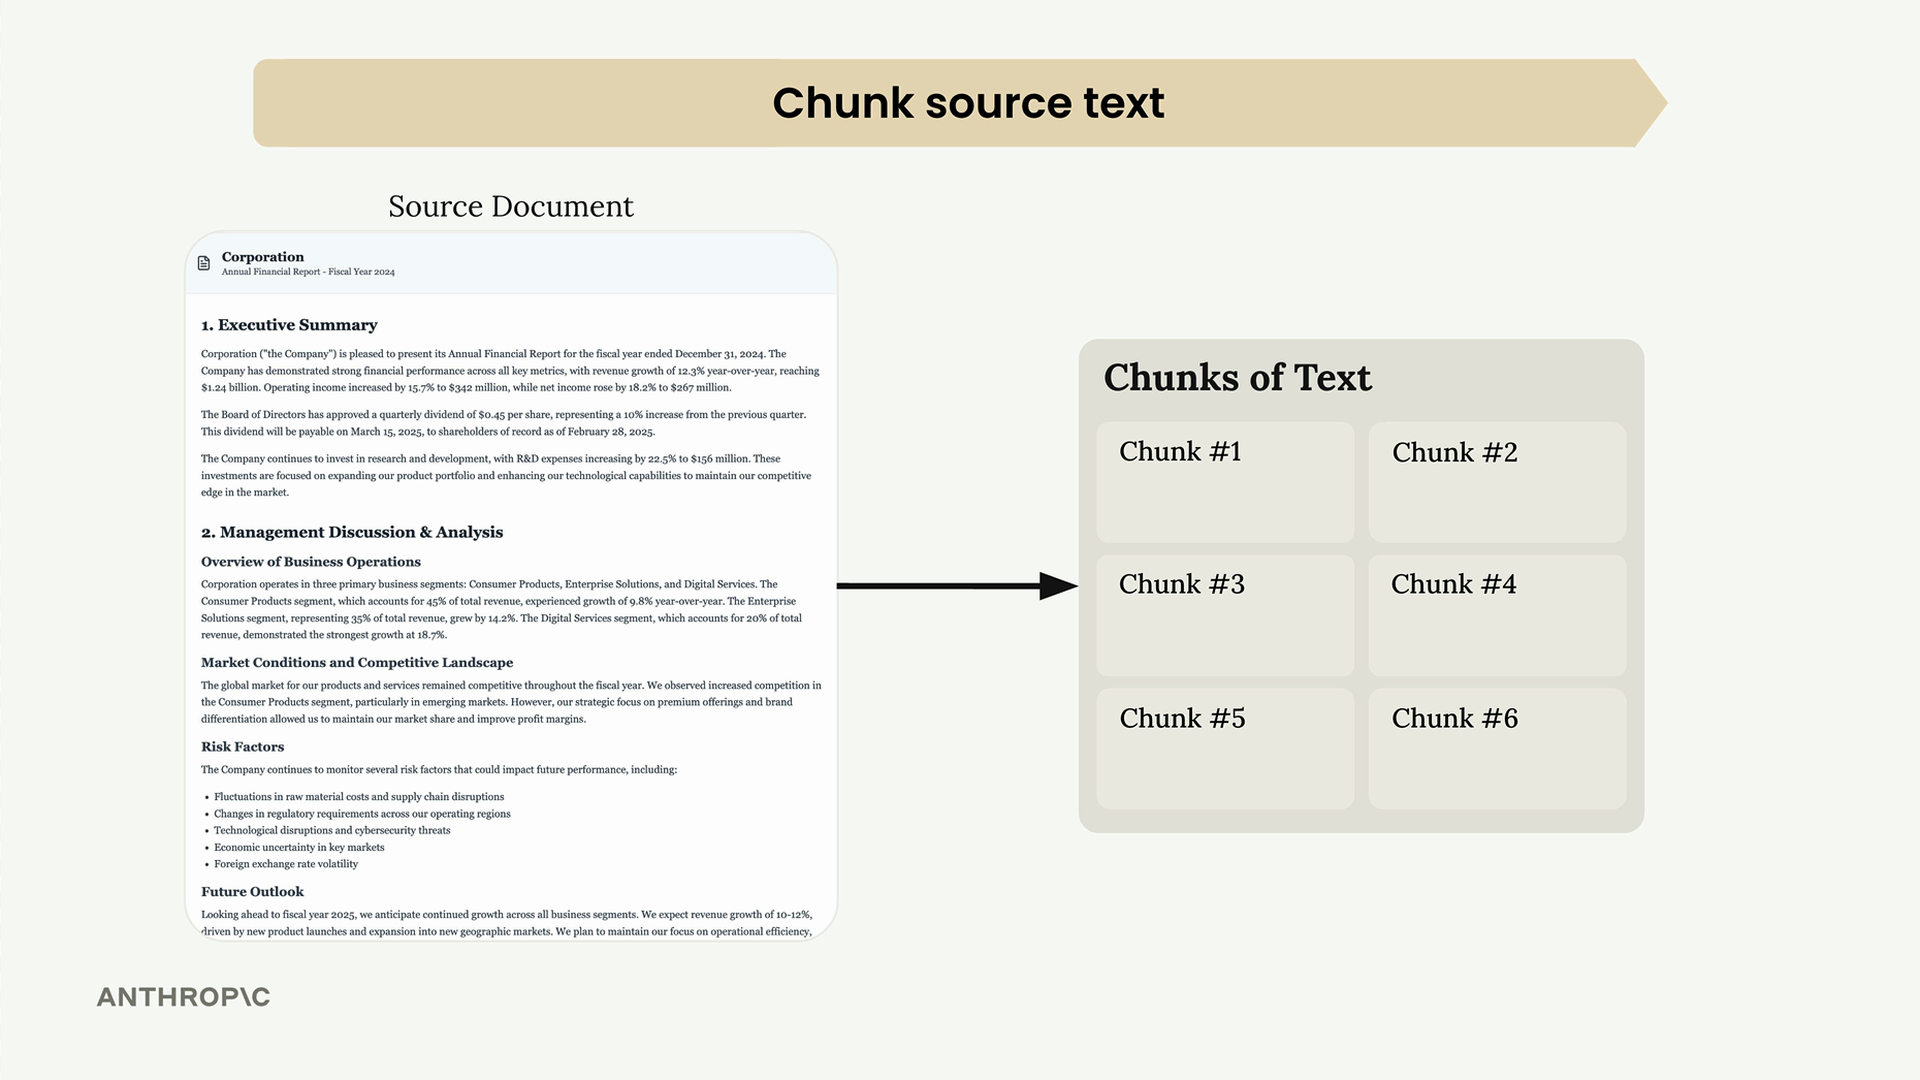
Die Textaufteilung (Chunking) ist einer der kritischsten Schritte beim Aufbau einer RAG-Pipeline (Retrieval Augmented Generation). Wie du deine Dokumente aufteilst, wirkt sich direkt auf die Qualität deines gesamten Systems aus. Eine schlechte Chunking-Strategie kann dazu führen, dass irrelevanter Kontext in deine Prompts eingefügt wird, was dazu führt, dass deine KI völlig falsche Antworten gibt.
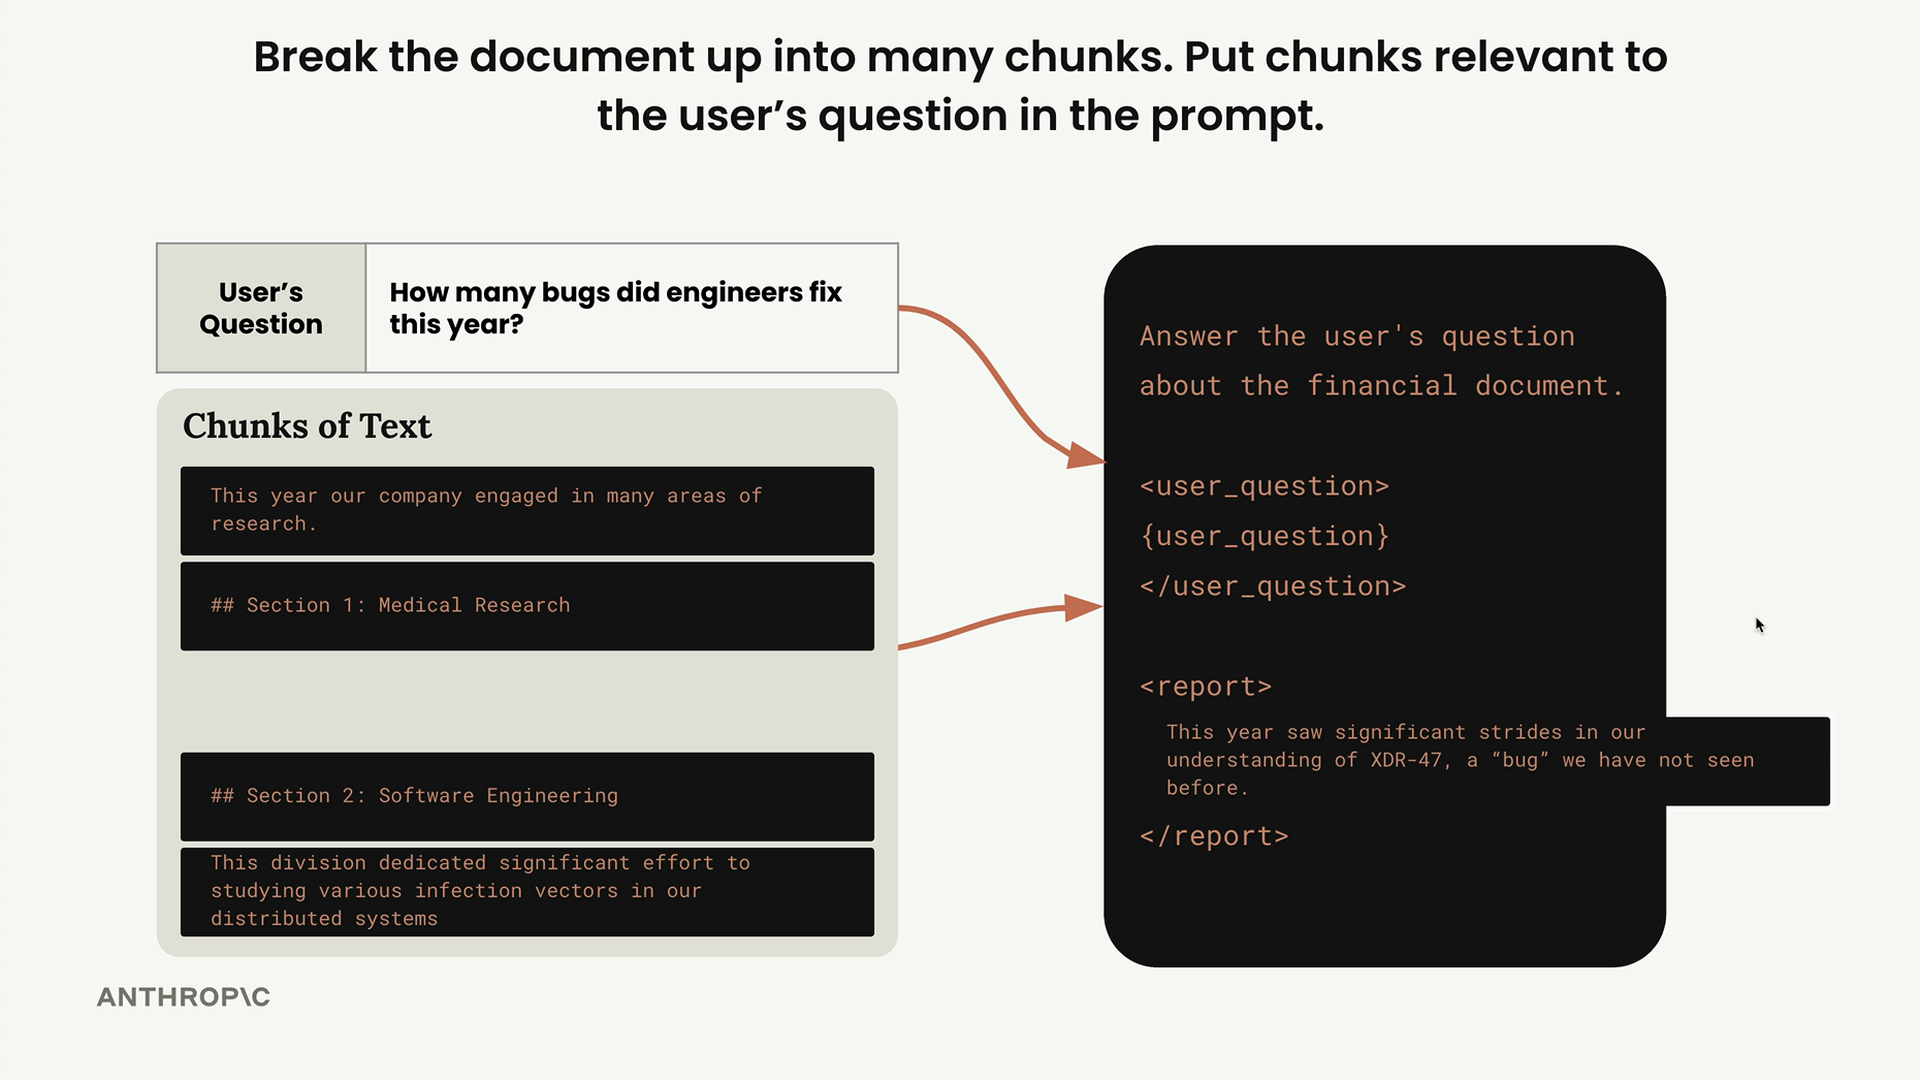
Betrachte dieses Beispiel: Du hast ein Dokument mit Abschnitten zu medizinischer Forschung und Softwareentwicklung. Wenn du schlecht chunkst, könnte ein Nutzer, der fragt „Wie viele Bugs haben die Ingenieure dieses Jahr behoben?“, stattdessen Informationen über medizinische Forschung erhalten, einfach weil der medizinische Abschnitt das Wort „Bug“ in einem anderen Kontext enthielt.
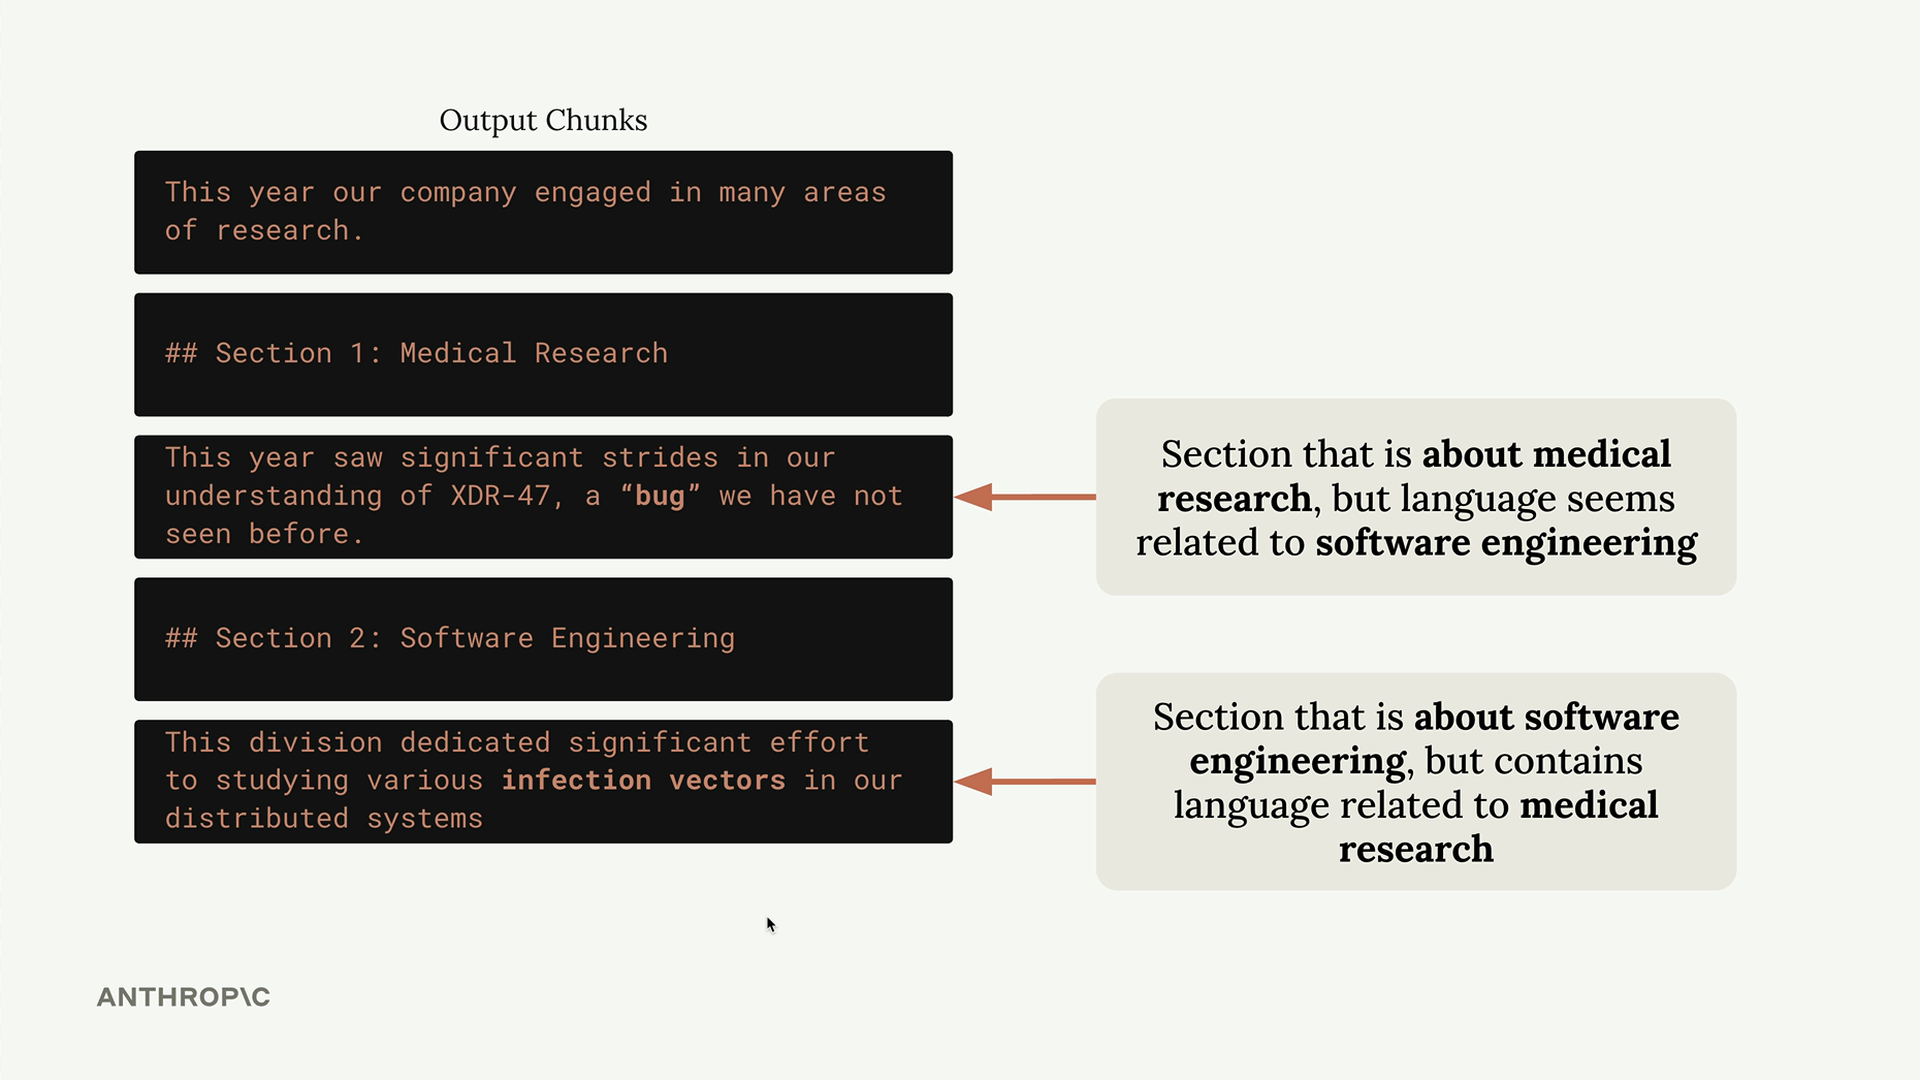
Dies zeigt, warum die Chunking-Strategie so wichtig ist. Das Ziel ist es, Chunks zu erstellen, die semantische Kohärenz bewahren und bei der Abfrage sinnvollen Kontext liefern.
Drei Hauptstrategien zur Textaufteilung
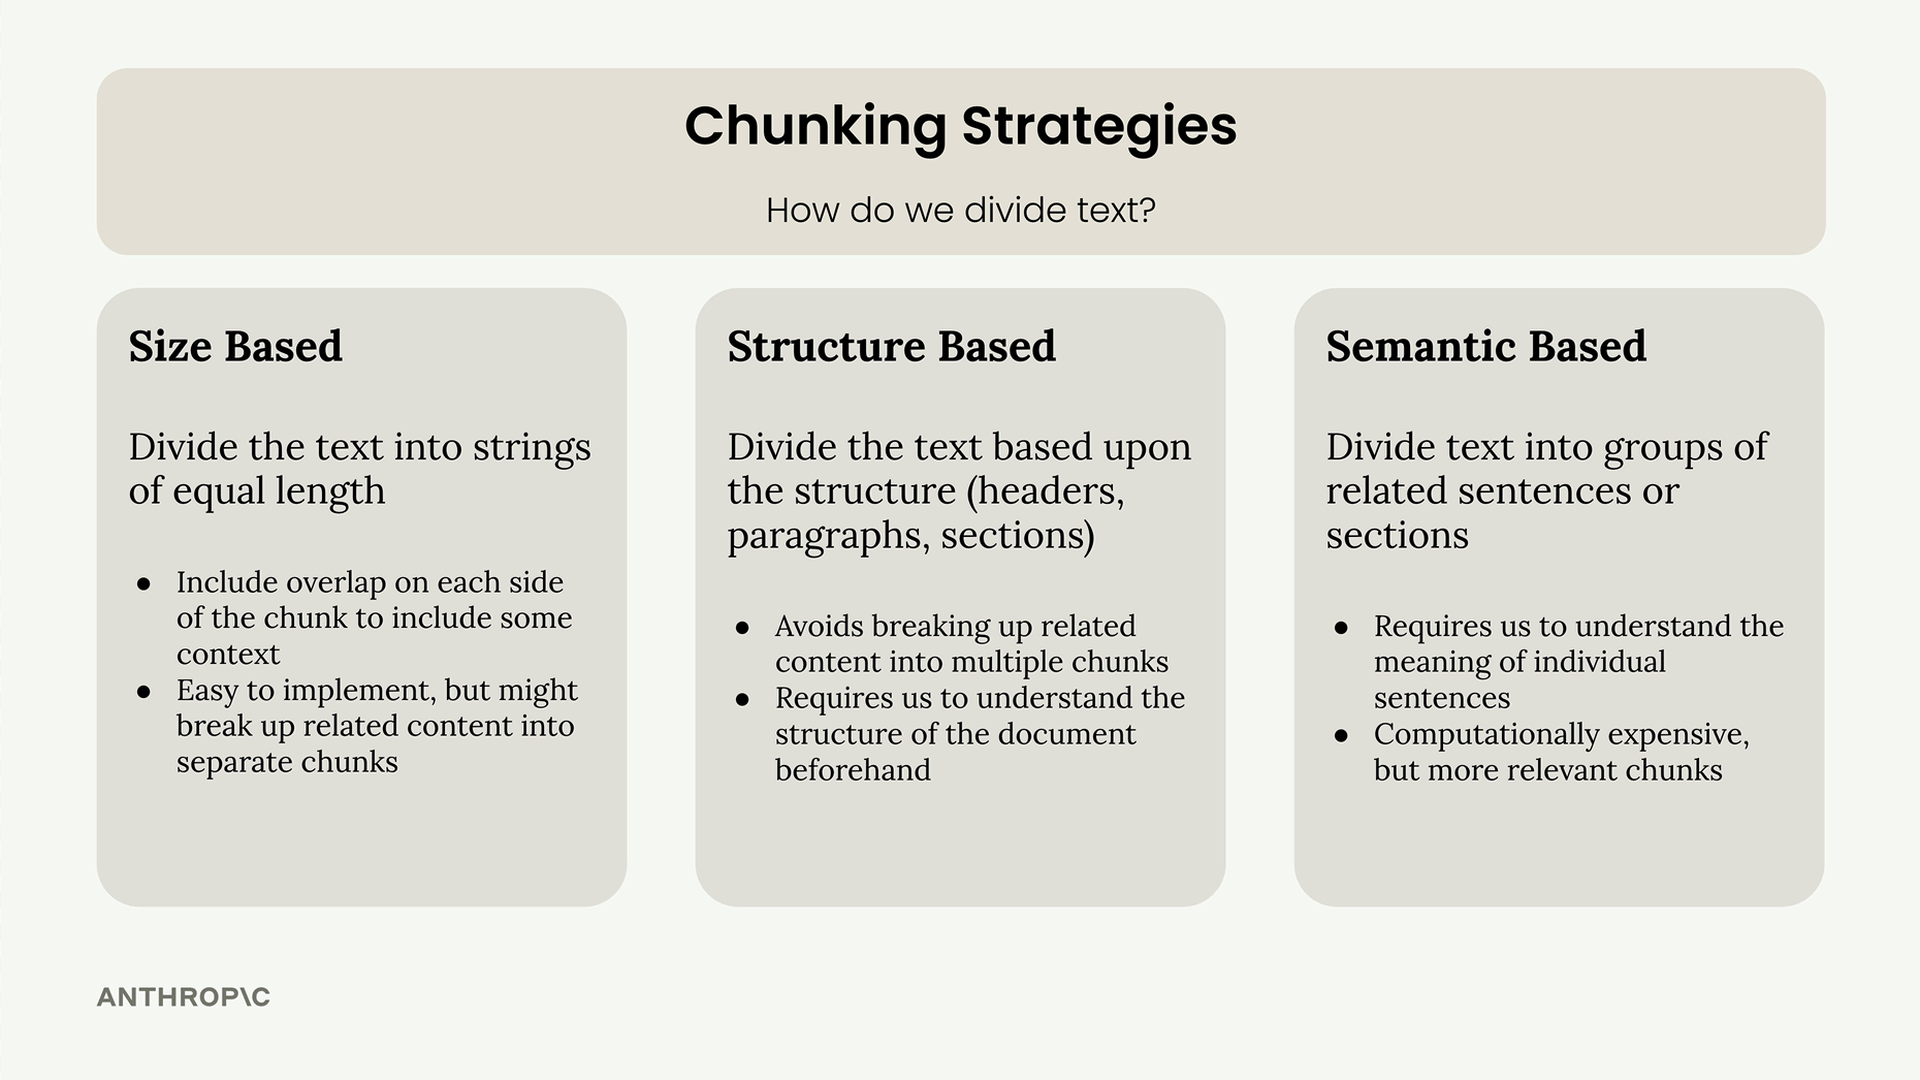
Es gibt drei grundlegende Ansätze zur Textaufteilung, jeder mit eigenen Vorteilen und Kompromissen:
- Größenbasiert: Text in Zeichenketten gleicher Länge unterteilen
- Strukturbasiert: Aufteilung anhand der Dokumentstruktur (Überschriften, Absätze, Abschnitte)
- Semantikbasiert: Zusammenhängende Sätze oder Abschnitte mithilfe von NLP-Techniken gruppieren
Größenbasierte Textaufteilung
Die größenbasierte Textaufteilung ist der unkomplizierteste Ansatz. Du teilst dein Dokument einfach in Chunks mit annähernd gleicher Zeichen- oder Wortanzahl auf. Sie ist einfach zu implementieren und funktioniert zuverlässig über verschiedene Dokumenttypen hinweg.
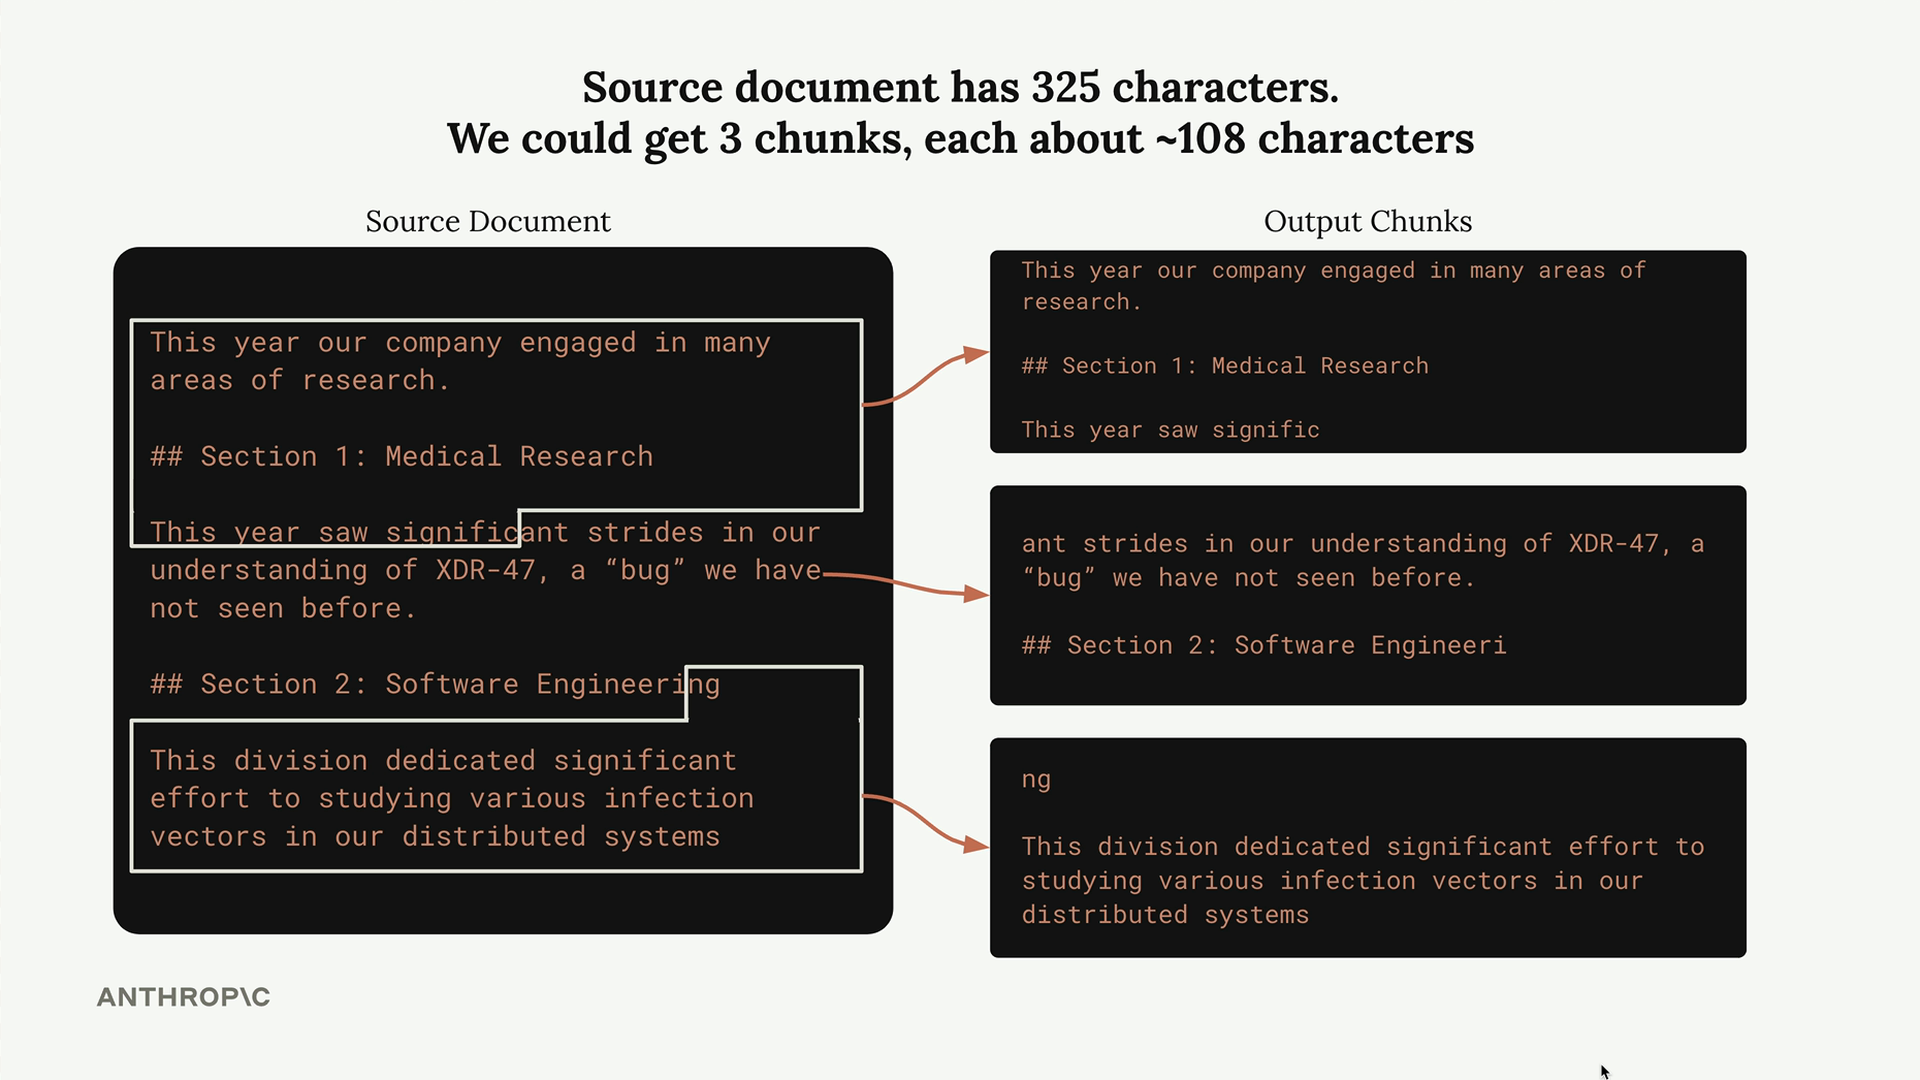
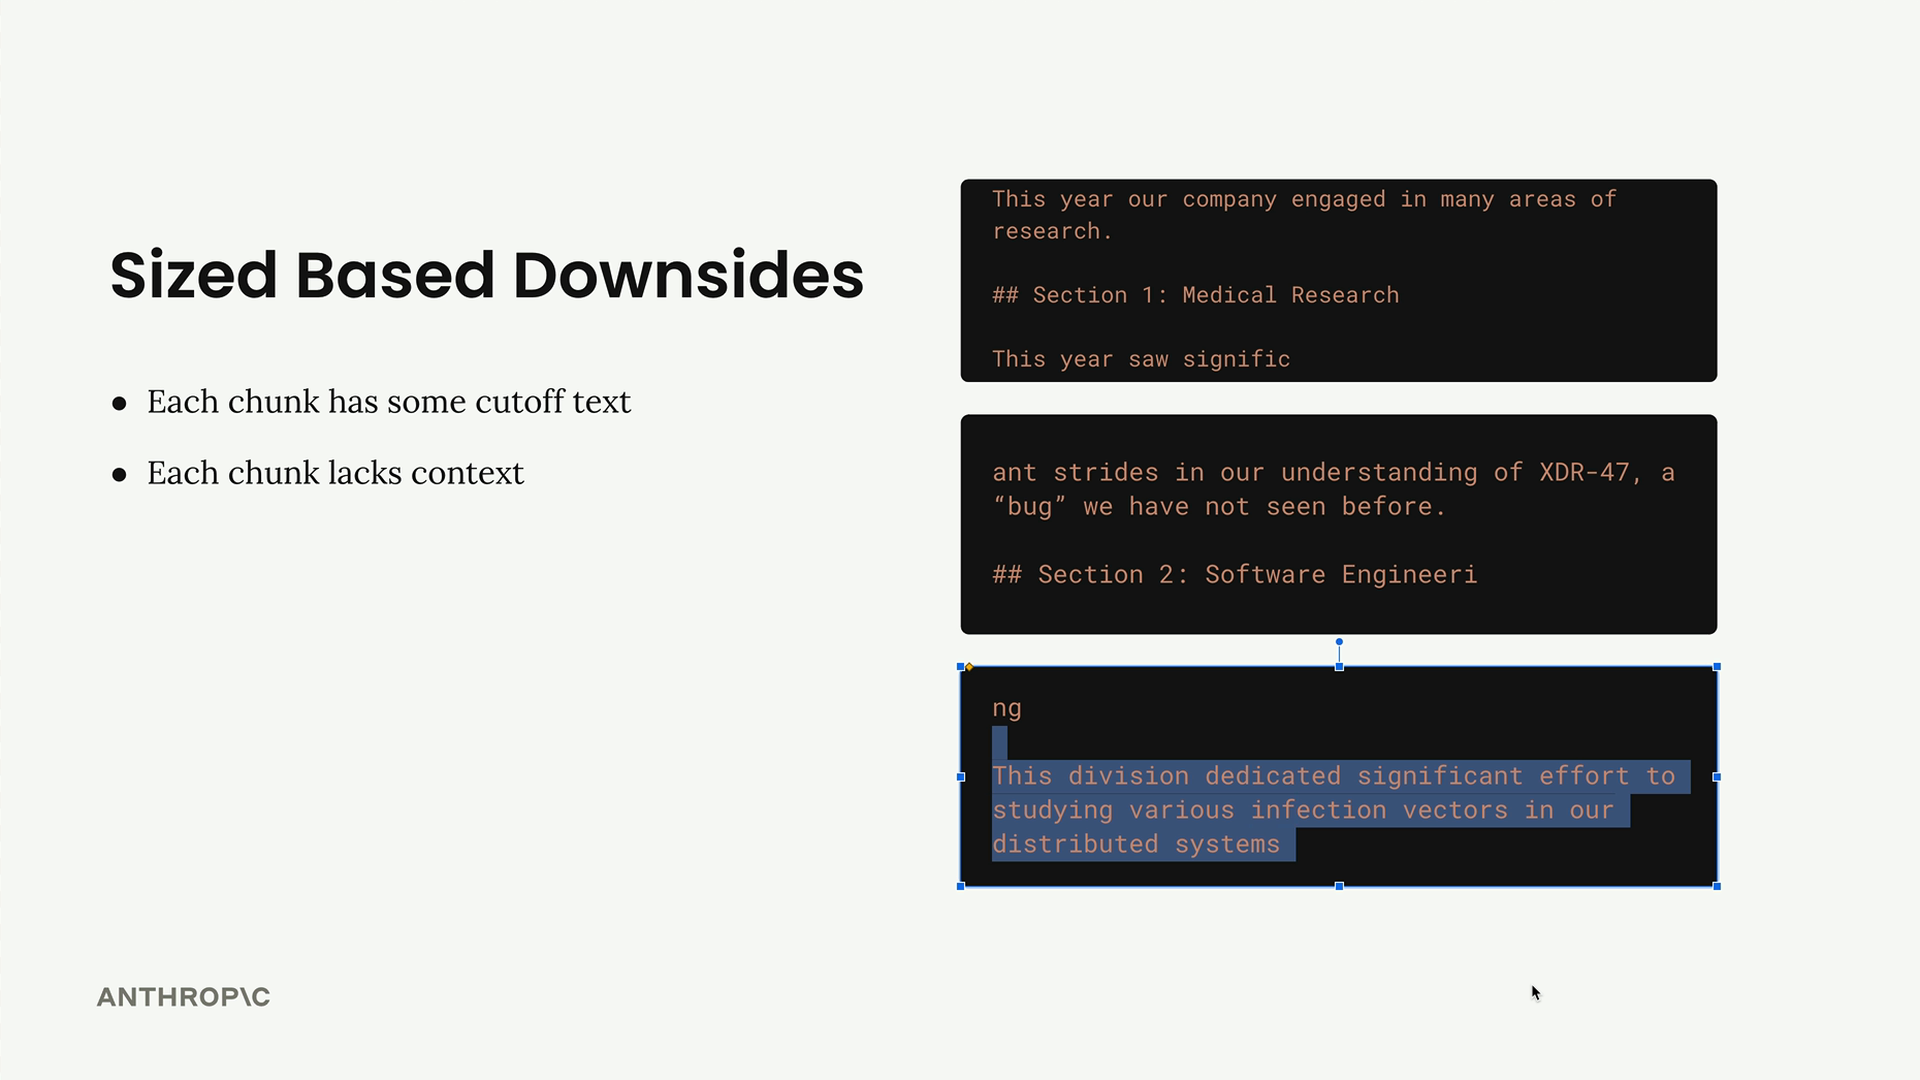
Dieser Ansatz hat jedoch klare Nachteile. Wörter werden mitten im Satz abgeschnitten, und Chunks verlieren wichtigen Kontext. Zum Beispiel enthält ein Chunk möglicherweise nicht die Abschnittsüberschrift, die erklären würde, worum es im Inhalt eigentlich geht.
Die Lösung besteht darin, eine Überlappung zwischen den Chunks hinzuzufügen. Jeder Chunk enthält einige Zeichen aus benachbarten Chunks, was eine bessere Kontextbewahrung gewährleistet und abrupte Abbrüche vermeidet.
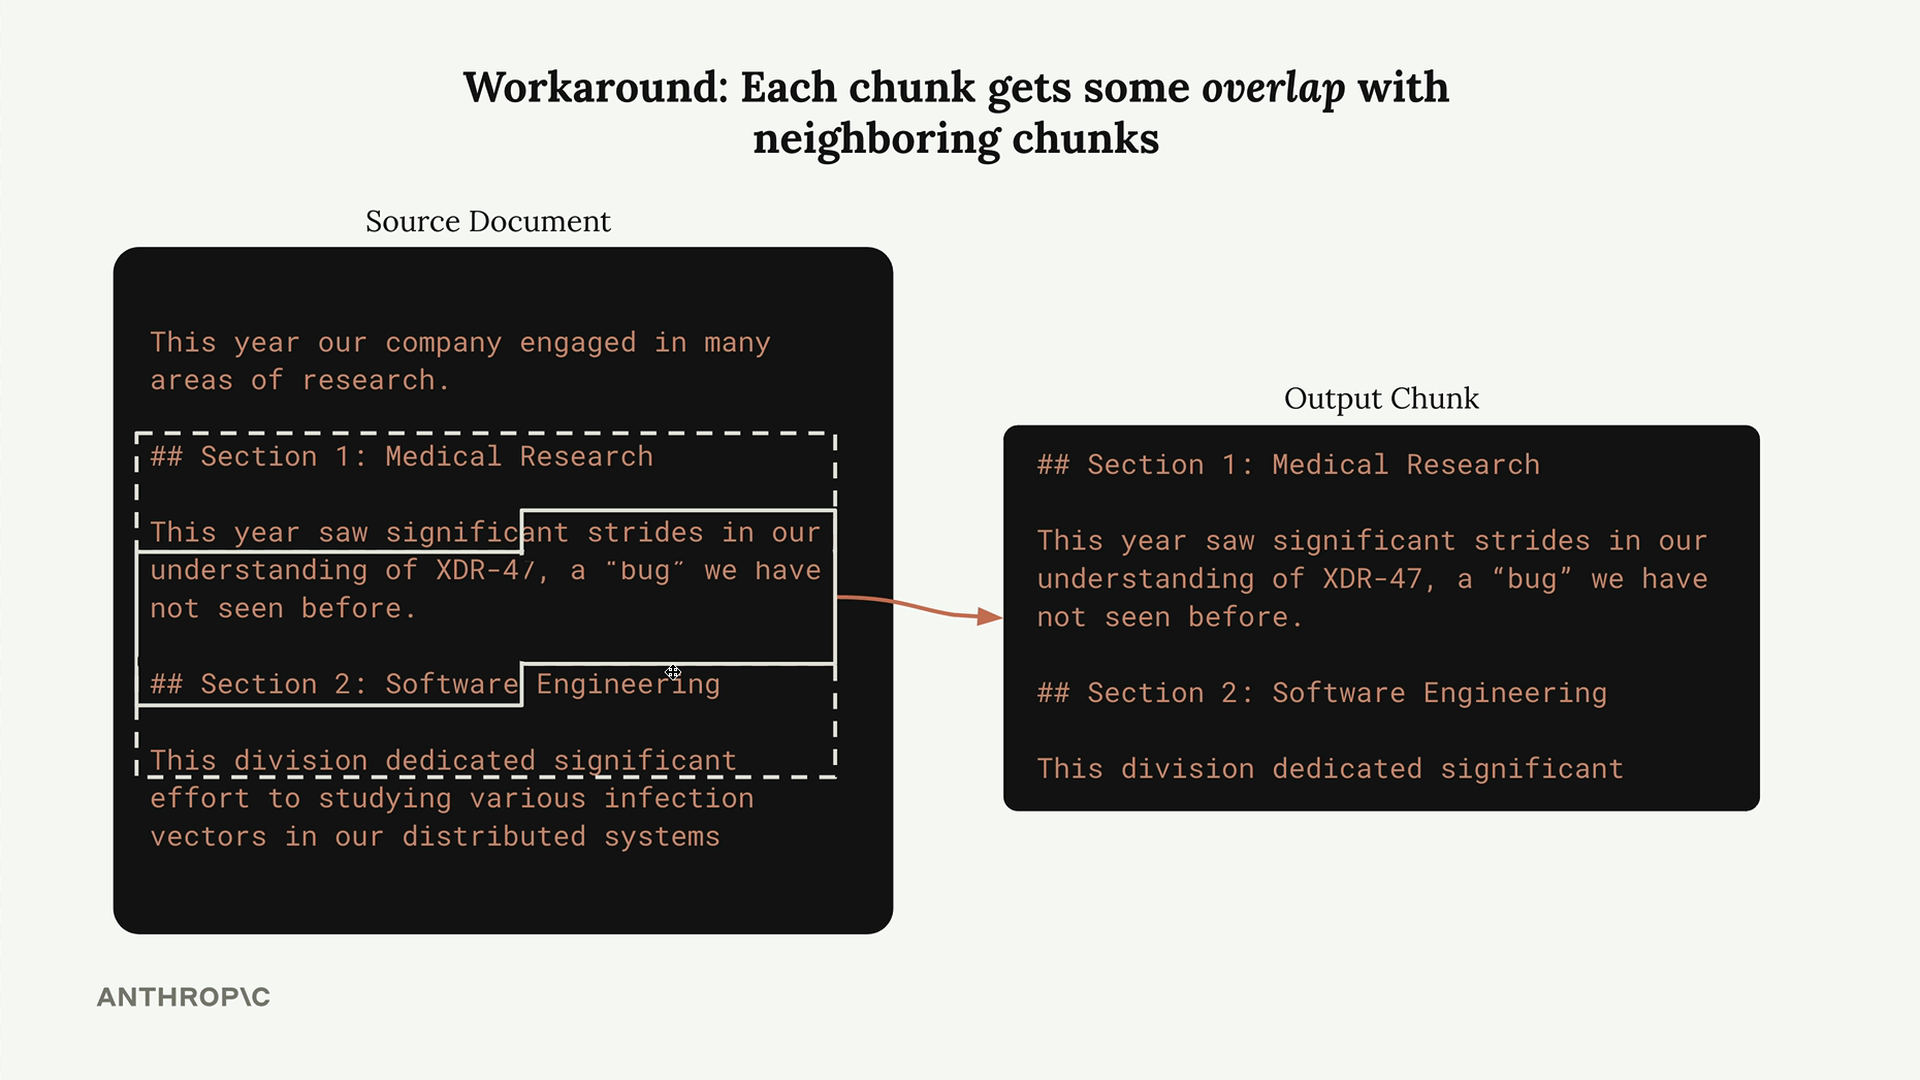
Hier ist eine grundlegende Implementierung der zeichenbasierten Textaufteilung mit Überlappung:
def chunk_by_char(text, chunk_size=150, chunk_overlap=20):
    chunks = []
    start_idx = 0

    while start_idx < len(text):
        end_idx = min(start_idx + chunk_size, len(text))
        chunk_text = text[start_idx:end_idx]
        chunks.append(chunk_text)

        start_idx = (
            end_idx - chunk_overlap if end_idx < len(text) else len(text)
        )

    return chunks
Strukturbasierte Textaufteilung
Die strukturbasierte Textaufteilung nutzt die natürliche Organisation deiner Dokumente. Wenn du mit Markdown-Dateien arbeitest, kannst du an Überschriften aufteilen. Bei anderen Formaten kannst du an Absätzen oder anderen strukturellen Elementen aufteilen.
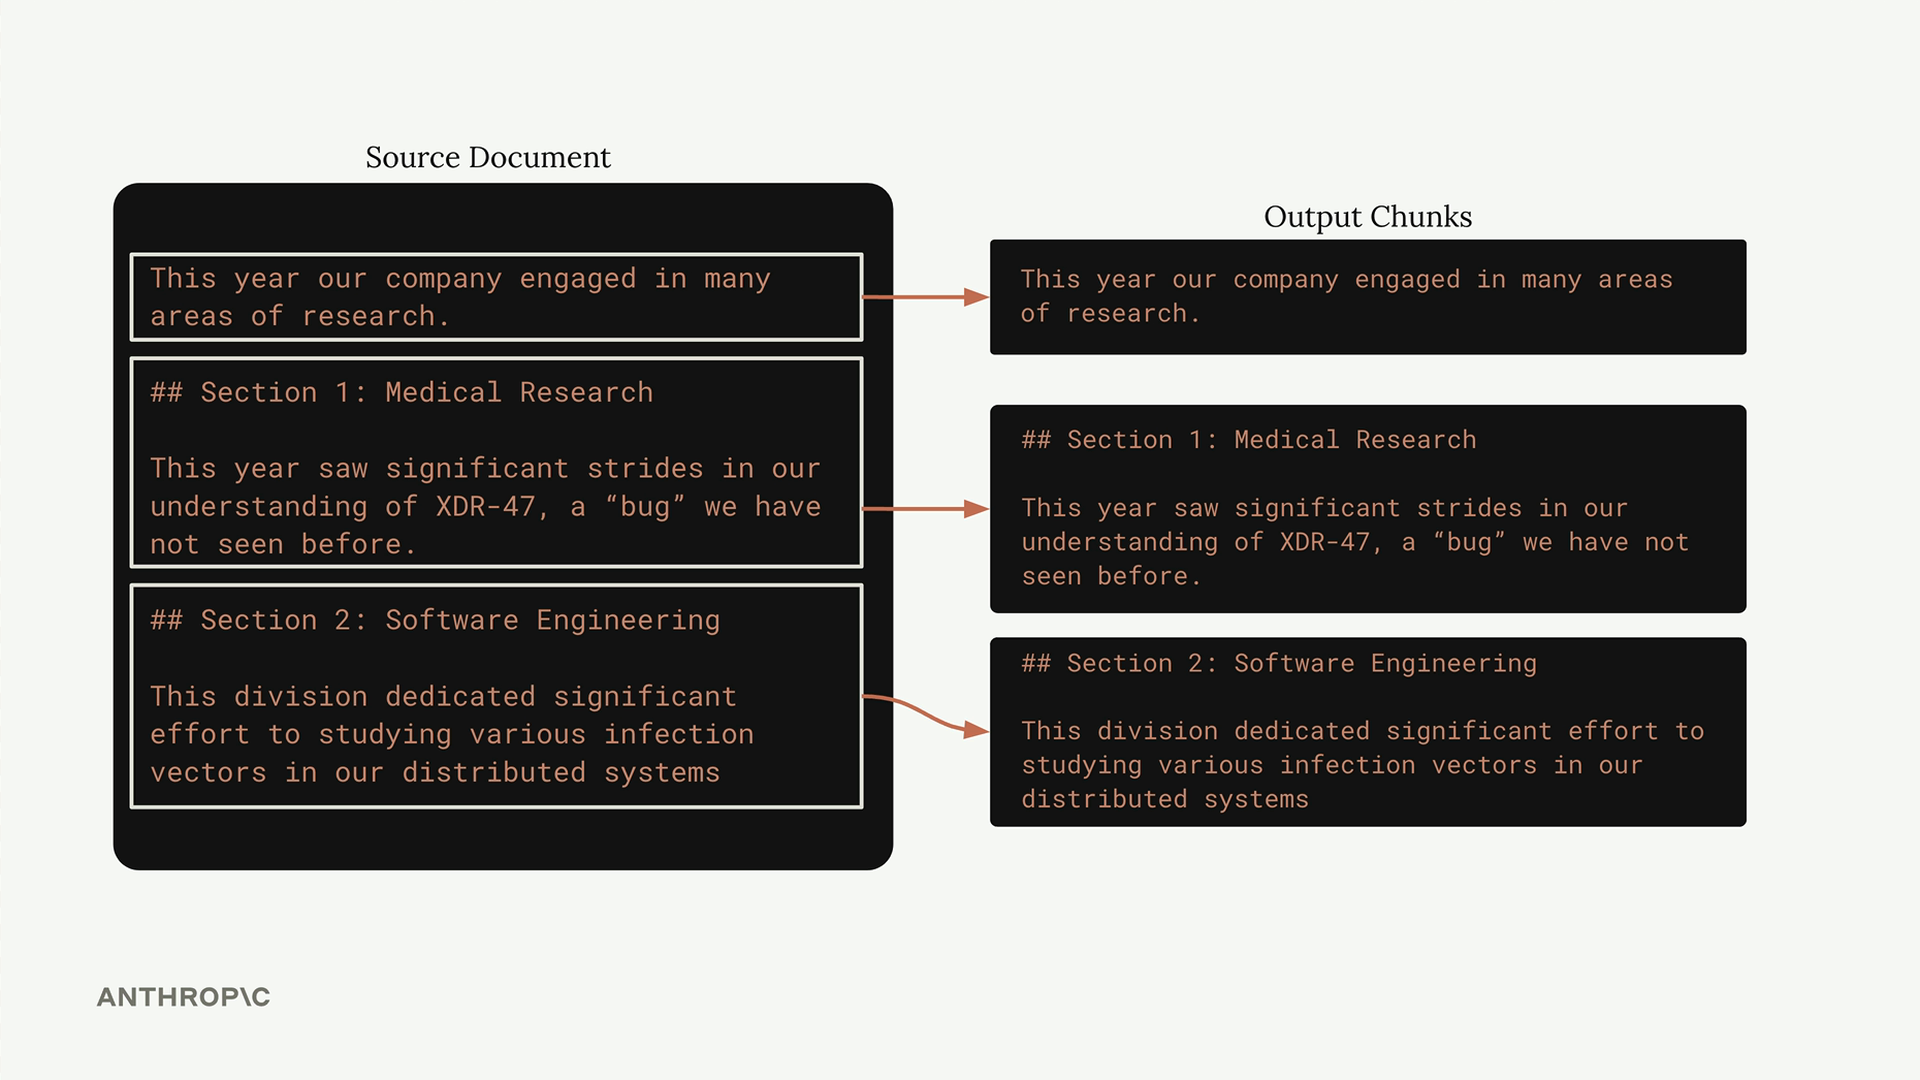
Dieser Ansatz funktioniert hervorragend, wenn du Garantien über die Dokumentstruktur hast. Bei Markdown-Dokumenten kannst du an Abschnittsüberschriften aufteilen:
import re

def chunk_by_section(document_text):
    pattern = r'\n## '
    return re.split(pattern, document_text)
Die größte Einschränkung besteht darin, dass viele Dokumente keine konsistente Struktur aufweisen. Reine Textdateien, PDFs oder von Nutzern hochgeladene Dokumente verfügen möglicherweise nicht über klare strukturelle Markierungen, an denen man aufteilen könnte.
Semantikbasierte Textaufteilung
Die semantikbasierte Textaufteilung ist der anspruchsvollste Ansatz. Sie analysiert die Bedeutung und die Beziehungen zwischen Sätzen, um zusammenhängende Inhalte zu gruppieren. Dies umfasst typischerweise:
- Text in Sätze aufteilen
- NLP-Techniken verwenden, um die semantische Ähnlichkeit zu messen
- Zusammenhängende Sätze zu kohärenten Chunks gruppieren
Obwohl dies die qualitativ hochwertigsten Chunks hervorbringen kann, ist es rechenintensiv und komplexer zu implementieren. Für die meisten Anwendungen funktionieren die einfacheren Ansätze gut genug.
Praktische Umsetzung
Hier ist eine satzbasierte Chunking-Funktion, die einen guten Mittelweg bietet:
def chunk_by_sentence(text, max_sentences_per_chunk=5, overlap_sentences=1):
    sentences = re.split(r'(?<=[.!?])\s+', text)
    chunks = []
    start_idx = 0

    while start_idx < len(sentences):
        end_idx = min(start_idx + max_sentences_per_chunk, len(sentences))
        current_chunk = sentences[start_idx:end_idx]
        chunks.append(' '.join(current_chunk))

        start_idx += max_sentences_per_chunk - overlap_sentences

        if start_idx < 0:
            start_idx = 0

    return chunks
Die richtige Strategie wählen
Welche Chunking-Strategie du wählst, hängt ganz von deinem spezifischen Anwendungsfall ab:
- Konsistente Dokumentstruktur: Verwende strukturbasierte Textaufteilung für die saubersten Ergebnisse
- Gemischte Dokumenttypen: Satzbasierte Textaufteilung funktioniert oft gut
- Code oder technische Inhalte: Zeichenbasierte Textaufteilung ist am zuverlässigsten
- Unbekannte Dokumentformate: Zeichenbasierte Textaufteilung ist deine sicherste Wahl
Denke daran, dass Chunking oft ein iterativer Prozess ist. Beginne mit einem einfachen Ansatz, teste ihn mit deinen spezifischen Dokumenten und Anwendungsfällen und verfeinere ihn dann basierend auf den Ergebnissen. Die „beste“ Chunking-Strategie ist diejenige, die für deine konkreten Daten und Anforderungen zuverlässig funktioniert.