Kontextbezogenes Retrieval ist eine Technik, die die Genauigkeit von RAG-Pipelines verbessert, indem sie ein grundlegendes Problem löst: Wenn du ein Dokument in Chunks aufteilst, verliert jeder Chunk seine Verbindung zum übergeordneten Dokumentkontext.
Das Problem mit standardmäßigem Chunking
Wenn du ein Quelldokument nimmst und es in Chunks für deine Vektordatenbank aufteilst, weiß jedes einzelne Stück nicht mehr, woher es stammt oder wie es sich zum Rest des Dokuments verhält. Dies kann die Retrieval-Genauigkeit beeinträchtigen, da den Chunks wichtige kontextuelle Informationen fehlen.
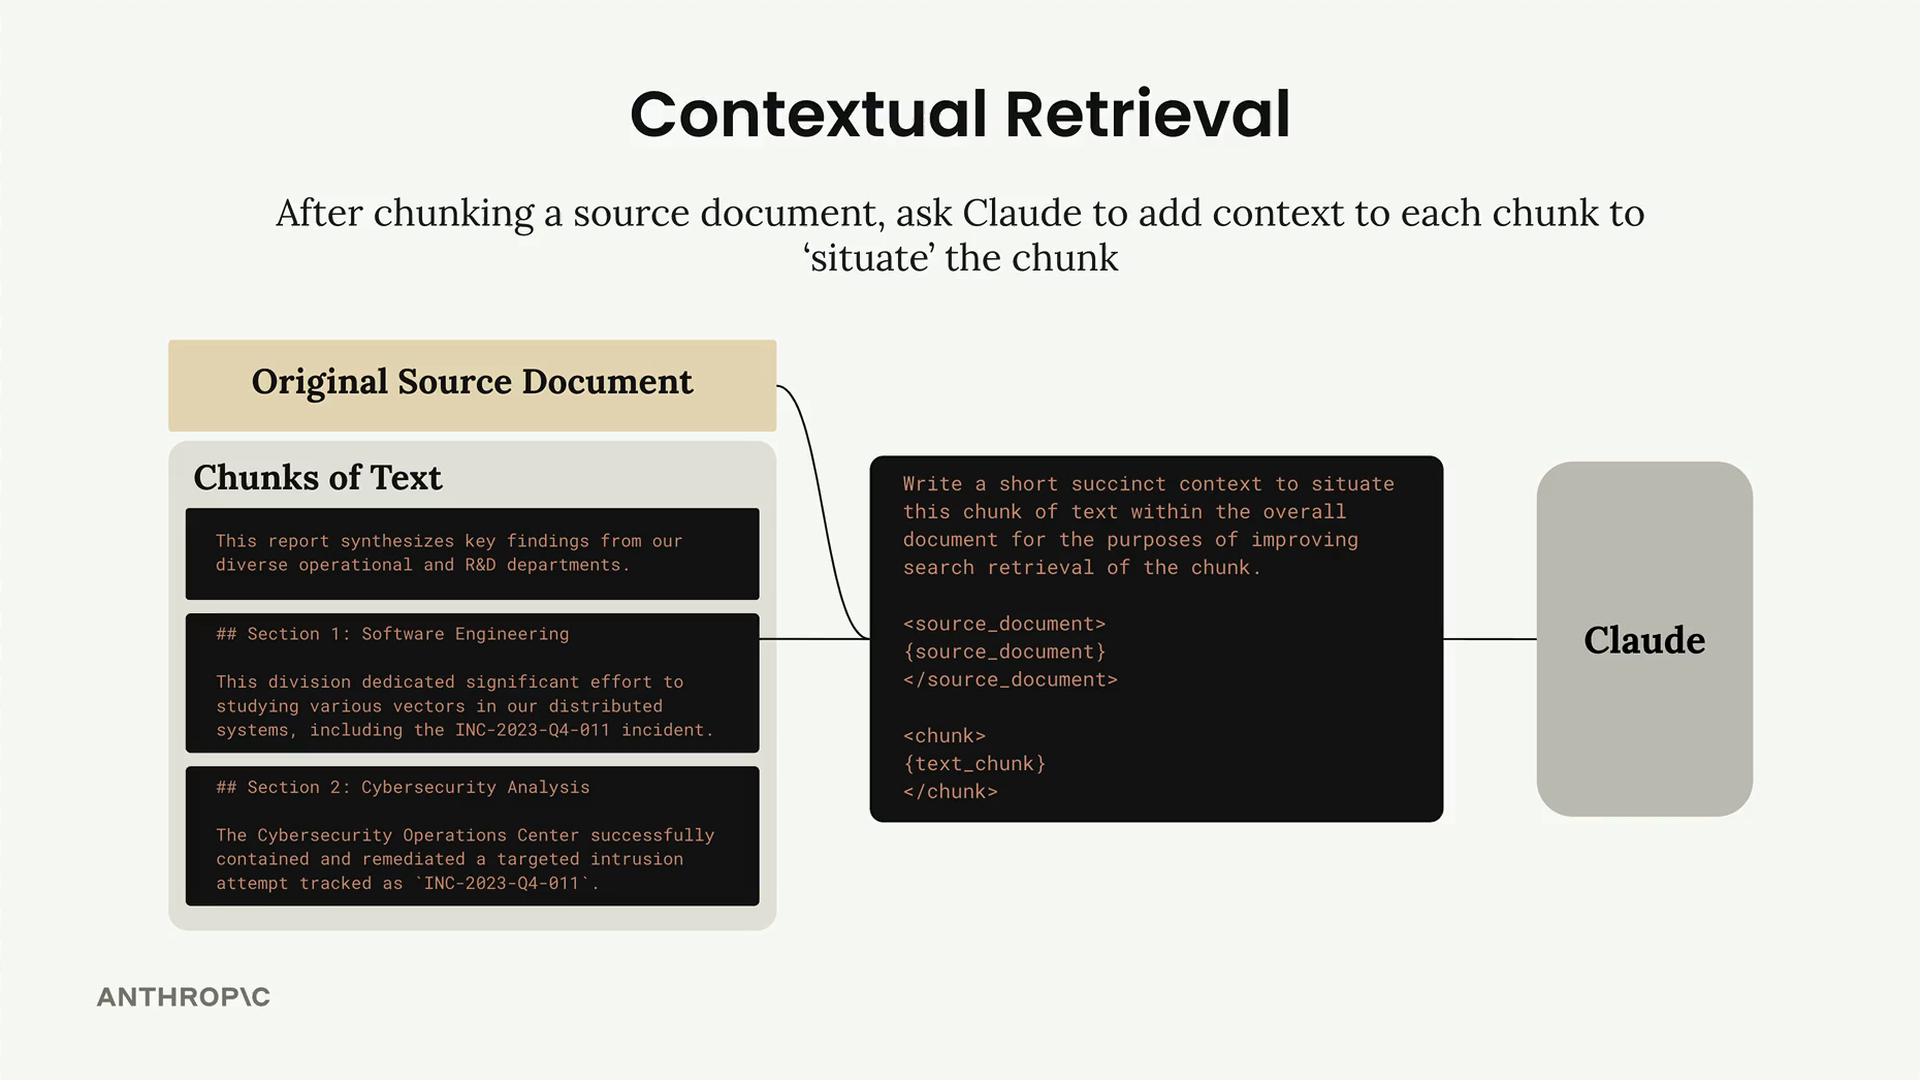
Wie kontextbezogenes Retrieval funktioniert
Kontextbezogenes Retrieval fügt einen Vorverarbeitungsschritt hinzu, bevor Chunks in deine Retriever-Datenbank eingefügt werden. Hier ist der Ablauf:
- Nimm jeden einzelnen Chunk und das ursprüngliche Quelldokument
- Sende beide an Claude mit einem spezifischen Prompt, der Claude bittet, Kontext hinzuzufügen
- Claude generiert einen kurzen Textausschnitt, der den Chunk innerhalb des größeren Dokuments „einordnet“
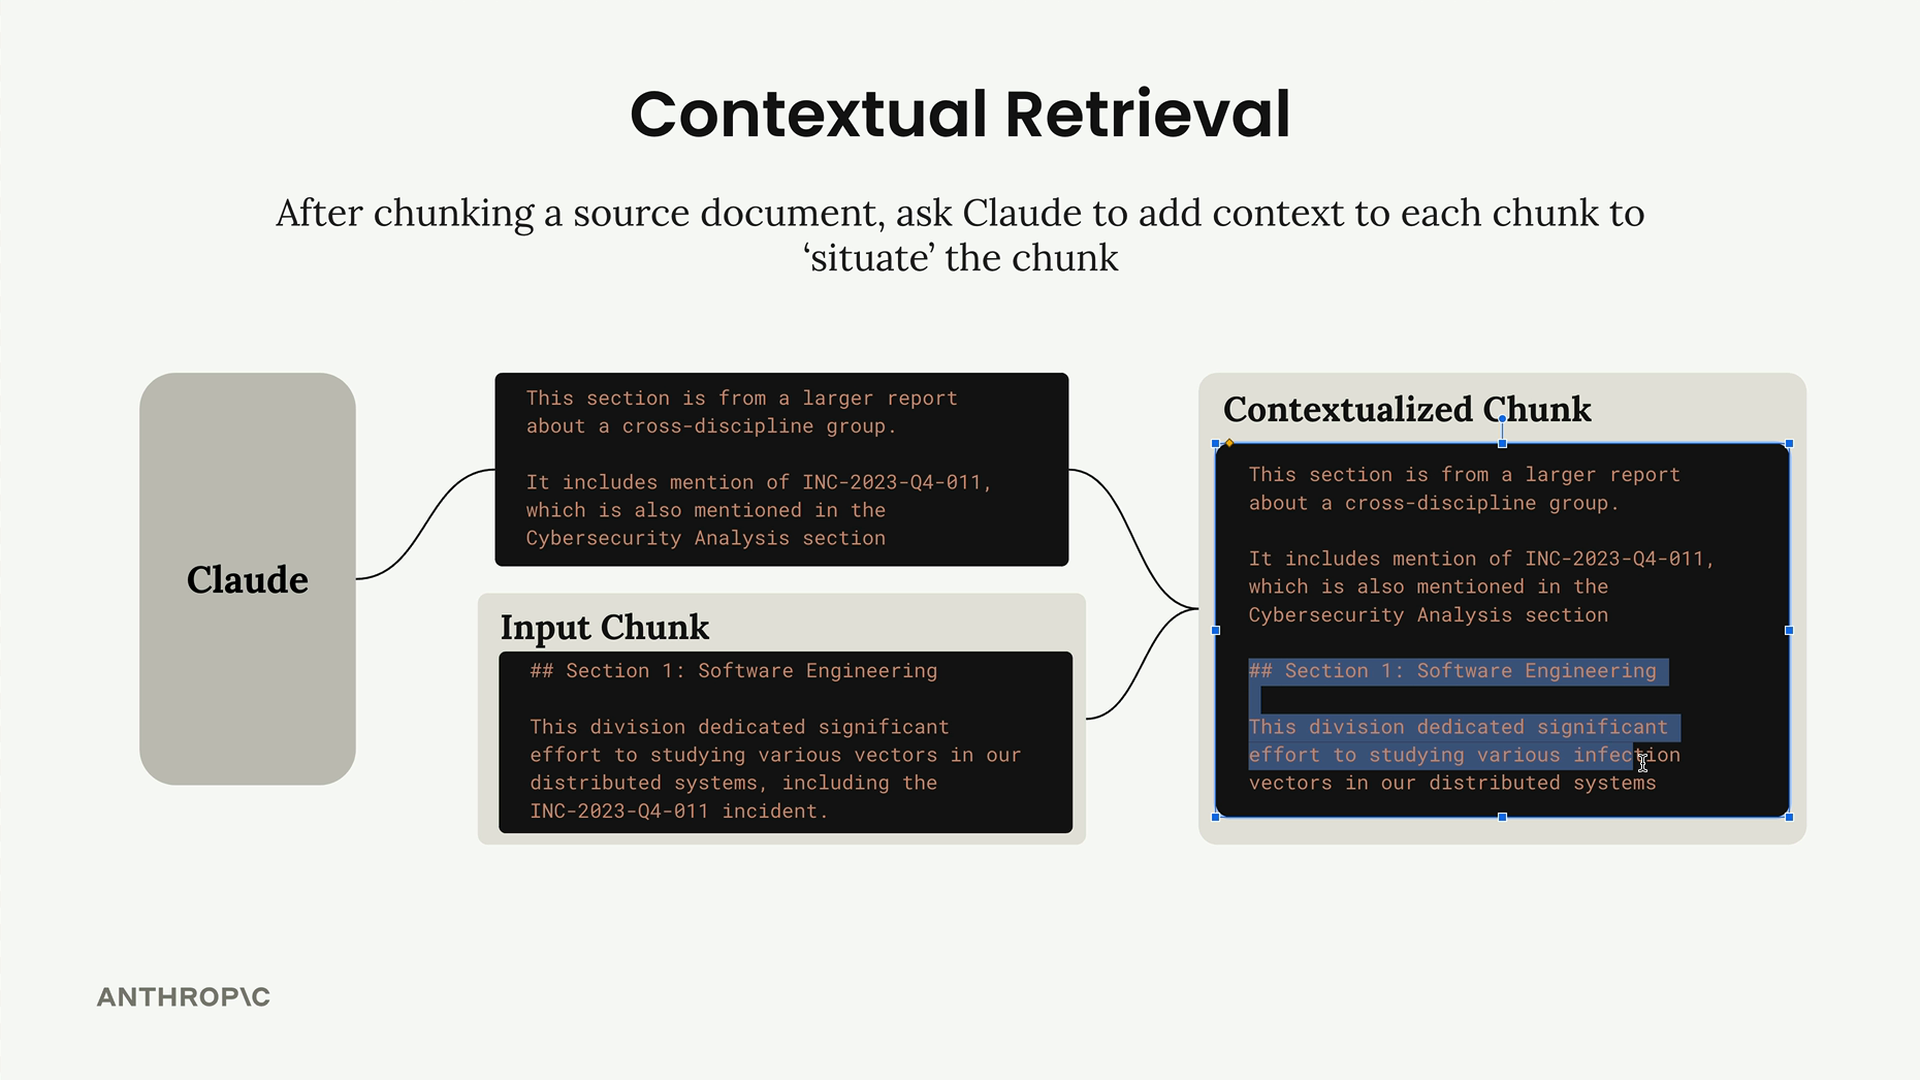
- Kombiniere diesen Kontext mit dem ursprünglichen Chunk, um einen „kontextualisierten Chunk“ zu erstellen
- Verwende den kontextualisierten Chunk in deinen Vektor- und BM25-Indizes
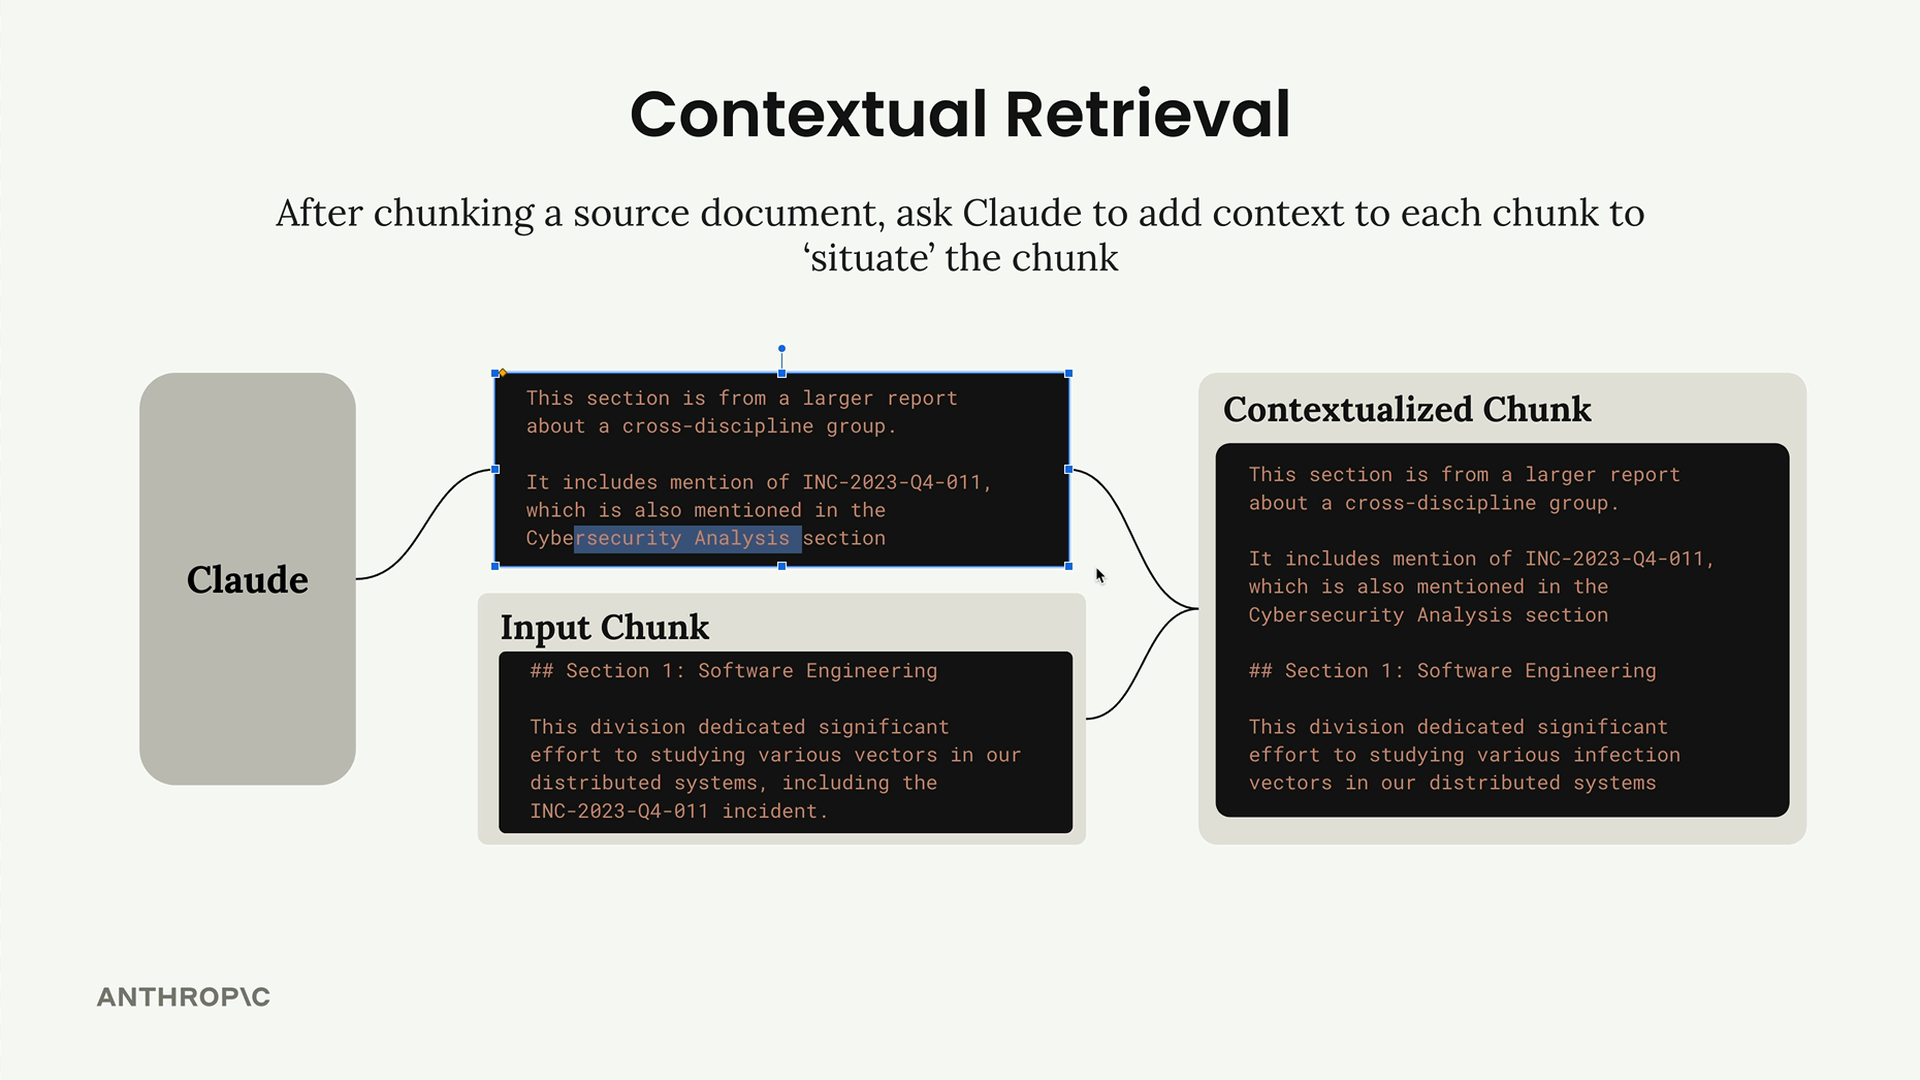
Wenn du zum Beispiel einen Abschnitt über Softwareentwicklung hast, der einen Vorfall aus dem Jahr 2023 erwähnt, könnte Claude einen Kontext wie diesen generieren: „Dieser Abschnitt stammt aus einem größeren Bericht über eine disziplinübergreifende Gruppe. Er enthält eine Erwähnung von INC-2023-04-011, die auch im Abschnitt Cybersicherheitsanalyse erwähnt wird.“
Umgang mit großen Dokumenten
Ein häufiges Problem tritt auf, wenn dein Quelldokument zu groß ist, um in Claudes Kontextfenster zu passen. Du kannst kontextbezogenes Retrieval dennoch verwenden, indem du eine reduzierte Menge an Kontext bereitstellst:
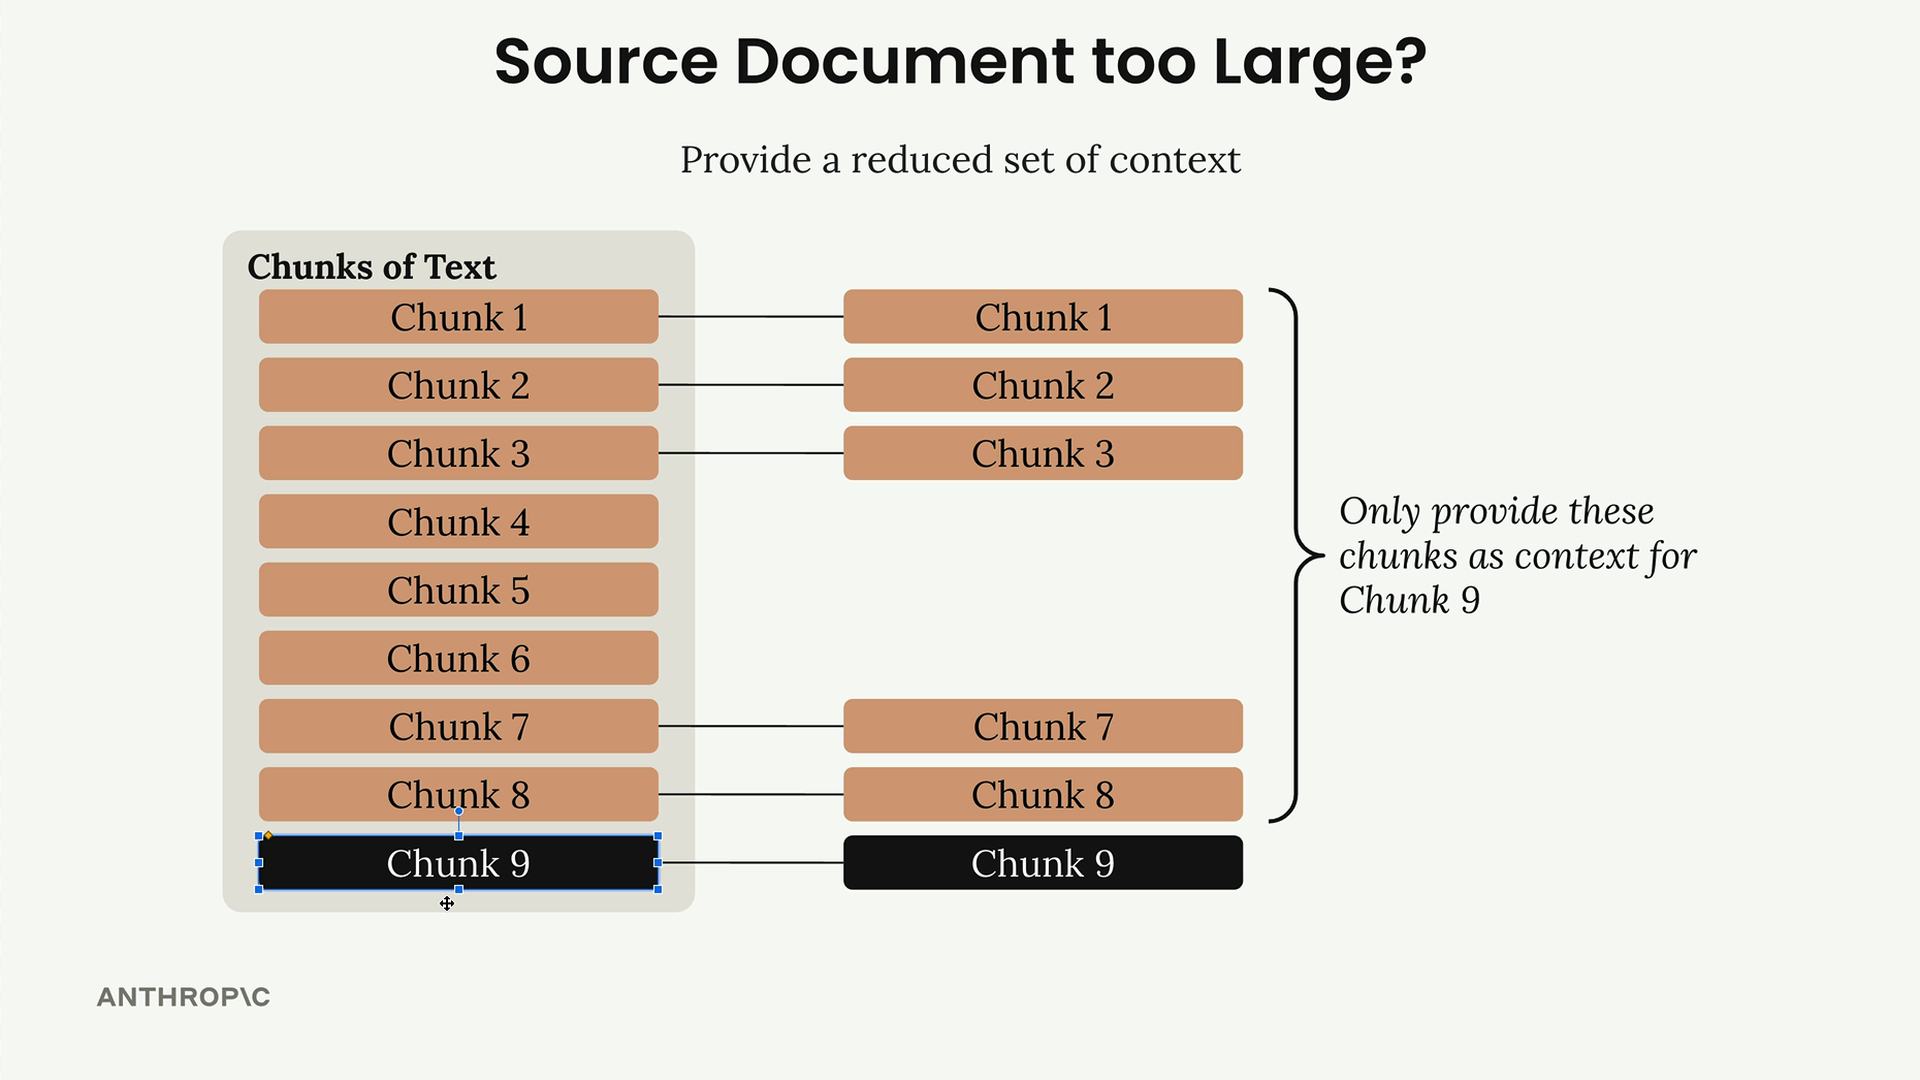
Anstatt das gesamte Dokument einzuschließen, stelle Folgendes bereit:
- Ein paar Chunks vom Anfang des Dokuments (die oft Zusammenfassungen oder Abstracts enthalten)
- Chunks unmittelbar vor dem Chunk, den du kontextualisierst
Dieser Ansatz gibt Claude genug Informationen, um die Dokumentstruktur und den unmittelbaren Kontext zu verstehen, ohne den Prompt zu überladen.
Implementierungsbeispiel
Hier ist eine grundlegende Funktion zum Hinzufügen von Kontext zu Chunks:
def add_context(text_chunk, source_text):
    prompt = f"""
Write a short and succinct snippet of text to situate this chunk within the
overall source document for the purposes of improving search retrieval of the chunk.

Here is the original source document:
<document>
{source_text}
</document>

Here is the chunk we want to situate within the whole document:
<chunk>
{text_chunk}
</chunk>

Answer only with the succinct context and nothing else.
"""

    messages = []
    add_user_message(messages, prompt)
    result = chat(messages)

    return text_from_message(result) + "\n" + text_chunk
Für große Dokumente kannst du eine Strategie implementieren, die relevante Kontext-Chunks auswählt:
# Füge jedem Chunk Kontext hinzu und dann zum Retriever hinzu
num_start_chunks = 2
num_prev_chunks = 2

for i, chunk in enumerate(chunks):
    context_parts = []

    # Anfängliche Menge an Chunks vom Beginn des Dokuments
    context_parts.extend(chunks[: min(num_start_chunks, len(chunks))])

    # Zusätzliche Chunks nach dem aktuellen Chunk, den wir kontextualisieren
    start_idx = max(0, i - num_prev_chunks)
    context_parts.extend(chunks[start_idx:i])

    context = "\n".join(context_parts)

    contextualized_chunk = add_context(chunk, context)
    retriever.add_document({"content": contextualized_chunk})
Wann kontextbezogenes Retrieval verwendet werden sollte
Diese Technik ist am wertvollsten, wenn:
- Deine Dokumente komplexe interne Beziehungen zwischen Abschnitten haben
- Chunks auf Konzepte verweisen, die an anderer Stelle im Dokument definiert sind
- Das Verständnis der Dokumentstruktur für ein genaues Retrieval wichtig ist
- Du mit technischen Dokumenten, Berichten oder wissenschaftlichen Arbeiten arbeitest
Während kontextbezogenes Retrieval zusätzliche Verarbeitungszeit und Kosten verursacht (da du zusätzliche API-Aufrufe tätigst), kann es die Retrieval-Genauigkeit für komplexe Dokumente, bei denen Kontext wichtig ist, erheblich verbessern.