加载中
在将文档分割成块之后,RAG 流程中的下一步是找出哪些块与用户的问题最相关。这从根本上说是一个搜索问题——您需要查看所有文本块,并识别出与用户所问内容相关的那些。
查找相关的块
挑战在于确定哪些块与用户的问题"相关"。这并不像关键词匹配那么简单——您需要理解问题和文本块两者的含义和语境。
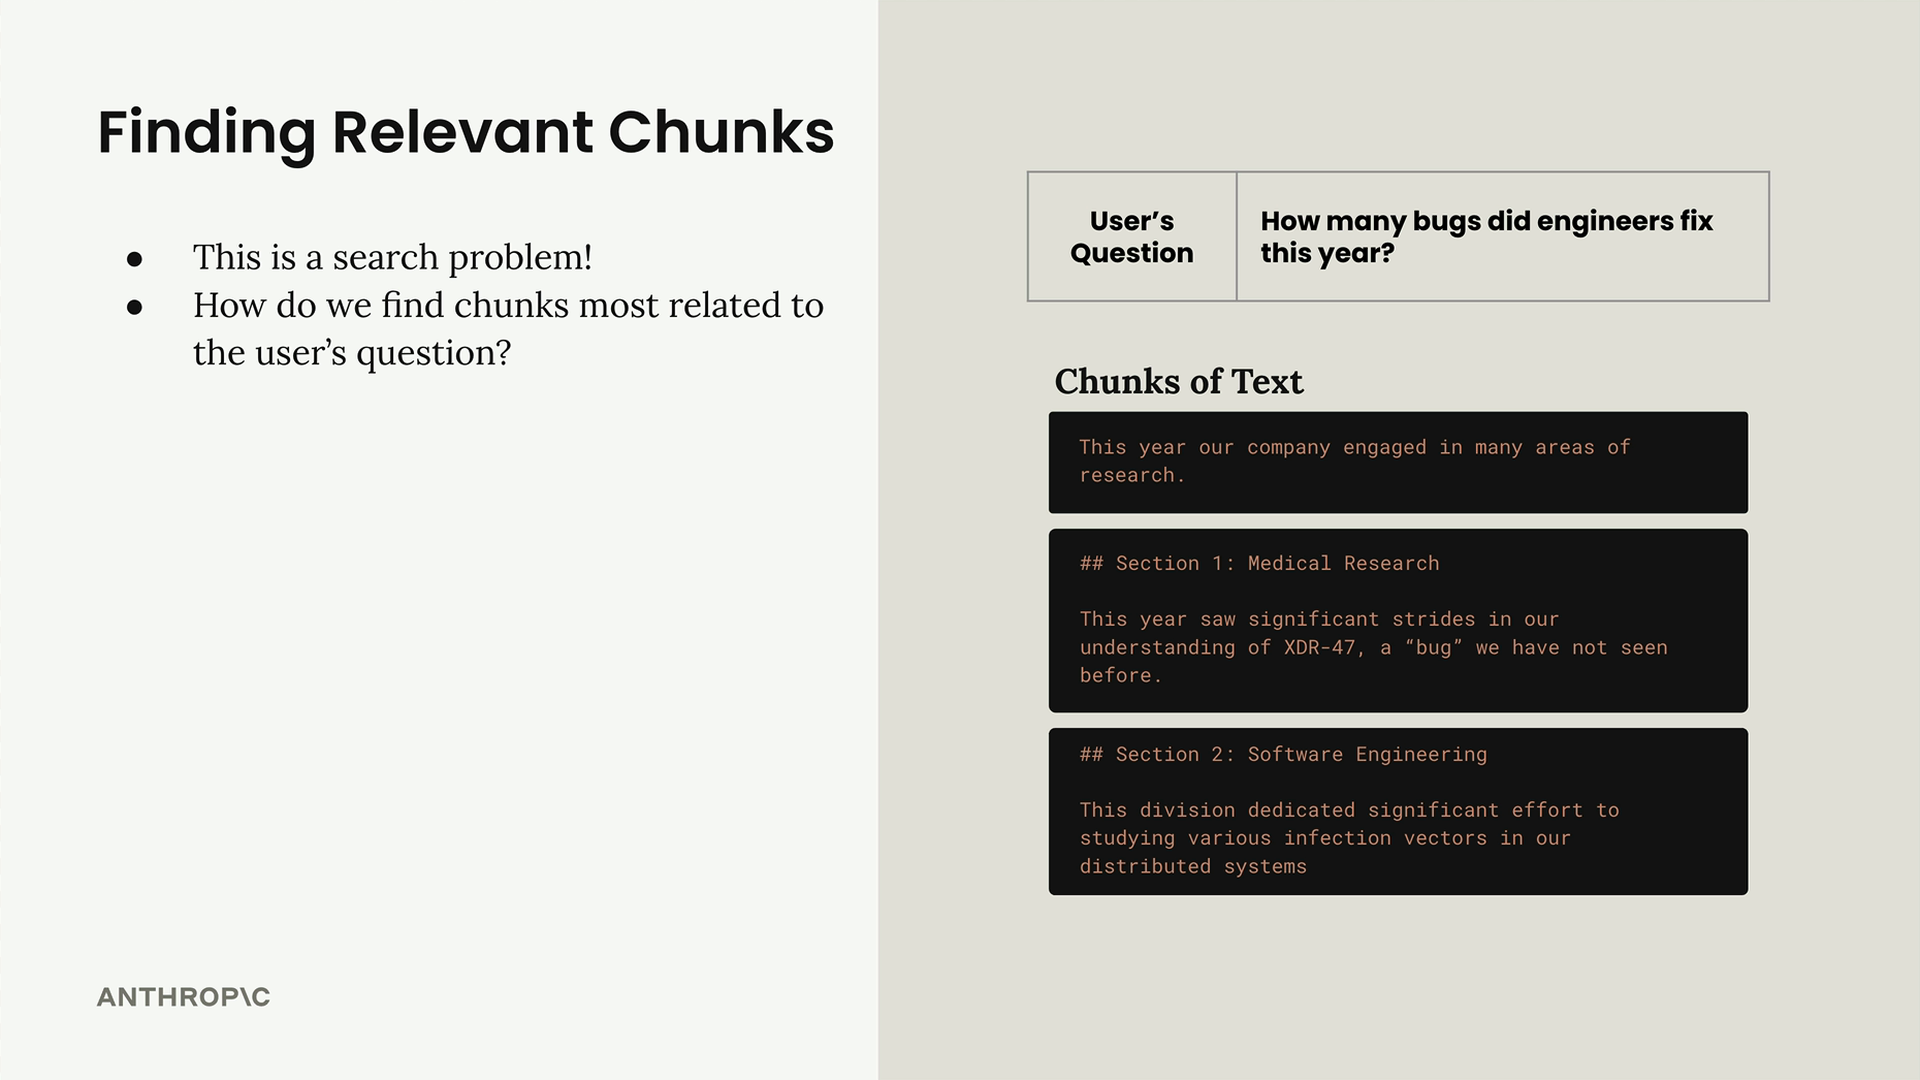
最常见的解决方案是语义搜索,它使用文本嵌入来理解每段文本实际在讲什么,而不仅仅是寻找精确的单词匹配。
什么是文本嵌入?
文本嵌入是对某段文本中所包含含义的数值表示。可以将其理解为把词语和句子转换成一种计算机可以在数学上处理的格式。
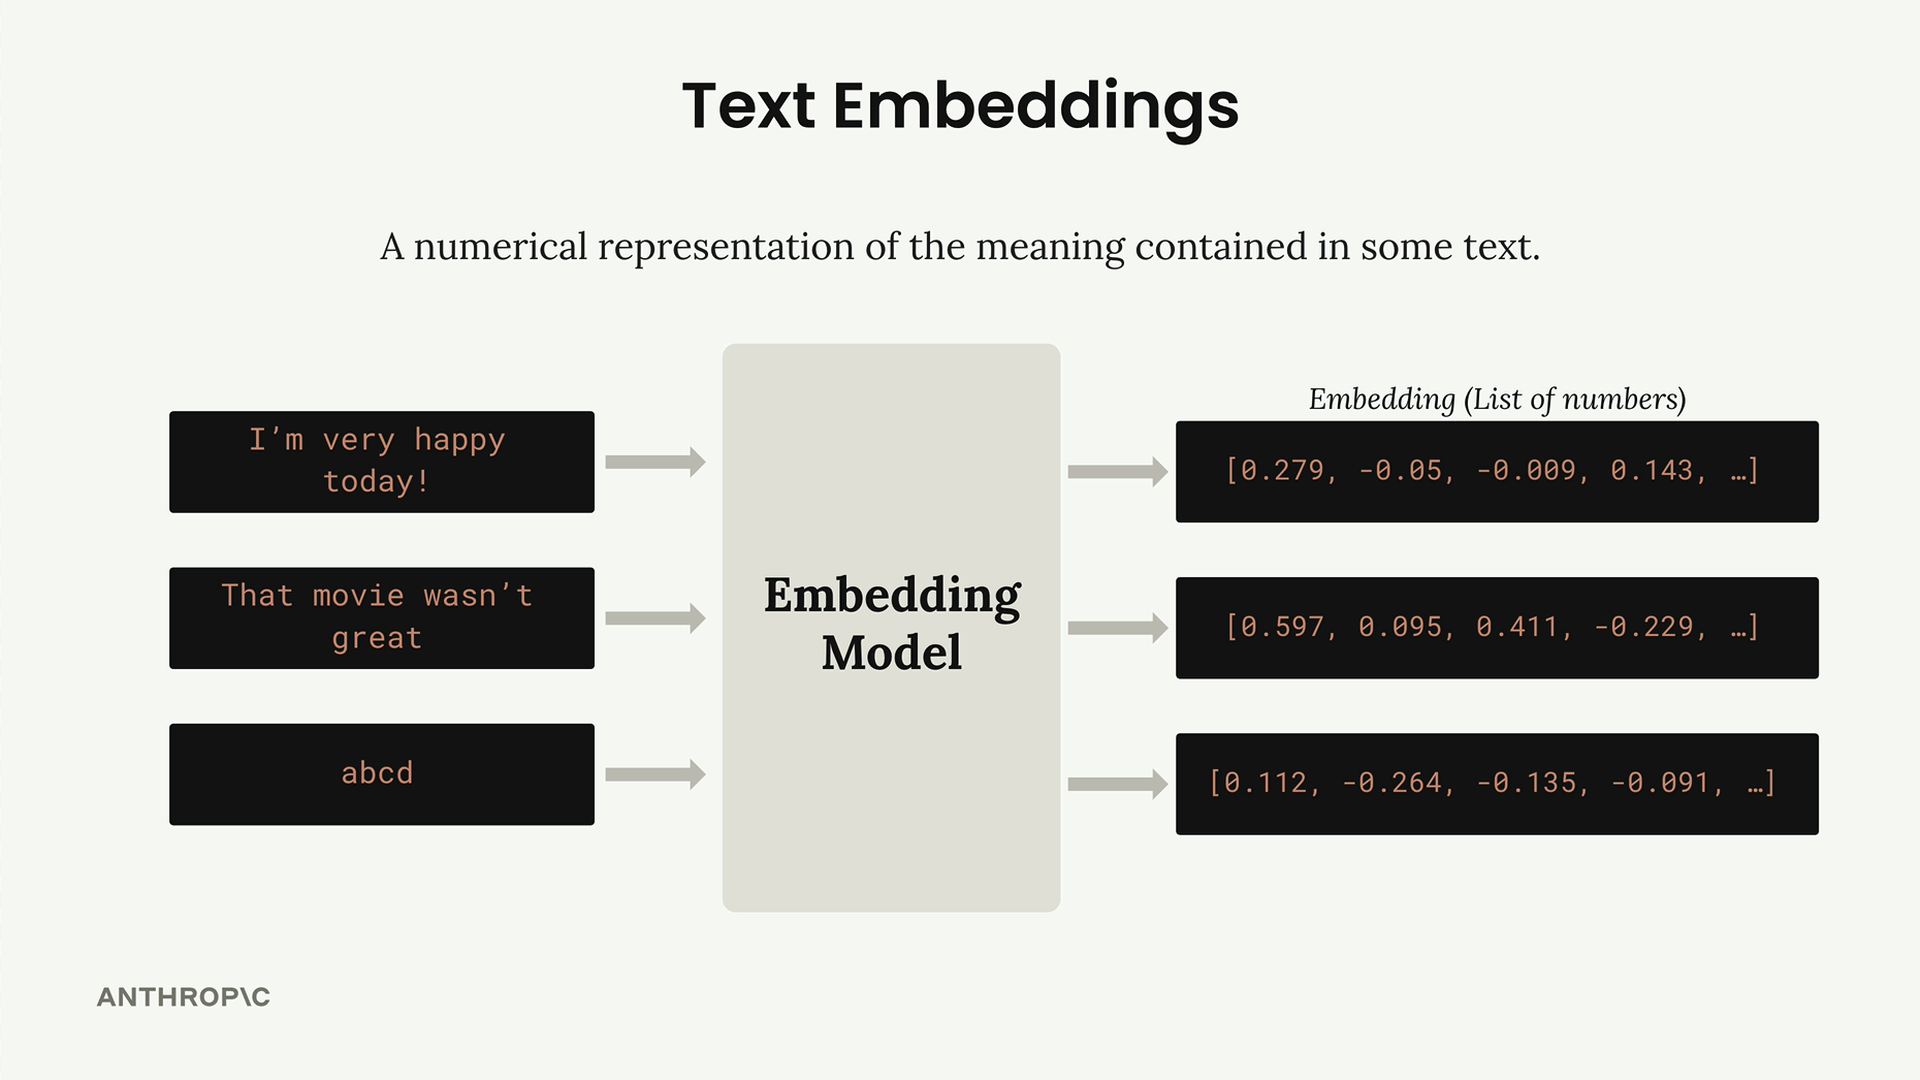
其工作原理如下:
- 您将文本输入到嵌入模型中
- 模型输出一长串数字(通常是1024个数字)
- 每个数字代表输入文本某种特征的"分数"
- 这些数字的范围在-1到+1之间
理解这些数字
嵌入中的每个数字就像是文本某个方面的分数。虽然我们并不确切知道每个位置代表什么,但将它们理解为衡量不同特质的指标会有所帮助。
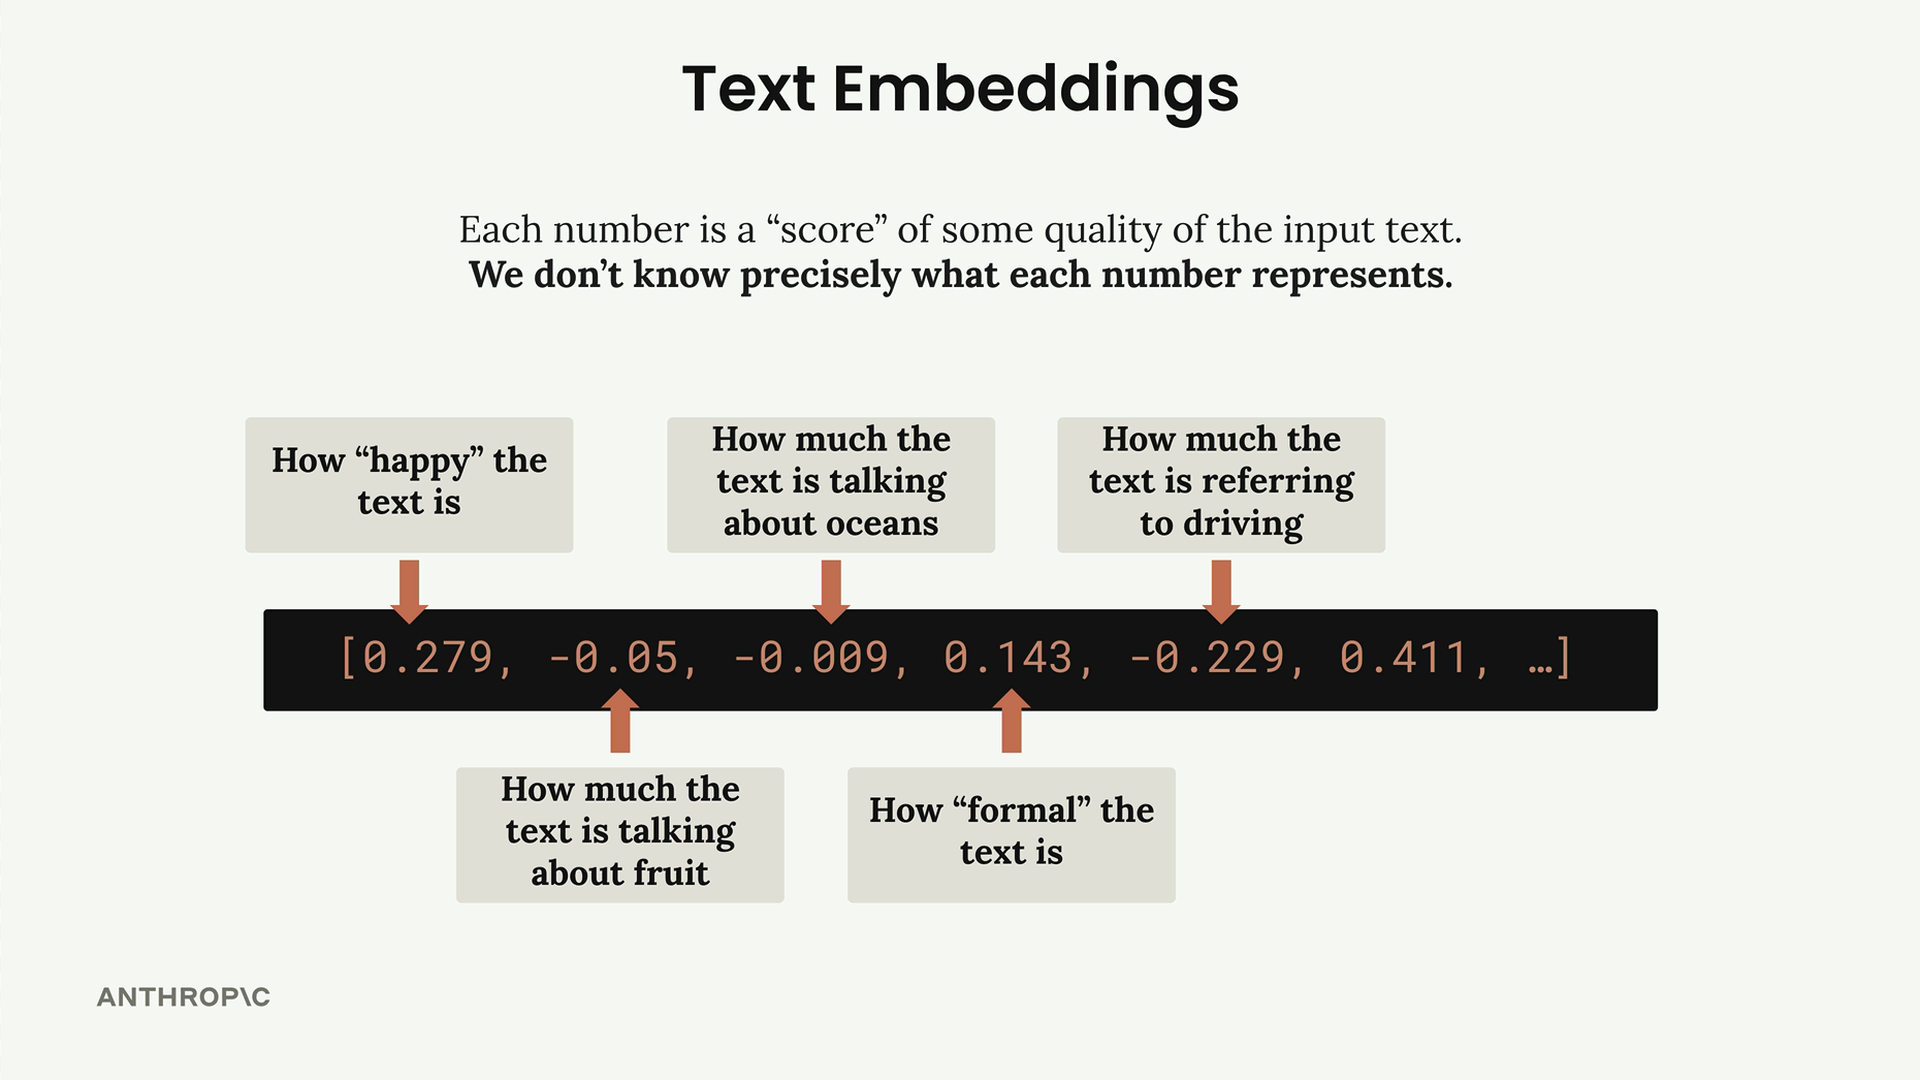
例如,某个数字可能对"文本有多快乐"进行打分,而另一个数字可能衡量"文本谈论海洋的程度"。关键点在于,我们实际上并不知道每个数字代表什么——嵌入模型在训练过程中学习这些模式,而它们并不是人类可以直接解读的。
用代码生成嵌入
创建嵌入很简单。以下是基本流程:
python
def generate_embedding(
    text,
    embedding_model_id="amazon.titan-embed-text-v2:0",
    dimensions=1024,
    normalize=True,
):
    request_body = {
        "inputText": text,
        "dimensions": dimensions,
        "normalize": normalize,
    }

    request_json = json.dumps(request_body)
    response = client.invoke_model(
        modelId=embedding_model_id,
        body=request_json,
        accept="application/json",
        contentType="application/json",
    )

    response_body = json.loads(response.get("body").read())
    return response_body["embedding"]
当您对一个文本块运行此函数时,您会得到一个包含1024个数字的列表,这些数字代表该文本的语义含义。
请注意,您可能需要在 AWS Bedrock 控制台中申请访问 Titan 嵌入模型的权限。如果版本2不可用,版本1对于学习目的来说同样有效。
为什么嵌入对 RAG 很重要
当您意识到相似的文本会有相似的嵌入值时,嵌入的威力就显而易见了。这意味着您可以通过数学方法将用户的问题与文档块进行比较,并找到语义上最相似的那些——即使它们并不包含完全相同的词语。
正是这种数值表示方式使语义搜索成为可能,并且在为 RAG 系统查找相关上下文方面,比简单的关键词匹配有效得多。