加载中
基于代码的评分通过检查模型输出是否遵循正确的格式并具有有效的语法,为您的提示评估增加了一层额外的验证。这在您要求模型生成代码、JSON 或正则表达式时特别有用。
代码评分的工作原理
代码评分器评估两个主要标准:
- 格式合规性 - 输出是否只包含所请求的格式(Python、JSON 或正则表达式),而不包含任何说明?
- 有效语法 - 输出是否能够被成功解析或编译?
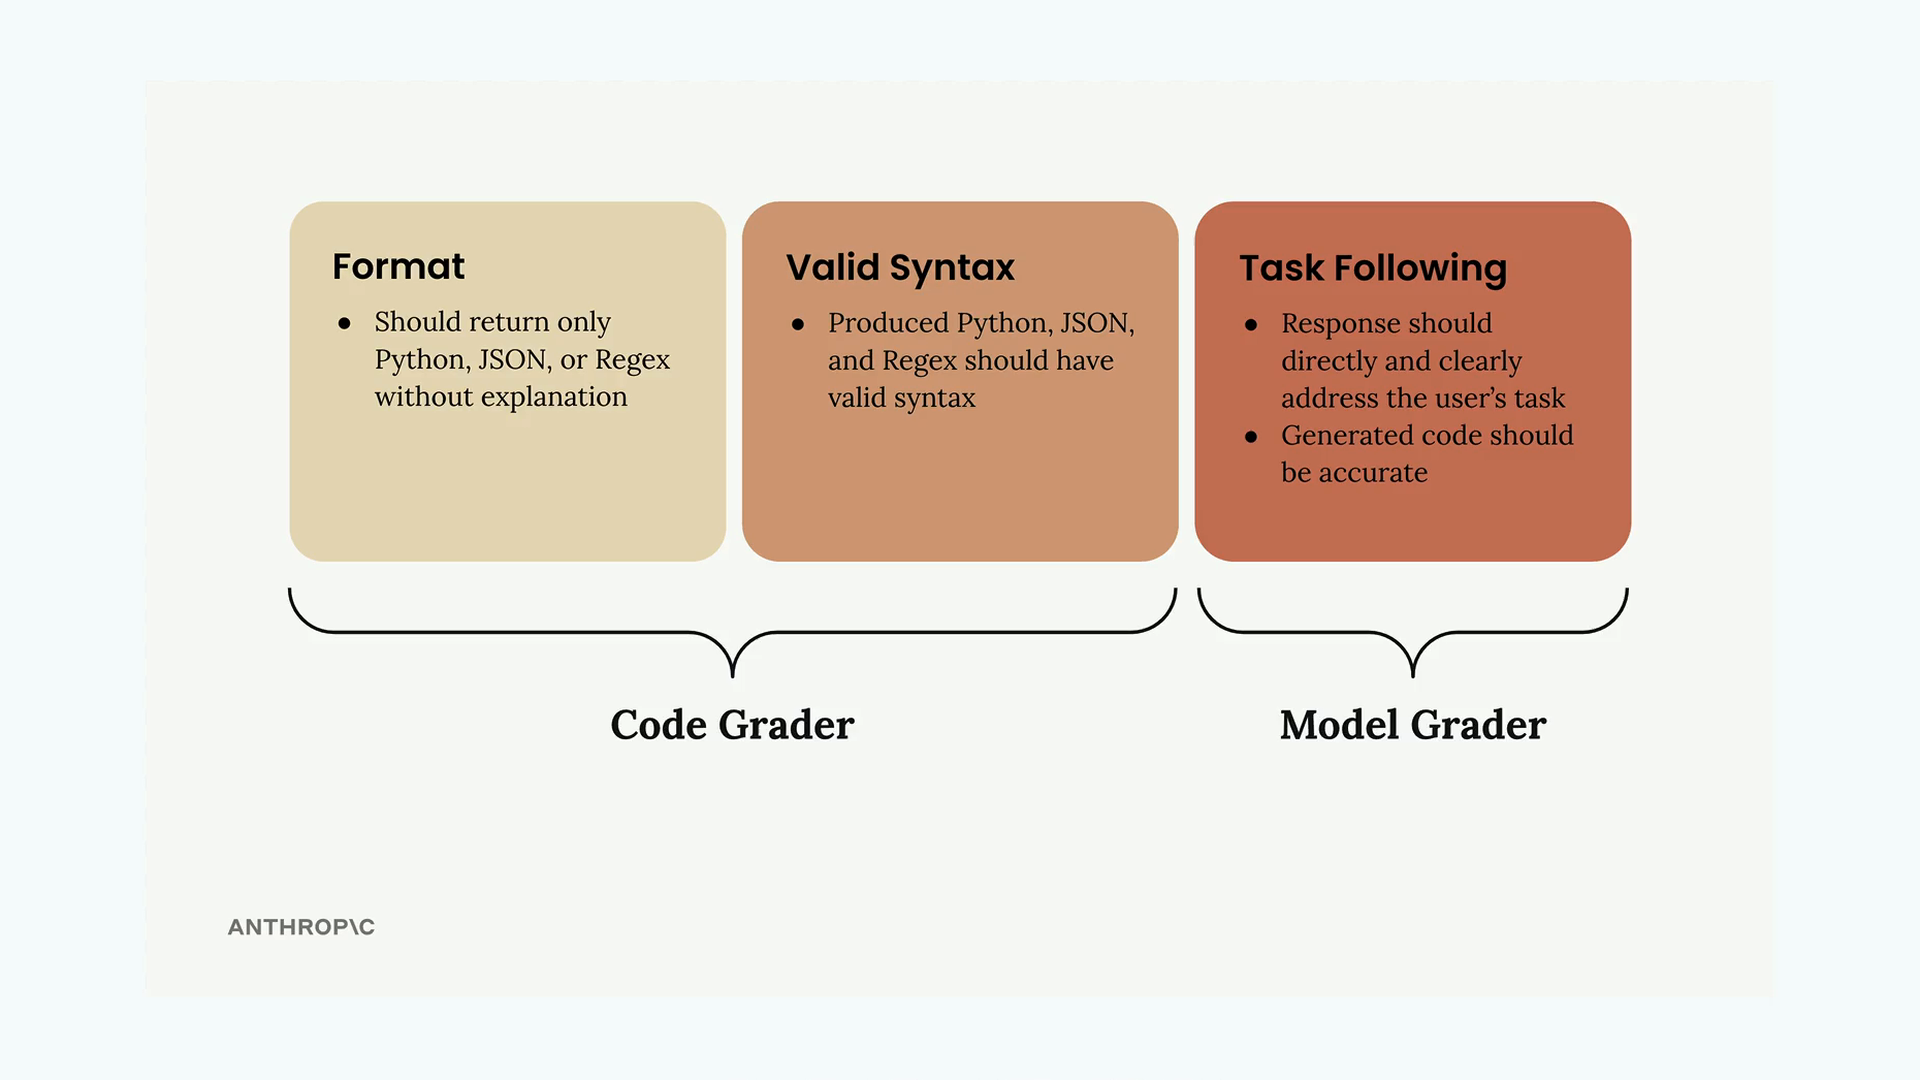
系统为每种格式类型使用单独的验证函数。如果代码解析成功,则获得满分 10 分。如果解析失败并出现错误,则得分为 0。
设置验证函数
您需要三个辅助函数来验证不同的输出类型:
python
import ast
import json
import re

def validate_json(text):
    try:
        json.loads(text.strip())
        return 10
    except json.JSONDecodeError:
        return 0

def validate_python(text):
    try:
        ast.parse(text.strip())
        return 10
    except SyntaxError:
        return 0

def validate_regex(text):
    try:
        re.compile(text.strip())
        return 10
    except re.error:
        return 0
这些函数使用 Python 的内置解析功能来检查语法有效性。json.loads() 函数用于验证 JSON,ast.parse() 用于创建 Python 抽象语法树,而 re.compile() 用于验证正则表达式。
向测试用例添加格式信息
您的测试数据集需要为每个任务指定预期的输出格式。更新您的数据集生成提示,以包含一个格式字段:
json
{
    "task": "Description of task",
    "format": "python"
}
格式字段应包含 "json"、"python" 或 "regex",具体取决于您期望该特定任务产生哪种类型的输出。
改进您的提示
为了从代码评分器获得更好的结果,请使您的提示指令更加具体:
* Respond only with Python, JSON, or a plain Regex
* Do not add any comments or commentary or explanation您还可以使用带有代码块和停止序列的预填充助手消息,以确保输出格式清晰整洁。
合并分数
首先,为每个测试用例选择匹配的验证器:
python
def grade_syntax(output, test_case):
    if test_case["format"] == "json":
        return validate_json(output)
    if test_case["format"] == "python":
        return validate_python(output)
    return validate_regex(output)
最后一步是将模型评分器的分数与语法评分器的分数合并。一种简单的方法是在 run_test_case 内取两个分数的平均值:
python
model_grade = grade_by_model(test_case, output)
model_score = model_grade["score"]
syntax_score = grade_syntax(output, test_case)

score = (model_score + syntax_score) / 2
这使内容质量(来自模型评分器)和技术正确性(来自代码评分器)获得同等的权重。您可以根据对您的特定用例而言哪个因素更重要来调整这种权重。
解读结果
运行评估后,您会得到一个综合分数,该分数同时反映了生成代码的语义质量和技术正确性。请记住,单独的一个分数并不能说明太多问题——真正的价值在于在迭代提示设计的过程中比较各次分数。
使用这个基准分数来测试提示的改进效果,看看您的更改是否真的带来了更好、更可靠的代码生成。