上下文检索是一种通过解决一个根本性问题来提高RAG流程准确性的技术:当您将文档拆分为多个块时,每个块都会失去与更广泛文档上下文的联系。
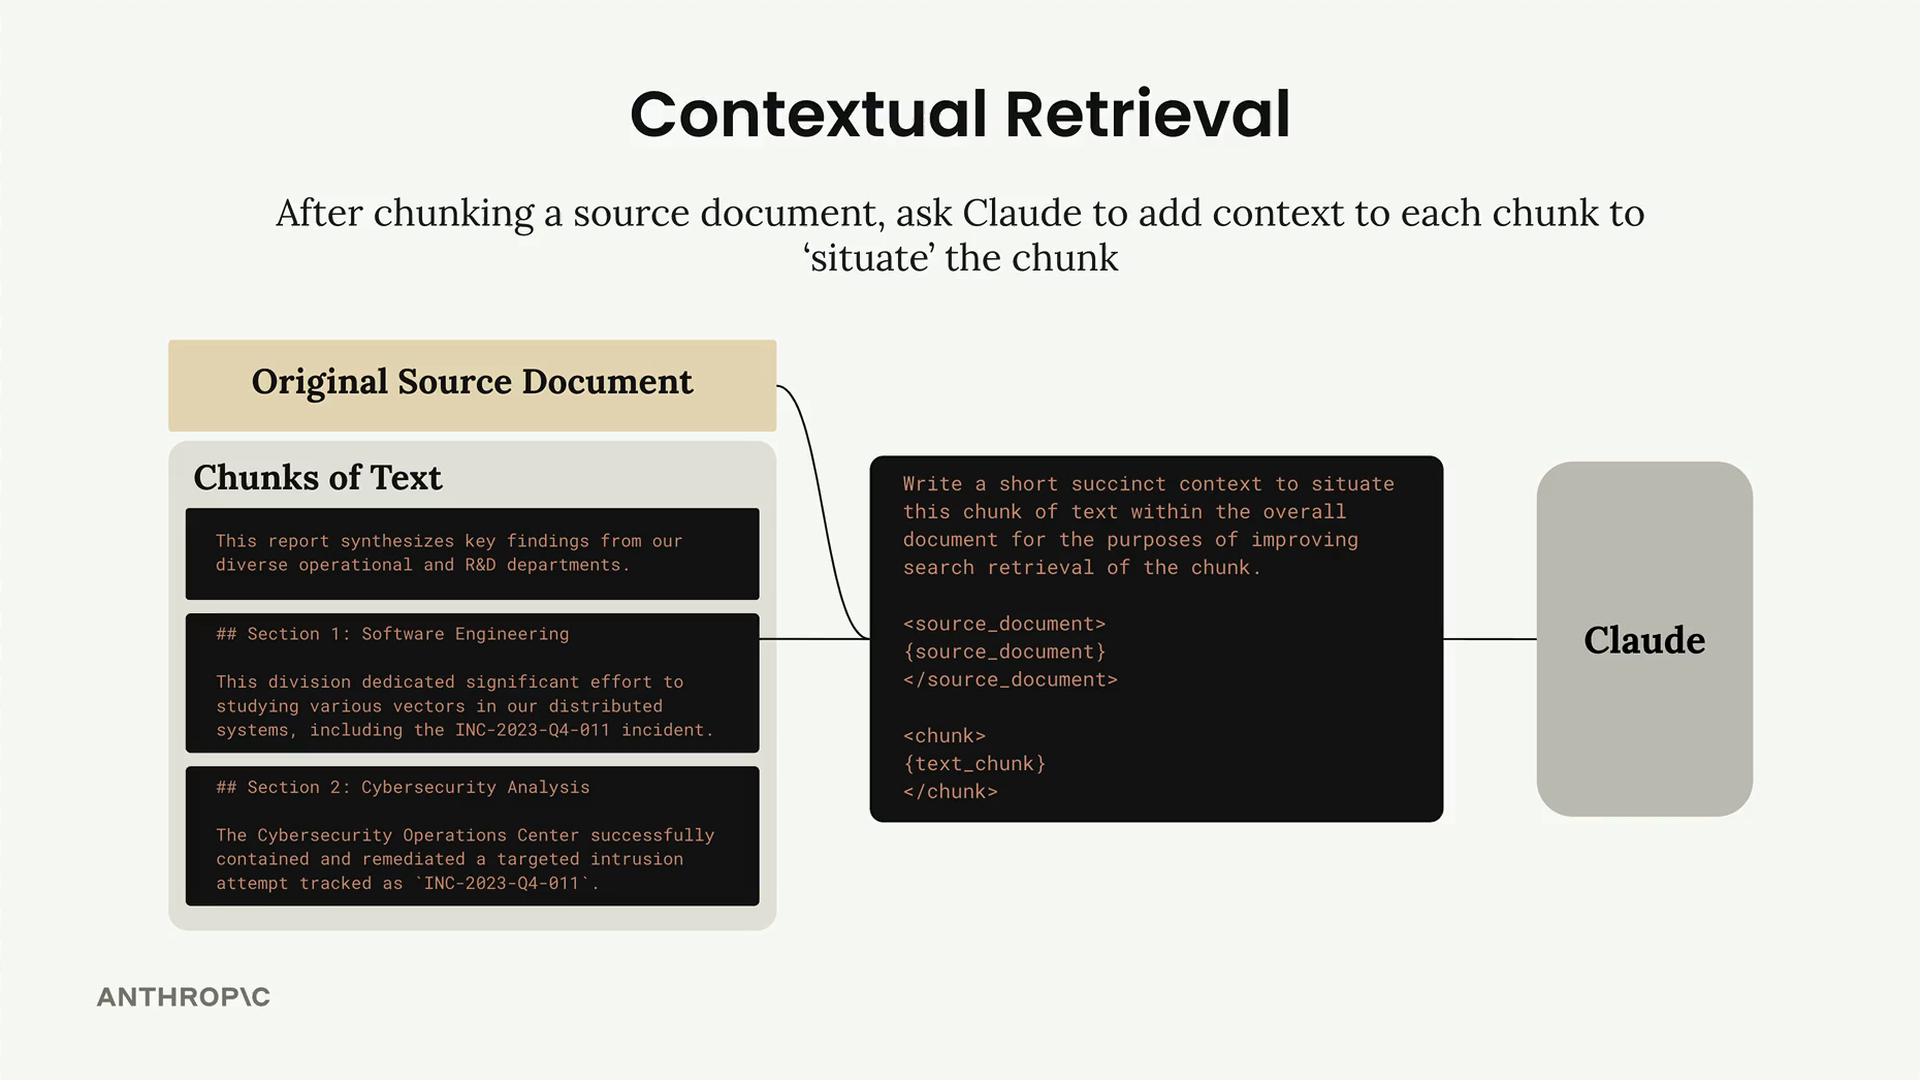
基本思路很简单。在对源文档进行分块之后,您要求Claude在将每个块存储到您的检索数据库之前,为其添加上下文。这个预处理步骤有助于将每个块"定位"在更大的文档之中。
工作原理
对于每个文本块,您将该块和原始源文档一起发送给Claude,并附上类似这样的提示:
Write a short and succinct snippet of text to situate this chunk within the
overall source document for the purposes of improving search retrieval of the chunk.

Here is the original source document:
<document>
{source_text}
</document>

Here is the chunk we want to situate within the whole document:
<chunk>
{text_chunk}
</chunk>

Answer only with the succinct context and nothing else.Claude可能会生成这样的上下文:"本节摘自一份关于跨学科小组的更大报告。其中提到了INC-2023-04-011,该事件在网络安全分析部分也有提及。"
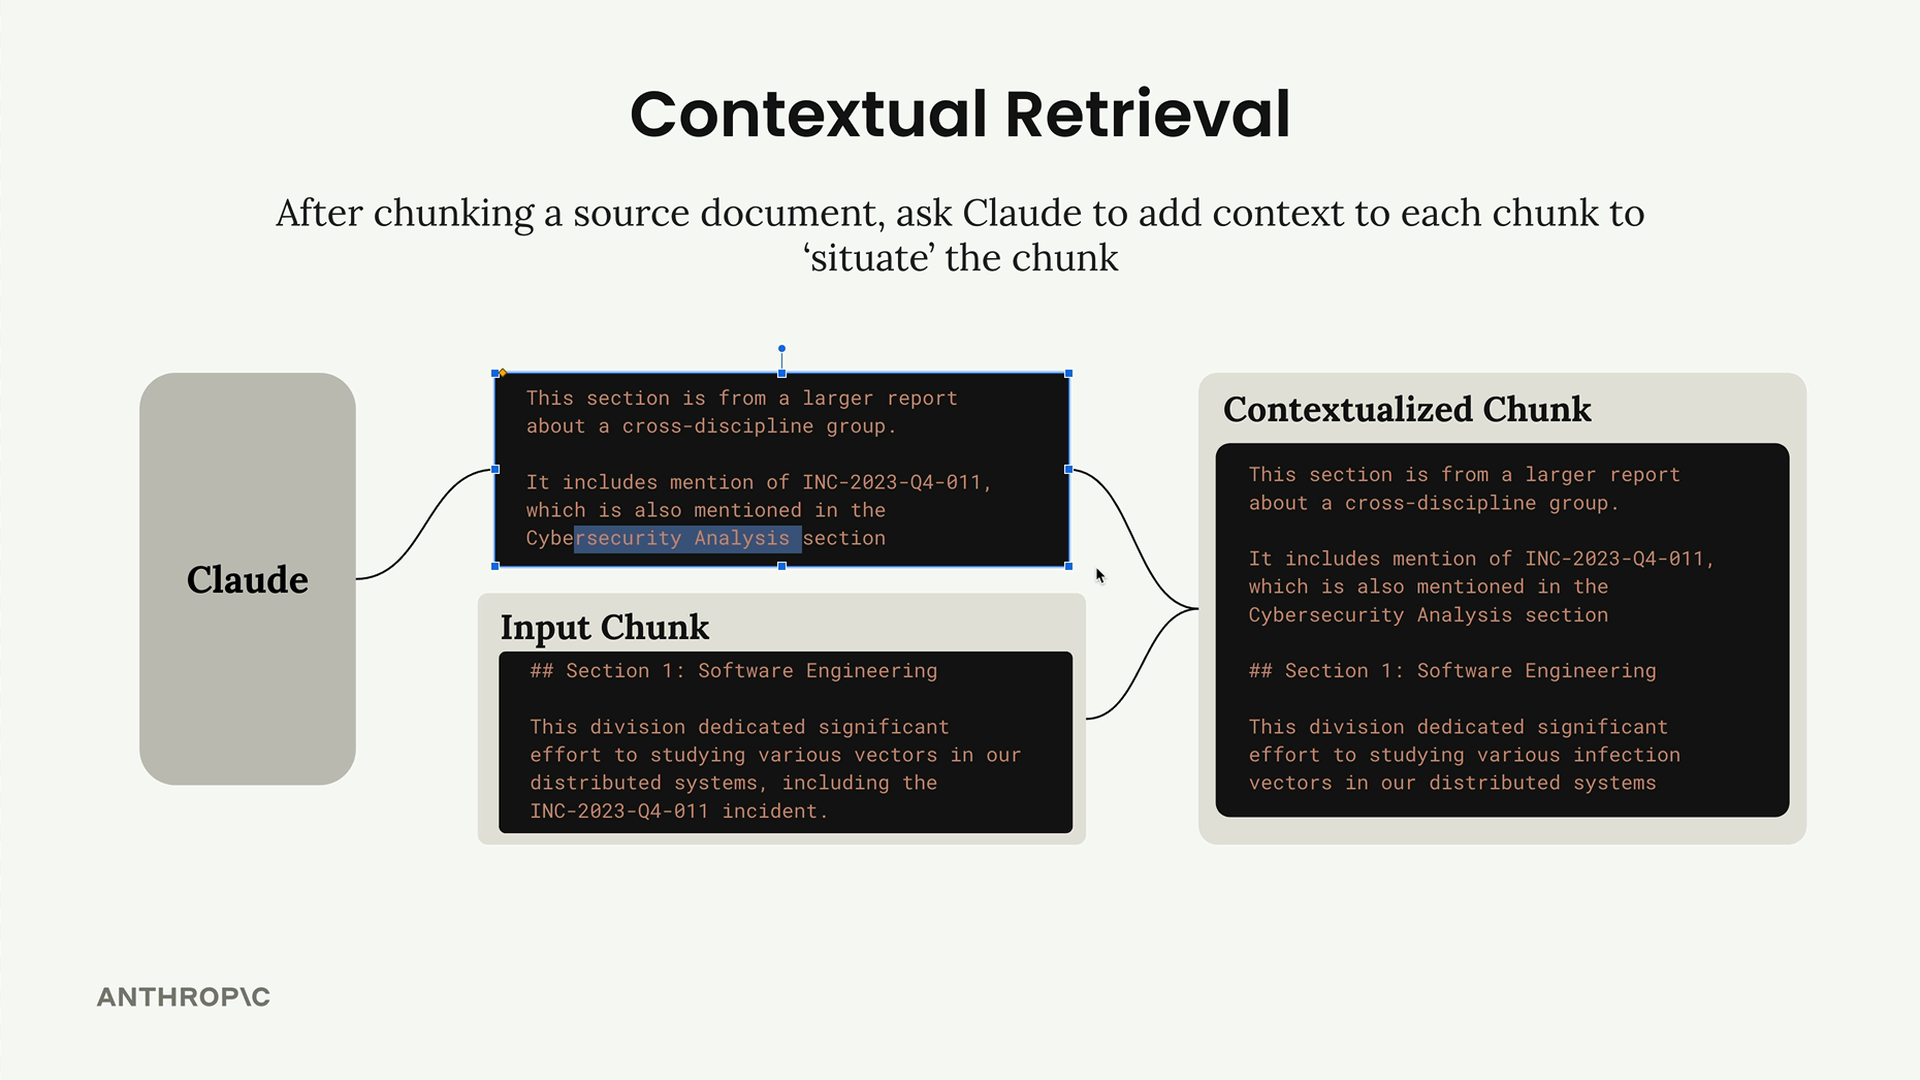
然后,您将这个生成的上下文与原始块文本结合,创建一个"上下文化的块",并将其存储在您的向量索引和BM25索引中。
处理大型文档
如果您的源文档太大,无法放入单个提示中,您可以提供一组精简的上下文,而不是整个文档。
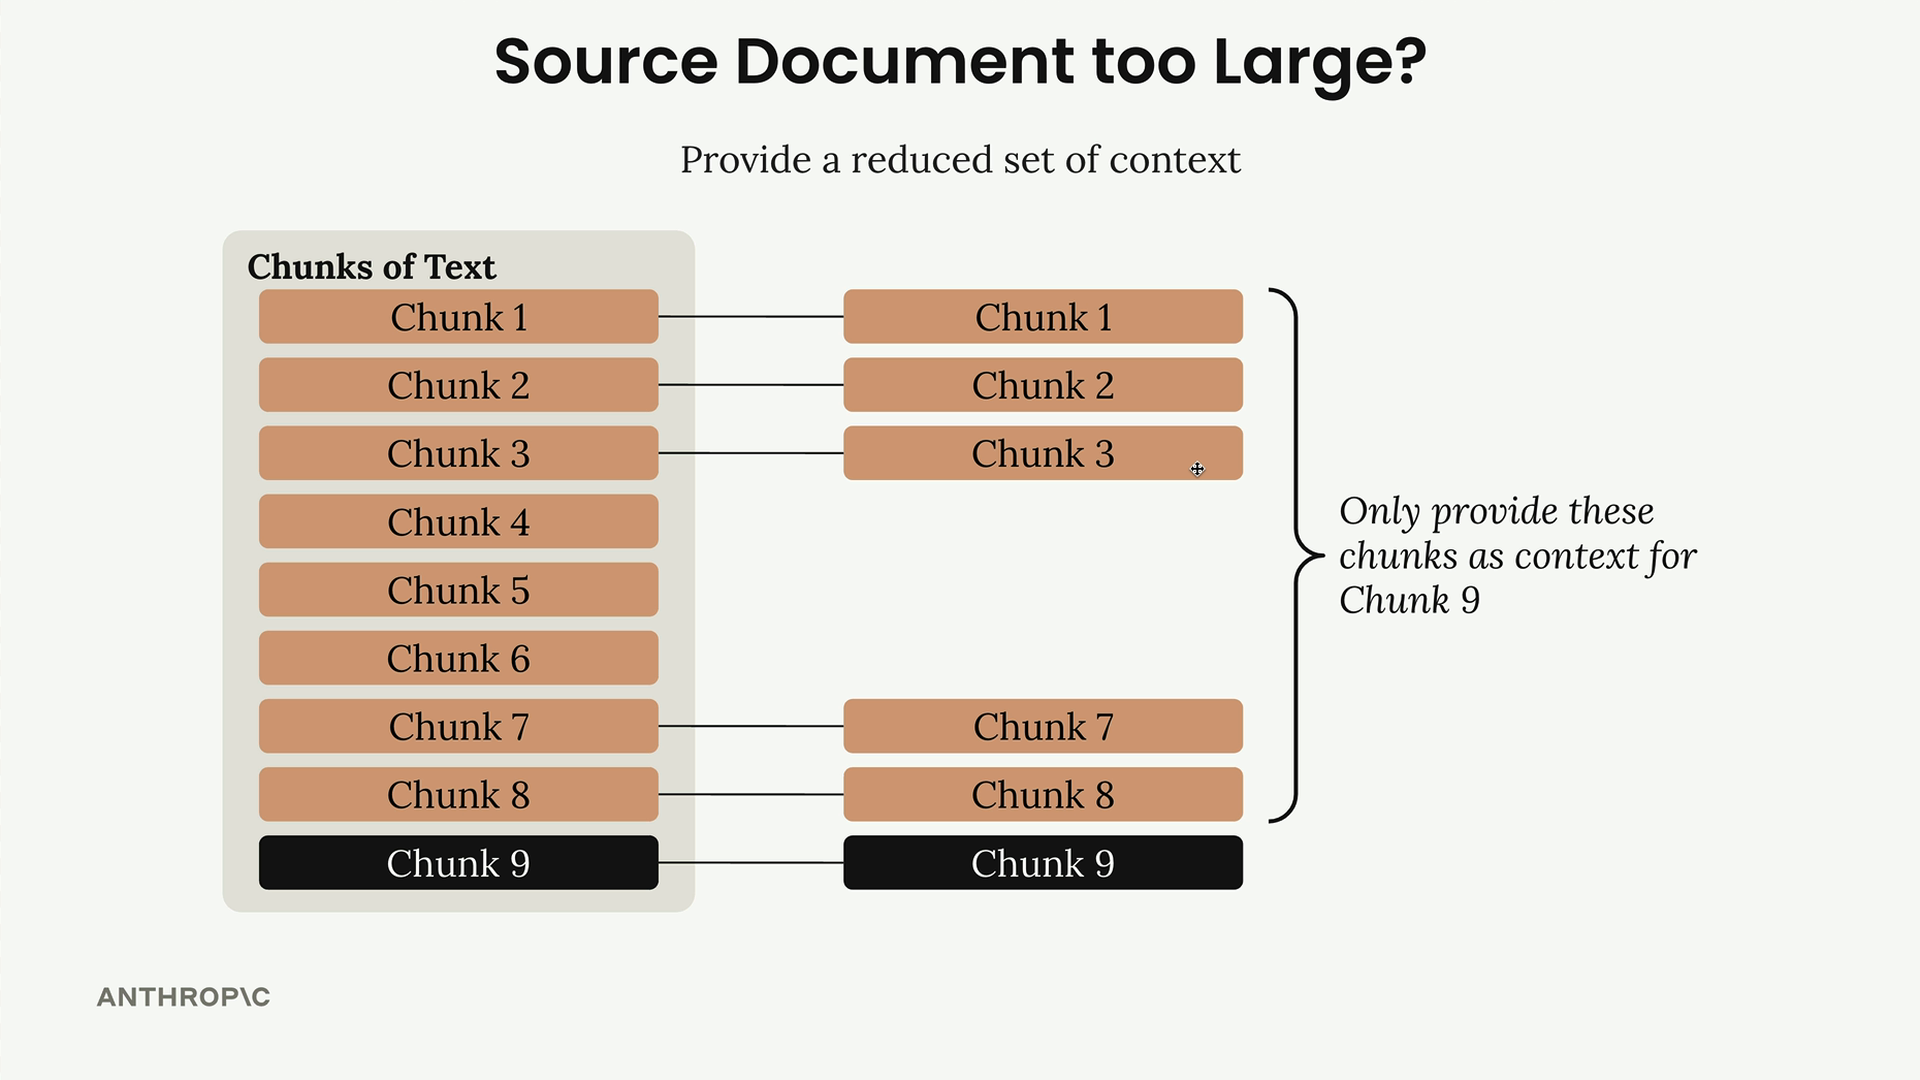
对于您要进行上下文化处理的任何给定块,请包含:
- 文档开头的几个块(通常包含摘要或概述)
- 紧邻目标块之前的块(提供局部上下文)
这种方法为Claude提供了足够的信息来生成有意义的上下文,而不会让整个文档淹没提示。
实现示例
以下是上下文检索函数的一个基本实现:
def add_context(text_chunk, source_text):
    prompt = f"""
    Write a short and succinct snippet of text to situate this chunk within the
    overall source document for the purposes of improving search retrieval of the chunk.

    Here is the original source document:
    <document>
    {source_text}
    </document>

    Here is the chunk we want to situate within the whole document:
    <chunk>
    {text_chunk}
    </chunk>

    Answer only with the succinct context and nothing else.
    """

    messages = []
    add_user_message(messages, prompt)
    result = chat(messages)

    return result["text"] + "\n" + text_chunk
在处理文档块时,您需要遍历每个块并生成其上下文化版本:
# 为每个分块添加上下文,然后添加到检索器
for i, chunk in enumerate(chunks):
    # 从起始分块和前置分块构建上下文
    context_parts = []
    context_parts.extend(chunks[:min(num_start_chunks, len(chunks))])

    start_idx = max(0, i - num_prev_chunks)
    context_parts.extend(chunks[start_idx:i])

    context = "\n".join(context_parts)

    contextualized_chunk = add_context(chunk, context)
    retriever.add_document({"content": contextualized_chunk})
预期结果
生成的上下文提供了关于文档结构和关系的有价值信息。例如,Claude可能会将某个块描述为"《年度跨学科研究综述》的第2节,详细介绍了软件工程方面为解决凤凰计划(Project Phoenix)中稳定性问题所做的努力。该节紧接方法论部分之后,财务分析部分之前,是涵盖该组织十个研究领域的综合报告的一部分。"
这些额外的上下文有助于检索系统更好地理解每个块不仅包含什么内容,还能理解它如何融入更大的文档结构并与其他部分关联。虽然对于简单文档,您可能不会看到显著的改进,但随着文档变得更加复杂,各部分之间存在错综复杂的交叉引用和依赖关系时,上下文检索会变得愈发有价值。