加载中
本演示通过一个实际示例展示了完整的RAG(检索增强生成)实现。我们将从零开始构建一个向量数据库,并使用一份示例报告文档执行RAG工作流的全部五个步骤。
设置向量数据库
该实现使用一个自定义的VectorIndex类来处理嵌入的存储和相似性搜索的执行。这个类为我们提供了向量数据库操作所需的核心功能。
五步RAG实现
步骤1:按章节对文本进行分块
首先,我们使用之前介绍的基于章节的分块方法,加载并分块源文档:
python
with open("./report.md", "r") as f:
    text = f.read()

chunks = chunk_by_section(text)
这会将我们的报告分解为可以独立处理的逻辑章节。
步骤2:为每个分块生成嵌入
接下来,我们使用列表推导式为每个分块创建嵌入:
python
embeddings = [generate_embedding(chunk) for chunk in chunks]此步骤涉及多次API调用,因此需要一些时间才能完成。每个分块都会被转换为一个数字向量表示。
步骤3:将嵌入存储到向量数据库中
现在我们创建向量存储,并用嵌入及其关联的文本填充它:
python
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
这里的关键要点是,我们同时存储嵌入和原始文本。仅仅返回一串数字列表是没有用的——我们需要与这些嵌入对应的实际文本内容。这些元数据使我们能够在之后检索到有意义的结果。
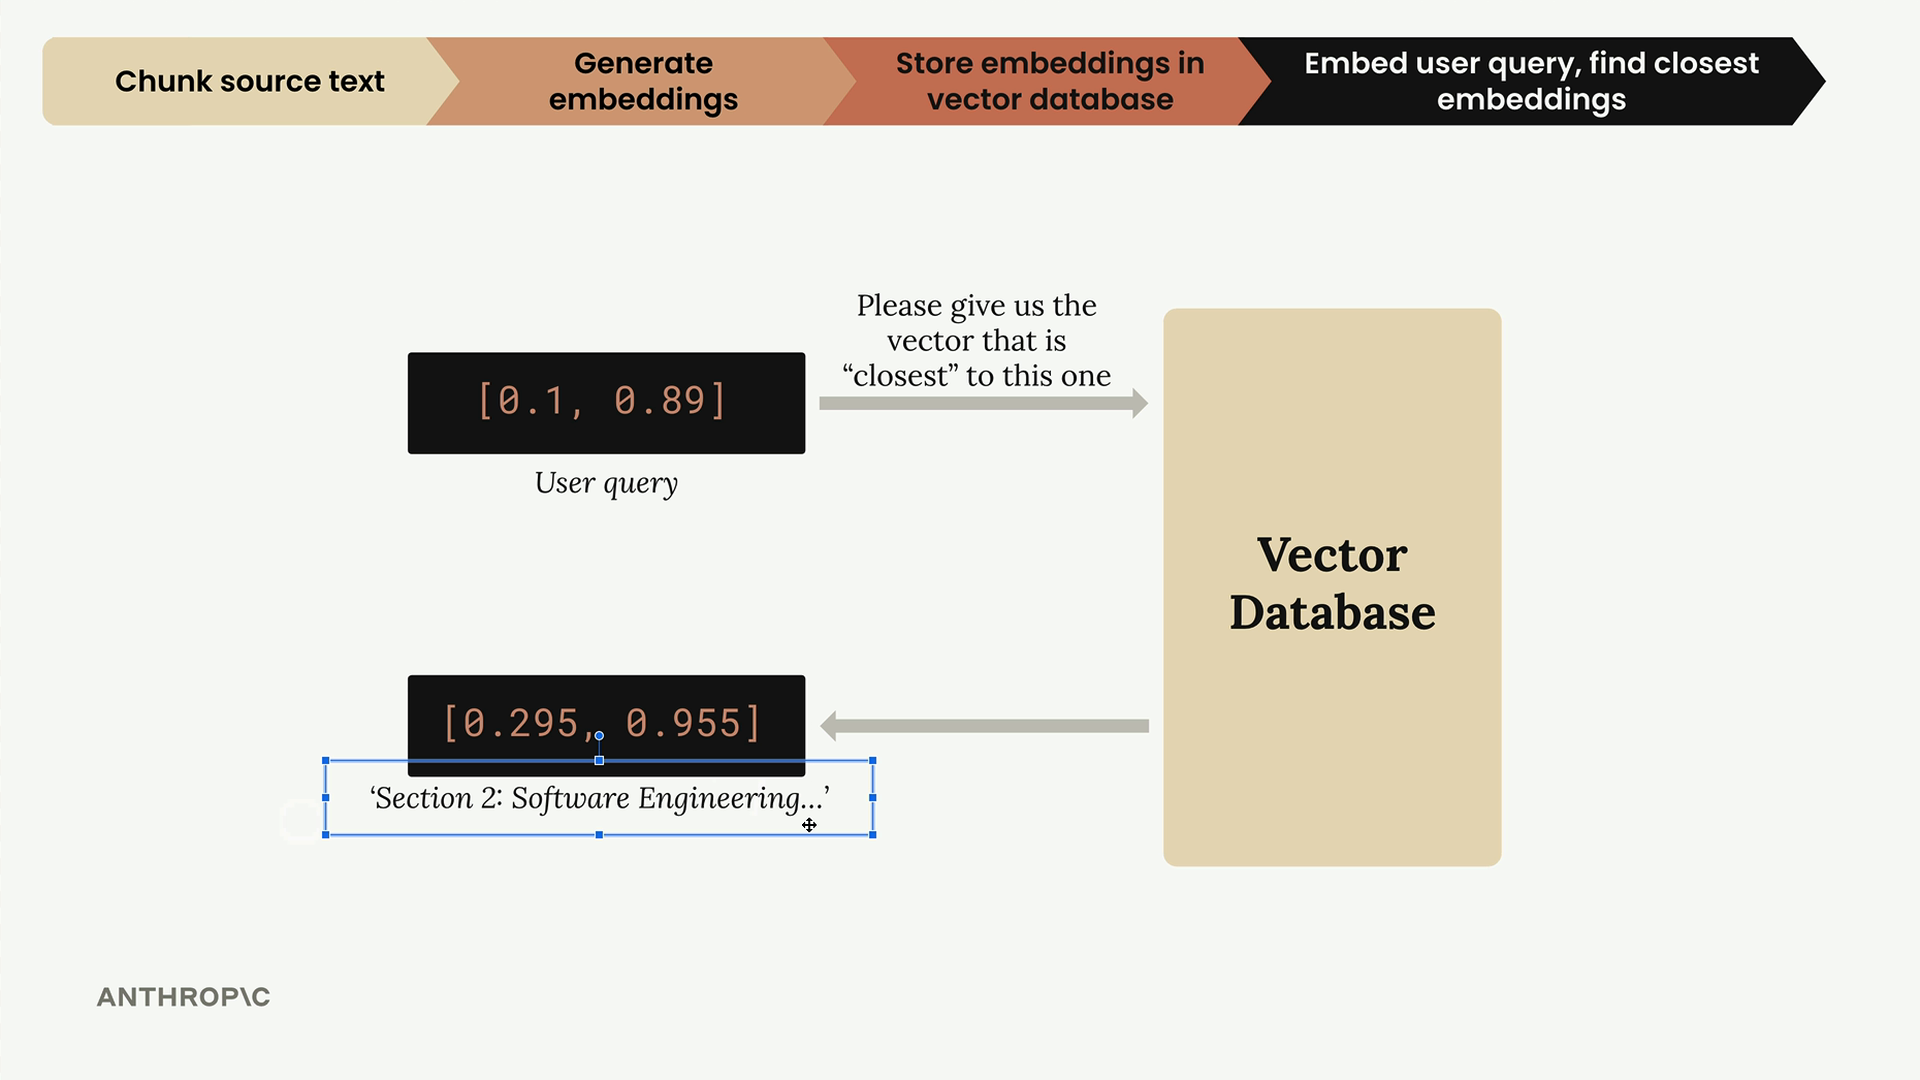
步骤4:生成用户查询嵌入
当用户提出问题时,我们将其转换为相同的嵌入格式:
python
user_embedding = generate_embedding("What did the software engineering dept do last year?")这会创建用户问题的向量表示,从而可以与我们存储的嵌入进行比较。
步骤5:搜索并检索相关分块
最后,我们搜索向量存储以找到最相似的内容:
python
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
这会返回两个最相关的分块及其余弦距离分数。距离越小表示相似度越高。
理解结果
搜索结果按相关性排序返回。在我们的示例中,软件工程部分的距离最小(0.71),使其成为最相关的匹配。方法论部分以0.72的距离位居第二。
距离度量可以帮助您了解系统对每个结果相关性的置信程度。距离越近表示与用户查询的匹配越好。
为什么要将文本与嵌入一起存储
一个至关重要的设计决策是将原始文本与每个嵌入一起存储。如果不这样做,您只会得到一串数字数组,这对生成响应没有用处。通过包含源文本,您可以立即使用检索到的分块为您的语言模型提供上下文。
这就完成了核心的RAG工作流程,不过在实际场景中还有一些额外的优化和改进可以提升性能。